如何将中文PDF翻译成英文?保留分栏、
 意扣 Equalang
导读
介绍如何将中文PDF翻译成英文并保留原始排版与表格结构。详解汉字分词、CID字体乱码解析及英文膨胀等技术难点与实用工作流。
关键词:中文PDF翻译成英文; 中文PDF翻译; PDF保留排版; 汉字分词翻译; 文档翻译
要将中文 PDF 翻译成英文并完整保留原始版式,首先需确认文档属于可直接提取文字的矢量电子版还是扫描图像。对于原生文字版 PDF,可直接上传至支持结构化版式还原的文档翻译工具(如意扣 Equalang 或谷歌文档翻译):工具会解析底层文本流,对无空格分隔的连续汉字进行专业分词与断句,拼接被换行和分页截断的完整句子,再将英文译文按原分栏、表格和图注位置写回。如果是扫描件,则需先经过 OCR 文字识别。此外,中文语意紧凑,译成英文后字符物理长度通常显著增加,应选用能自动缩放字号自适应文本框的工具,以避免表格内容溢出或重叠。
中文 PDF 翻译英文的实操三步法
将中文技术文献、行业研报或学术论文翻译为英文,关键不仅在于词义转换,更在于对 PDF 矢量坐标、字符编码和排版规则的解析。以下是保证排版不乱的标准处理流程。
第一步:检查文字可提取性与编码状态
在任意 PDF 阅读器中打开文件,尝试选中一段中文并复制到纯文本记事本中:
- 若复制出来的文字为正常汉字:说明 PDF 为原生电子版,内嵌了规范的字符映射表(如
ToUnicodeCMap 表),可直接使用文档翻译工具整文件处理。 - 若复制结果显示为问号、空白方框(乱码)或乱序符号:说明文档使用了子集化内嵌的 CID 字体,且缺少标准的 Unicode 映射。常规文本提取工具无法正常读取其内容。
- 若无法选中任何文字:说明该 PDF 为纯图片扫描件,必须先使用支持中文识别的 OCR 流程。
第二步:上传并执行保留版式翻译
下面用意扣(Equalang)演示完整的文件翻译流程(equalang.com/zh-CN/documents)。
- 进入网站的文档翻译页面(/documents)。
- 上传中文 PDF 文件。网页端支持单文件逐个上传,同一个账号同时最多处理 3 份文档,其余文件会自动排队。
- 源语言选择中文(或自动检测),目标语言选择英文。
- 若文档为包含复杂公式、矩阵或微积分表达式的学术论文,可勾选公式优化选项,避免行内符号被拍平成乱码。
- 点击开始翻译。系统会自动识别多栏布局、表格合并单元格以及跨页句子拼接,完成整篇翻译并生成对齐排版的英文文档。
第三步:工作台对照核验与双语导出
翻译完成后,进入意扣的翻译工作台(Translation workspace)进行查阅与下载:
- 工作台左侧展示中文原文,右侧展示英文译文,点击开启「双栏同步滚动」,便于逐段对照数据、图表和专有名词。
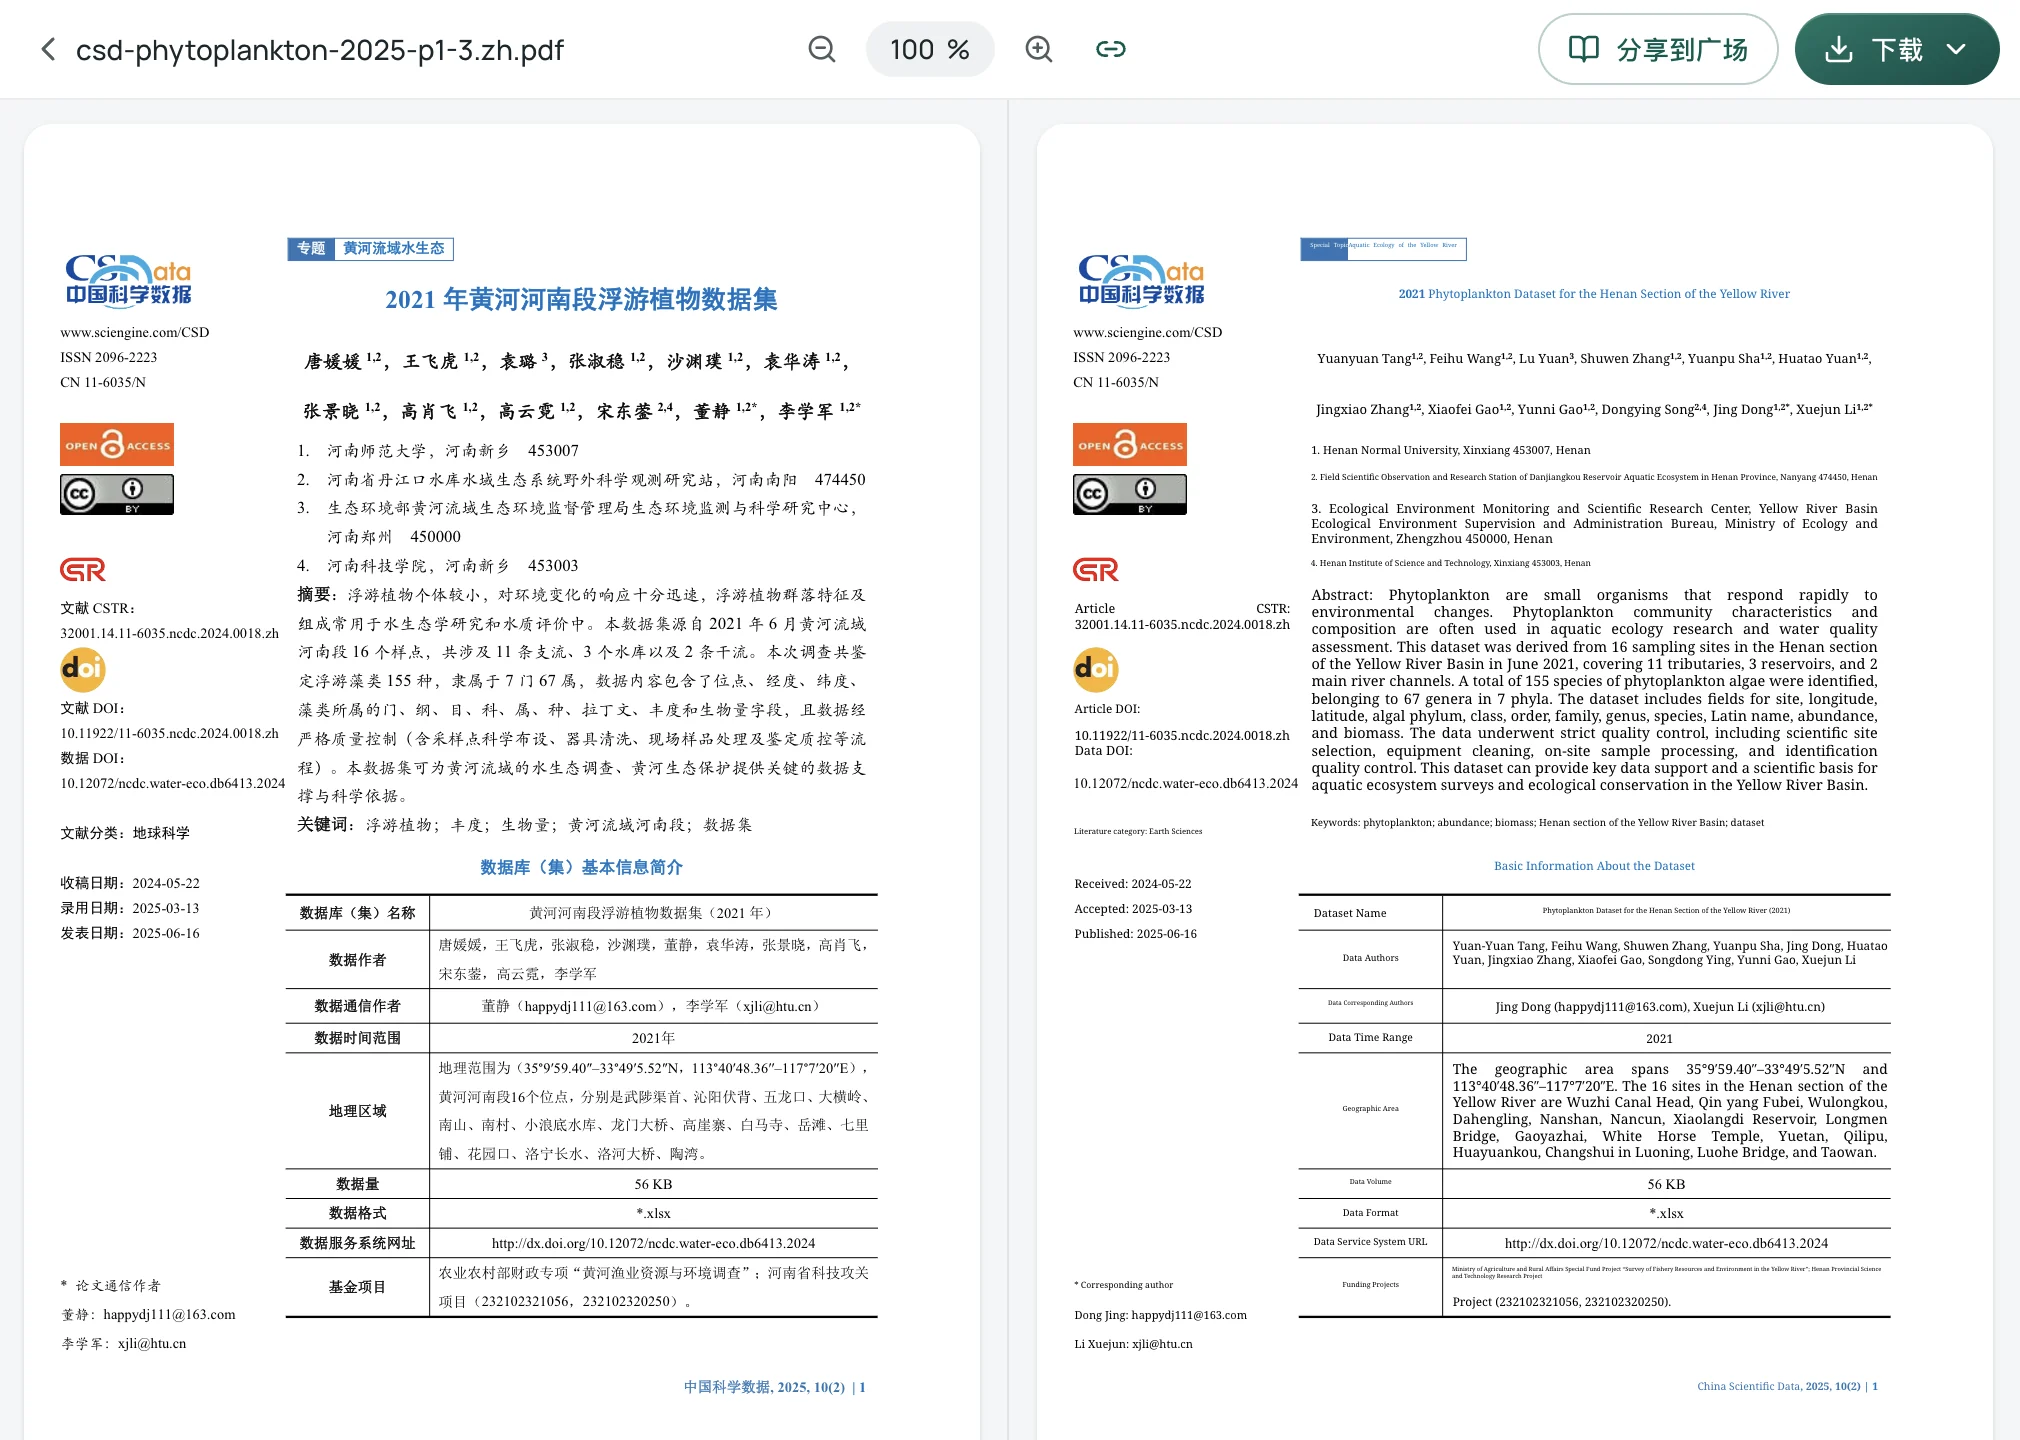
- 点击下载可选择仅译文 PDF,获取一份页数与原文完全一致、排版结构完整对应的纯英文文件。
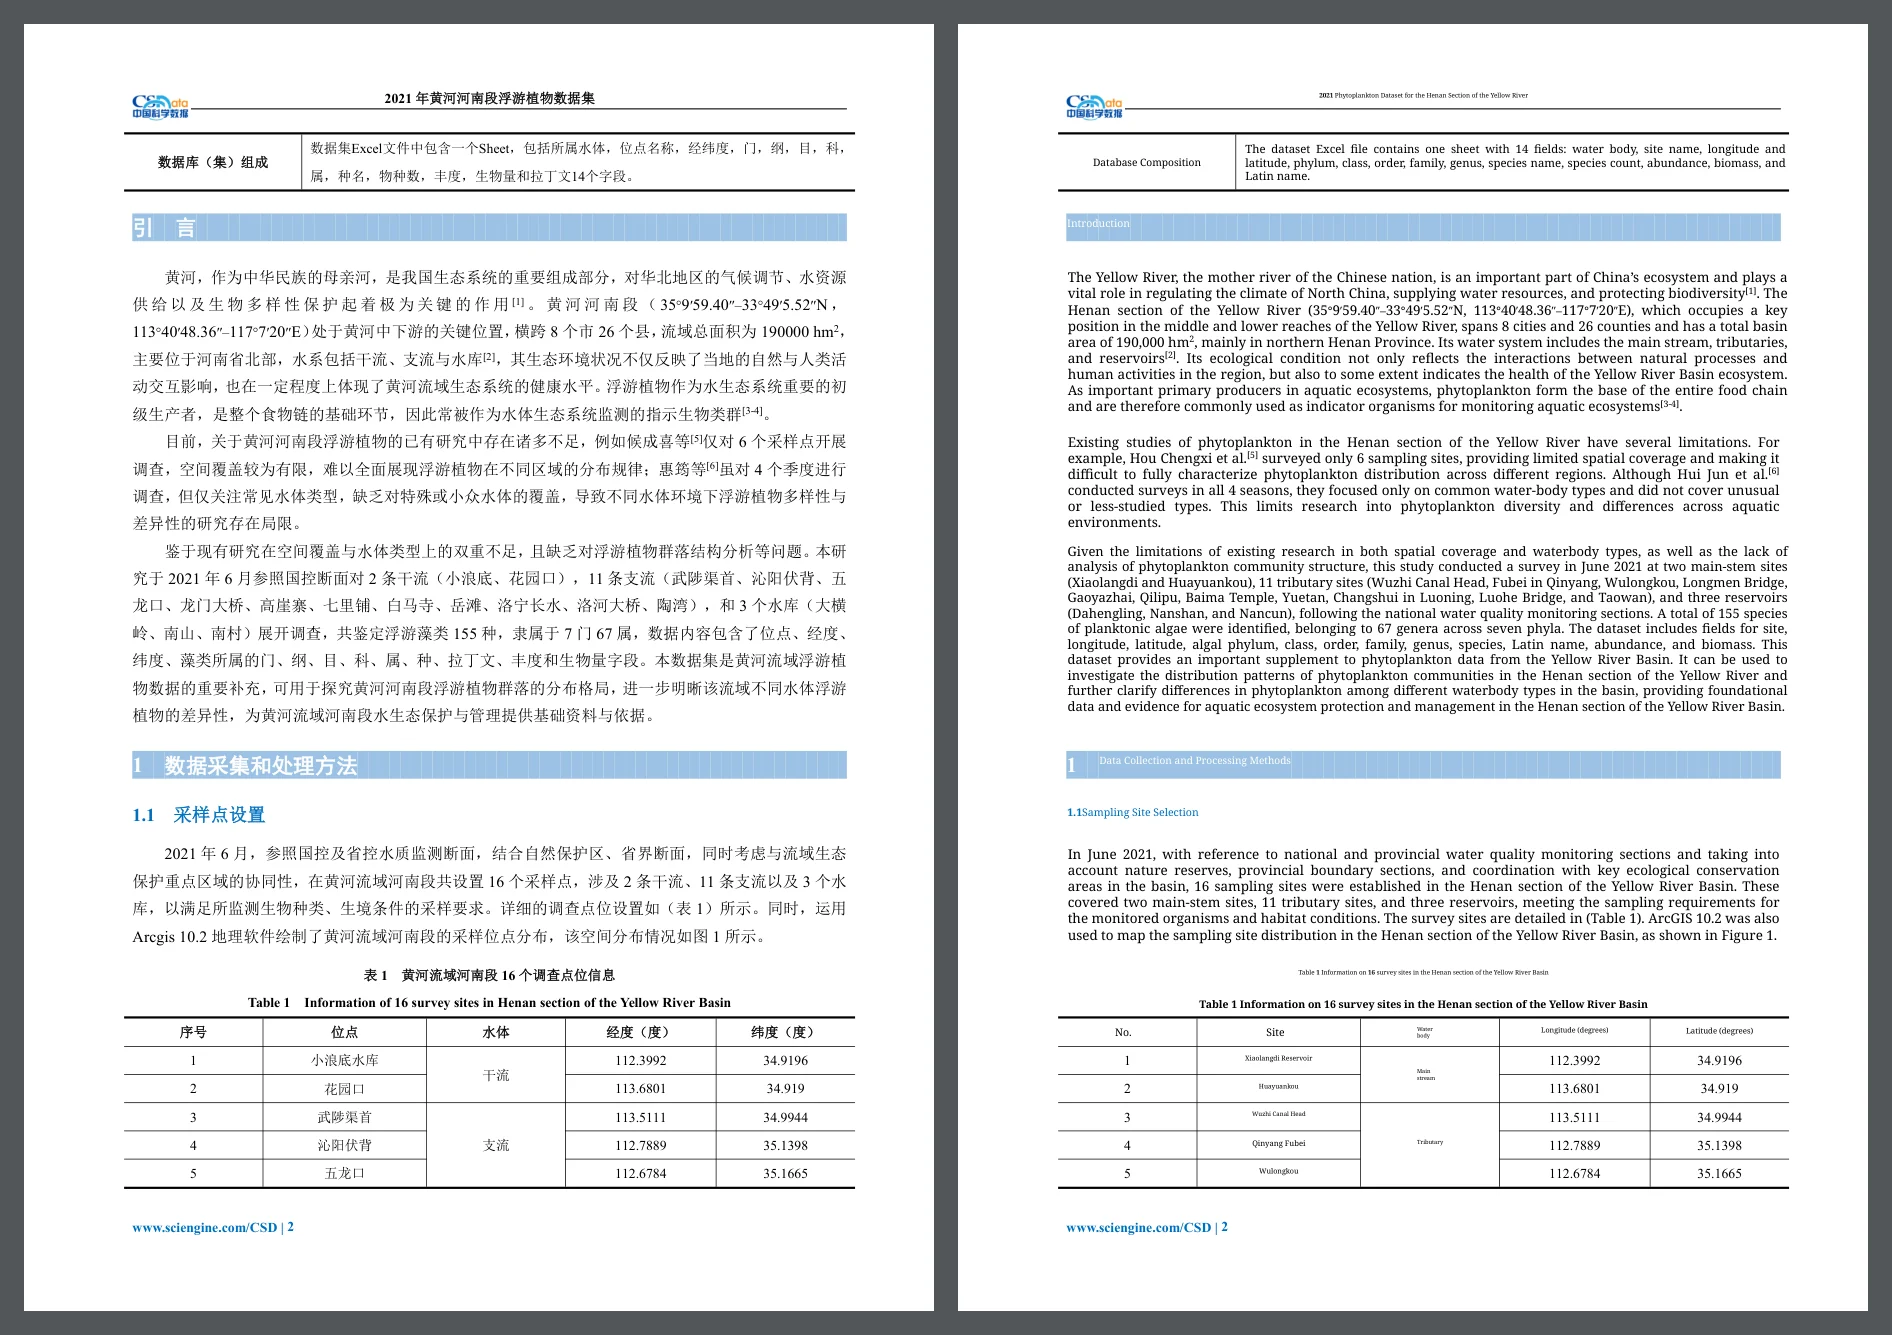
- 也可以下载对照文件:该文件由原文页与译文页逐页交替生成。使用本地 PDF 阅读器(如 Acrobat、Preview 或 PDFgear)打开该文件,在菜单中切换为「双页视图」(若左右页对折错位,可在阅读器设置中取消「封面单独显示」),即可实现左页中文、右页英文的左右对照精读体验。
为什么中文 PDF 翻成英文容易排版错乱?
中文排版与拉丁语系有着截然不同的排版规范。了解底层排版原理有助于规避文档损坏风险。
1. 汉字间无空格与分词歧义
依据 W3C《中文排版需求》(Requirements for Chinese Text Layout, CLReq)第 4.2.2 节的定义,中文词汇之间没有空格或其他分隔符,词边界必须依靠特定语言的分词算法(词典匹配、语法规则或统计模型)来判定。
由于中文分词本身具有歧义性,若翻译引擎缺乏上下文长句感知能力,往往会在分栏换行处将复合专业名词割裂翻译。这不仅会导致译文语句不通,还会打碎段落的自然行高。
2. 全角标点与避头尾规则
根据国家标准 GB/T 15834—2011 以及 W3C CLReq 第 2.1.2 节:
- 中文的停顿与句终标点(如逗号、句号、分号)占用一个完整汉字字宽(全角字身)。
- 大陆出版物中,水平书写的句末标点位于字框左下方;港台出版物则通常居中分布。
- 排版时受严格的避头尾规则(Line-start/line-end prohibition)约束,禁止点号出现在行首或行尾。
当机器直接替换文字而未重新计算标点字框时,英文的半角逗号和句点容易沿用原有的全角空白,造成译文中出现不规则的空白间隙。
3. CID 字体与字形子集化乱码
Adobe 官方技术说明指出,亚洲语言文字(包含上万汉字字符)普遍采用 CID 字体(Character Identifier 字体)。文档导出软件为压缩文件体积,通常只将文章用到的字形作为「子集」(Subset)嵌入 PDF 中。
若原作者导出的 PDF 未规范写入 ToUnicode 映射表,即使屏幕上能正常渲染出宋体或黑体,底层代码流也只是一串无序的字形索引。直接抓取这层数据进行机器翻译,输出的内容必然是整段问号或不可读乱码。
4. 英文文本膨胀与表格溢出
W3C 国际化工作组(i18n)的研究指出,中文表达具有极高信息密度,单个汉字即可表达完整语素。而将中文翻译为自然英文时,译出的文字通常更长。
例如,中文表格表头「点位」(2 个汉字字宽)译为英文「Site」(4 个字符)。若工具不能根据单元格边界自动调小字号或重新折行,文字就会直接冲出表格框线或与下一列数据相互重叠。关于表格结构保留的更多技巧,可参考复杂表格与合并单元格翻译指南。
常见翻译方案的实际表现与取舍
复杂中文 PDF 翻译的实用避坑建议
- 先测文本复制,再建任务:在处理整本手册或论文前,先从 PDF 中复制一段文字粘贴到记事本。若能正常显示汉字(如公开的《中国科学数据》论文数据集样本),即可放心提交文档翻译;若复制出乱码,需考虑 OCR 预处理。
- 多栏论文注意阅读顺序:中文学术论文多采用双栏紧凑排版。对于跨栏截断的句子,应确保工具具备跨栏语义拼接能力,否则会造成左栏尾句与右栏首句生硬拼接。详见双栏学术论文翻译指南。
- 善用对照视图核验专有名词:专业技术文献中的特定术语和单位(如
mg/g、‰)至关重要。利用双页视图让中英文并排显示,能快速定位原文并核查关键技术参数。关于保持长文档专业名词统一,可参考PDF保留排版技巧。
参考资料
- W3C, Requirements for Chinese Text Layout 中文排版需求 (CLReq), 2026-11-04 草案:https://www.w3.org/TR/clreq/
- W3C 国际化指南, Text size in translation: https://www.w3.org/International/articles/article-text-size.en
- Adobe Help, PDF 字体概述: https://helpx.adobe.com/acrobat/using/pdf-fonts.html
- Google 翻译帮助, 翻译文档和网页: https://support.google.com/translate/answer/2534559?hl=en&co=GENIE.Platform%3DDesktop
- 唐媛媛、王飞虎、袁璐等,董静、李学军(通信作者).「2021 年黄河河南段浮游植物数据集」.《中国科学数据》, 2025, 10(2), DOI: 10.11922/11-6035.ncdc.2024.0018.zh;该刊论文按出版方(中国科学院计算机网络信息中心)声明以 CC BY 4.0 在线发表(https://cnic.cas.cn/jgsz/kyywbm/qycxxjxxjssys/cgcc/202106/t20210628_6118574.html): https://doi.org/10.11922/11-6035.ncdc.2024.0018.zh
- 意扣文档翻译:https://equalang.com/zh-CN/documents
- 意扣价格与隐私说明:https://equalang.com/pricing, https://equalang.com/legal/privacy