双栏学术论文 PDF 翻译:
 意扣 Equalang
导读
双栏英文论文翻译后常遇到跨栏断句、连字符断词和图注穿插。本文结合三遍阅读法,给出双栏 PDF 译文对照步骤与必须回看原文的核对清单。
关键词:双栏论文PDF翻译, 学术PDF翻译, 跨栏断句, PDF对照阅读, 英文论文初筛
双栏排版的英文学术论文直接复制或粗略机翻时,最常卡在三个地方:一句话从左栏底跳到右栏顶被拦腰截断、行尾连字符把专业术语拆成两半、通栏图表或公式夹在中间把上下文冲散。想用中文译稿快速初筛论文、又不被错位的段落误导,核心做法是:先用保留分栏与段落层级的工具把版面稳住,再按“鸟瞰—图表—正文”三遍法对照阅读,并在关键数值、公式符号和缩写处强制回看英文原稿。
下面把双栏 PDF 常见错位的原因、三遍阅读的对照步骤,以及哪些地方必须核对原文一次说清。
为什么双栏论文一翻译就容易乱序
PDF 本质上是记录“字符画在页面哪个坐标”的版式文件,而不是像 Word 那样天生带有连续的段落流。双栏学术论文里同时存在几种排版元素,普通文本提取或逐行翻译很容易认错阅读顺序:
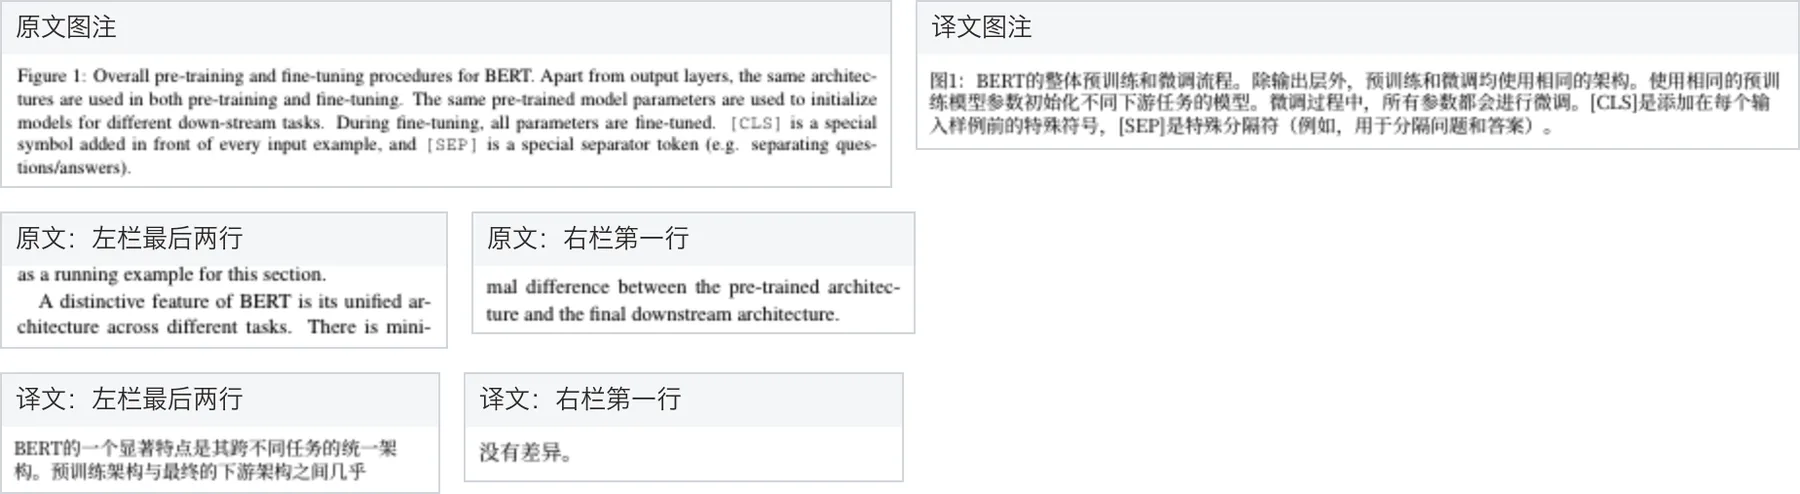
- 跨栏与跨页截断:左栏最后一行没写完的句子,原本应该接右栏第一行,或者跳到下一页左栏顶部。如果按页面从左到右硬扫,左栏第 1 行就会和右栏第 1 行拼成一句毫无逻辑的话。
- 行尾连字符(Hyphenation):英文排版为了两端对齐,常把长单词在行尾加连字符断开(例如把
self-attention之外的普通词pre-processing或archi-tecture拆成两行)。未做拼接处理时,断词会被当成两个独立词,导致术语漏译或错译。 - 浮动图表与图注穿插:论文里的通栏大图(Figure)、三线表(Table)和脚注常嵌在页面顶部或底部。若不区分正文流和图注层级,图注就会直接插进正在推导的句子中间。
用“三遍阅读法”读双栏译稿:每遍看什么、怎么核对
滑铁卢大学 S. Keshav 教授提出的论文“三遍阅读法”(Three-Pass Approach),非常适合迁移到双栏译稿的阅读中。与其从第一页第一行硬着头皮往下顺读,不如把阅读拆成三个阶段,让中文译稿帮你在前两遍快速筛掉不相关的文献,把精力留给第三遍的细节核对。
第一遍:5–10 分钟鸟瞰(看结构,决定要不要继续读)
第一遍的目标是搞清论文在解决什么问题、属于哪一类方法、结论是否和你的研究或工程任务相关。
- 只读固定位置:依次扫读标题、摘要(Abstract)、各级小标题(Section Headings)以及结论(Conclusion)段落。
- 检查段落层级:加粗的小标题和列表编号能帮你快速串起作者的论证骨架。
- 利用文内跳转:看到摘要或引言里提到关键章节、参考文献时,直接通过目录或交叉引用链接跳过去看一眼,不用在双栏正文里来回滚屏硬找。
如果第一遍读完发现研究假设或实验场景和你的需求不搭,就可以直接停下,不用浪费时间抠正文细节。
第二遍:30–60 分钟抓图表与核心公式(看证据,还原实验脉络)
决定继续读之后,第二遍先绕开大段的正文铺垫,专门盯住双栏页面里的图表、图注和独立公式。
- 先读图注和表头:把所有 Figure 的图注(Caption)和 Table 的多行表头、合并单元格结构看懂,弄清横纵坐标、实验组和基线(Baseline)分别是什么。
- 对照架构图与连接关系:看模型架构图或流程图时,用译文的模块中文标签和图注建立整体印象,同时瞄一眼原图的箭头流向与缩写。例如在已有 AI 论文局部样例中,架构图的主要连接关系、部分模块中文标签与图注可以对照阅读,帮读者快速理清数据流向。
- 定位核心公式编号:看独立公式(比如带编号
(1)的注意力计算或损失函数)时,先确认分式、根号和上下标结构完整,再顺着正文里引用该编号的句子看每个符号的物理或数学含义。
第三遍:精读正文与跨栏推导(左右对照,拆解技术细节)
只有确定这篇论文需要复现、引用或深入借鉴时,才进入第三遍逐段精读。这一遍最怕被跨栏长句和复杂从句带偏。
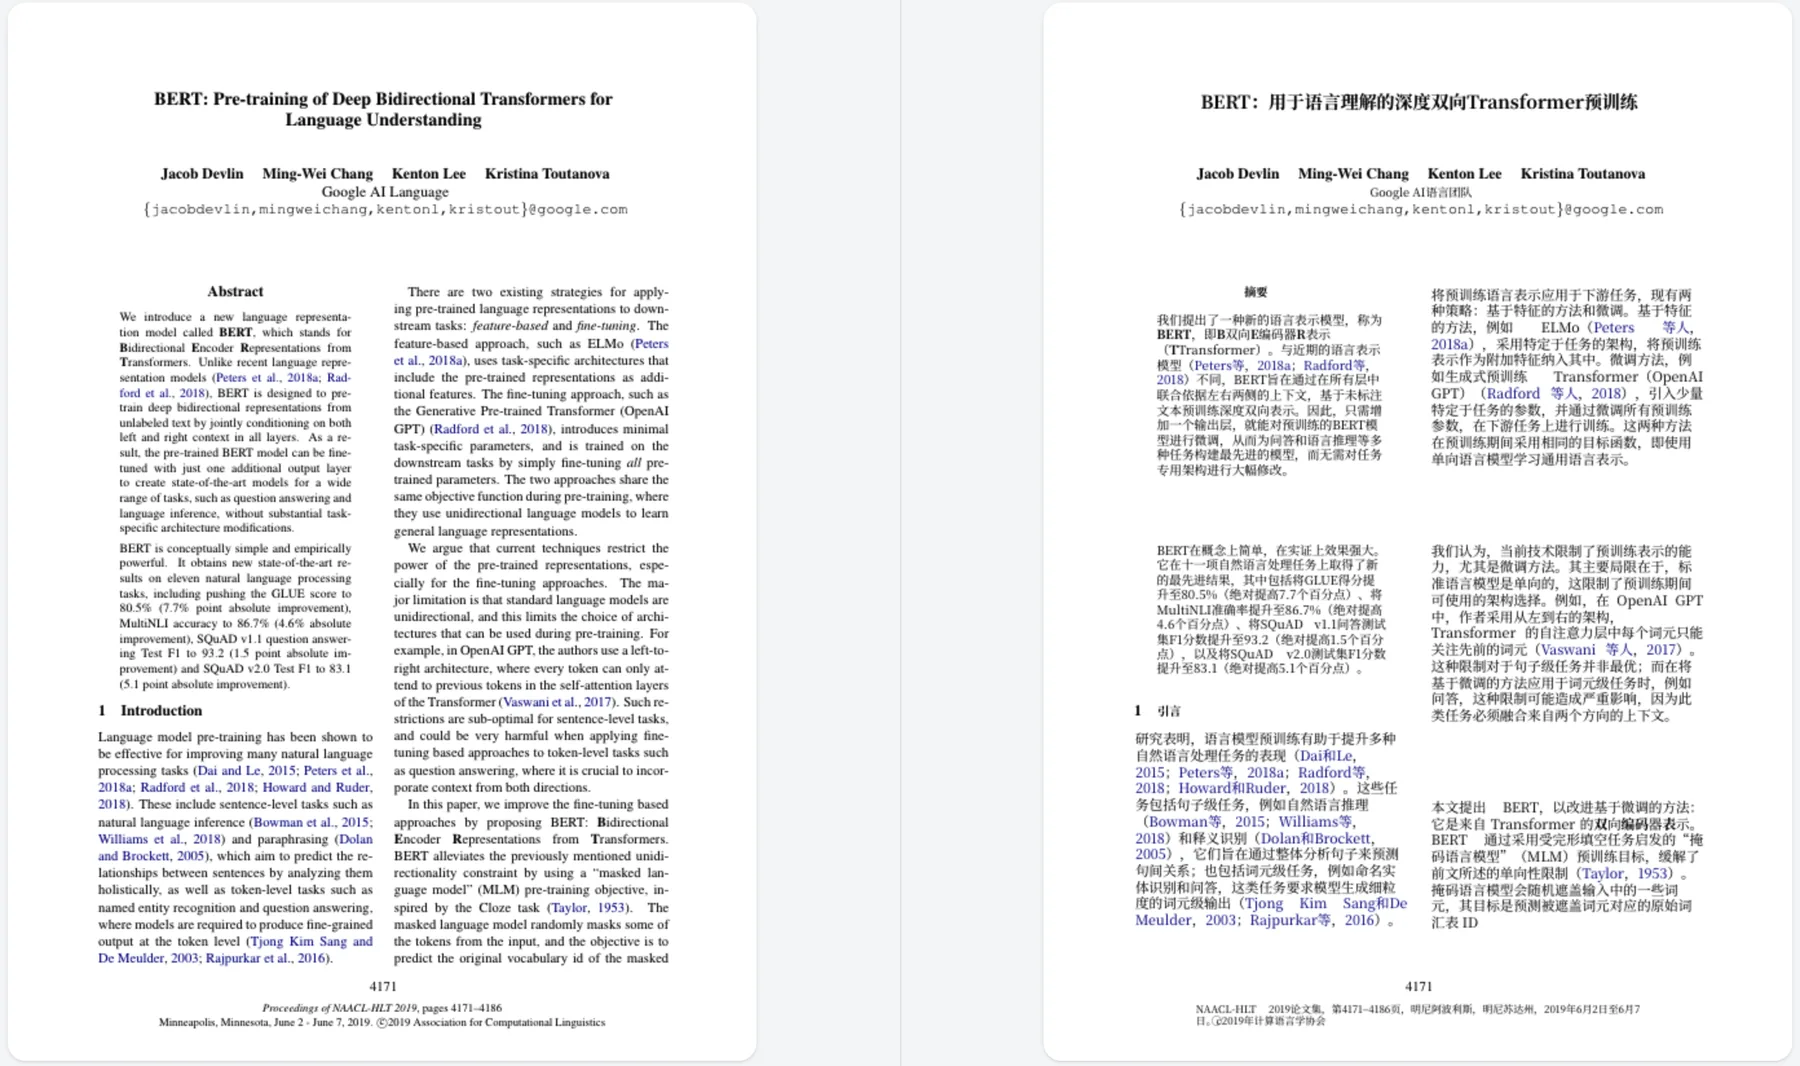
在支持保留文档结构的处理流程里,比如把论文 PDF 传到意扣(Equalang)完成文件翻译后,双栏版式、页眉页脚、图注和段落层级会保留下来,被分页截断的句子也会先拼回完整再翻译;原文加粗的术语,译文对应位置同样加粗。不过,因为中英文字符宽度不同,译文的字体、字号和换行位置会随译文长度自然变化,不会做到像素级一模一样。
精读时建议按这三步操作:
- 打开左右并排视图:文档翻完后,在网站的翻译工作台(Translation workspace)里打开,左边显示英文原文、右边显示中文译文,开启两栏同步滚动。
- 顺着拼好的跨栏句读逻辑:遇到左栏底部拖到右栏顶部的长难句,或者跨页的推导段落,先读右侧拼合后的完整中文句子,理清主谓宾和因果关系。
- 离线归档与批注:如果习惯在本地 PDF 阅读器里划线做笔记,可以下载译文 PDF,或者下载原文与译文逐页交替的对照文件,在平板或电脑上翻页比对。
哪些地方不能只看译文,必须回看英文原稿
机器翻译能帮你在初筛和泛读阶段省下大量查词和顺句子的时间,但在学术研究和工程落地中,译稿不能代替原稿复核。结合我们在学术论文与讲义 PDF 上的实际核验经验,以下四类位置必须把视线移回左侧原文核对:
一套顺手的双栏论文处理清单
下次拿到一篇急需判断价值的英文双栏 PDF,可以直接按这个顺序走一遍:
- 上传转换:把 PDF 上传到意扣(Equalang)发起翻译任务;如果论文里包含大量行内数学符号,顺手开启公式优化。
- 工作台三遍筛读:在翻译工作台用左右并排同步滚动视图,花 5 分钟走完第一遍(标题、摘要、小标题、结论),再用 20 分钟走完第二遍(图注、表格结构、架构图与核心公式)。
- 精读与原稿复核:筛出真正要精读的章节后,对照左侧原文读跨栏长句;凡是碰到坐标轴字母、模型缩写、公式上下标和实验表格数字,直接在左栏原稿上确认无误后再做笔记。
把这套动作固定下来,既能避开跨栏断句和连字符带来的阅读卡顿,又能守住学术核对的严谨底线。
参考资料
- S. Keshav, How to Read a Paper, ACM SIGCOMM Computer Communication Review: https://www.cs.cmu.edu/~./keshav/papers/quick-reading.pdf
- 意扣(Equalang)产品与文档翻译说明:https://equalang.com/
- 意扣(Equalang)文档功能页:https://equalang.com/documents
- 文中配图使用的示例论文:Jacob Devlin、Ming-Wei Chang、Kenton Lee、Kristina Toutanova,BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,NAACL 2019,ACL Anthology 以 CC BY 4.0 许可公开,配图用的是其中 4 页的摘录:https://aclanthology.org/N19-1423/