PDF 一翻译排版就乱?因为它通常不像 Word 那样标出段落和表格
 意扣 Equalang
导读
大多数 PDF 不像 Word 那样标出哪些字是一段、哪些字属于一张表。我们以两篇论文为例,看翻译工具拿到了什么,比较几种翻译方法,再列出译完该检查的四个地方。
Word 文件会记下哪些字是一段、哪些字属于一张表。大多数 PDF 不记这些,只记一个个字,以及每个字该画在页面上的哪个位置;段落、表格、句子,都是读的人自己看出来的。有的 PDF 带有给读屏软件用的无障碍标签,粗略标出了段落和表格,但很多没有,所以翻译工具不能指望它们。下面作为例子的两篇论文就没有这些标签。
你看到的双栏排版、跨列的表头、跨页的句子,都得重新拼出来才能翻译。翻完以后,长短不同的译文还得塞回原来的位置。排版变乱,基本都出在这两步。
怎么处理,取决于你手上有什么:
- 有生成这份 PDF 的 Word、PPT 原文件:直接翻原文件,别翻 PDF。
- 简单的文字 PDF,表格不多,文件不大:谷歌翻译的文档功能最省事(在中国大陆需要能访问谷歌)。
- 论文、说明书、报告,有表格、公式或双栏排版:用会重建版面的文档翻译,翻完后检查第 3 节列出的四个地方。
- 扫描件(在阅读器里选不中文字):得先识别出文字才能翻。DeepL 收扫描件,并自己处理这一步;谷歌翻译会把扫描页原样留着不翻。
1. 翻译工具从 PDF 里「看到」的是什么?
我们自己做文档翻译,天天和 PDF 里的文字打交道。为了让你看清楚,我们从 arXiv 下载了两篇论文,LLaMA 和 Mistral 7B,并用开源工具 MuPDF 的 mutool 提取了其中的文字。一个工具如果不识别版面结构,它拿去翻的大致就是这样的文字。下面每一处,先看它在页面上的样子,再看提取出来的结果(单独一行的 … 表示省略了若干行)。
1.1 表格变成一列数字
LLaMA 论文的表 3 比较了 10 个模型在 8 项测试上的成绩:
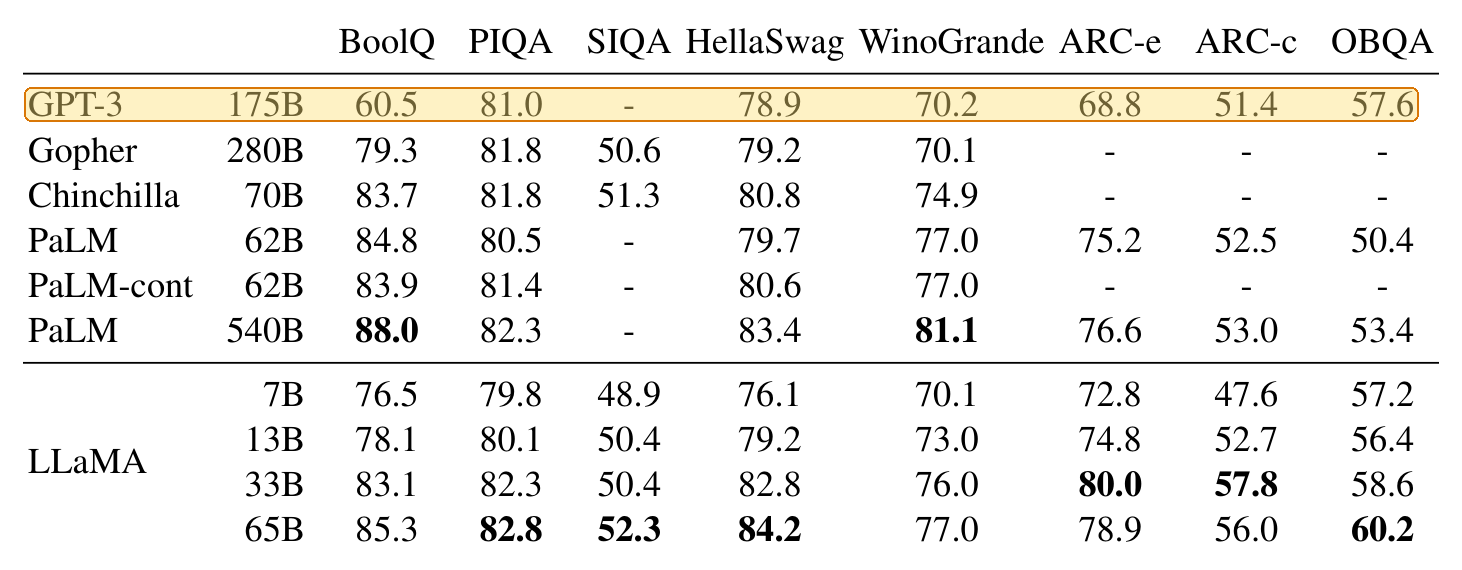
提出来以后是 102 行:5 行表头,然后一行一个值。下面是前 16 行,从 GPT-3 到 57.6 这 10 行就是图里标黄的那一行。
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
单看文字,完全不知道哪个数字对应哪一项测试。如果把这些粘贴进翻译框,拿回来的还是一列数字。字翻了,表格却没了。
1.2 一句话中间,夹着一整张表
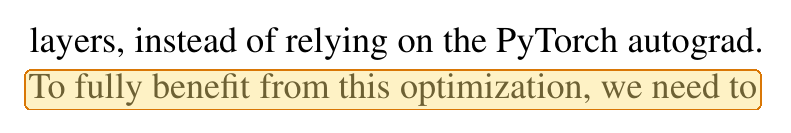
LLaMA 第 3 页的最后一句,停在「we need to」:
后半句跑到第 4 页表 3 下方左栏的开头:
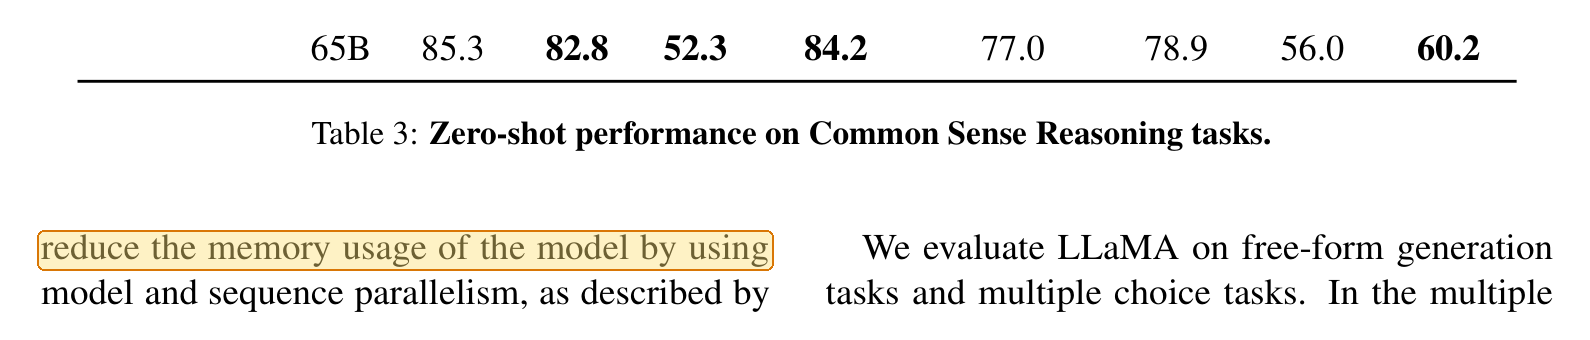
在提取出来的文字里,一条脚注、一次分页、表 3 的全部 102 行和表题,统统夹在这一句话中间:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
两页之后又来了一次:第 5 页停在「…the textual description and tests in a」,而「docstring.」要到第 6 页表 7 的下面才出现,中间隔着表 7 的 44 行和 7 行表题。
如果工具按页翻,或者照提取顺序翻,它拿到的就是两截看似互不相干的残句。反映在译文里,就是一页末尾话没说完,另一半句子莫名其妙地掉在了下一页的表格下面。
1.3 下标和分数变成了别的东西
Mistral 论文里,有个变量写作 h 带下标 i:
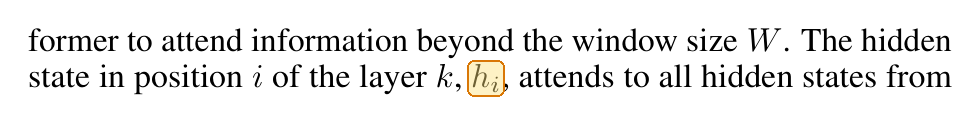
文字提出来后,下标没了,只剩 hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
翻译工具没有理由把它当成变量,在它眼里,这就是一个普通的英文单词「hi」。
分数的情况更糟。LLaMA 论文里有一处数值是 4d 的三分之二,写作 ⅔·4d,其中的 ⅔ 是上下叠排的分数:
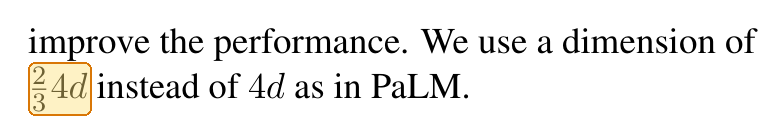
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
三分之二个 4d,变成了 34d。上标、分数线、数学字体里的符号,在 PDF 里都只是摆在特定位置的一个个小图形。文字一旦提出来,这些字还在,位置却丢了。
1.4 单词在行尾被拆开
双栏排版的论文为了左右对齐,会大量在行尾断词。LLaMA 这一篇里,有 242 处普通单词被连字符断开。你可能会想,把连字符删掉、两半拼回去不就行了?但遇到名字里本来就有的连字符,这招就不管用了:
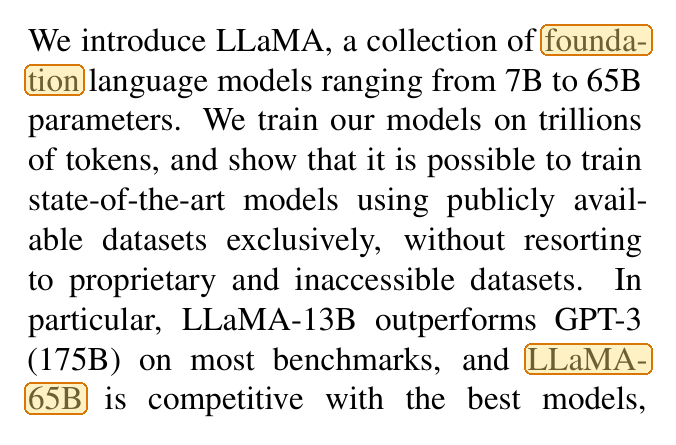
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- 和 tion 确实要去掉连字符才是一个词。但 LLaMA- 和 65B 之间的连字符是模型名字的一部分,删了反而是错的。
我们只用一种提取工具,试了两篇用 LaTeX(学术界常用的排版软件)排出来的论文。Word 导出的 PDF、扫描件或是其他提取工具,输出结果可能不一样,但要找的就是这四类问题。
2. 有哪几种翻译方法?
谷歌和 DeepL 的情况来自它们自己的帮助页(2026 年 10 月 7 日查看)。DeepL 还在帮助页里建议:如果对 PDF 译文不满意,可以试试上传原始文档(如 .docx、.pptx)再翻。这也和我们开头的建议一致。
表格里的最后一种办法,正是意扣翻译(Equalang翻译)的文档翻译功能要解决的问题,也是我们最熟悉的一种做法。它在翻译前,会先把被分页截断的句子拼回完整的一句;合并过的单元格、多行表头会按原本的结构重建,而不是拍平成一列;公式也不会当作乱码丢弃,遇到夹在文字中间、难处理的公式,可以打开公式优化。
它做不到和原版一模一样:译文比原文长,换行和字号就会变,所以原本排得很满的页面,翻完还是值得再看一眼。文档翻译目前支持中文、英文、日语、韩语、西班牙语、法语等多种语言。
3. 翻译完成后,检查这四处
- 表格:表头还在对应的列上吗?数字有没有变?
- 分页处和表格下方:读一读每页的最后一行,以及每张表下面紧接着的那句话。话说了一半就没了下文,是文本被切开翻译留下的最常见痕迹。
- 公式和变量:抽查几个夹在文字中间的公式。看有没有字母被当成单词翻掉了,或者分数变成了别的数字。
- 页数和链接:如果翻完的页数和原来差很多,说明有文字丢了或者挤出了原本的页面。试着点一两条目录,看能不能跳到对的地方。
参考资料
- Touvron 等,《LLaMA: Open and Efficient Foundation Language Models》,arXiv:2302.13971v1,CC BY 4.0 许可。
- Jiang 等,《Mistral 7B》,arXiv:2310.06825v1,CC BY 4.0 许可。
- 谷歌翻译帮助中心,Translate documents & websites,2026 年 10 月 7 日查看。
- DeepL 帮助中心,Translate PDF files,2026 年 10 月 7 日查看。
- 实测方法:2026 年 10 月 7 日用 MuPDF 1.25.6 提取文字,命令
mutool draw -q -F txt -o out.txt in.pdf。文中配图截自两篇论文的原页面,标黄是我们加的。