学术论文PDF翻译实测:
 意扣 Equalang
导读
实测16页BERT与27页DPO两篇公开英文论文的PDF翻译效果,逐页展示双栏、表格与公式优化前后的真实对比,并附双语PDF阅读技巧与积分估算方法。
关键词:学术论文PDF翻译; 论文双语对照PDF; PDF公式翻译乱码; Zotero论文翻译; 英文文献阅读工具
把双栏英文论文复制进聊天框,或者直接用浏览器网页翻译打开 PDF,结局往往差不多:左右两栏的句子串成一团,实验表格里的数字错位,行内公式变成一堆找不到上下标的乱码。赶上开题或写综述要连读十几篇文献,光是在原文和译文之间来回核对行号、找回丢失的分数线,就能耗掉大半个下午。
怎么把论文翻成能顺畅读下去的中文,取决于你的阅读习惯:如果英文底子不错、只是偶尔卡在长难句,用浏览器划词插件或 Zotero 划词翻译就够了,完全不用动原 PDF 的排版;如果你习惯折腾开源工具、愿意自己配环境和大模型 API 密钥,可以用 PDFMathTranslate 这类本地脚本在自己电脑上生成译稿;如果你不想维护本地环境,希望在网页或 Zotero 里直接拿回保留排版的译文 PDF,下面用意扣(Equalang)的文档翻译功能演示真实论文跑出来的效果——哪些地方原样保住了,哪些地方不开特定选项会踩坑,都摊开来看。
很多人在用付费文档翻译前还有一个顾虑:不知道翻出来到底能不能看,怕扣了积分却拿到一份排版散架的废稿。2026 年 10 月 26 日,我们团队自己挑了两篇大家熟悉的开源英文论文跑了一遍英译简中实测:一篇是双栏排版、实验表格密集的 BERT 论文(NAACL 2019,16 页),另一篇是单栏、满篇推导和行内公式的 DPO 论文(arXiv 2305.18290,27 页)。下面逐页拆解这两份生成结果,顺便讲清楚什么时候该开「公式优化」、双语 PDF 怎么左右并排看,以及动手前怎么算清积分。
双栏排版与实验大表:16 页 BERT 论文实测
计算机和工程领域的顶会论文大多是紧凑的双栏排版,带着页脚出处、蓝色的交叉引用链接,以及动辄十几列的数据对比表。在测 16 页的 BERT 论文(Devlin 等,NAACL 2019)时,我们关掉了「公式优化」开关。系统在开始前给出的报价与最终实扣一致,都是 179.09 积分,大约 3 分钟跑完。
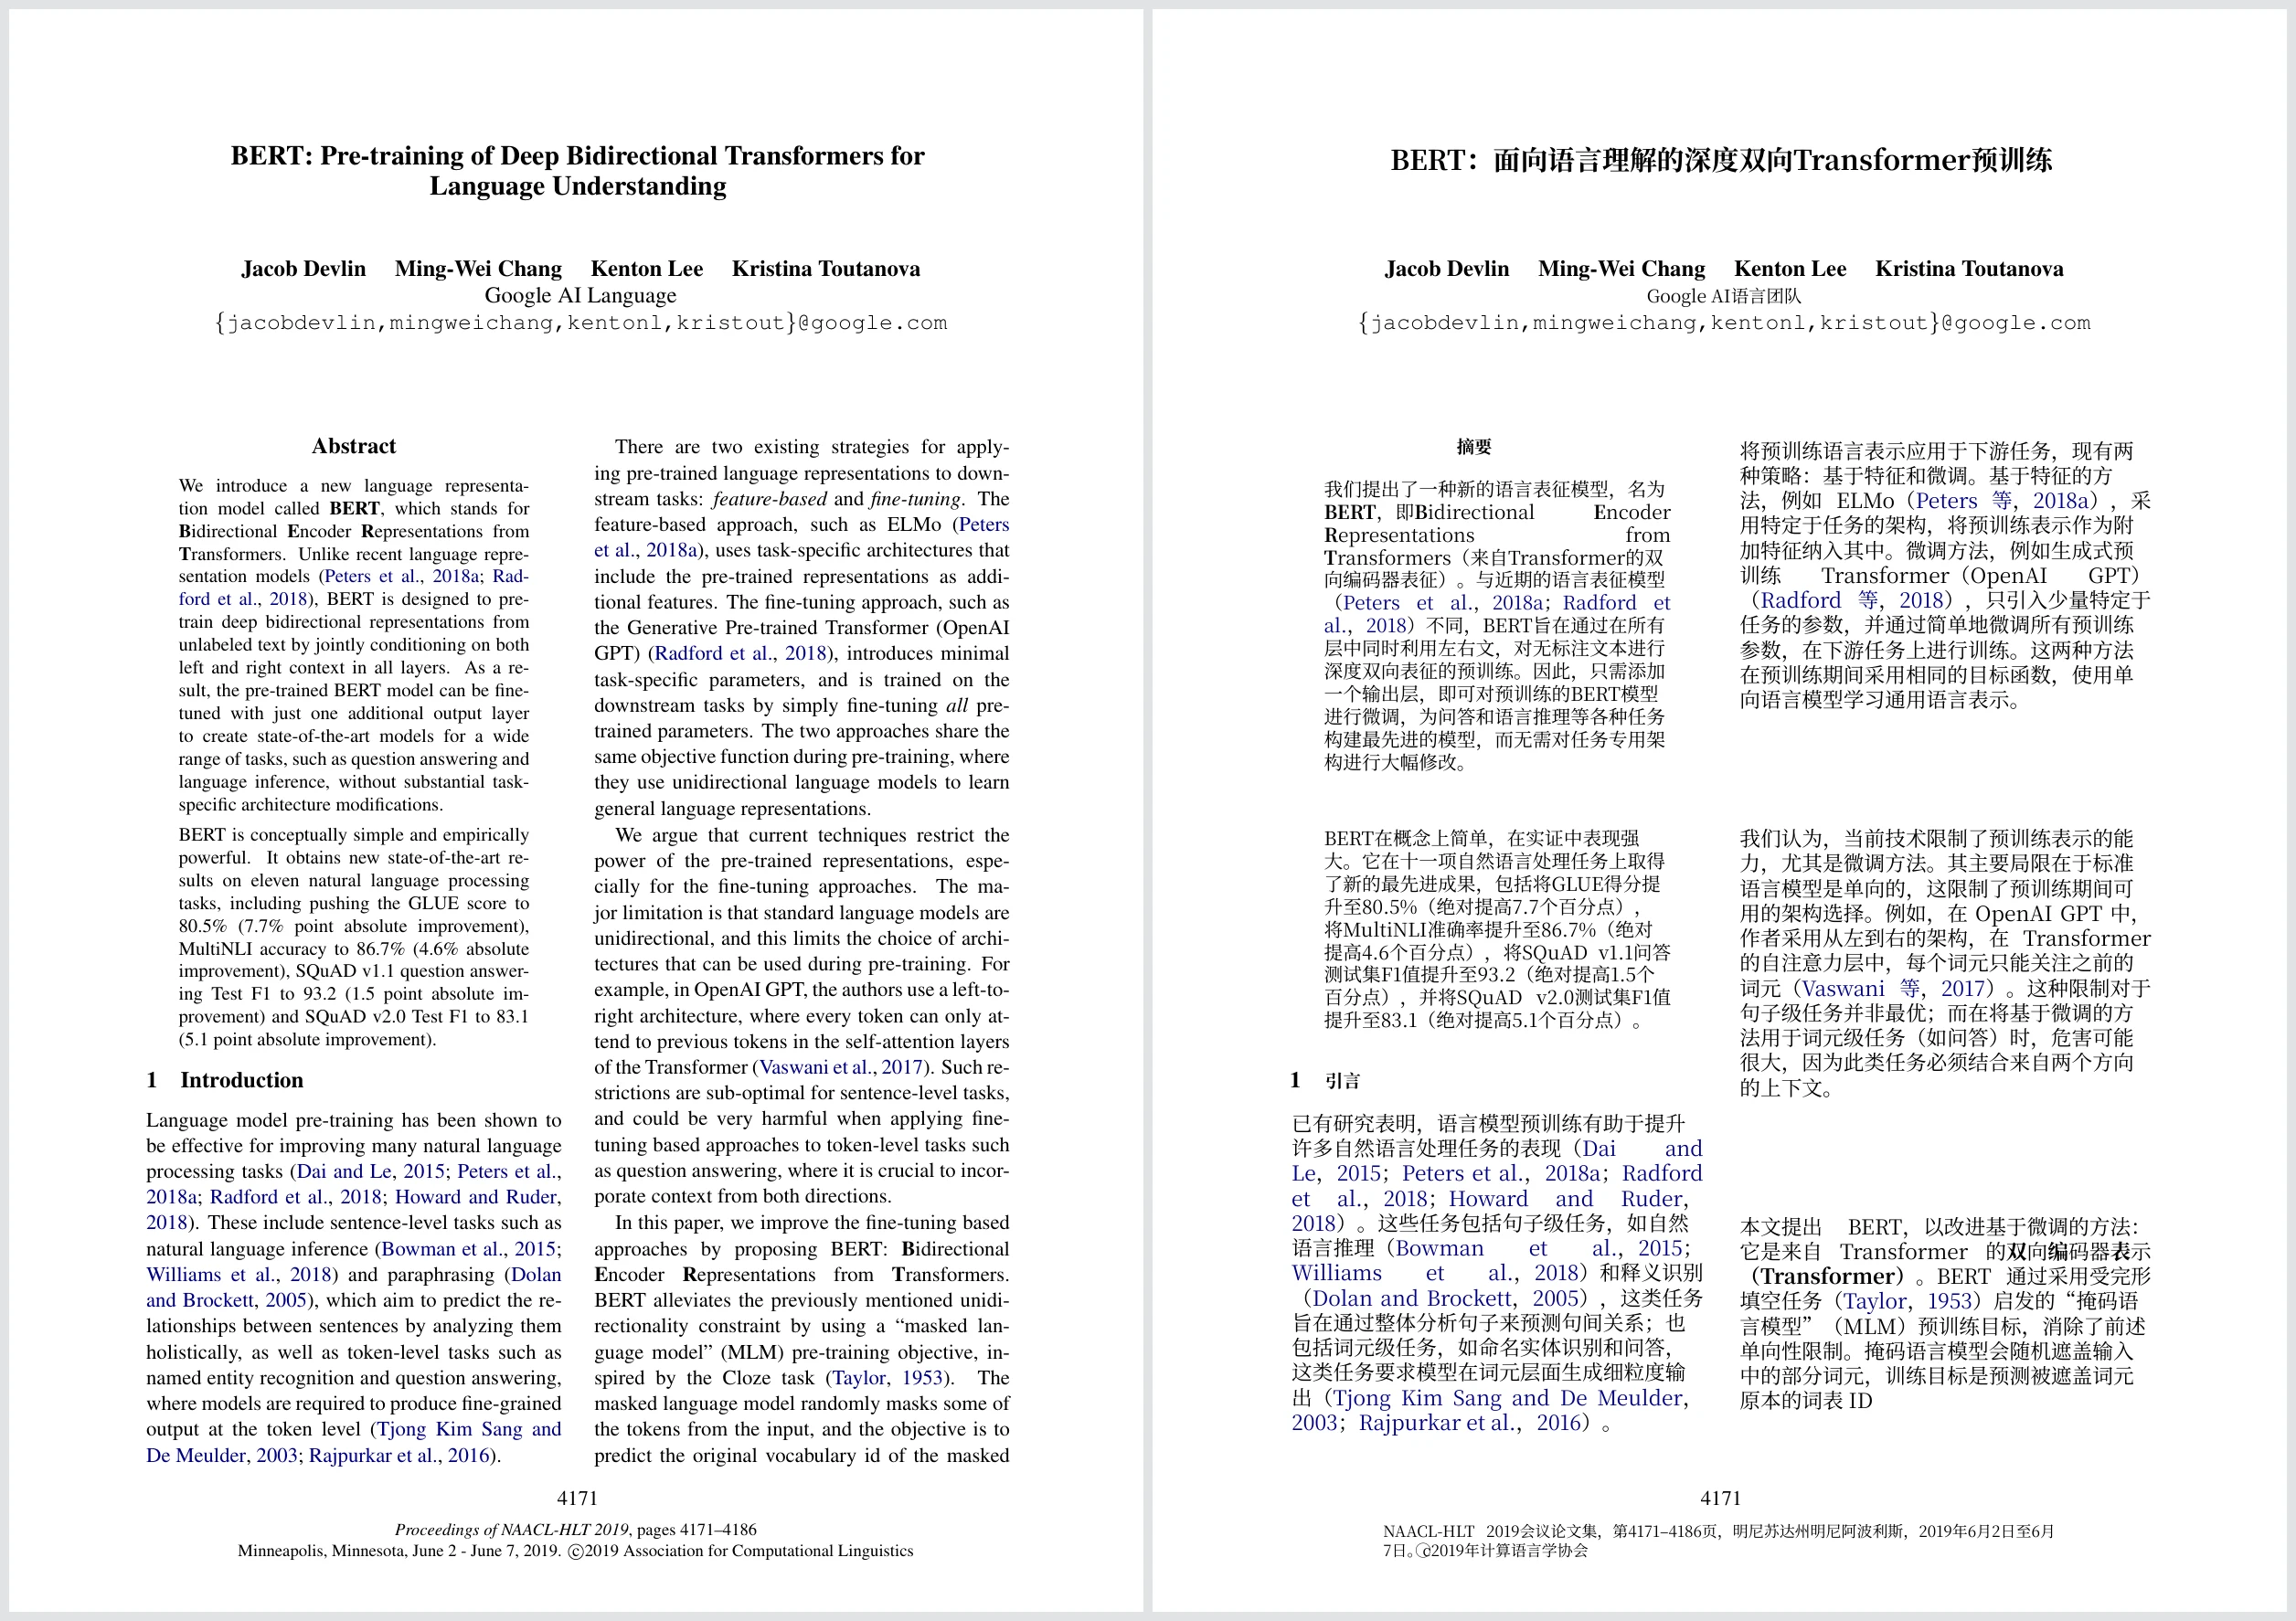
先看第 1 页的整体版面,双栏论文最容易散架的几个地方都稳住了:
- 分栏与层级结构:大标题、作者与机构、章节编号、页码以及底部的会议页脚都留在原来的位置;跨栏、跨页被截断的英文长句会先拼回完整句子再翻译,没有出现左栏半句、右栏半句拼不上的情况。
- 蓝色引用链接:正文里的文献引用依然保持蓝色高亮,点击后还能正常跳转到文末参考文献。
- 段落留白变化:因为同一句话译成中文后字符变短,摘要底部与正文第一节之间的垂直留白比英文原稿稍微大了一点。
看懂实验部分离不开表格。拿 BERT 的表 1(GLUE 基准测试结果)来说,一旦翻译时把数字搞丢或者把加粗的最优值挪了列,这张表就彻底没法看了。
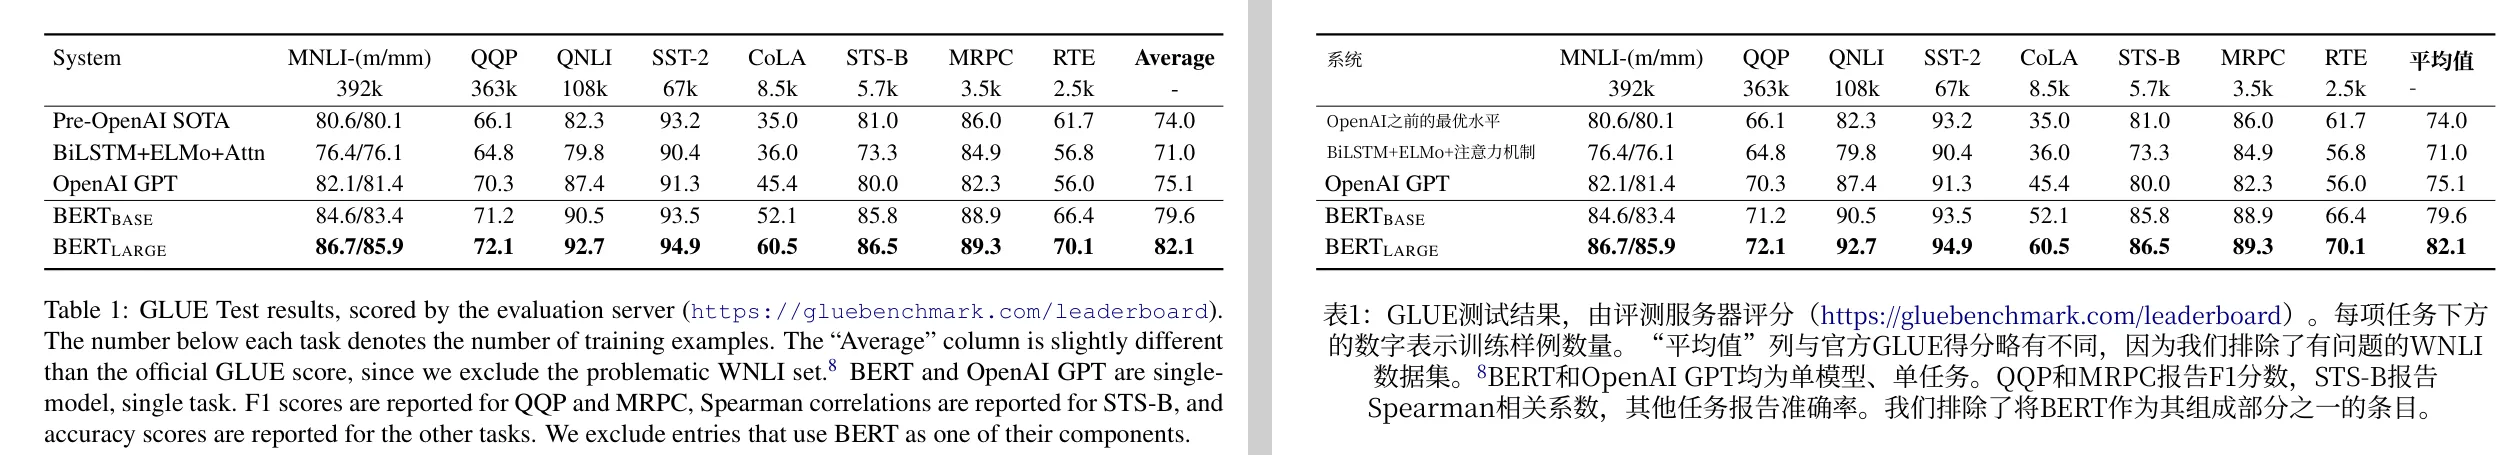
从表 1 的实测截图可以看到,表格里的每一个小数、每一处加粗的最优得分都原封不动,只有表头和行名被译成了中文(例如表头译为「系统」「平均值」,分组行译为「OpenAI之前的最优水平」)。这样在扫读实验结论时,既能直接看中文表头理解对比维度,又不用担心模型评测数据被篡改。如果你平时经常处理这类排版复杂的文献,可以参考怎么翻译学术论文 PDF 并保留版式。
什么时候该开「公式优化」:BERT 与 27 页 DPO 论文对比
为什么测 BERT 时关掉了「公式优化」?不开这个开关,正文里的数学公式会变成什么样?翻到 BERT 第 6 页右栏的 4.2 节,下图是开启公式优化后的同一段,未开启时的结果见下文文字。
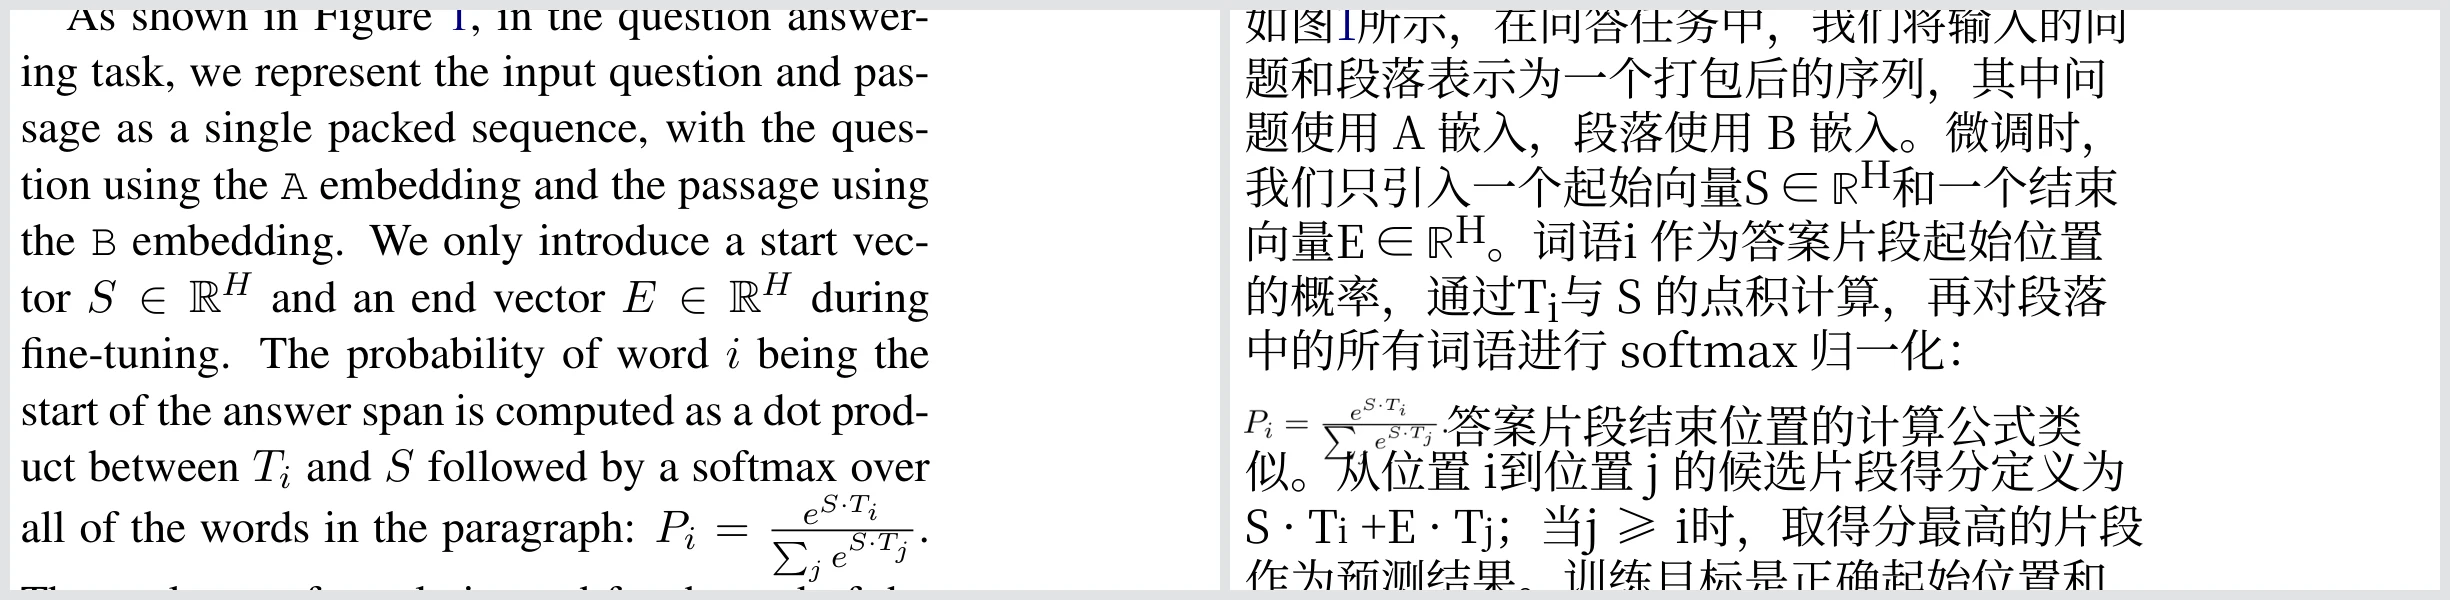
在第 6 页右栏的 4.2 节正文里,原文用了一个带求和符号的行内分式 P_i = e^{S·T_i} / Σ_j e^{S·T_j} 来表示词元作为答案起点的概率。未开启公式优化时,这个行内公式被拍平成了一行普通字符(Pi =eS·TiPj es · Tj),分数线和上下标都没了;而在 2026-11-06 取原文第 1、3、6、7 页节选开启公式优化重跑后,译文中的分式、上下标以及 S ∈ ℝ^H、E ∈ ℝ^H 的上标都得以还原,分式字号比正文略小,紧接其后的中文说明也正常排布。
这正是「公式优化」开关要解决的问题。开启公式优化每页另收 10 积分,如果是偏综述、实证分析或人文社科类的论文,正文里几乎没有复杂行内算式,关掉它就省下这笔按页计的费用(像 27 页的 DPO,就是 270 积分)。但只要遇到推导密集的机器学习、物理或数学论文,这每页 10 积分就非常关键。
为了看开启后的真实差异,我们接着跑了 27 页的 DPO 论文(Rafailov 等,arXiv 2305.18290),这次打开了「公式优化」。任务基础翻译用量为 258.33 积分,加上 27 页的公式优化费用 270 积分(10 积分/页),合计报价并实扣 528.33 积分,耗时约 16.5 分钟。
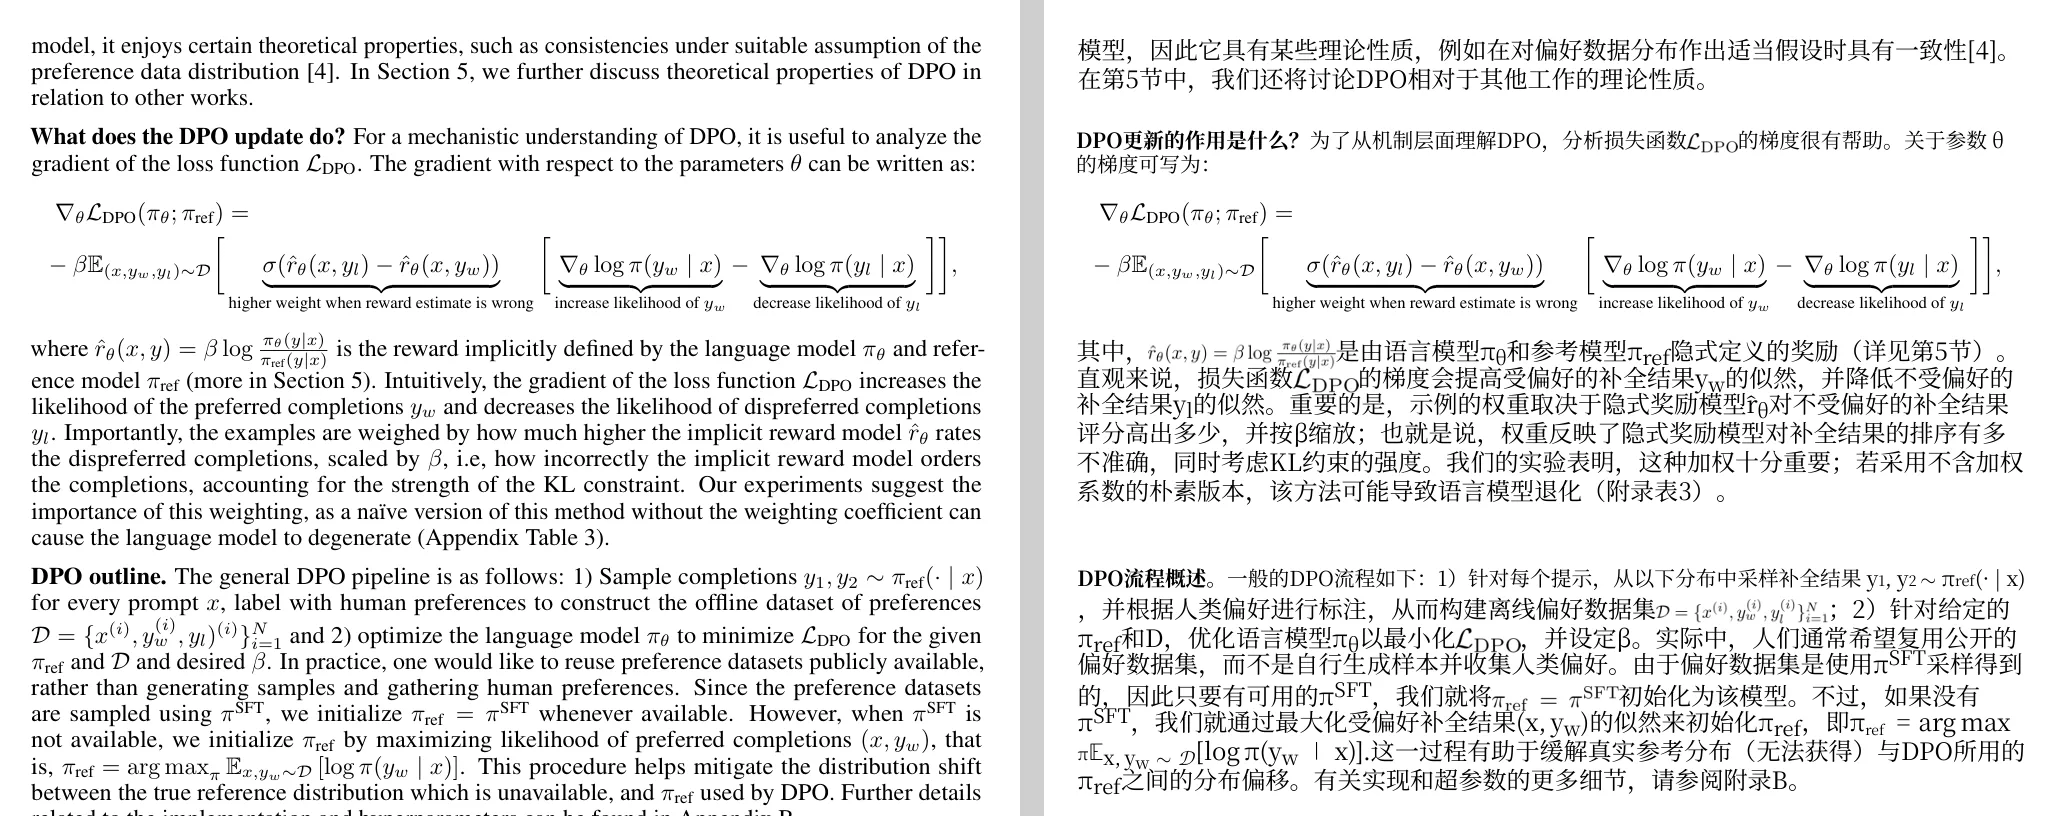
对照 DPO 第 5 页的译稿,可以清楚看到开启公式优化后的得失:
- 独立公式整块保留:页面中间那行带花括号的损失函数梯度公式完整保留了原样。需要注意一个细节:公式下方花括号里的英文小字批注属于公式整体的一部分,会保持原英文,不会翻成中文。
- 行内分式不再变乱码:散落在中文段落里的
r̂_θ(x, y) = β log ...以及带分式的行内符号都原样嵌在句子里,没有像前面 BERT 4.2 节那样被拍平。 - 局部行距偏紧:在连续塞了好几个行内公式的段落里,个别公式上下行的行距会显得有点挤,有轻微压字,但不影响认读文字和符号。
简单总结一下怎么选:如果一篇论文只有几处独立编号的大公式,或者你只打算粗略扫一遍实验结论,关掉公式优化就够了,省积分也更快;如果论文的核心贡献全写在段落里的行内公式和推导步骤上,建议在提交前勾上「公式优化」。关于公式密集型文献的更多处理细节,可以延伸阅读AI 与数学论文里的复杂公式怎么翻译。
拿到的两份文件,怎么实现左右对照精读
每次跑完一个 PDF 翻译任务,系统都会同时给两份文件:
- 译文 PDF:页数和原稿完全一样(比如 BERT 就是 16 页,DPO 就是 27 页),适合直接通读,或者发给习惯看纯中文的同门和合作者。
- 双语对照 PDF:每一页英文原稿后面紧跟着它对应的中文译页,原文与译文逐页交替(16 页的 BERT 生成后是 32 页)。
很多人下载了双语对照 PDF 后直接用默认单页模式往下滚,看个图表还得上下翻页,其实换个打开方式就能变成左右并排:
- 在网页翻译工作台里看:任务刚跑完时,不用急着下载,直接在网站的翻译工作台(Translation workspace)里打开,默认就是左边原文、右边译文并排显示,点开同步滚动就能逐段核对专有名词。
- 在 Zotero 或本地阅读器里看:如果你把双语对照 PDF 存到了本地,用 Zotero 自带阅读器打开后,在顶部菜单选「查看 → 平铺 → 奇数页起始」。因为奇数页全是英文原稿、偶数页全是对应的中文译稿,平铺之后正好左边是第 1 页原文、右边是第 1 页译文,翻页时两边永远严丝合缝。
平时用 Zotero 管理文献的话,也可以装一个意扣 Zotero 插件(支持 Zotero 7 至 10,Windows 和 macOS)。在文献条目上右键 PDF 附件就能直接发起整篇翻译,默认把译文或双语对照 PDF 作为子附件挂在原文献下面,还能跟 Zotero 同步。想对比不同文献阅读工具的配合方式,可以看读学术论文的翻译工具怎么选以及非英语母语研究者怎么高效读英文文献。
动手前怎么预估积分与耗时
把论文传上去之前,你不需要盲猜一篇 PDF 会扣多少积分。无论是在网页端上传文件,还是在 Zotero 插件里右键 PDF 附件,点下开始按钮前的确认框都会先列出这篇文档的页数、预计消耗的积分和当前账户余额,网站与插件共用同一个积分余额、按同一套标准计费:
- 基础文字量 + 公式优化按页叠加:基础积分按提取出的文字 token 量计算(官网换算基准是 1,000 token 约等于 750 个英文单词或 1,000 个汉字);如果勾选「优化 PDF 公式排版」,则固定按每页加收 10 积分计算。
- 用这两篇真实例子做参考:按意扣价格页面最小积分包 10 美元 1 万积分的基准来算(买得越多每 1 万积分越便宜),16 页的 BERT 论文不开公式优化扣 179.09 积分(不到 0.18 美元),27 页的 DPO 论文开了公式优化扣 528.33 积分(约 0.53 美元)。
- 取消或失败不扣费:看到报价后如果觉得太贵直接取消,或者万一遇到任务失败,预扣的积分都会原数释放,不会白扣。
最后提醒一句边界:上面展示的 BERT 和 DPO 都是由 LaTeX 原生导出的干净文字版 PDF;如果碰到扫描版 PDF,或者页面中间打着斜向大字水印的会议论文,排版还原度和耗时都会受影响。遇到几十页的长综述或预印本时,先看一眼确认框里的报价,再根据正文里行内公式的密度决定开不开公式优化,就能把积分花在真正需要精读的文献上。
参考资料
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of NAACL-HLT 2019, 4171–4186(CC BY 4.0):https://aclanthology.org/N19-1423/
- Rafailov, R., Sharma, A., Mitchell, E., Ermon, S., Manning, C. D., & Finn, C. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. arXiv:2305.18290(CC BY 4.0):https://arxiv.org/abs/2305.18290