翻译 AI 论文 PDF:
 意扣 Equalang
导读
读前沿 AI 论文时,独立公式结构与行内变量符号共同决定推导是否可读。以 DeepSeek-V4 论文实测为例,看不同工具在复杂求和与计算通信比表达式中的真实排版。
关键词:AI论文翻译, PDF公式排版, 行内公式优化, 求和公式, 计算与通信比
阅读前沿机器学习论文时,研究者与工程师经常需要在正文论述、数学符号推导与参数计算之间频繁切换。如果只是把零散段落复制出来阅读,文字脱离了原本的版式,公式与解析往往被割裂开,阅读时不得不频繁在阅读窗口与原 PDF 之间来回重新定位。
直接阅读保留原始版式的 PDF 译件,能让研究者更顺畅地跟随推导与算法流向。使用意扣(Equalang)翻译学术 PDF 时,页面主体结构与数学公式排布能更好地保持在对应位置,便于双语对照阅读。
我们以 DeepSeek 团队发布的 DeepSeek-V4 技术报告(单栏排版)英译中样本为例。其中公式部分展示了开启公式优化后的意扣译件,而各工具对照样本均沿用此前实际生成的译件,通过截取对应内容区域进行排版对照。
案例一:Token-Level 压缩公式与紧随解释
在 AI 论文中,读懂独立公式往往只是第一步。公式下方紧随的段落通常承担着关键的变量定义与推导衔接。如果正文里的行内符号发生形变或丢失分数线,读者在阅读解析时就容易与上方公式脱节。
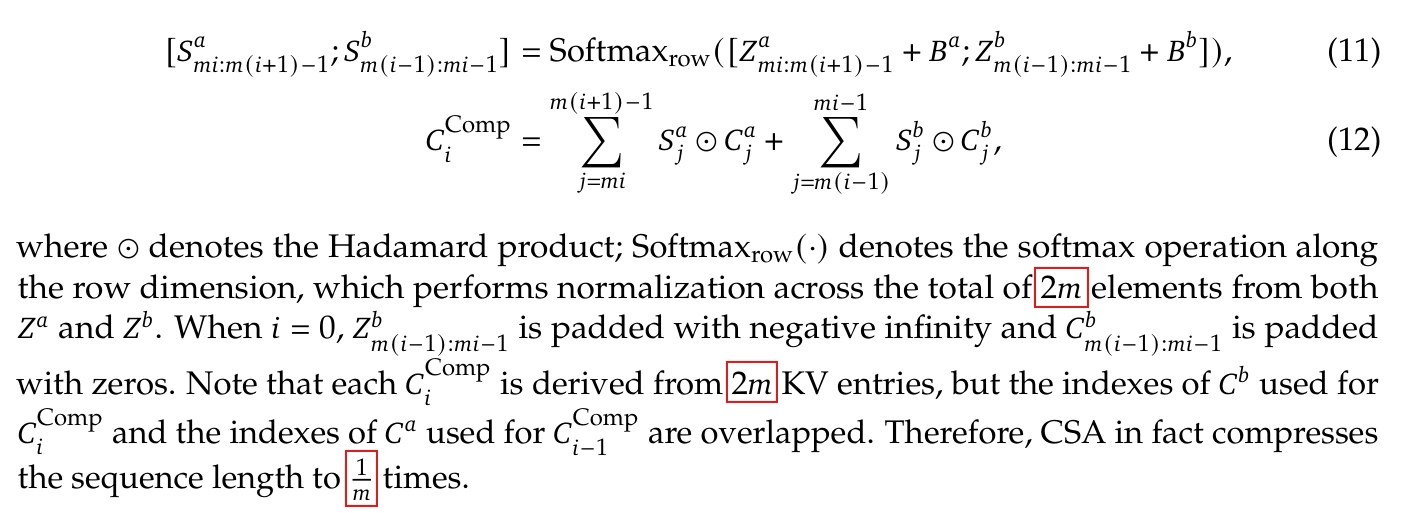
在 DeepSeek-V4 论文第 10 页,作者给出了 Token-Level 压缩机制的关键独立公式 (11) 与 (12)。其中公式 (11) 包含区间嵌套索引与 Softmax,公式 (12) 包含两个带有上下限的求和项相加,并涉及哈达玛积(Hadamard product)。紧随其后的正文段落则进一步解释了变量 Z 与 C 的嵌套区间下标、以 i 与 i−1 为索引的压缩变量、两处 2m,以及末尾带有水平线的分式 1/m(以下截图中红框为便于核对的阅读定位标注):
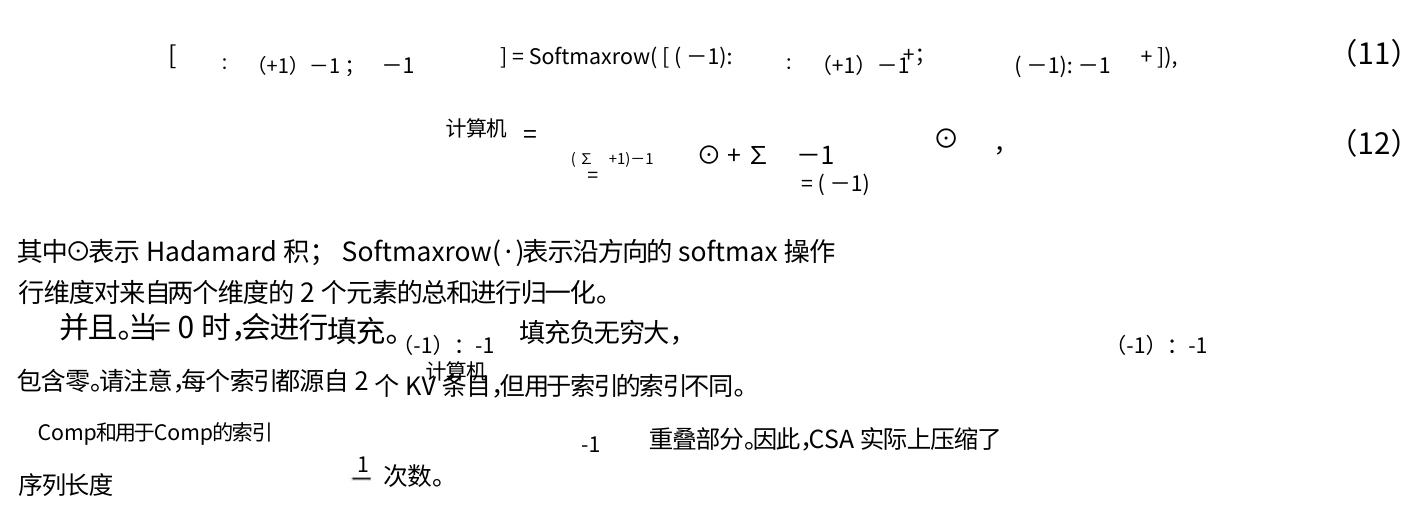
面对这类独立公式与密集行内符号共存的页面,各工具译件的处理效果呈现出不同层次的差异:
- Google 翻译样本:独立公式中的求和排布被打散,多个变量字母缺失,未能呈现原式的运算层级;随后的正文段落中,变量与下标符号也出现离散与缺失,打断了数学推导的连贯性。
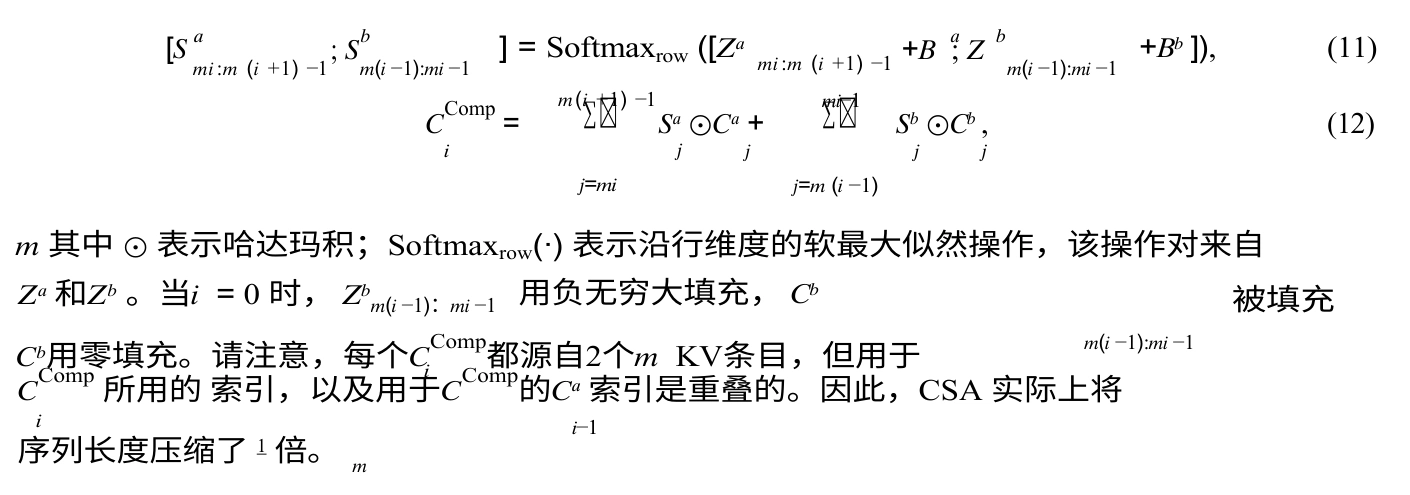
- DeepL 样本:公式 (12) 中的求和符号显示为异常方块符号,上下限与变量符号分离;随后的解释段落中,行内变量 C 与下标索引同样在换行间被打散。
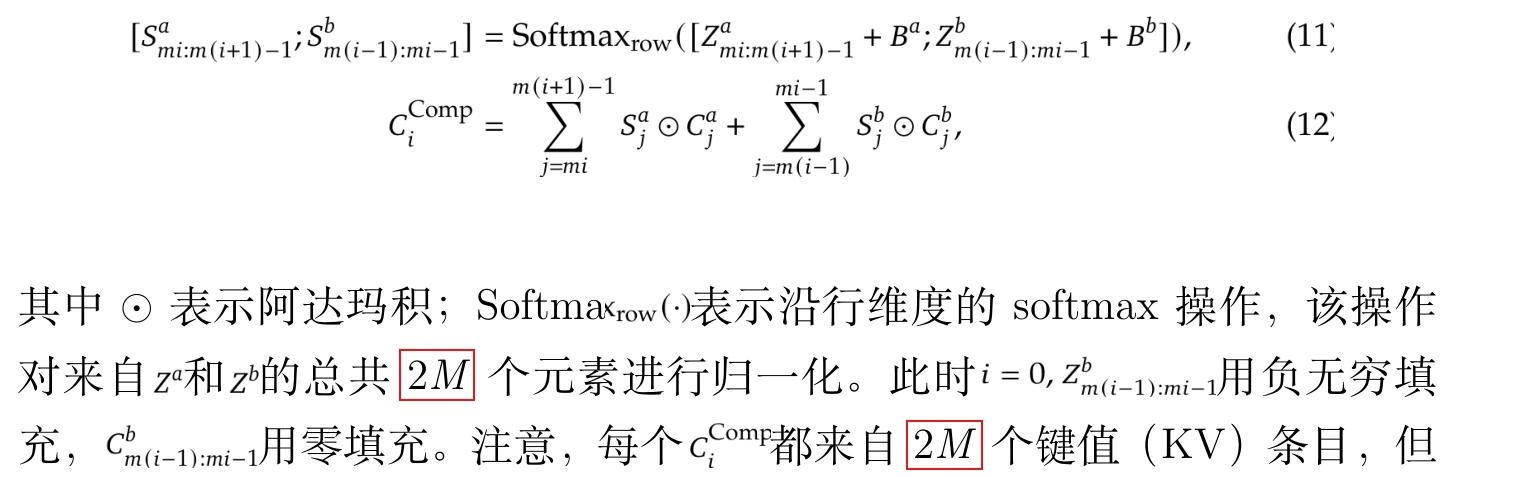
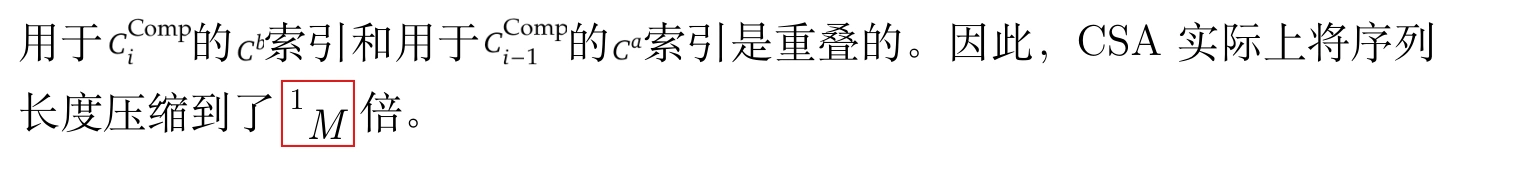
- 百度翻译样本:第 14 页的独立公式 (11) 与 (12) 结构保持可辨。在随后的正文解释中,两处变量 2m 呈现为大写 2M;由于排版正常分页,该解释段落延续至第 15 页顶部,末尾的压缩系数 1/m 呈现为上浮的 1 与大写 M,缺少了水平分数线。
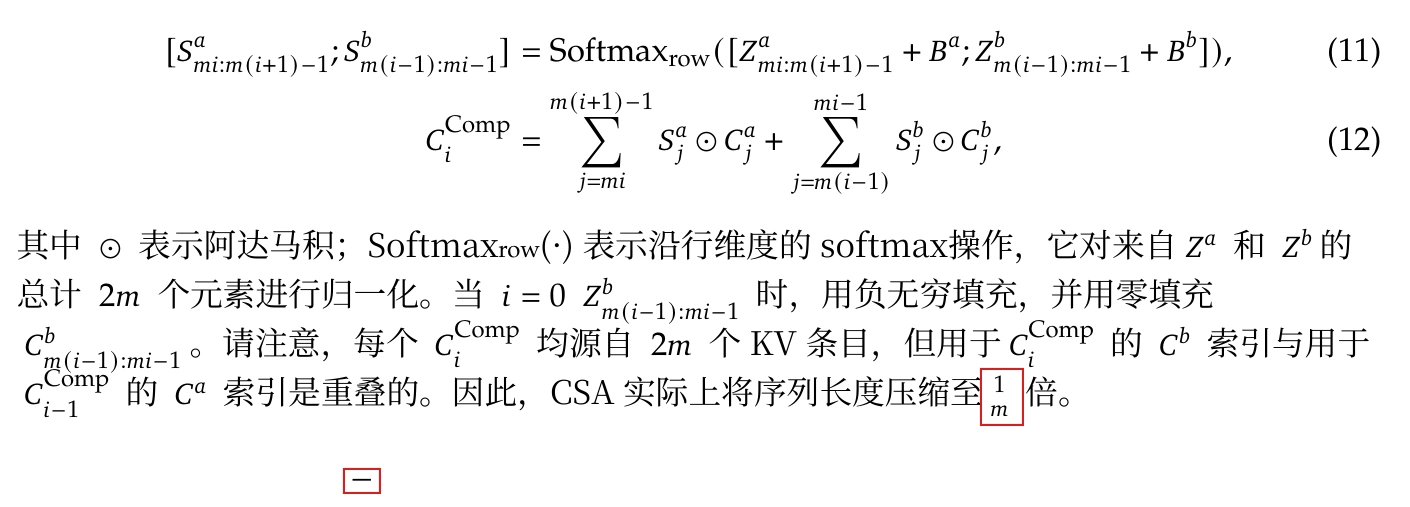
- 沉浸式翻译样本:独立公式 (11) 和 (12) 保持了规整的几何结构,求和项与上下标清晰,后续段落保留了主要行内符号。但在段落末尾的行内压缩因子处,字符 1 与 m 虽上下排列,水平分数线却与字符分离并留在段落下方原排版位置。
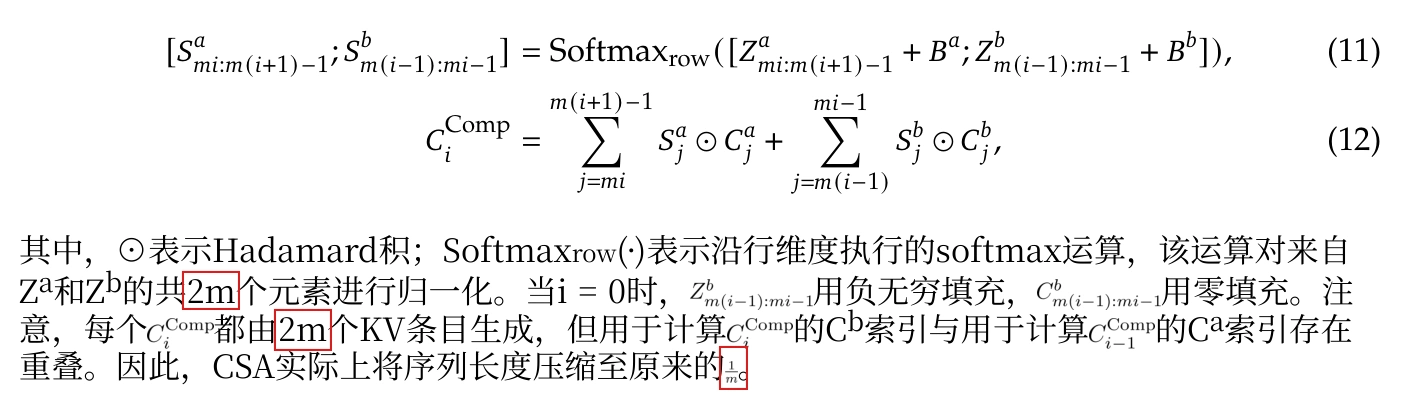
- 意扣(Equalang)译件(开启公式优化):针对包含密集数学推导的学术文档,意扣提供了公式优化选项。在开启公式优化后,所展示的公式 (11) 与 (12) 保持了求和项、上下限与编号结构;随后的正文段落中,两处 2m 变量保持小写,变量 Z 与 C 的嵌套区间下标以及压缩变量清晰可读,末尾的 1/m 准确保留了带水平线的分式排布。
案例二:计算通信比推导与参数表达式
在分布式架构与系统设计章节中,公式中的每一个系数(如参数 h、d)和下标(计算量 comp、通信量 comm)都直接决定表达式的准确性。如果字符在翻译中被替换或遗漏,整个推导关系就会失真。
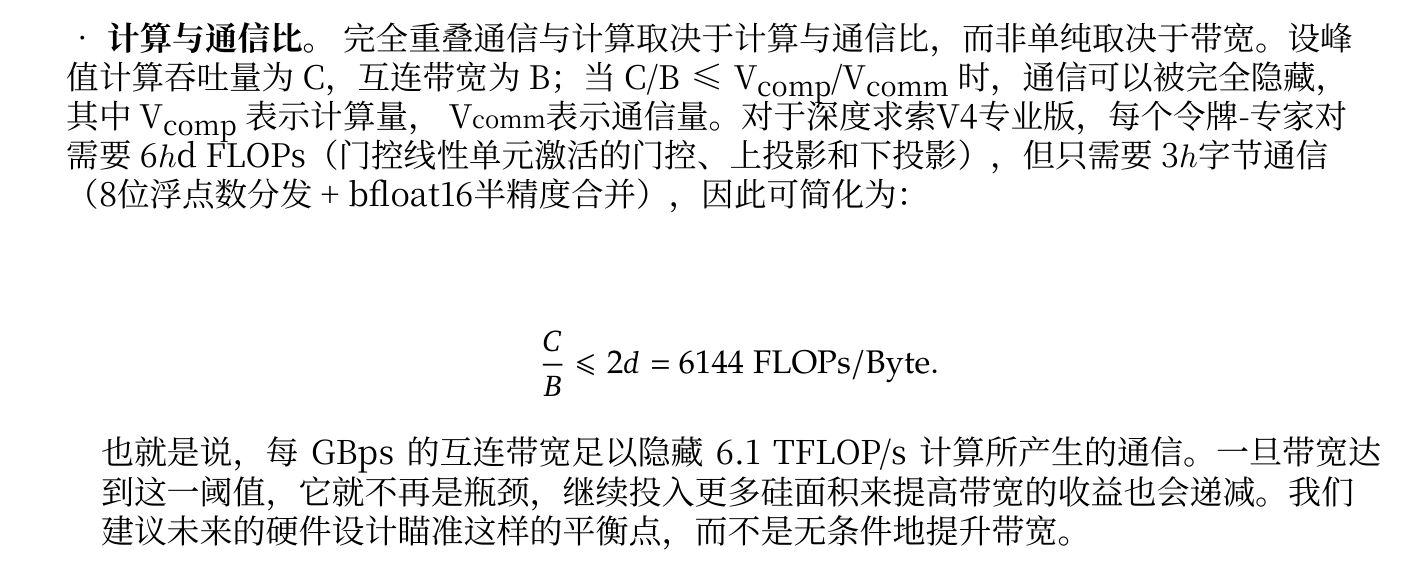
在 DeepSeek-V4 论文第 16 页,作者分析了计算量与通信量的比值关系。页面中包含行内比值 V_comp / V_comm、变量定义中的 6hd 与 3h 系数,以及独立的 C/B ≤ 2d = 6144 FLOPs/Byte 算力带宽比公式:
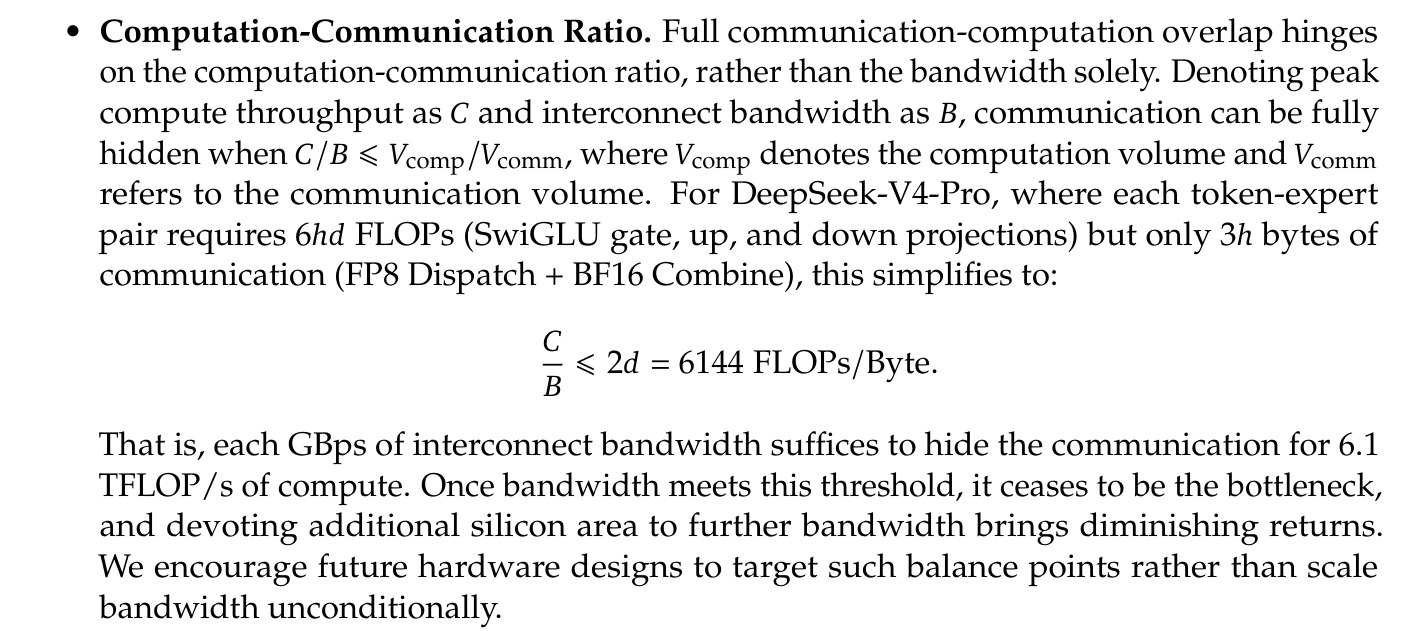
对比各工具在这一推导区域的表现,能更直观地看出变量保留对专业阅读的影响:
- Google 翻译样本:正文中的多个关键变量(如 C、B、V、h、d)以及不等式符号丢失,独立公式中也遗漏了 C/B 与 d,使得算力与通信推导出现断裂。(注:原译排版将后方的功耗预算段落连在同一行,截图完整保留以避免截断语句)。
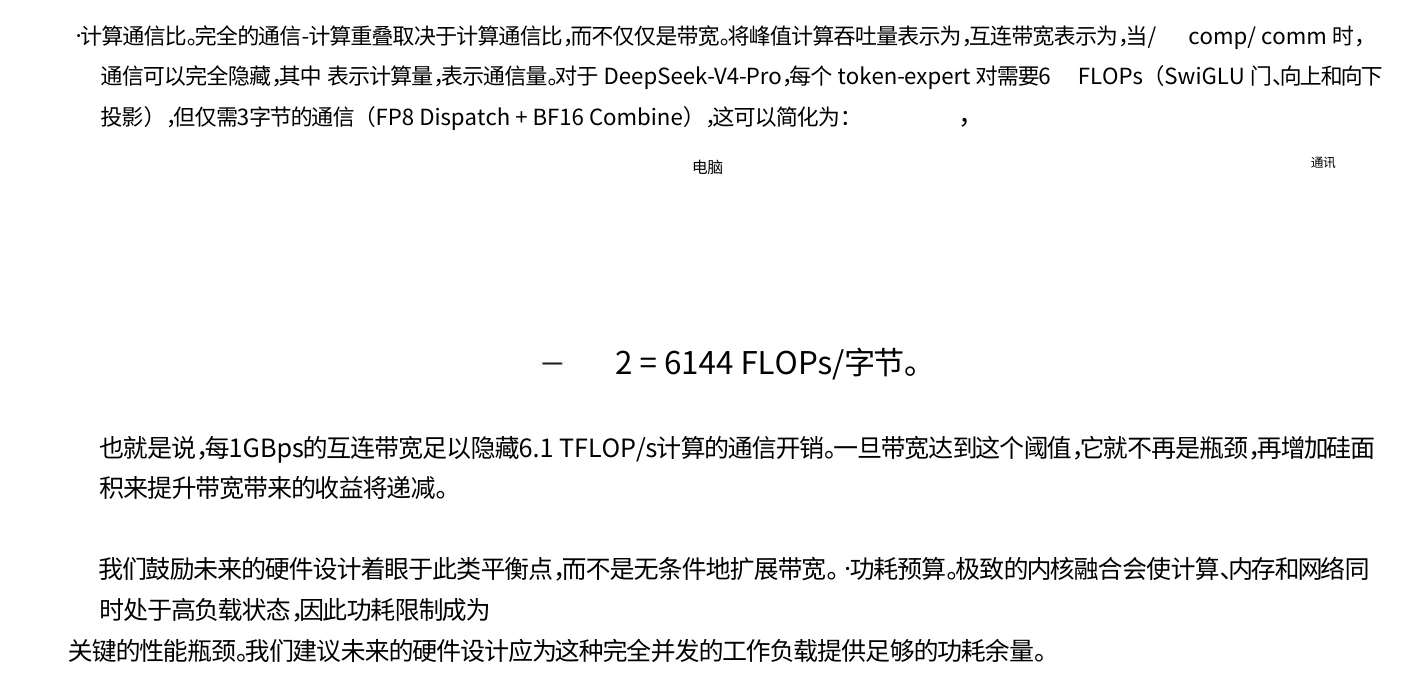
- DeepL 样本:保留了行内下标、6hd 与 3h 系数;独立公式中的 C/B 分式间距虽被拉长,但字符完整,数学推导保持可读。
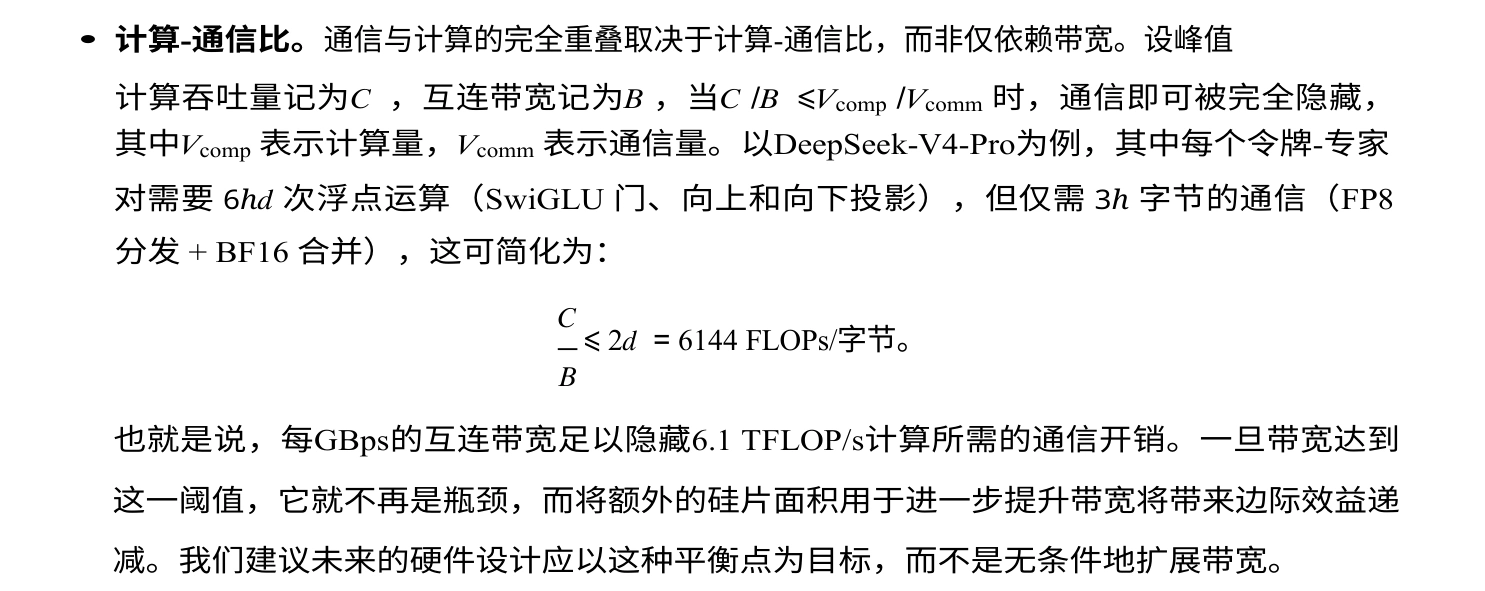
- 百度翻译样本:行内比值通过图片形式保留了下标,独立的 C/B 分式也保持完好。但在随后的变量解释中,该处文本呈现为 6D 与 3;变量 h 的缺失直接改变了计算量与通信量的表达关系。
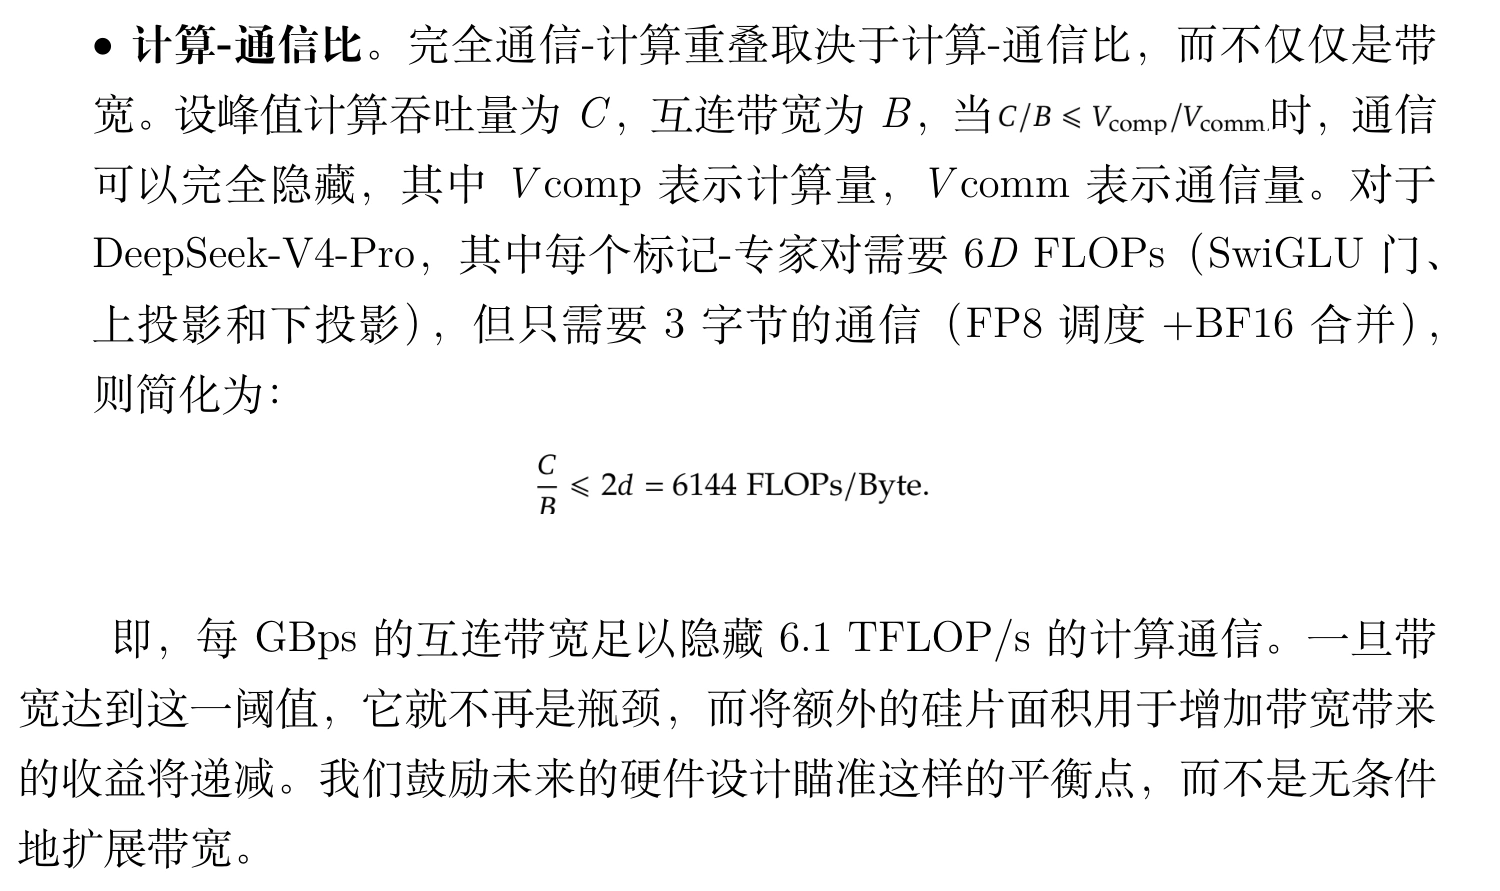
- 沉浸式翻译样本:将行内的 comp 与 comm 排成了同基线的普通文字(呈现为 Vcomp、Vcomm),属于排版基线层级的轻微变化;6hd、3h 系数以及独立的 C/B 计算比公式均完整保留,整体推导依然成立。
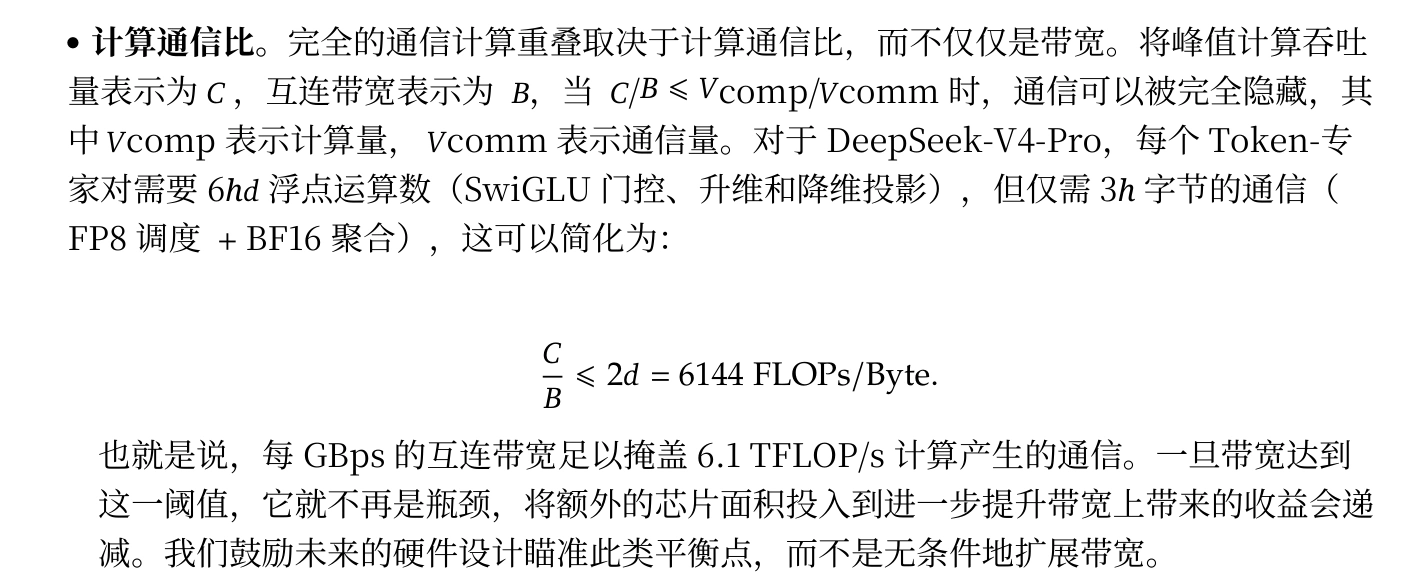
- 意扣(Equalang)译件(开启公式优化):在开启公式优化后,行内条件与定义中的 V_comp 与 V_comm 准确保留了下标层级,关键系数 6hd 与 3h 保持完整,下方的独立公式 C/B ≤ 2d = 6144 FLOPs/Byte 结构清晰,读者能够顺畅地核对推导过程中的各项表达式。
如何翻译 AI 论文 PDF
如果你需要阅读一份外文学术论文或技术白皮书,可以通过以下几步完成翻译:
- 打开意扣文档翻译页面,登录个人账号;
- 上传待翻译的论文 PDF 文件;
- 选择目标语言(例如简体中文),如涉及密集公式推导可开启公式优化,点击开始翻译;
- 等待系统处理完成后,直接下载翻译好的 PDF 文件。
在日常文献研读中,结合以下方法通常能获得更好的阅读体验:
- 双屏或分屏并排对照:在一侧屏幕打开英文原版 PDF,另一侧打开意扣翻译件,借助译件快速通读理解主干脉络;
- 定位核对细节变量:通读推导过程中遇到复杂的求和下限或全新符号时,随时在原版对应位置核对原始变量声明;
- 结合行内解释检验表达式:重点观察公式展开式与正文解析中的变量符号,确保推导关系与参数表达清晰一致。