学术论文PDF如何翻译?从架构图文到实验表格的阅读对照实践
 意扣 Equalang
导读
查阅前沿研究时,复杂图文排版与密集数据表格常给跨语言阅读带来阻碍。本文通过技术报告整页与临床论文全表样本,探讨版式对齐、术语对照与分屏阅读技巧。
关键词:学术论文翻译, PDF文献翻译, 图文排版对照, 表格翻译, Equalang文档翻译
追踪前沿研究或快速调研新领域时,阅读外文学术文献是许多科研人员、学生与专业工作者的日常工作。直接阅读英文 PDF 时,文献中往往既有密集的理论推导,又有复杂的模型架构图、图注说明、列表以及多维实验表格。逐段剪切复制容易打断阅读思路,而直接将整篇文档交给翻译工具时,版面错乱或表格数据移位又常增加核对成本。
学术文献翻译的核心价值,在于用顺畅的母语呈现研究脉络,同时保持图表与正文的相对位置,方便读者随时回溯原稿。本文结合两份真实的英译中样本——一份包含复杂模型架构图的技术报告,以及一份包含密集临床基线表的医学研究论文——从实际阅读体验出发,探讨学术 PDF 翻译在图文排版、数据表格及术语对照上的表现。(文内所有整页与整表图片均可点击查看清晰大图)
图文混排的版式还原:以技术报告整页为例
现代学术预印本与技术报告常常将大尺寸模型架构图、说明图注、项目符号列表与解释性正文融于同一页面。在这类单栏图文排版中,翻译如果破坏了图文顺序,读者就很难将文字描述与图示模块直观对应。
我们以 DeepSeek-V4 技术报告第 6 页的英译中样本为例。该页上方为大尺寸的多模块系统架构图,图下附有详细图注,下方则由项目符号列表与连贯正文承接:
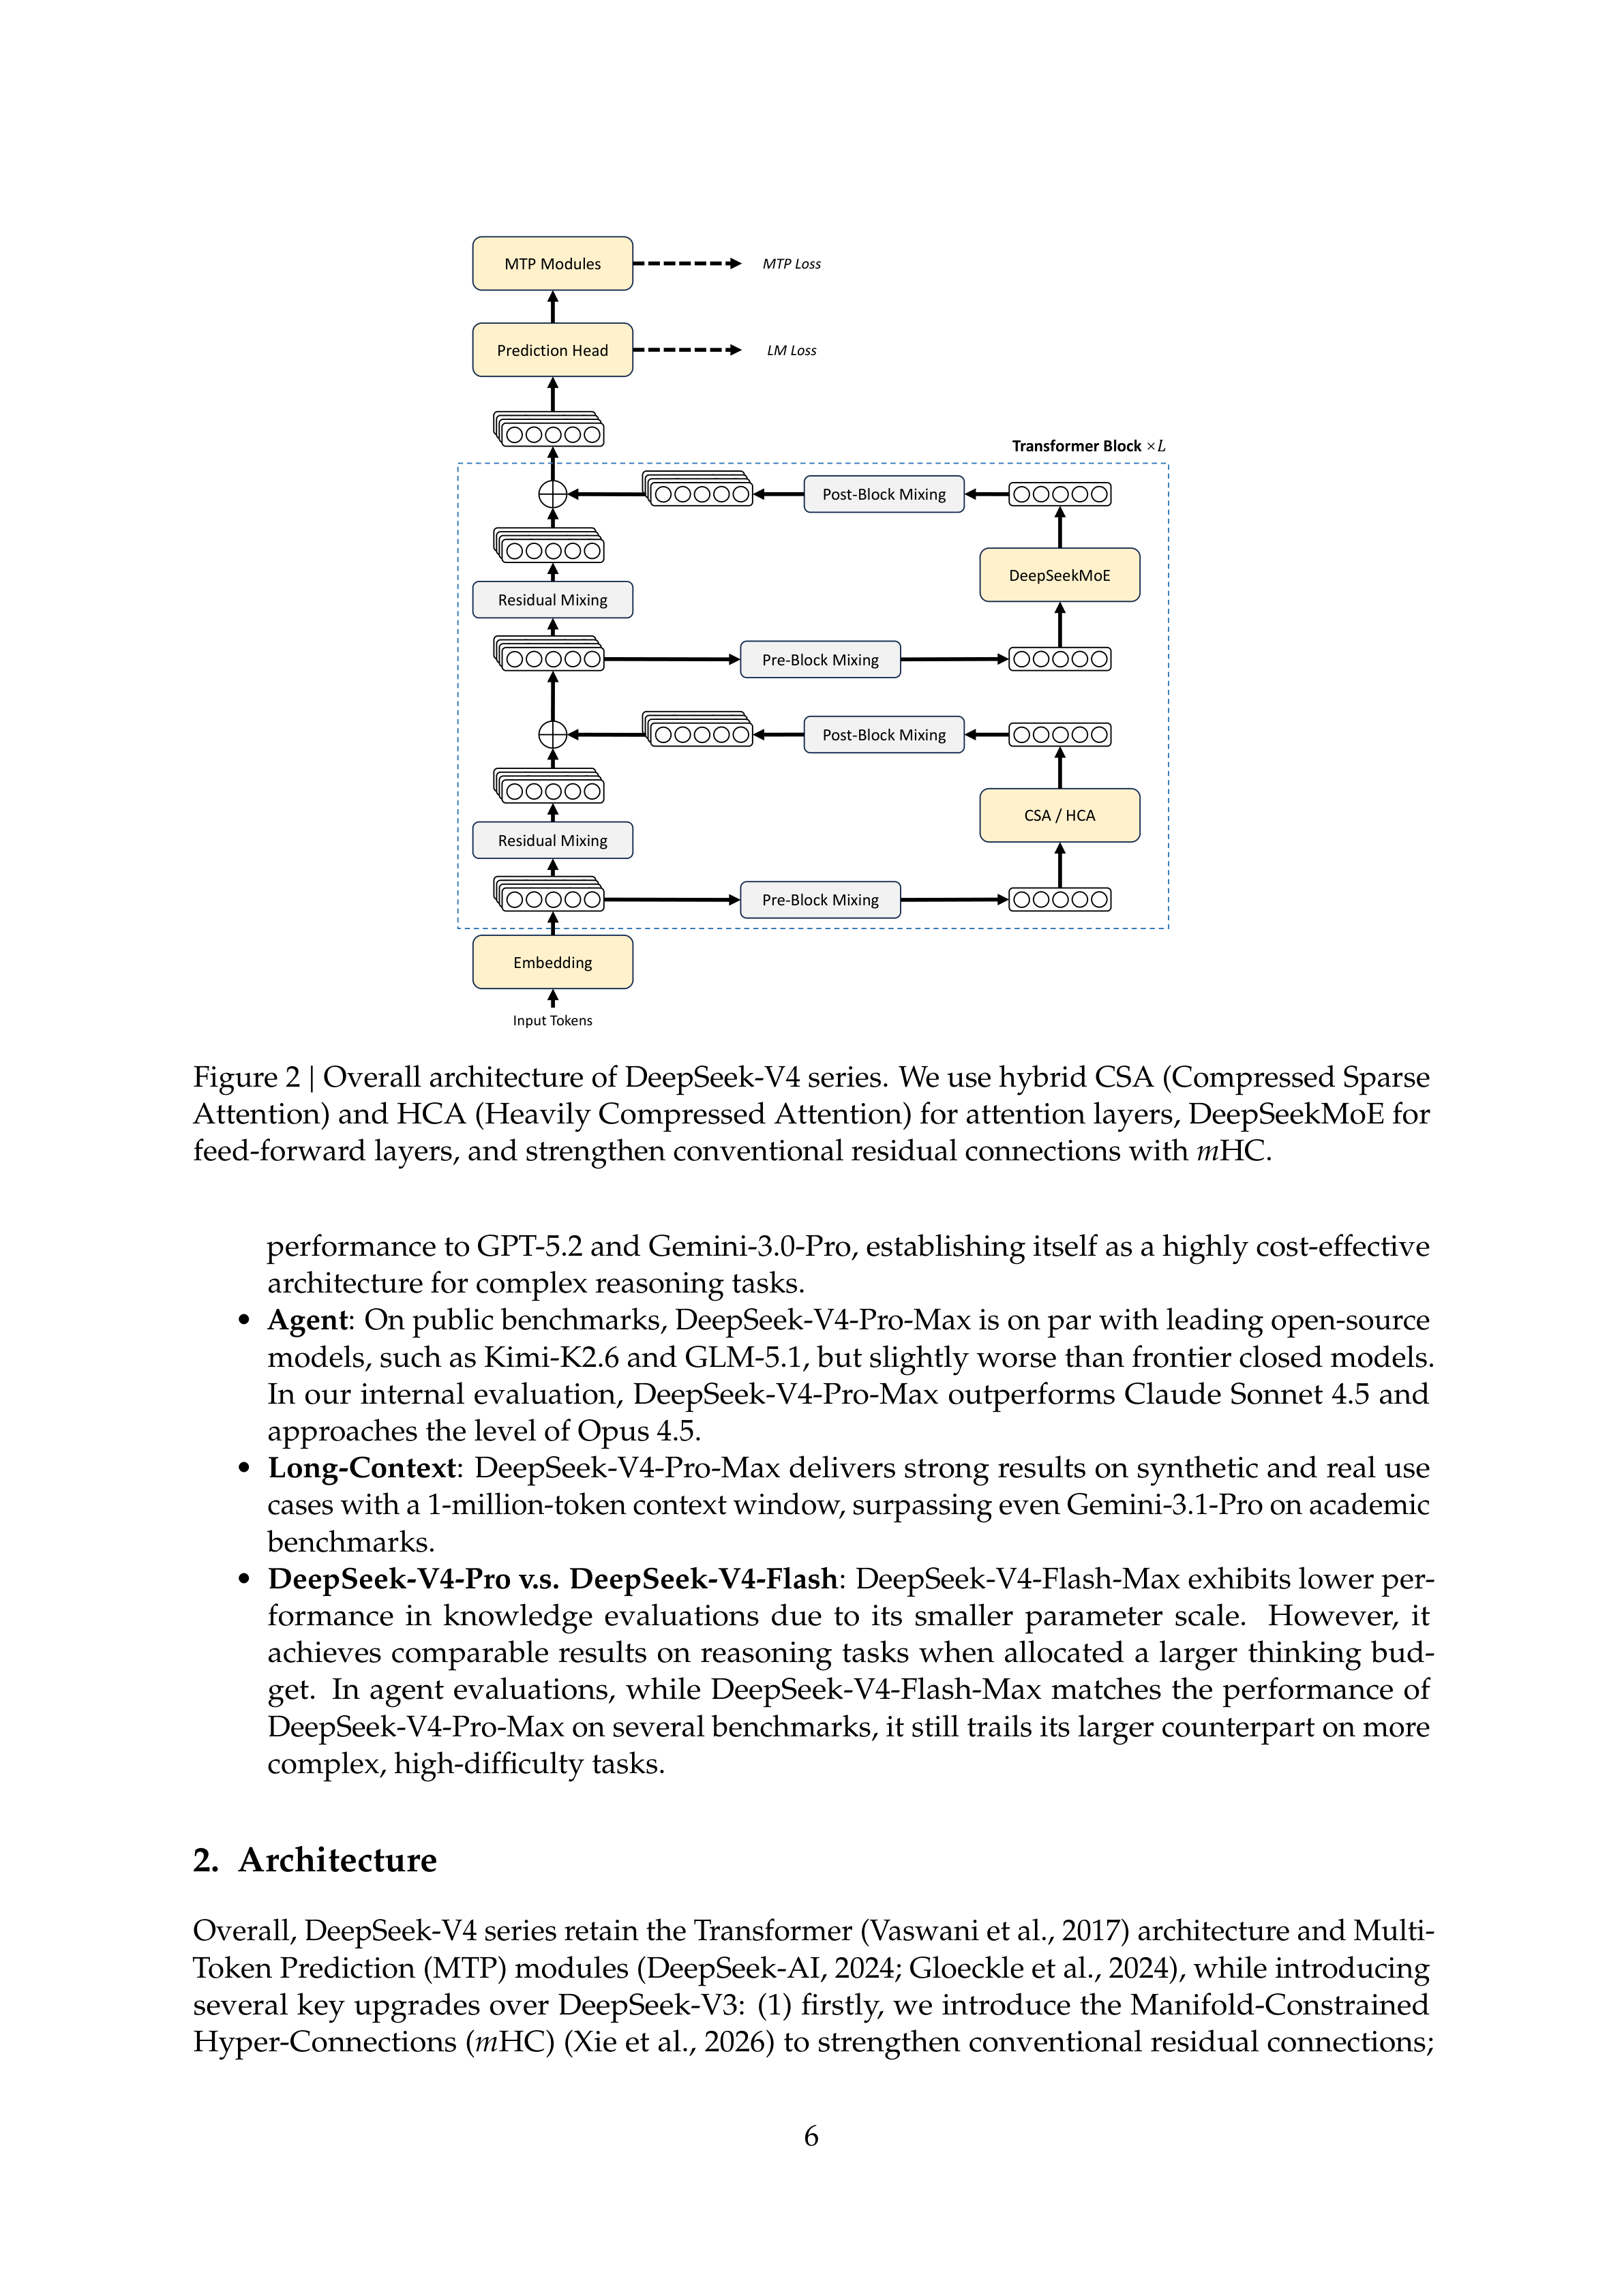
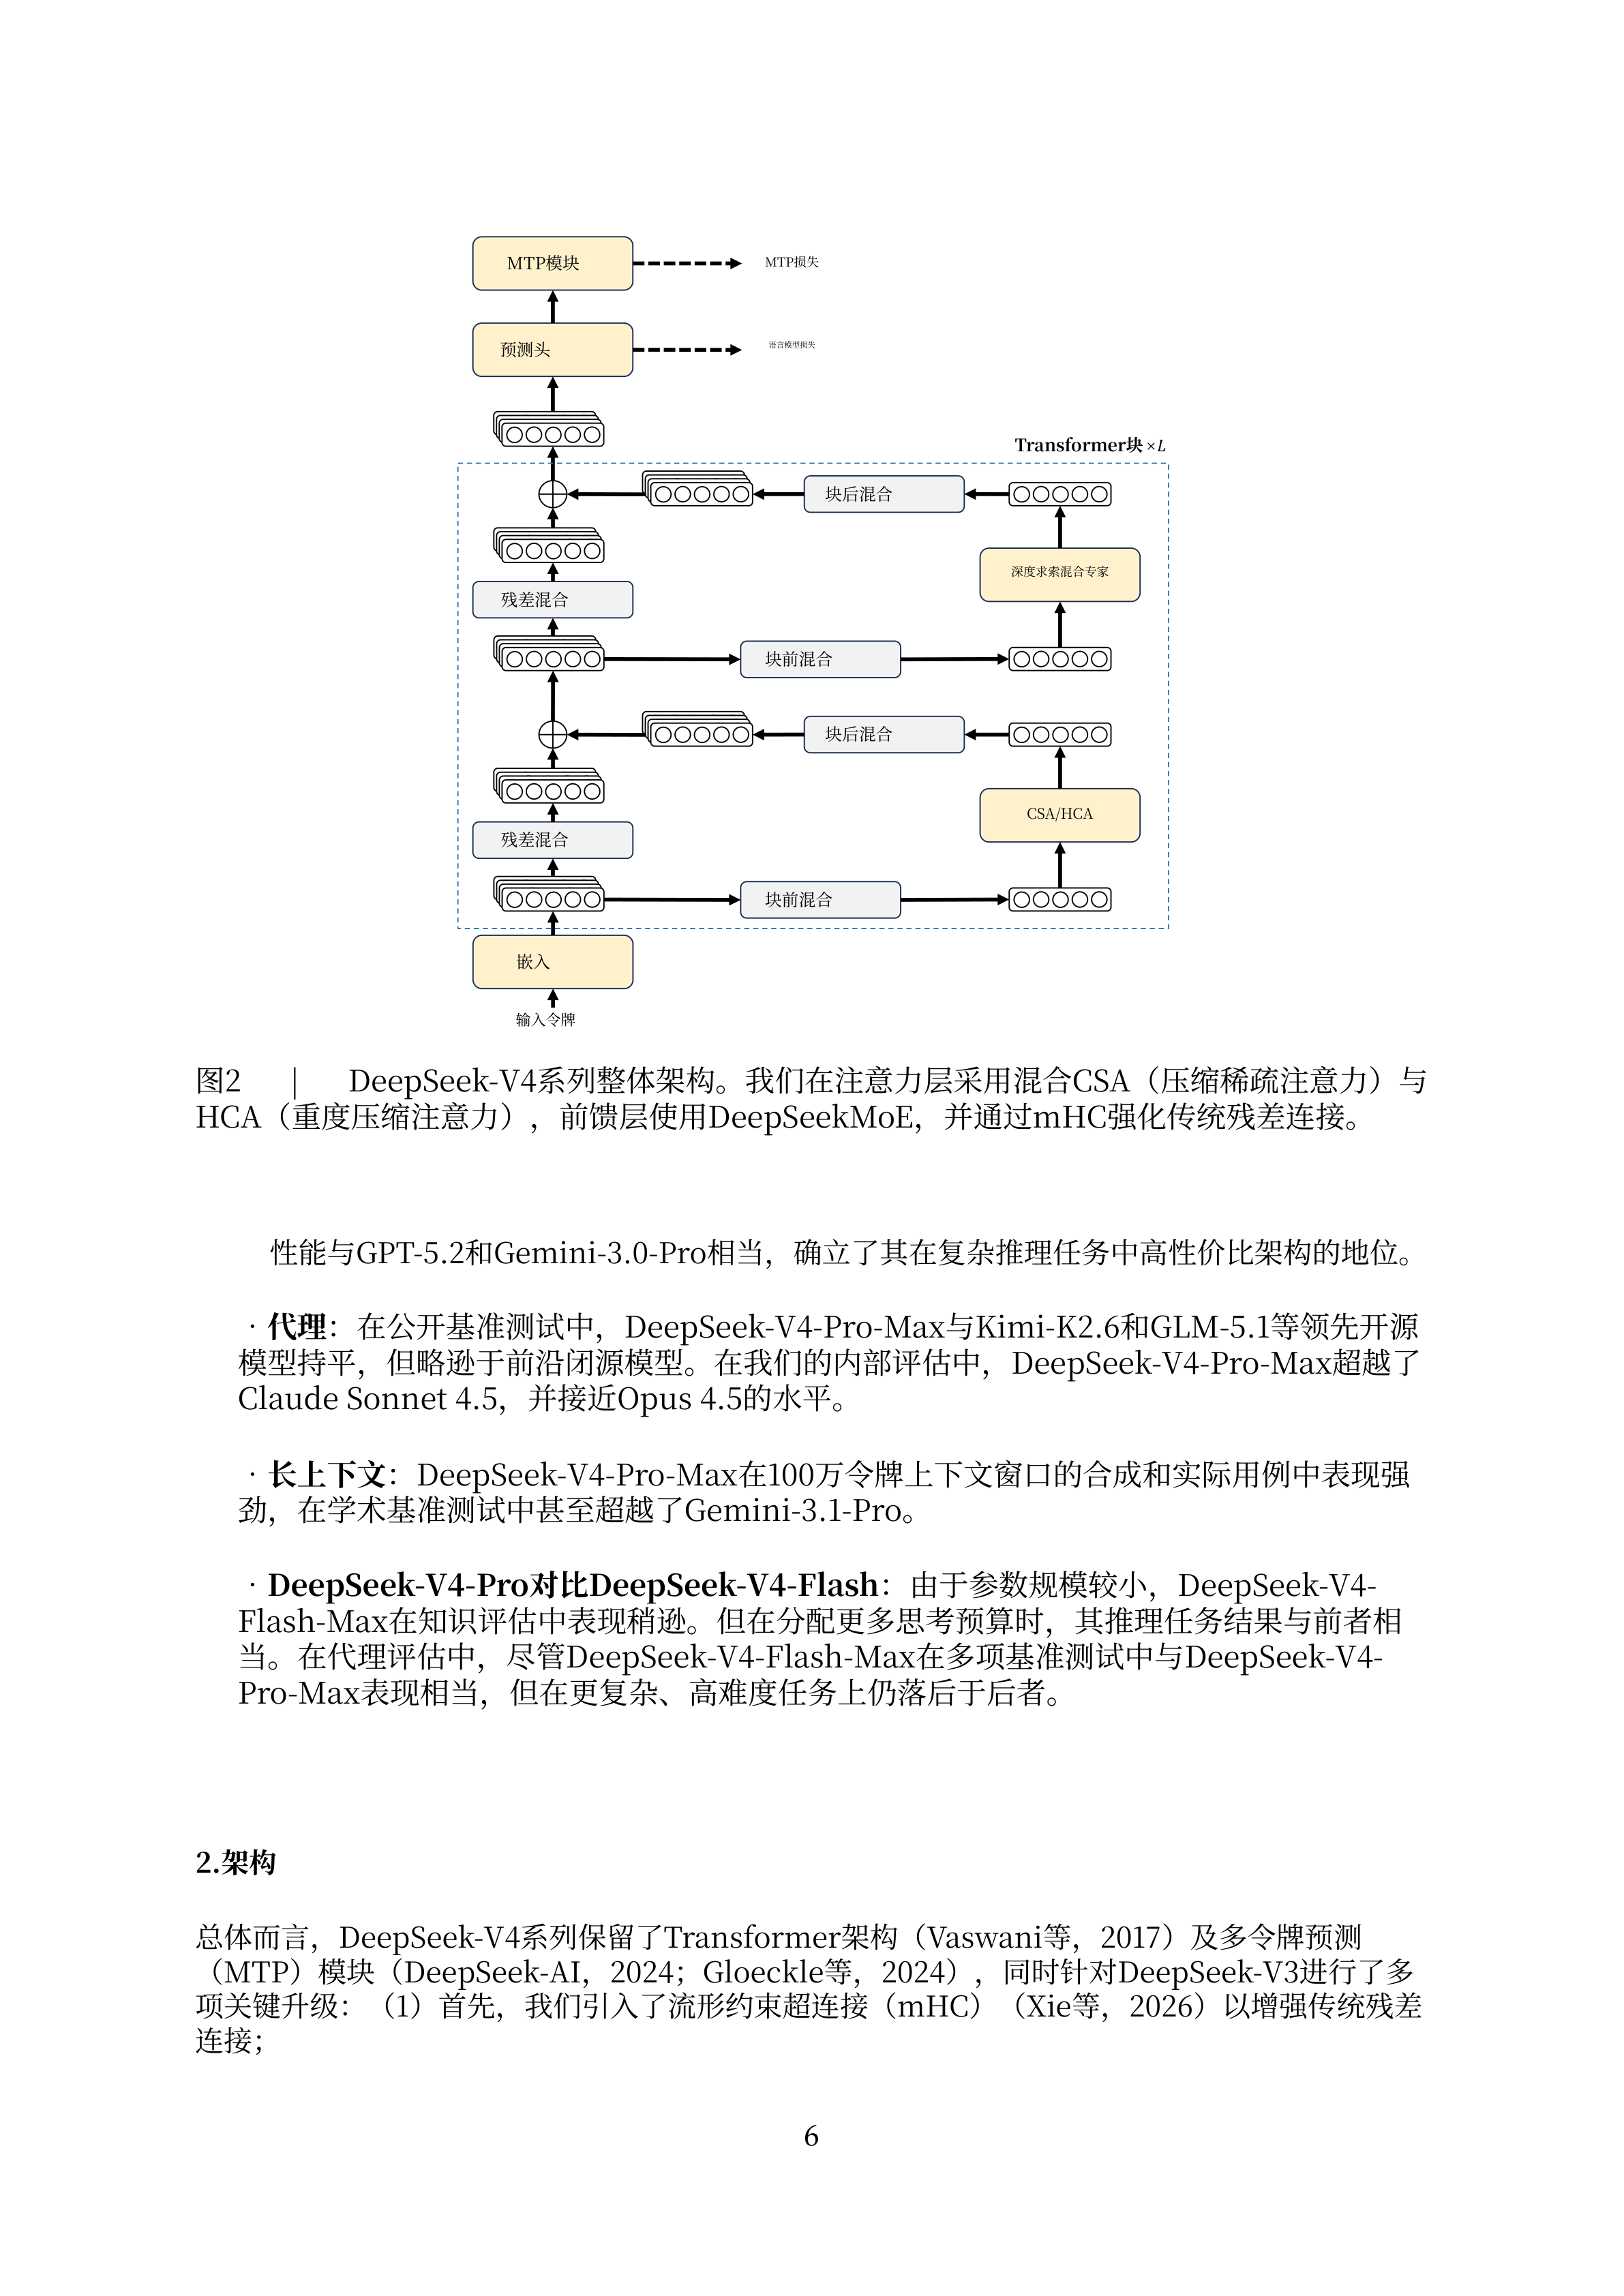
对比原件与 Equalang 译文整页可以看到:
- 图文相对位置保持稳定:架构图保留在页面上方核心位置,图注文字直接在图下方完成翻译,没有发生文字覆盖图示或图文错位跳页的情况。
- 列表与正文层次清晰:下方的项目符号列表与段落缩进清晰,保留了原报告论述的结构层次,便于读者在浏览图示后迅速阅读具体的文字说明。
实验表格与专业术语对照:以 Table 1 为例
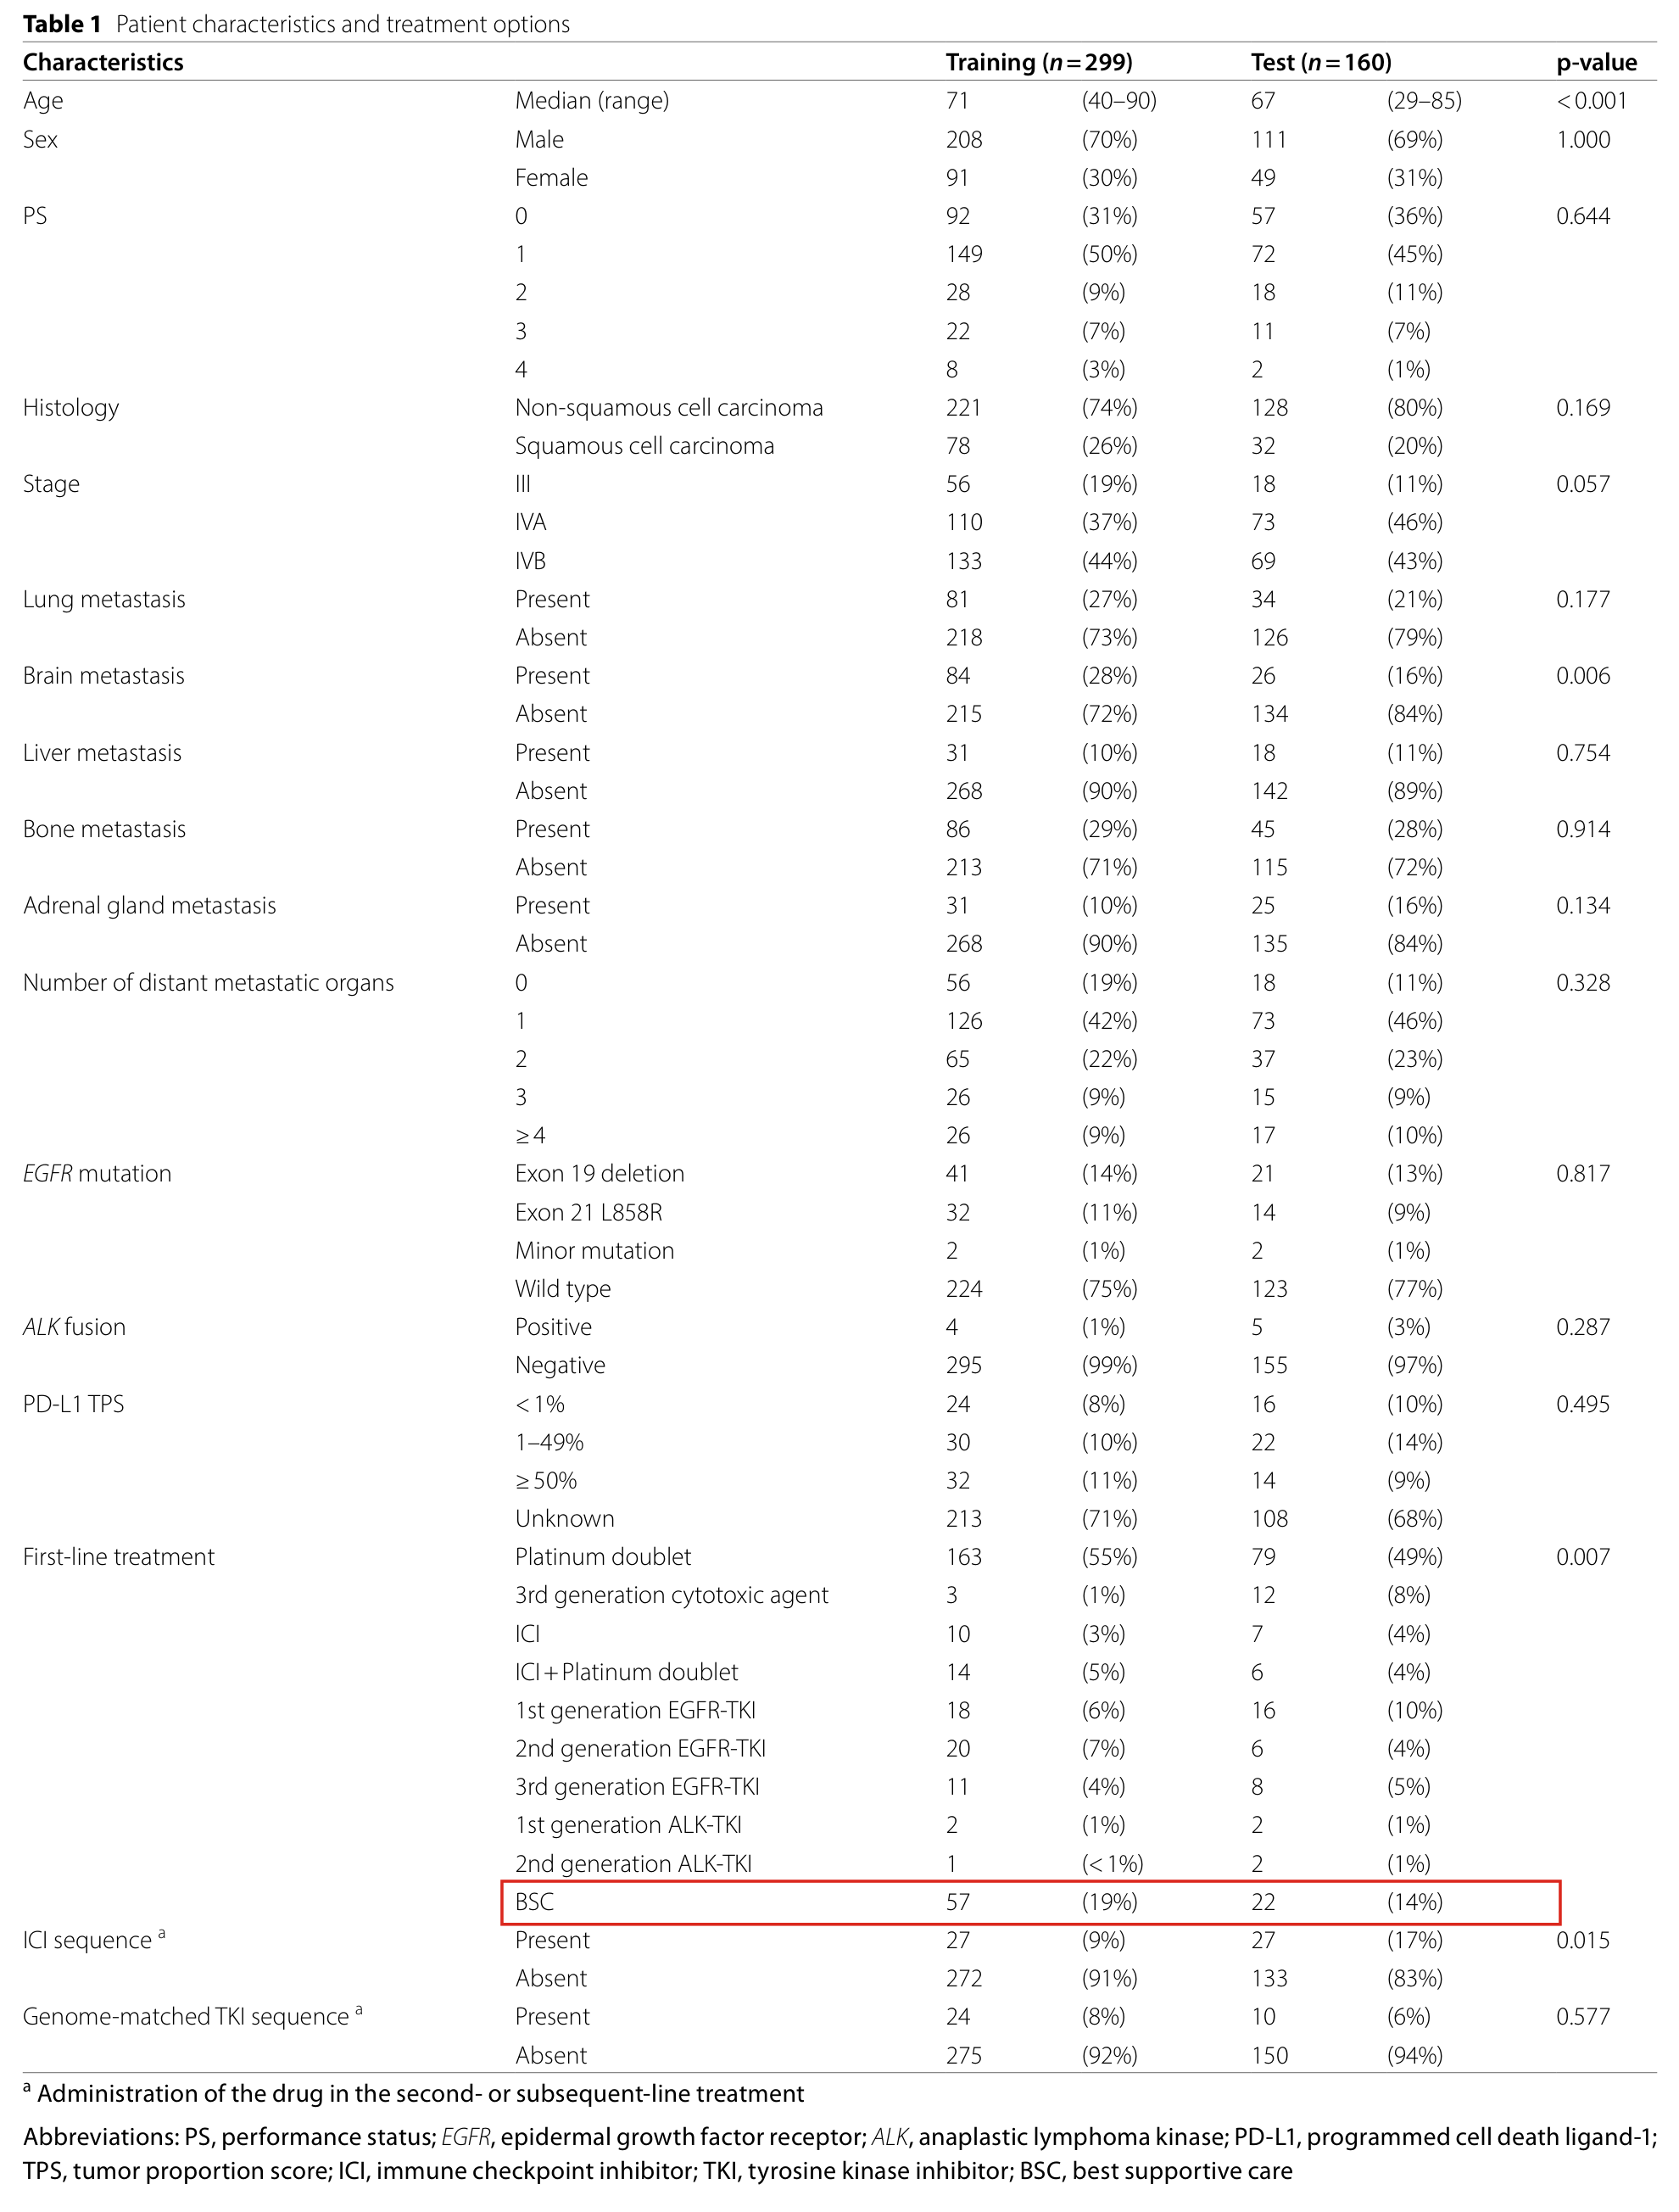
从架构图文转向严谨的实验数据时,文献中的表格对结构稳定性的要求更为严苛。我们选取了 2024 年发表于《BMC Cancer》的临床研究论文(Junji Koyama 等人关于晚期非小细胞肺癌生存预测的模型研究)第 5 页的受试者基线表(Table 1)进行整表对比。
在这份完整表格中,表头主要分为训练组(Training)与测试组(Test)。在年龄行中,两组中位数值分别为 71(40–90)与 67(29–85),显著性标识 p < 0.001 保留在原位,方便读者直接核对两组患者的年龄统计差异。
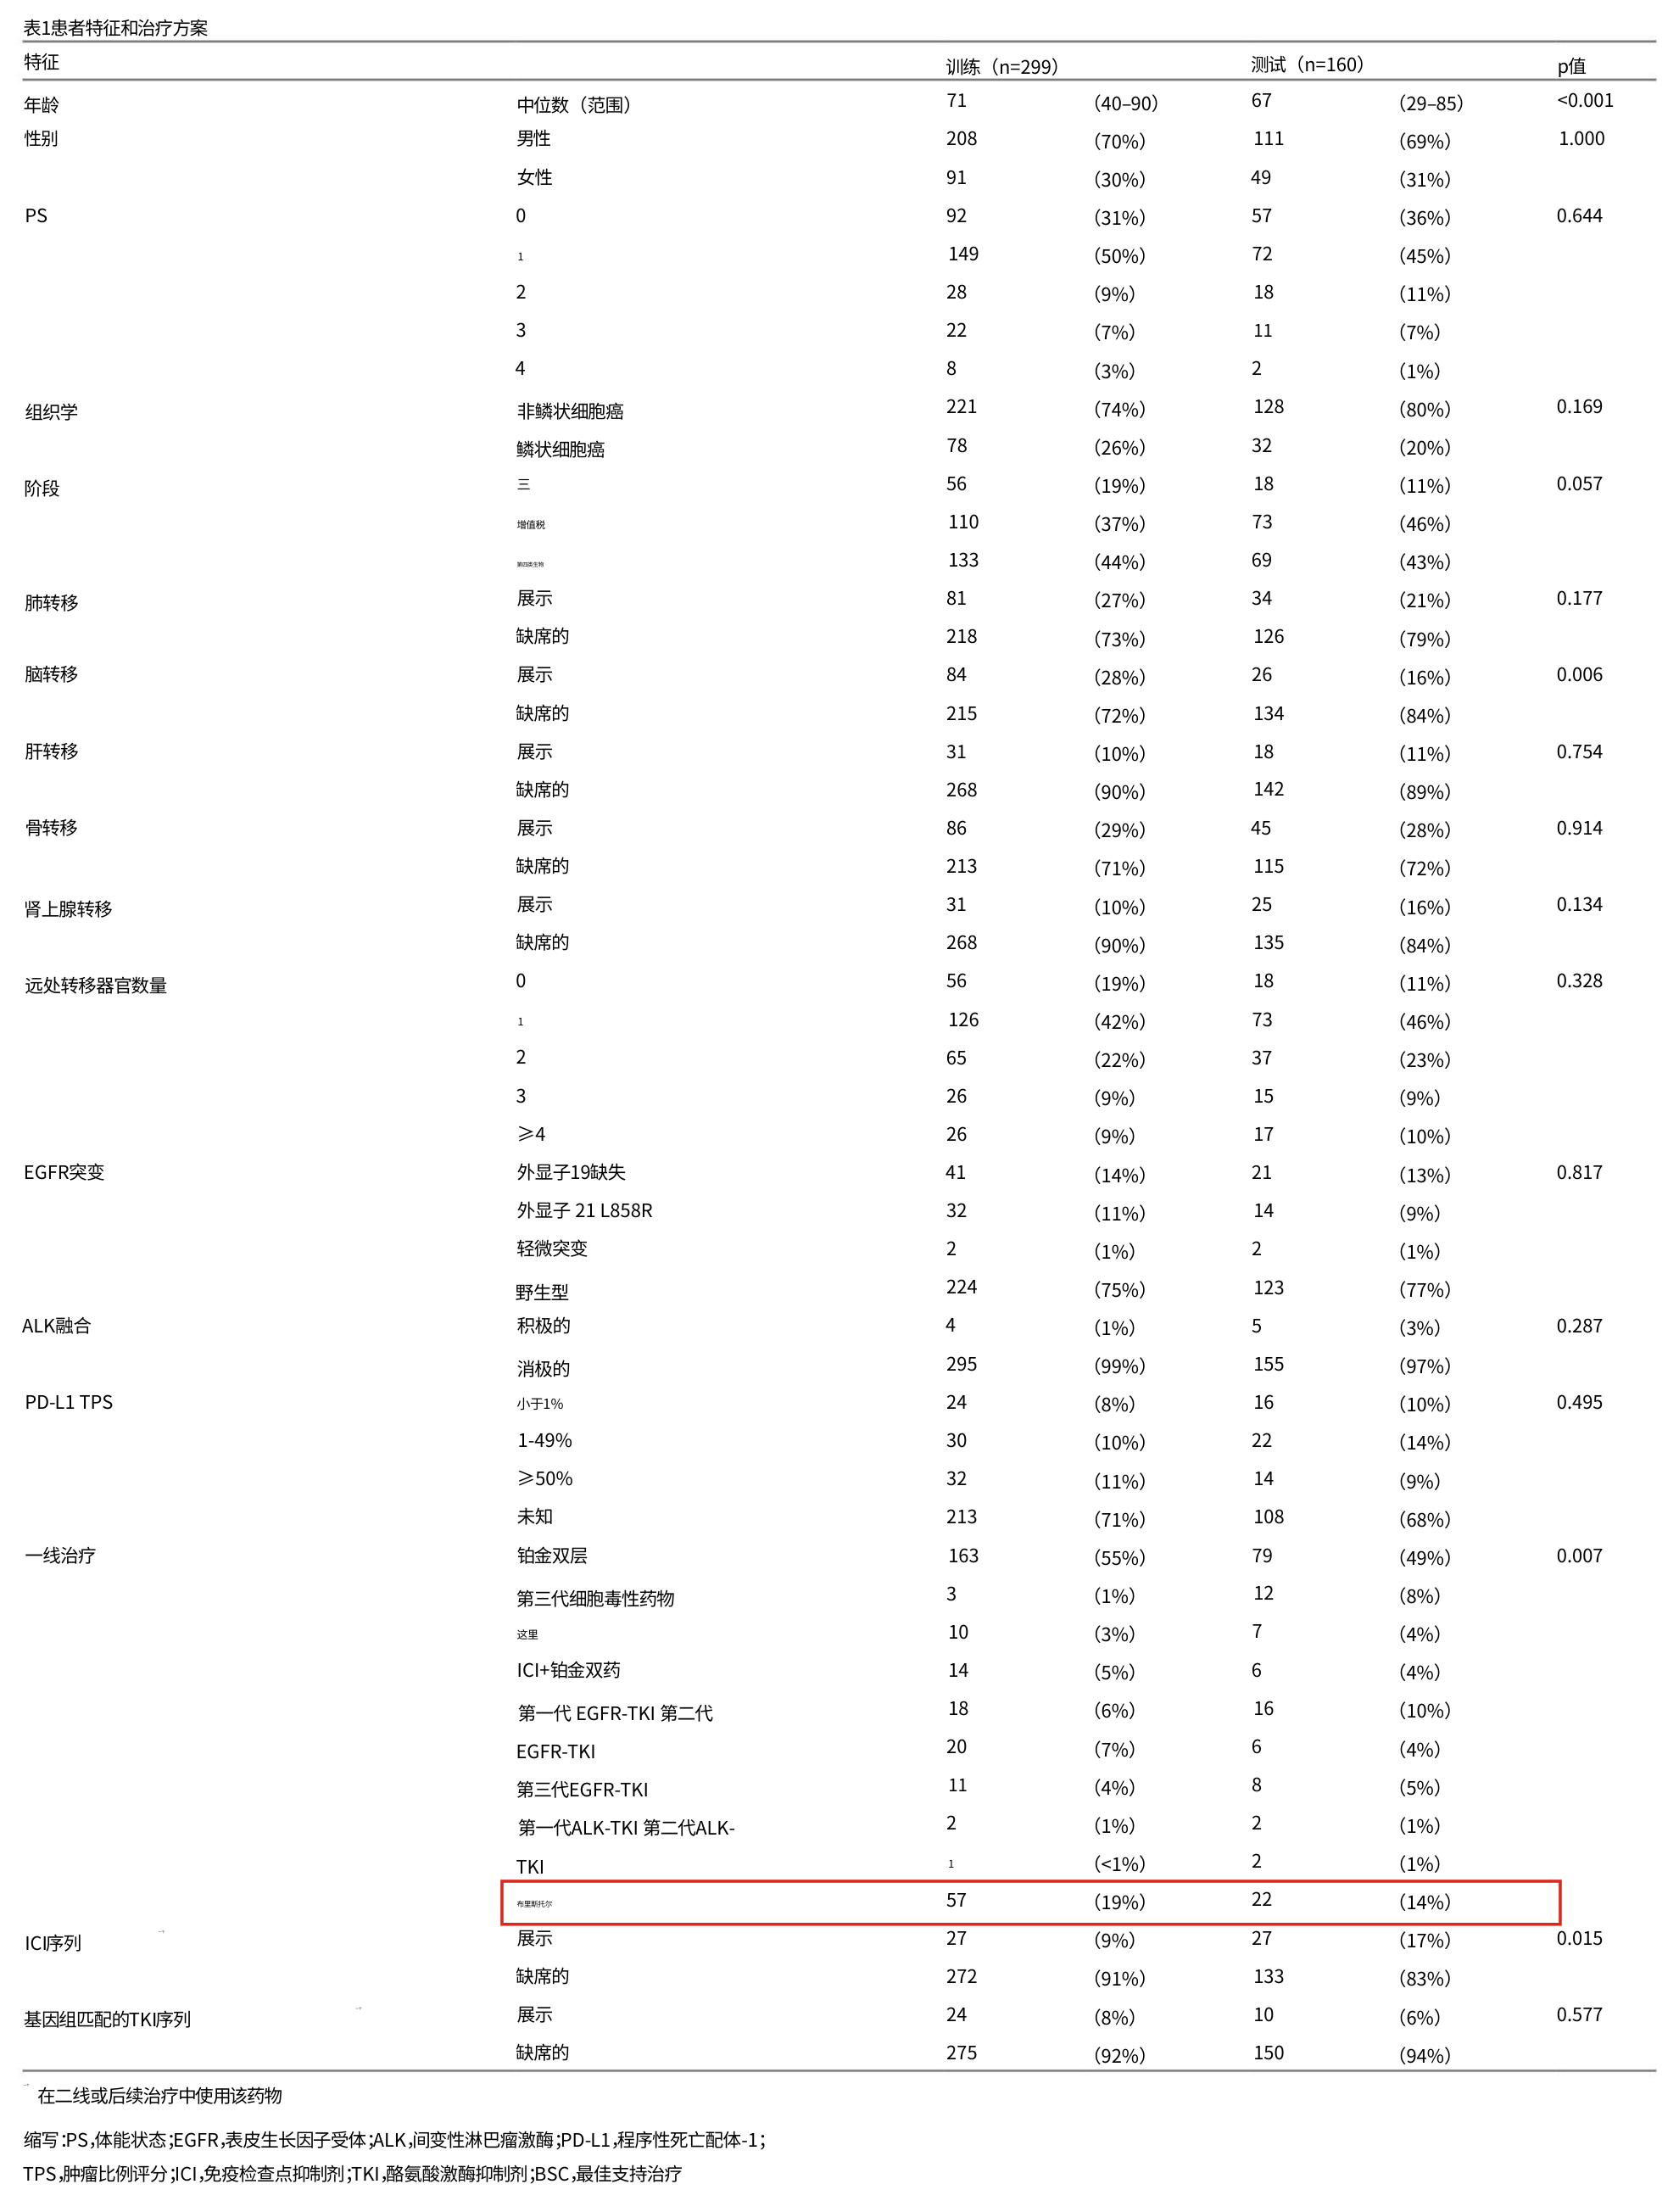
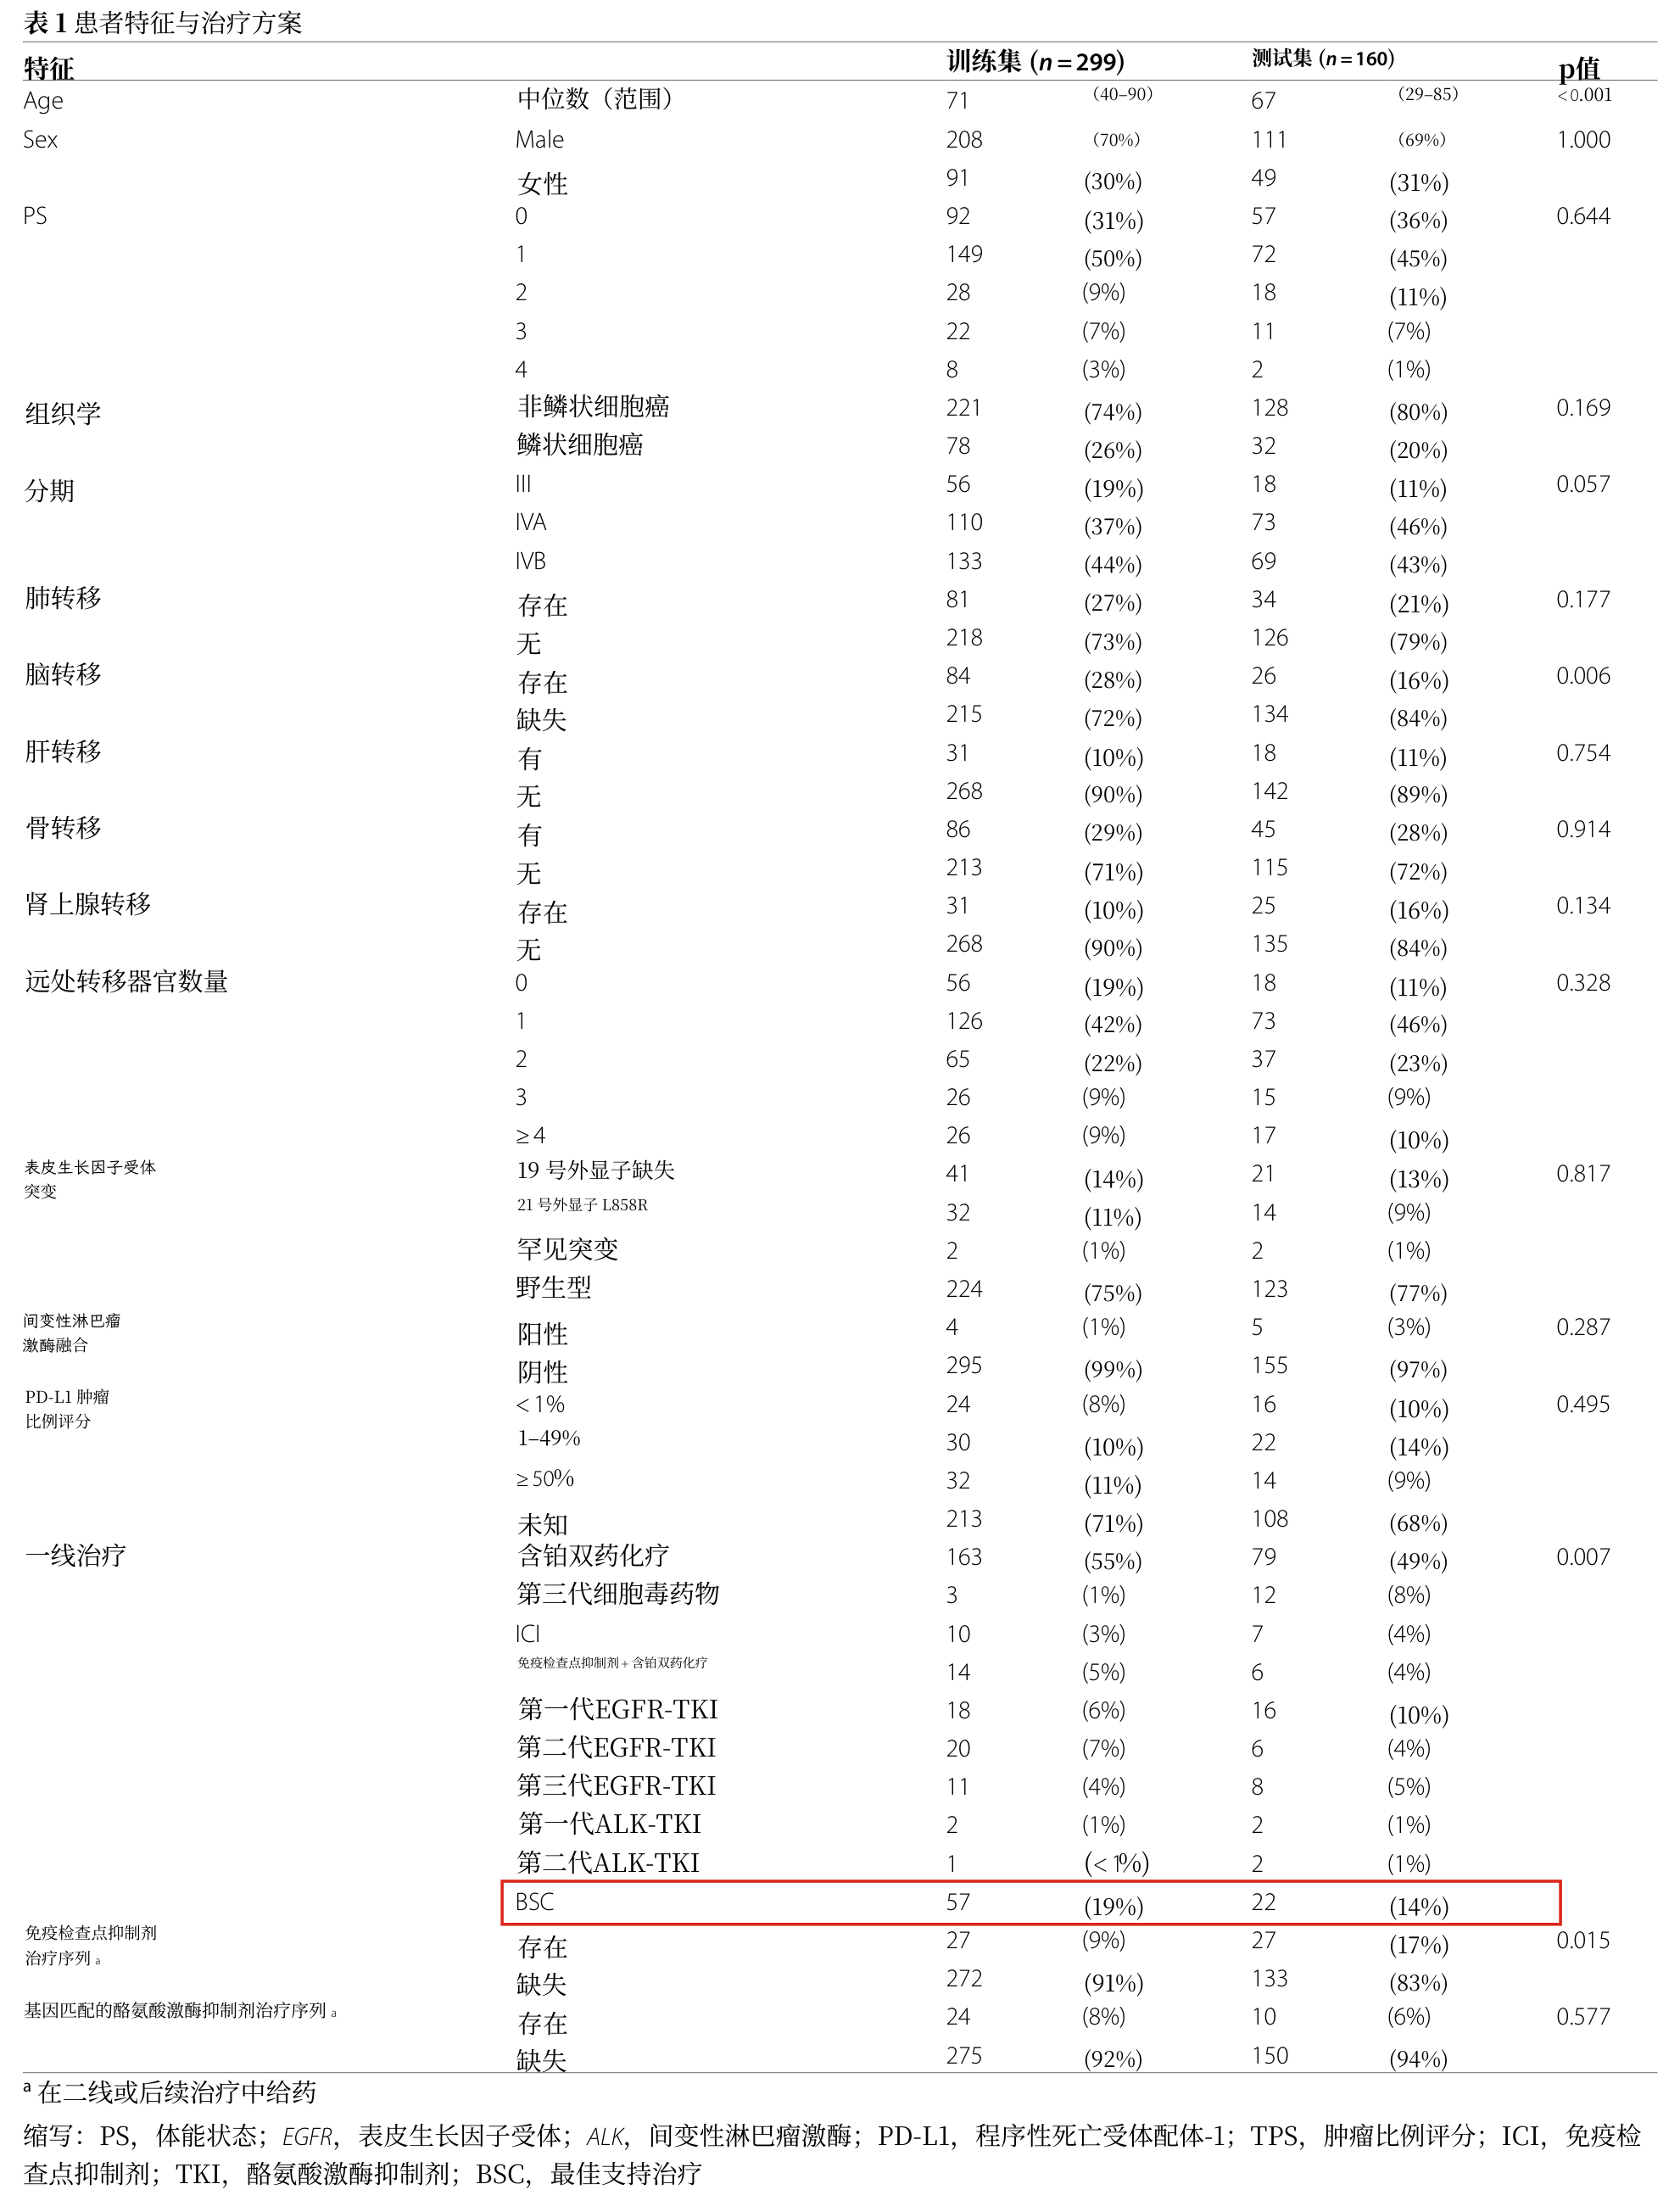
更关键的测试点在于表格中紧凑的专业缩写。在一线治疗(First-line treatment)分类中,有一项缩写为 "BSC",原论文两组对应数据分别为 57(19%)与 22(14%)。原作者在表格底部注明了明确注释:"BSC, best supportive care"(最佳支持治疗)。我们通过带有红色矩形框标出 BSC 所在行的整表截图,依次对比各工具的翻译表现。
原文与竞品表现
原论文整表保留了规整的临床指标与清晰的底部注释:
在 DeepL 的翻译样本中,Table 1 位于第 5 页,红框标出的 BSC 行被译为“基线”,与一线治疗分类语境不符。值得客观说明的是,DeepL 译文的表格脚注由于篇幅延续到了第 6 页,在该续页中,BSC 脚注被正确翻译为“最佳支持治疗”:
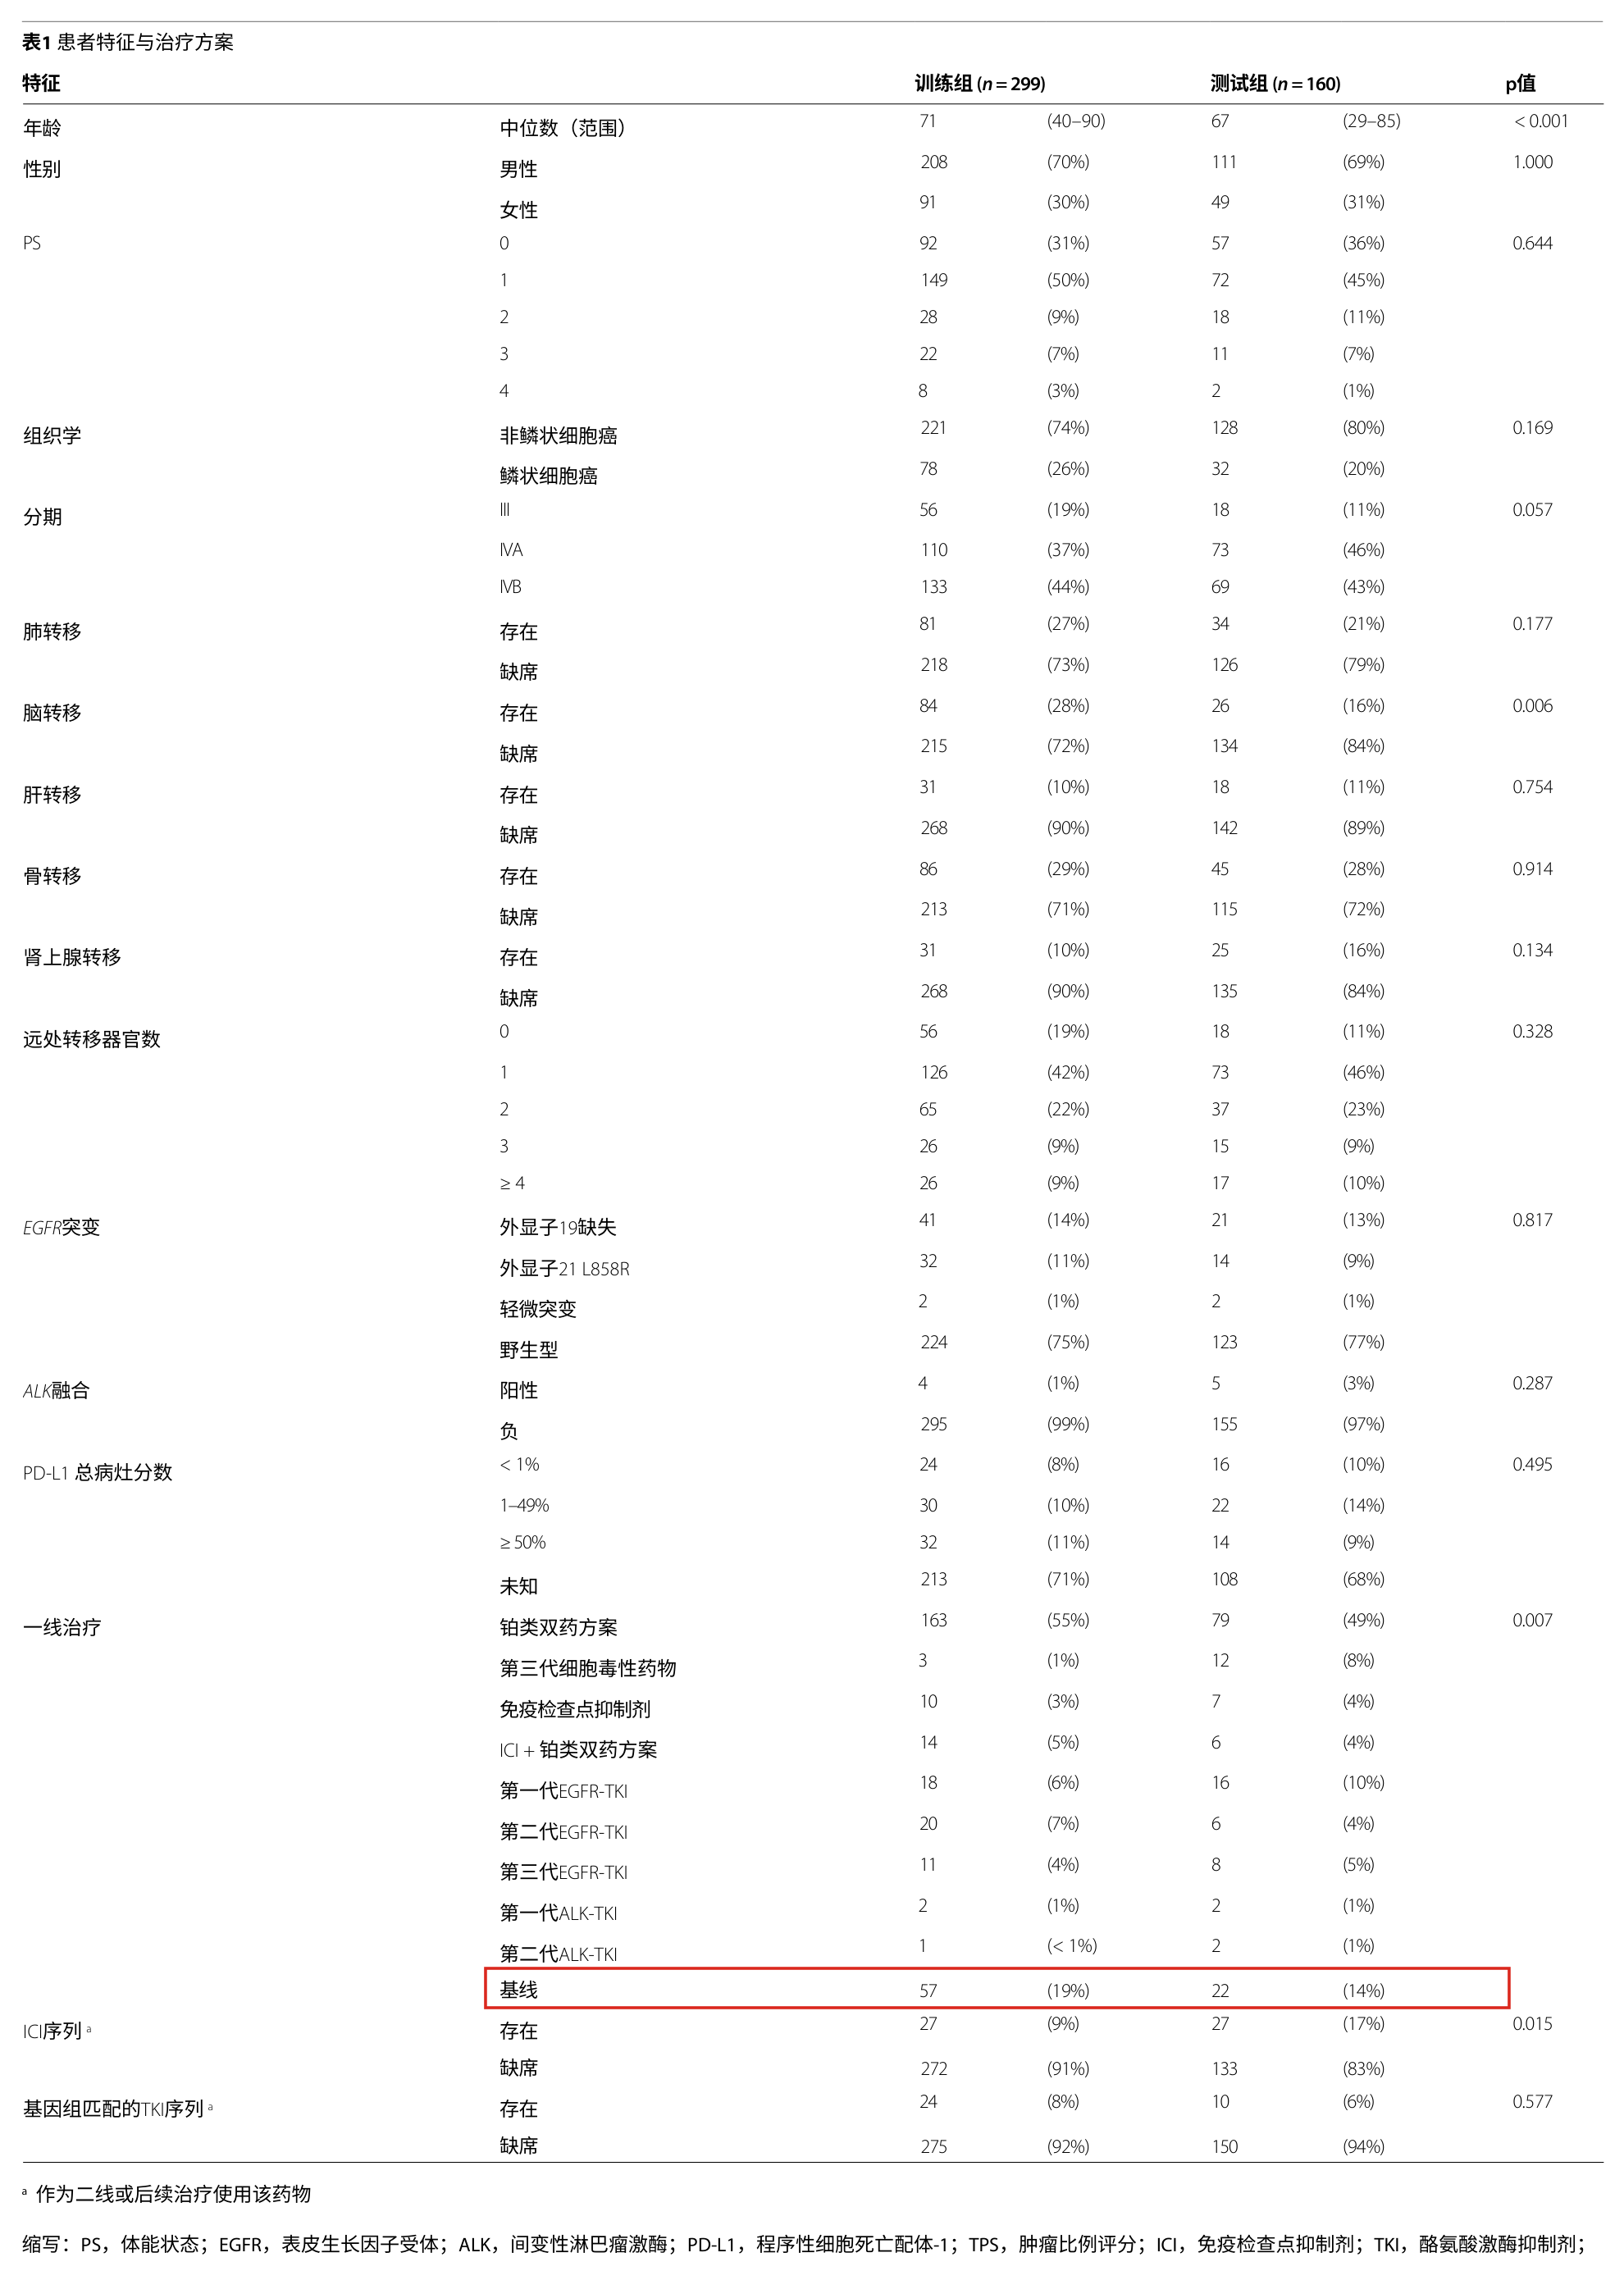

在 Google 翻译的整表样本中,红框标出的 BSC 行被译为“布里斯托尔”,与一线治疗分类语境不符;但在同一张表格的底部脚注中,Google 翻译实际上正确给出了“最佳支持治疗”。这种表格行与同页脚注译法不一致的现象,反映出独立单元格与连贯注释在词义对齐上的脱节:
在沉浸式翻译样本(截取自其双语页的中文侧)中,表格行选择保留了原始英文字母 "BSC",并在底部脚注给出了对应中文解释。在专业学术阅读中,保留领域通用的英文缩写也是常见且合理的做法,便于读者核对原始术语:
Equalang 的整表翻译表现
在 Equalang 翻译的整表样本中,红框标出的 BSC 行直接译为“最佳支持治疗”,与底部的中文脚注保持了一致的专业术语表述:
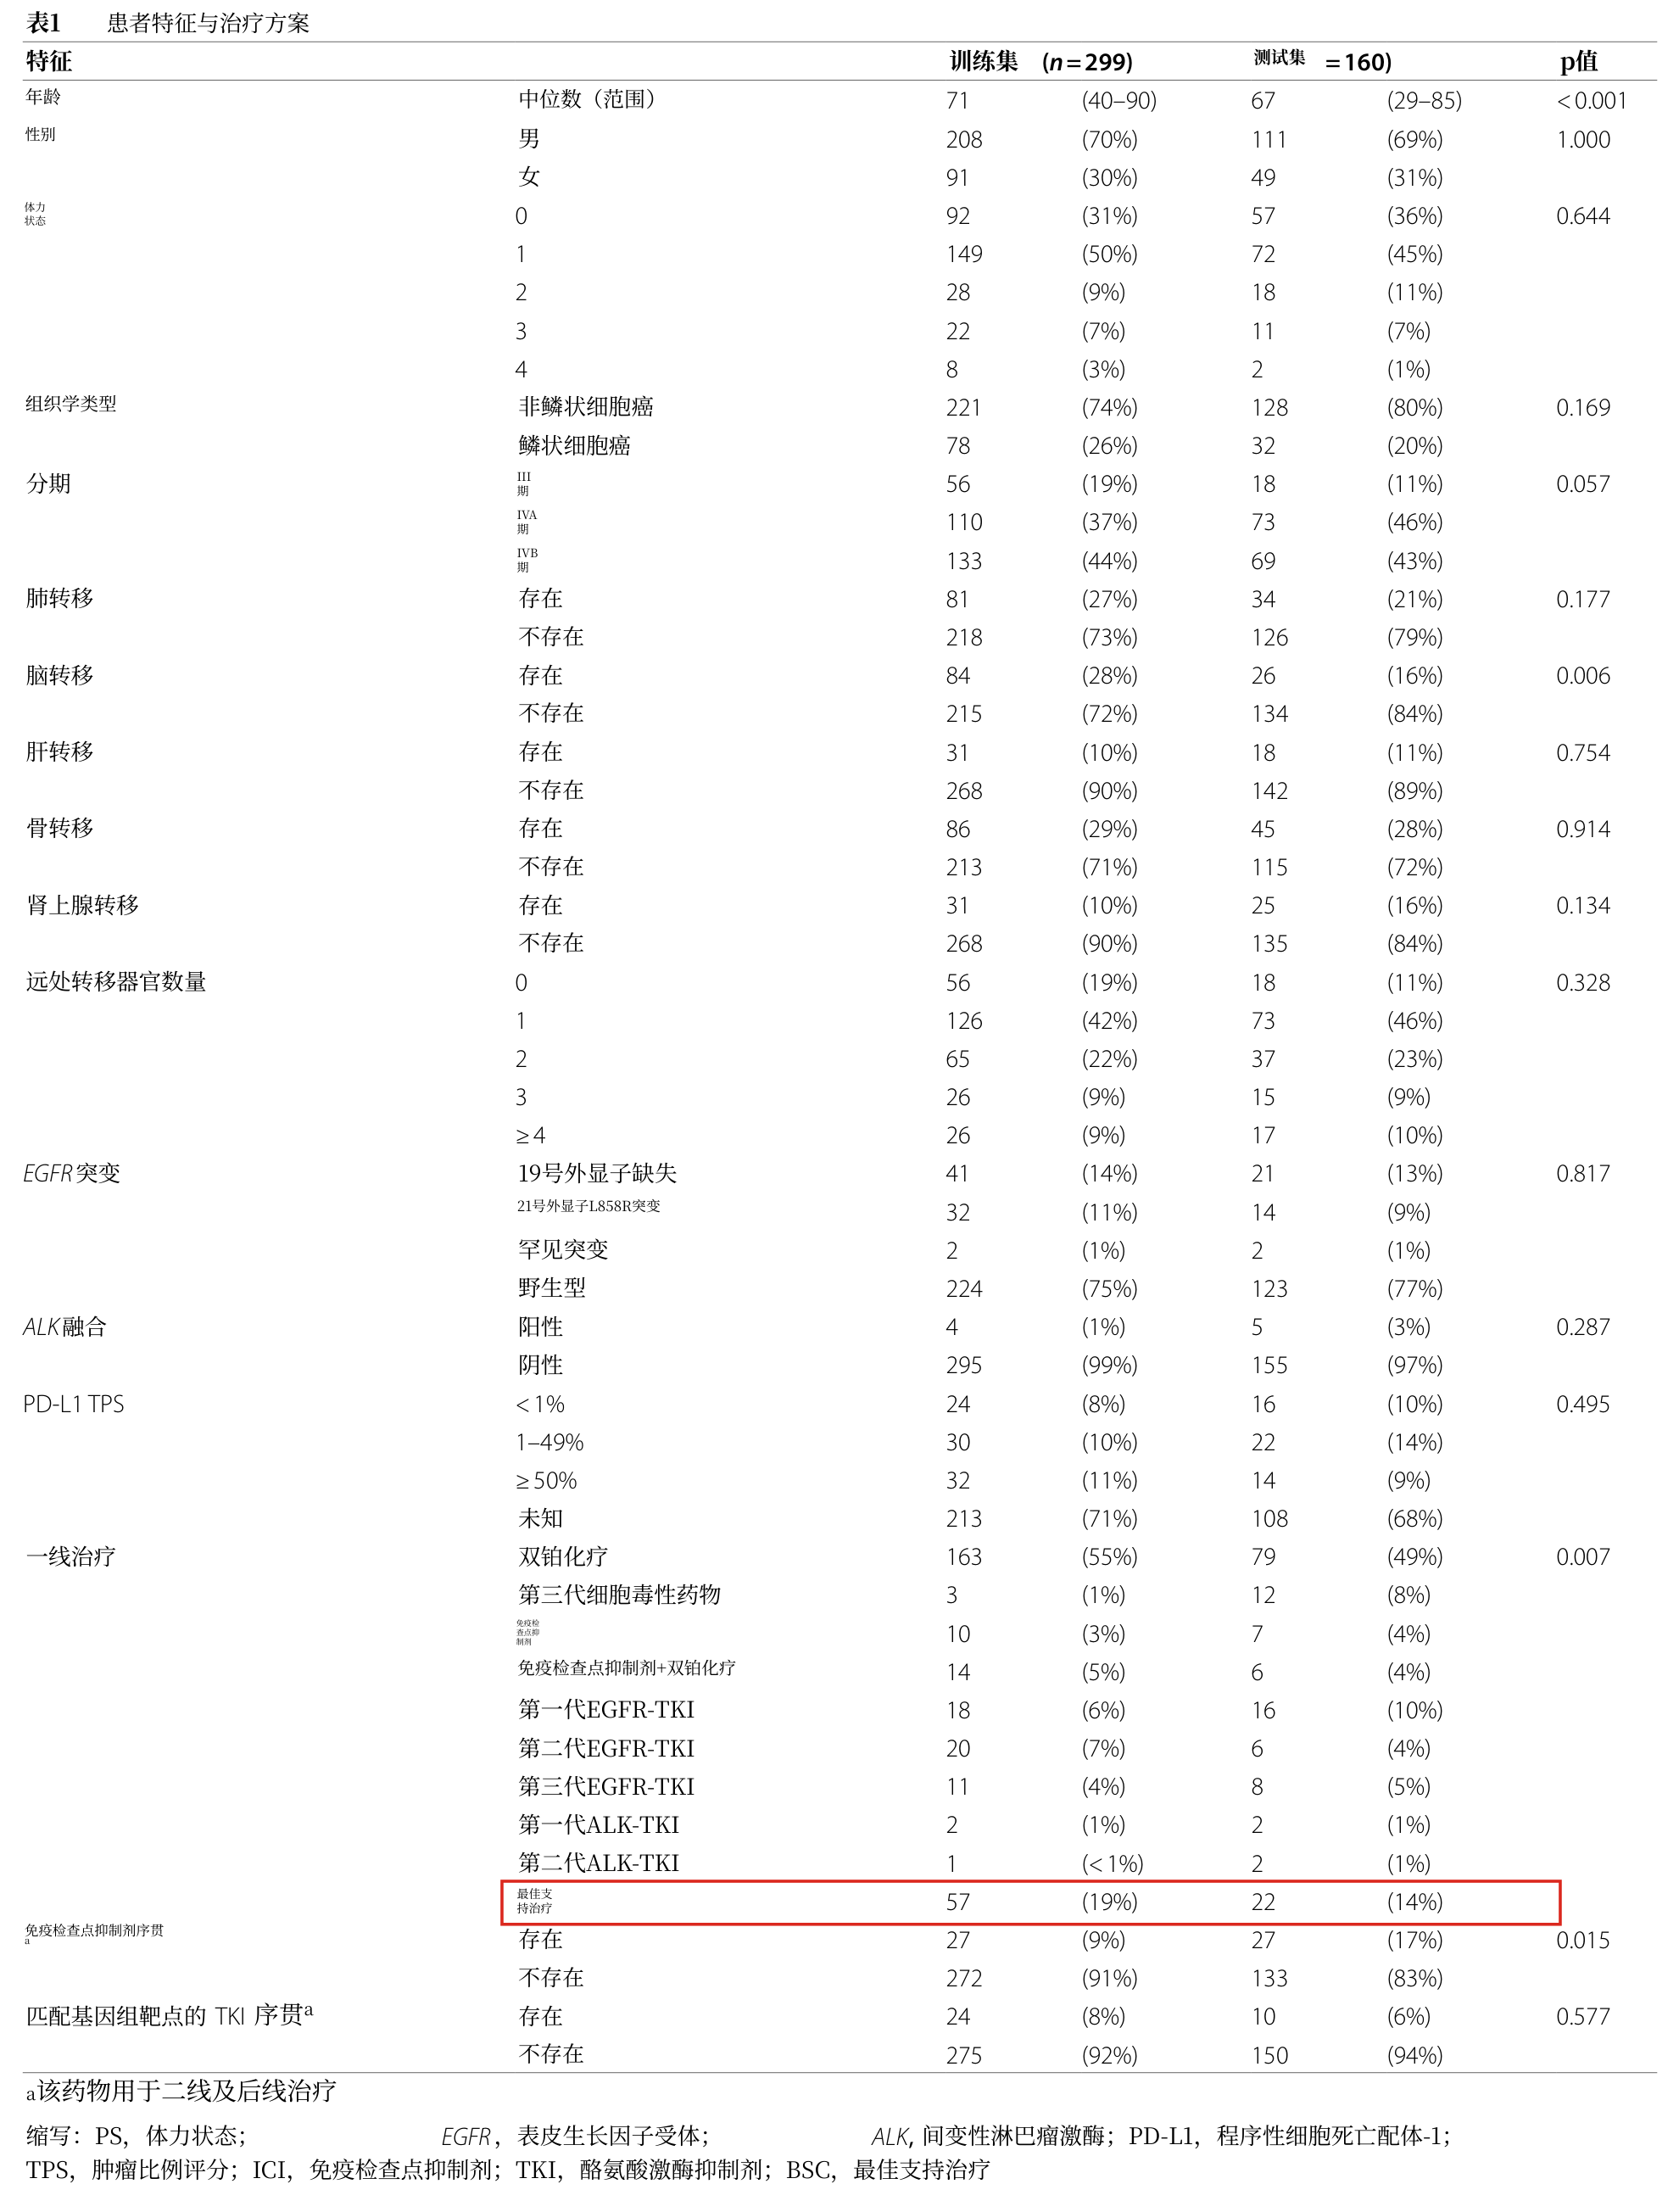
从核验的样本局部来看,所讨论的年龄分布与 BSC 一线治疗等关键数字均保持在对应的列位之下,文字行序清晰,读者能够直接理解该项临床分类的含义,无需反复翻找脚注核对。
结合文档翻译的高效阅读工作流
在日常科研中,使用 Equalang 处理学术 PDF 的操作路径非常简单:
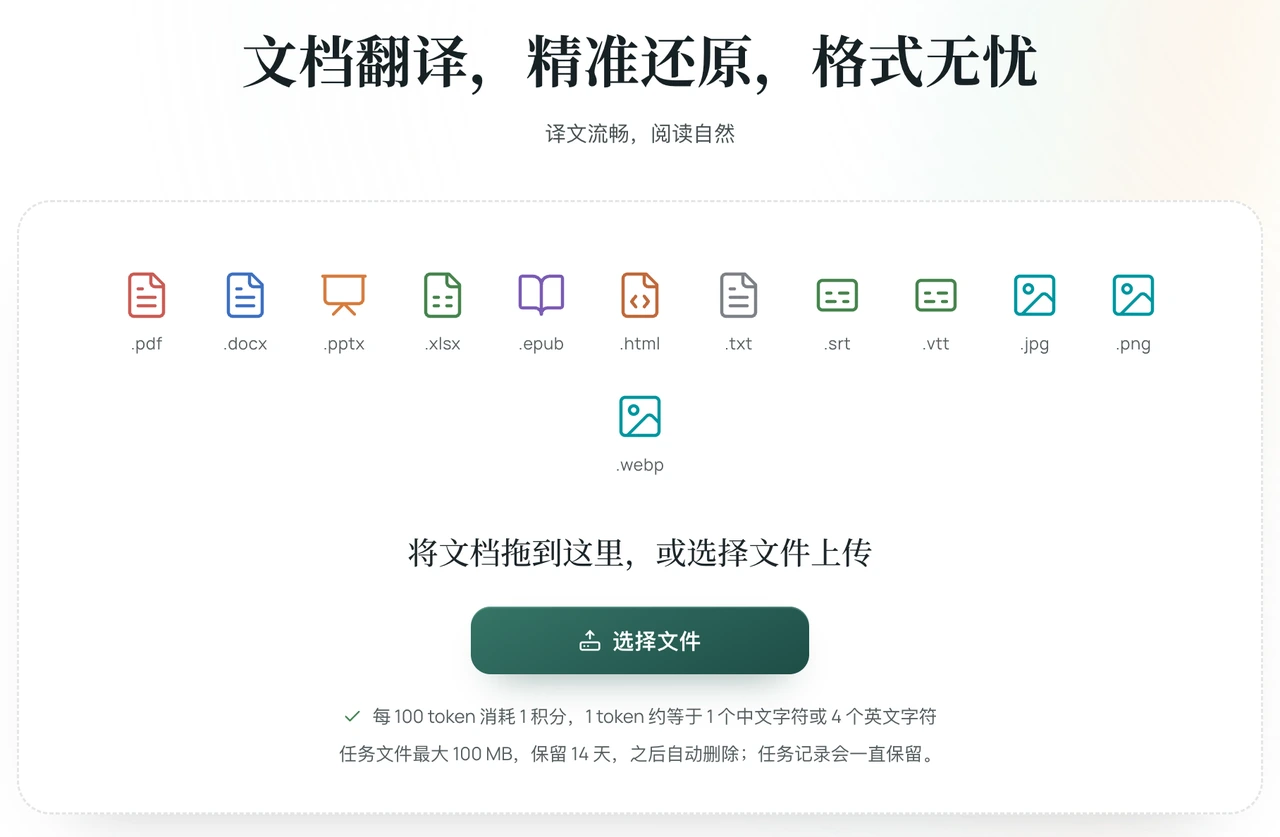
- 登录并上传文献:登录进入 Equalang 文档翻译 入口,将需要阅读的论文或技术报告 PDF 拖入上传区。
- 选择目标语言并启动:设置目标语言为简体中文,启动翻译任务。
- 下载译文并配合原件对照:任务完成后下载生成的独立 PDF 译件。
在研读包含精密实验数据的文献时,推荐在同一屏幕上左右分屏对照阅读:
- 屏幕一侧打开翻译后的中文 PDF,快速通览研究背景、实验设计流程与讨论结论;
- 屏幕另一侧保留英文原文 PDF,在遇到精细统计指标、专有名词缩写或需要推敲的参数定义时,目光随时移向原版核验。
这种阅读方式既免去了反复复制粘贴的碎片操作,又能在顺畅吸收信息的同时确保学术理解的严谨。
参考资料 / Sources
- DeepSeek-AI. (2026). DeepSeek-V4 Technical Report. arXiv:2606.19348.
- Koyama, J., et al. (2024). Artificial intelligence-based personalized survival prediction using clinical and radiomics features in patients with advanced non-small cell lung cancer. BMC Cancer, 24:1417. https://doi.org/10.1186/s12885-024-13190-w
- Equalang 文档翻译平台:https://equalang.com/zh-CN/documents
- Equalang 官方主页:https://equalang.com/zh-CN/