读 arXiv 论文公式总被机翻弄乱?看外文文献有什么好用的翻译工具
 意扣 Equalang
导读
双栏学术论文遇到 LaTeX 数学公式与跨页长句总被机翻拆散?本文拆解文献翻译核心技术瓶颈,演示双栏排版保留与原译并排对照的高效阅读方案。
关键词:arXiv 论文翻译; 学术文献翻译工具; PDF 双栏排版保留; LaTeX 数学公式翻译; 双页对照读文献
每周追踪 arXiv 最新预印本或突击顶会录用论文列表时,很多研究生和科研人员都会撞上一堵无形的墙:把双栏学术 PDF 的文字一段段复制到常规翻译窗口,原本严谨的 LaTeX 数学公式、上下标和求和符号瞬间散落成意义不明的碎片字符;跨栏、跨页处的连字符(Hyphenation)导致单词被强行截断,机翻出来的句子语无伦次;好不容易翻完一页,原文里的图表标号与推导逻辑全被冲散,反复切屏找坐标耗尽了所有读论文的心力。
读懂前沿文献的核心瓶颈,往往不是英语词汇量不足,而是**「公式被拆成乱码、双栏版式四分五裂、原译无法同步定位」**打断了研究者的推导心流。
这篇文章梳理学术文献翻译工具的底层选型标准,对比开源与主流工具的实际边界,并演示一套不碎公式、保留双栏原貌的高效文献精读流程。
一、为什么学术论文是机器翻译的「硬骨头」?
常规翻译工具(如通用划词插件或普通文本翻译框)擅长处理连贯的日常段落,但在学术 PDF 面前往往破绽百出。这主要源于学术文献特有的三大技术挑战:
- LaTeX 数学公式与特殊符号交织:论文正文中穿插着大量行内变量(如 $\theta_i, \mathbf{W}_Q$)、上下标、复杂分式与独立张量方程。通用机翻模型缺乏排版语法树感知,容易把数学变量当成普通英文单词强行汉化,把分母根号 $\sqrt{d_k}$ 拆成零碎汉字,导致推导全线崩溃。
- 双栏排版与物理分页断裂:PDF 本质上是面向打印的静态绘图指令,不包含天然的段落逻辑流动。双栏排版容易导致普通工具跨栏串行阅读;而处于页面底部的跨页未完长句,常被强制截为两半,产生严重误译。
- 图表编号与交叉引用丢失:算法架构图(Figure)、消融实验表(Table)以及文内对特定方程式的引用标号(如 Equation 3),在通用提取过程中极易错位丢失,破坏了论证链条。
因此,一套合格的学术文献翻译工具,必须具备**「PDF 版式结构化解析 + LaTeX 公式原位保护 + 原文译文并排对照」**的核心能力。
二、市面主流学术文献翻译方案横向对比
在日常科研中,大家常见的文献翻译方案主要分为三类,各自的适用边界十分明显:
针对需要兼顾公式准确、排版规整与免配置开箱即用的场景,下面用我们自己开发的 Equalang(意扣) 演示具体的处理流程。
三、三步搭建「左英右中」双栏文献精读工作流
要让文献阅读流畅,可以将原稿与生成的译稿左右并排对照,实现沉浸式精读。
第一步:整篇解析并开启公式优化
在 Equalang 网页端的文档翻译页面上传 arXiv 下载的原版 PDF 文件。对于数学公式密集的理工科、计算机或物理学论文,系统在解析阶段会对行内符号与独立方程进行重点保护。
被页面底部截断的跨页长句,系统会先在段落逻辑层重组拼合,再进行上下文连贯翻译,避免上下页断句割裂。
第二步:检查复杂公式与符号结构贴合度
翻译完成后,生成的译件会完整保留原论文的双栏宽度、章节标题层级、图表原图与图注位置。
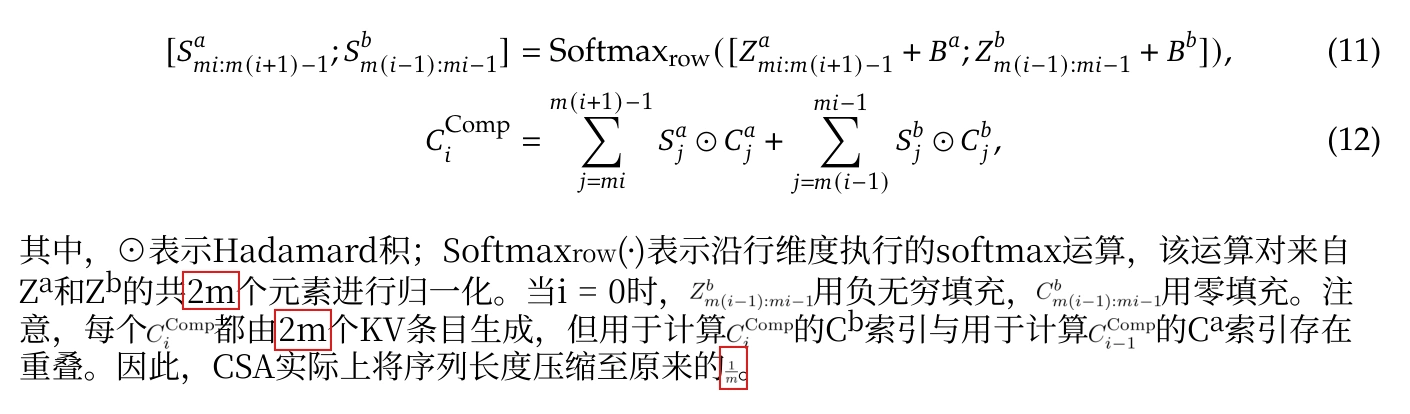
在处理如 DeepSeek-V4 论文等严谨推导时,上图示意了公式与译文排版的效果:
- 行内符号未被译成文字:2m、Z^a 等行内符号没有被译成文字,但部分行内公式字号明显变小。
- 独立方程式与编号对齐:CSA 公式 (11)(12) 居中排布,右侧的公式索引编号清晰保留,行文逻辑与推导无缝衔接。
第三步:将原件与译件双窗口并排对照
将英文原件与下载的中文译件在 macOS「预览」、Acrobat、PDF Expert 或 Edge 浏览器中分别打开,并将两个窗口左右并排:
- 屏幕左侧窗口打开英文原件。
- 屏幕右侧窗口打开对应的中文译件,翻至相同页码。
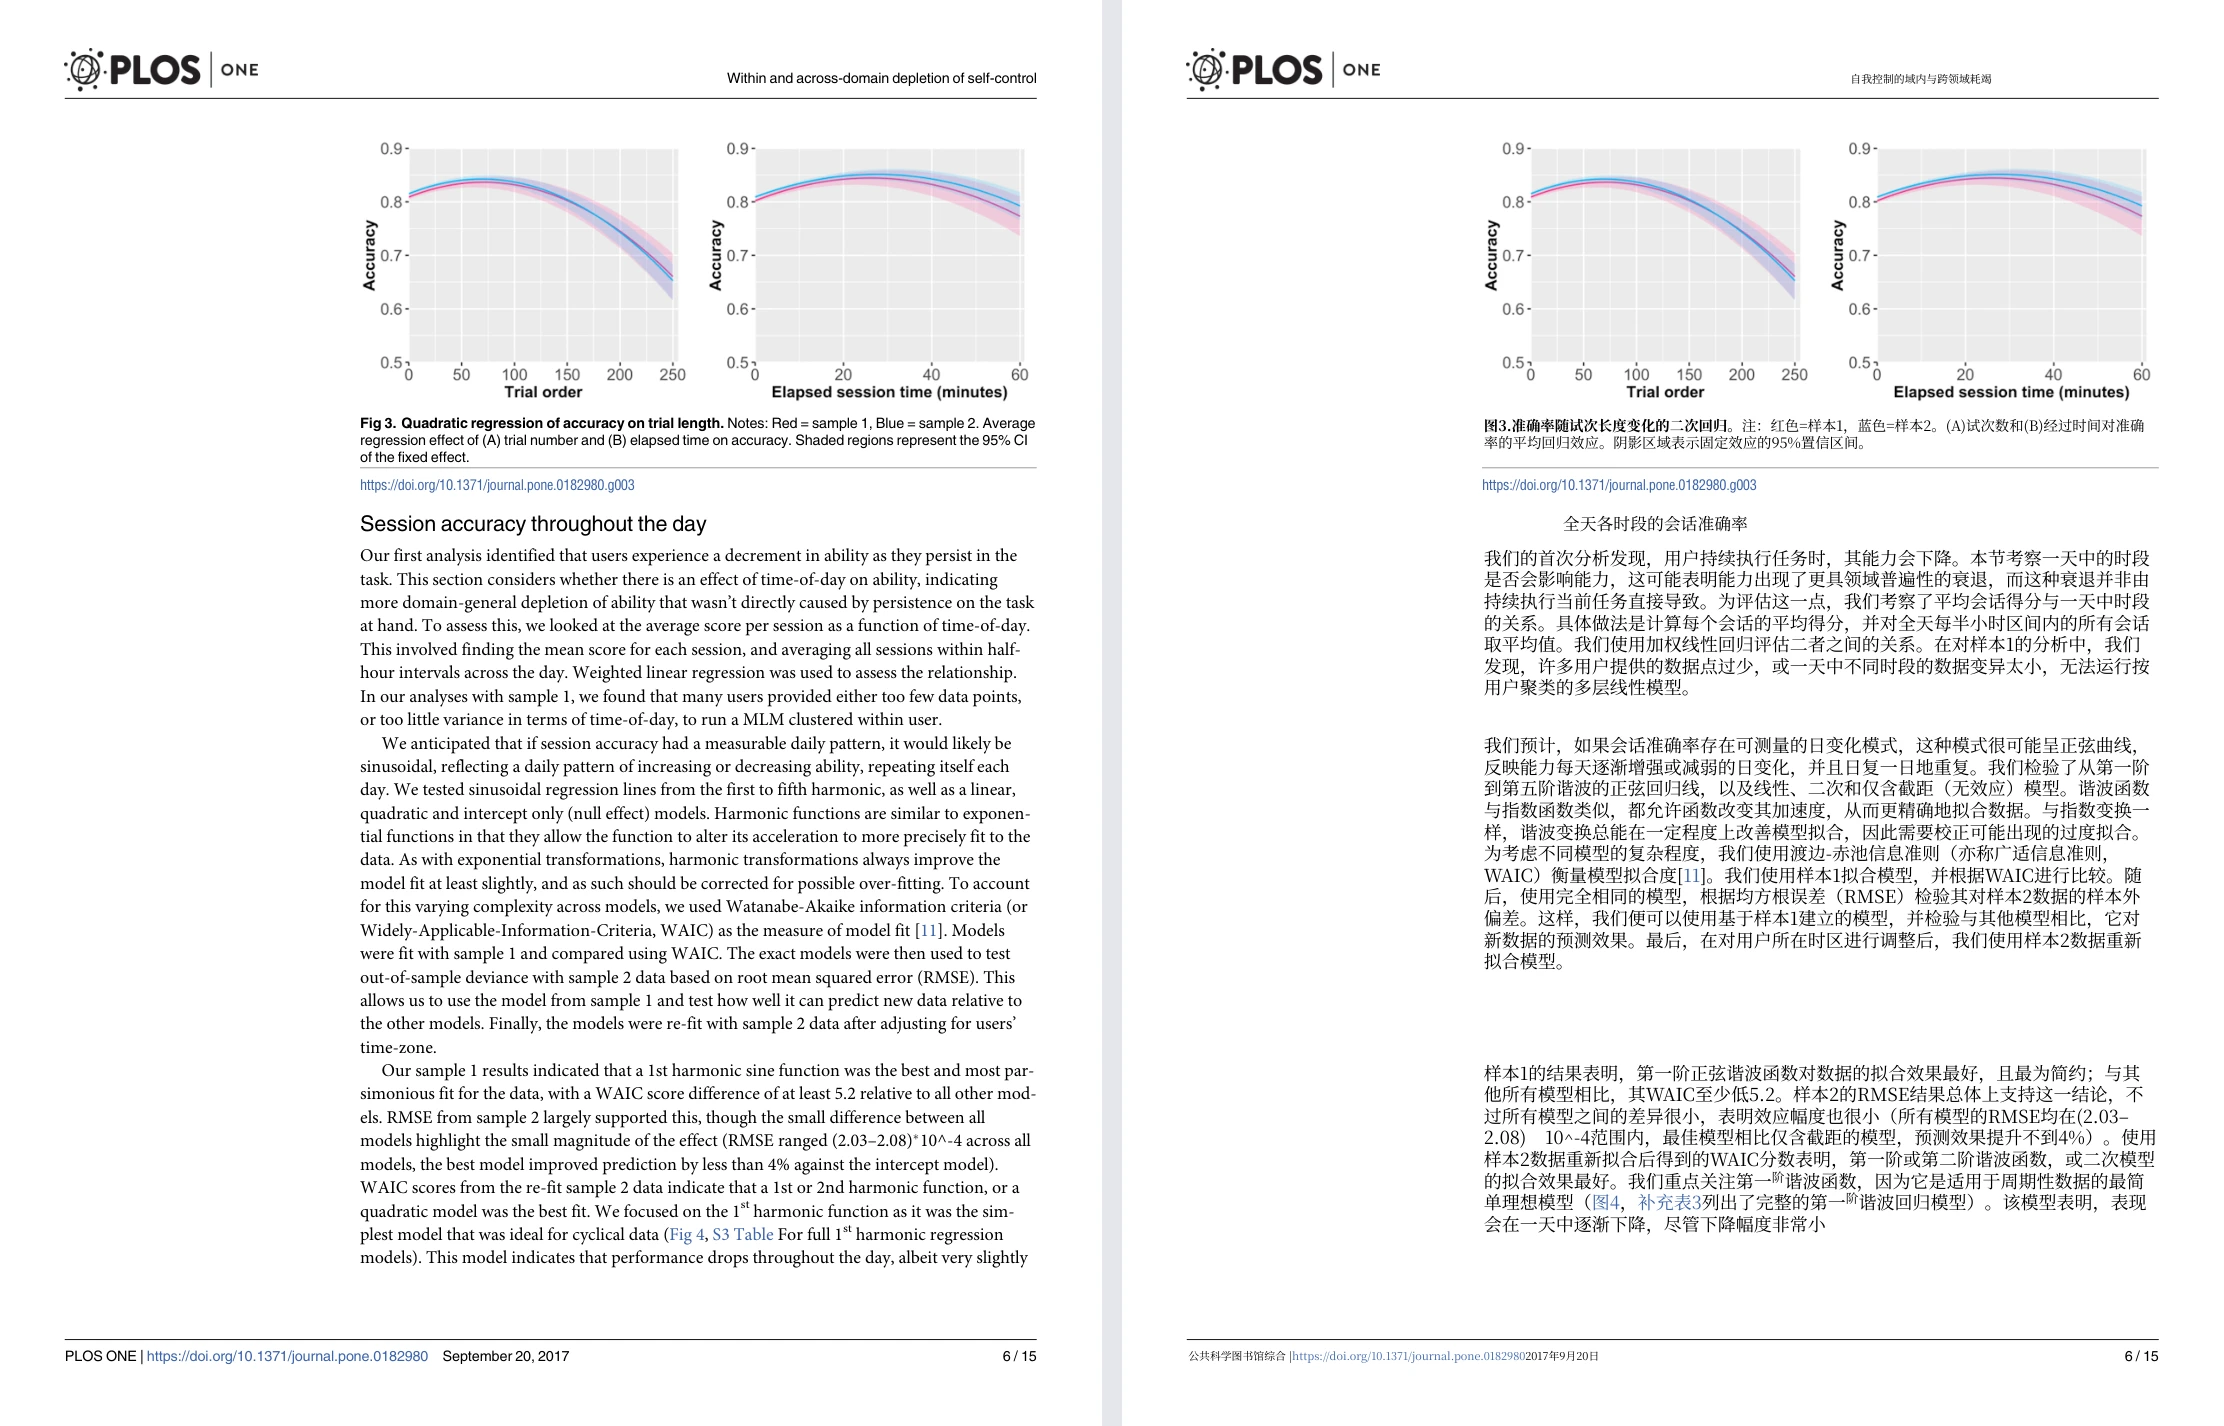
调整完毕后,屏幕左侧即为第 $N$ 页英文原稿,右侧即为对应的第 $N$ 页中文译文:
- 扫读论述时看右侧中文,快速理解作者的研究动机、核心论点与实验设计;
- 遇到关键公式、特殊名词缩写或疑难代码时,视线自然移向左侧英文原版,核对最原始的数学定义。
四、学术文献双语精读的避坑清单
在日常借助工具阅读学术文献时,建议保持以下几项科研好习惯:
- 重要结论回看原文定义:机器翻译可以大幅降低母语非英语读者的理解门槛,但在论文引用(Citation)、定理严格证明或代码复现阶段,务必以英文原稿的严格定义为准。
- 注意扫描版与矢量版差异:如果遇到年代久远的早期扫描版文献,文字若未经过高质量 OCR 识别,版式还原度可能会受到影响;尽量选用 arXiv 或 IEEE/ACM 官方提供的矢量原版 PDF。
- 复杂伪代码保持英文原名:算法步骤中的函数名、变量名与外部库名称(如 PyTorch / TensorFlow 原语)应保持原文,避免局部翻译影响实操理解。
参考资料 / Sources
- Equalang 意扣文档翻译官网入口
- arXiv.org 开放学术预印本数据库
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- PDFMathTranslate 开源学术论文翻译工具项目仓库