想读的论文不是英文?保留排版、
 意扣 Equalang
导读
针对中文、日文、德文等非英语学术论文,介绍如何保留双栏排版、公式与图表进行完整翻译,并分享对照原著查验术语与核对数据的严谨精读流程。
关键词:非英语学术论文; 论文翻译; PDF排版翻译; 学术精读; 意扣Equalang
在科研过程中,很多重要的开创性成果和基础实验并不总是以英文发表。你可能会在追溯某项材料或工程机理时顺着引文找到一份早期的德语文献,在调研工业机器人时遇到详实的日语论文,或者需要查阅中文技术报告中的具体系统设计。当手头的关键参考资料是一份非英语的 PDF 时,如何准确、高效地读懂它,往往成了文献调研的第一道难关。
复制粘贴与普通翻译工具的局限
面对非英语学术论文,最直接的做法往往是把文字复制到通用翻译框里。但在学术 PDF 上,这种操作很快会遇到麻烦。双栏排版的文本复制出来后,经常出现断行错位、不同分栏内容粘连在一起的情况;上标、下标以及行内数学符号会变成无序乱码,导致原本严密的实验推导完全无法辨读。
如果直接将整份 PDF 丢给常规的文档转换工具,排版往往更容易变形。许多工具在处理文档时会直接丢弃矢量插图,破坏包含合并单元格或多行表头的复杂实验表格,使公式变成杂乱文本。一旦图表与正文说明脱节,研究人员就很难将分析结论与具体的数据曲线对应起来。
保留版式、公式与图表的文档翻译
下面用意扣(Equalang)文档翻译进行演示。相比通用的文本翻译框或基础的文件转换脚本,学术文献翻译的核心在于完整维系正文与图表、公式、表格之间的空间排版对应关系。
在网页端上传学术 PDF 后,系统支持自动识别源语言。文档翻译目前支持中文、英文、日语、韩语、西班牙语、法语、德语等多种语言,研究人员可以直接将各类非英语源语言文献翻译成英文或中文。
意扣会重建双栏排版、段落层级、图注以及页眉页脚;原本被分页截断的句子,在翻译前会先拼回完整语意再进行处理。对于学术材料中关键的数据表格,多行表头与合并单元格会按原结构恢复;行内公式与独立公式不会变成乱码,遇到复杂的行内数学符号时还可以开启公式优化。
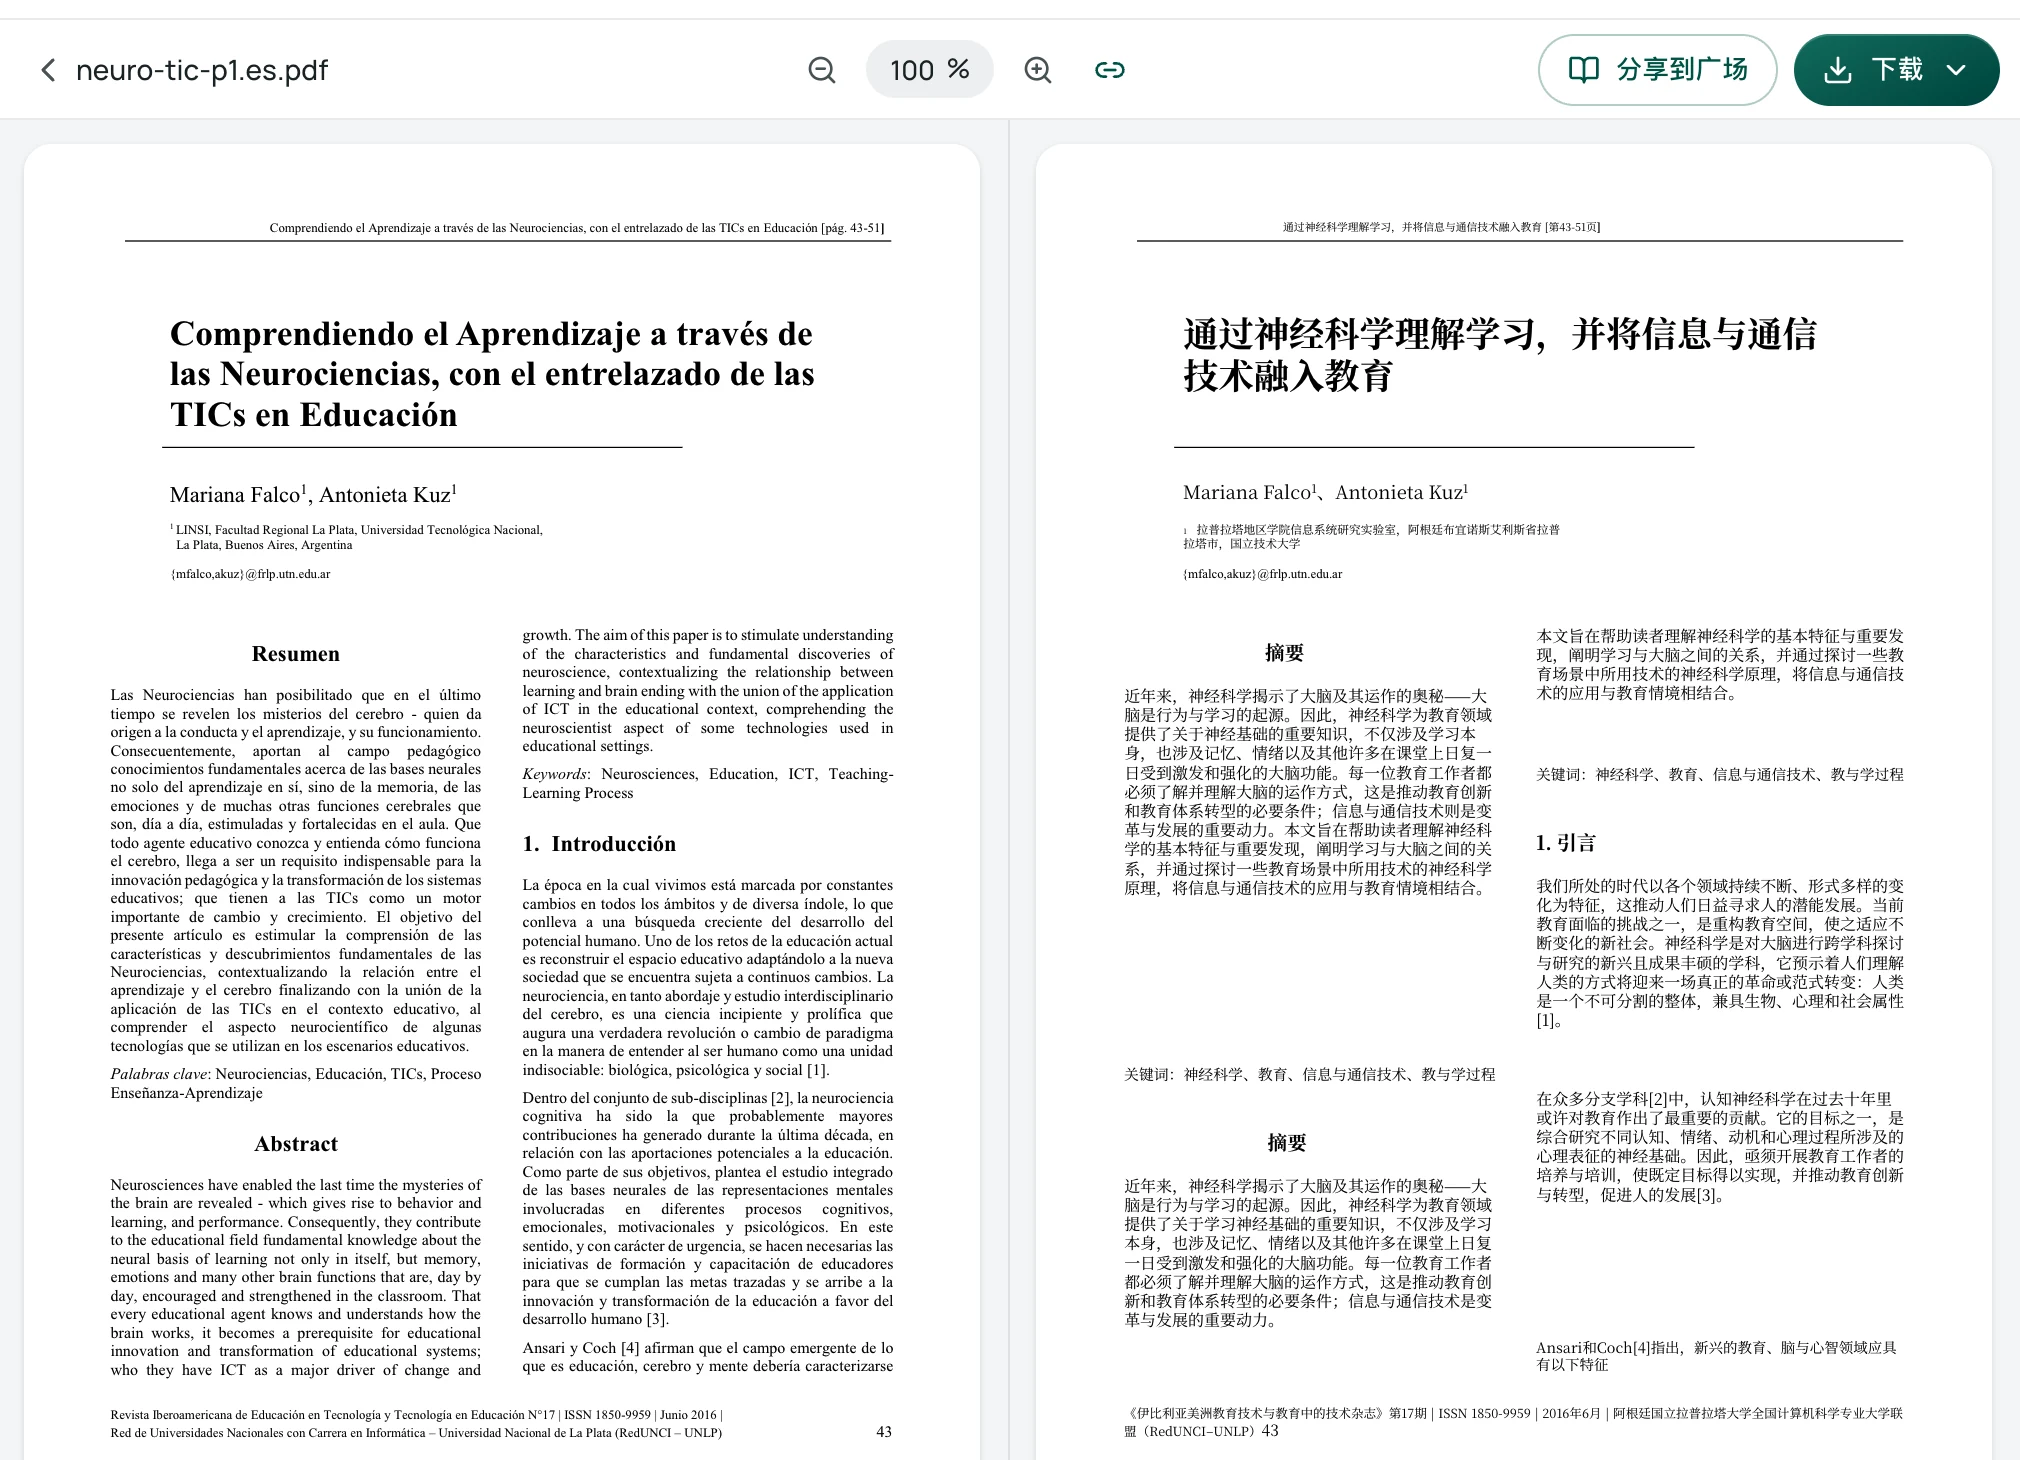
需要说明的是,文档翻译的目标是保留版式结构与阅读逻辑,并非追求像素级的一模一样。不同语言在表达相同含义时的字数存在客观差异,字号与换行会随译文长度产生自然自适应调整。
非英语学术论文的严谨精读工作流
拥有一份保留排版的译文 PDF 只是第一步。严谨的学术阅读依然需要规范的核查工作流:
-
结合图表通读全局结构:先通读摘要、小标题与结论,借助原位保留的图表与拓扑图,将文本讨论与实验曲线结合起来理解。如果希望了解更多工具辅助阅读的技巧,可以参考这篇关于如何使用翻译工具阅读学术论文的梳理。
-
对照原文核实核心专业术语:不同语种在特定学科里往往有一套严谨的构词习惯,例如德语中的专业复合词或日语汉字术语,直接机器翻译有时会抹平关键的细分概念。在意扣的原文与译文并排工作台中,左侧原文与右侧译文支持同步滚动。一旦遇到关键结论或定义模糊处,应立即对照左侧原文确认原始用词。关于学术文献的精读细节,我们在学术论文 PDF 翻译指南中有更详细的说明。
-
核对表格数值与公式符号:对于论文中最核心的实验数据、基准测试结果或常数指标,切勿仅凭译文做结论。应始终对照原表格中的数值、误差范围及上下标符号;对于涉及密集推导的算法公式,也应逐项核验(参见我们关于AI 论文与公式翻译的解析)。
-
规范引用原始文献:在撰写自己的综述、开题报告或学位论文时,引用必须基于原始文献。参考文献列表中应准确使用原文献所发表语种的官方标题、作者名录、刊物卷期与 DOI,绝不能将翻译后的译文版本作为原始文献进行标注。