Förstörs formler i arXiv-artiklar? Smarta översättningsverktyg
 Equalang
I korthet
Förstörs LaTeX-formler och delade meningar i tvåspaltiga PDF:er av maskinöversättning? Vi visar hur du läser med bevarad layout och parallellvy sida vid sida.
Nyckelord: översätta arXiv-artiklar; verktyg för akademisk översättning; bevara tvåspaltig PDF-layout; översätta LaTeX-formler; parallell läsning sida vid sida
När du bevakar de senaste preprints på arXiv varje vecka eller går igenom listan över antagna artiklar inför en toppkonferens stöter många doktorander och forskare på en osynlig mur: När du kopierar text stycke för stycke från en tvåspaltig akademisk PDF till ett vanligt översättningsfönster förvandlas precisa matematiska LaTeX-formler, index och summasymboler plötsligt till obegripliga teckenfragment. Avstavningar över spalter och sidor klipper av ord mitt itu, vilket gör maskinöversättningen osammanhängande. Och när du väl har tragglat dig igenom en sida har figurhänvisningar och matematiska härledningar kommit i oordning, så att all energi går åt till att växla mellan fönster för att hitta rätt i texten.
Den största flaskhalsen när man läser banbrytande forskning handlar sällan om bristande engelskt ordförråd. I stället är det hur formler förvandlas till skräptecken, hur den tvåspaltiga layouten trasas sönder och hur bristen på synkroniserad orientering mellan original och översättning bryter forskarens tankeflöde.
I den här artikeln går vi igenom de grundläggande kriterierna för att välja verktyg för akademisk översättning, jämför gränserna för öppen källkod och etablerade lösningar, samt visar ett effektivt arbetsflöde för djupläsning där formler bevaras intakta och den tvåspaltiga layouten bibehålls.
1. Varför är akademiska artiklar en hård nöt för maskinöversättning?
Vanliga översättningsverktyg (som generella markeringstillägg i webbläsaren eller enkla textrutor) fungerar utmärkt för sammanhängande vardagstext, men när de ställs inför en akademisk PDF visar sig snabbt deras begränsningar. Det beror främst på tre specifika tekniska utmaningar i akademisk litteratur:
- LaTeX-formler sammanflätade med specialtecken: Brödtexten är full av variabler i löpande text (som $\theta_i, \mathbf{W}_Q$), index, komplexa bråk och fristående tensorekvationer. Generella modeller för maskinöversättning saknar förståelse för layoutens syntaxträd. De riskerar att behandla matematiska variabler som vanliga engelska ord och försöka översätta dem, eller bryta sönder nämnarens rotuttryck $\sqrt{d_k}$ till lösryckta fragment, vilket gör härledningen helt obegriplig.
- Tvåspaltig layout och fysiska sidbrytningar: En PDF består i grunden av statiska ritinstruktioner avsedda för utskrift och saknar ett naturligt, logiskt textflöde. Med två spalter läser enkla verktyg ofta felaktigt tvärs över spalterna. Dessutom klipps långa meningar längst ner på sidan ofta brutalt av vid sidbrytningen, vilket leder till allvarliga feltolkningar.
- Förlorade figurnummer och korsreferenser: Arkitekturdiagram för algoritmer (Figure), tabeller för ablationstester (Table) och hänvisningar till specifika ekvationer i texten (som Equation 3) förskjuts eller försvinner lätt vid vanlig textextraktion, vilket raserar artikelns logiska resonemangskedja.
Ett fullgott verktyg för översättning av akademisk litteratur måste därför ha tre kärnförmågor: strukturerad PDF-layoutanalys, bevarande av LaTeX-formler på ursprunglig plats samt parallell jämförelse mellan original och översättning sida vid sida.
2. Jämförelse av vanliga metoder för akademisk litteraturöversättning
I det dagliga forskningsarbetet delas de vanligaste översättningsmetoderna i regel in i tre kategorier, var och en med tydliga styrkor och begränsningar:
För situationer där du behöver exakta formler, prydlig layout och en färdig lösning utan krånglig konfiguration visar vi här arbetsflödet med vårt eget verktyg Equalang.
3. Tre steg till ett parallellt läsflöde: engelska till vänster, översättning till höger
För att läsningen ska flyta på smidigt kan du jämföra originalet och den genererade översättningen sida vid sida för en fokuserad djupläsning.
Steg 1: Analysera hela dokumentet med formeloptimering aktiverad
Ladda upp den ursprungliga PDF-filen från arXiv på sidan för dokumentöversättning i Equalangs webbgränssnitt. För artiklar inom teknik, datavetenskap eller fysik med många matematiska formler skyddar systemet automatiskt både symboler i löpande text och fristående ekvationer under analysfasen.
Långa meningar som bryts av vid sidans nederkant sammanfogas först på en logisk styckenivå innan de översätts sammanhängande i sin kontext, så att meningen inte slits isär mellan sidorna.
Steg 2: Kontrollera komplexa formler och symbolstrukturer
När översättningen är klar behåller det genererade dokumentet originalartikelns spaltbredd, rubrikhierarki, figurer och bildtexter intakta.
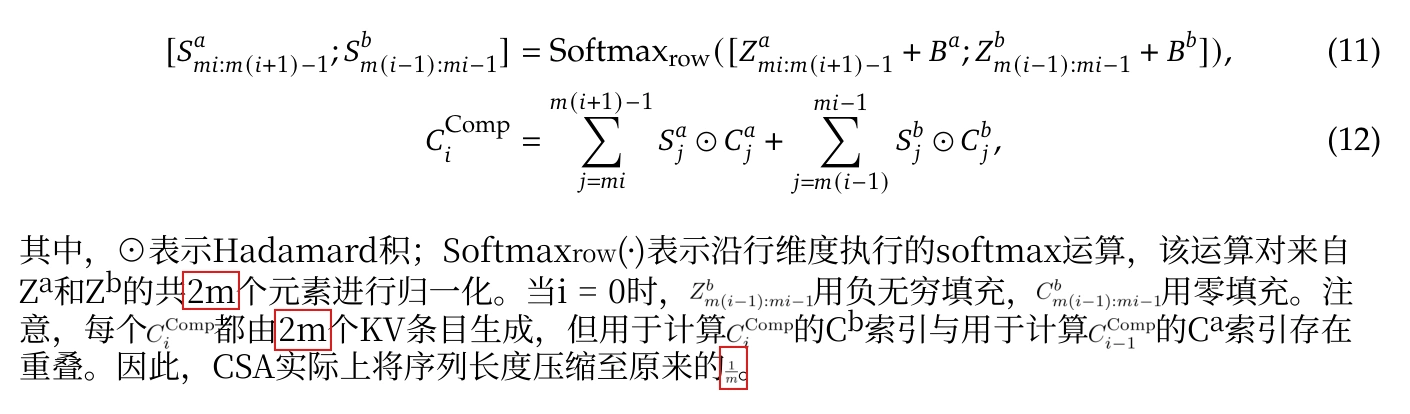
Vid läsning av artiklar med krävande härledningar, som DeepSeek-V4-artikeln, illustrerar bilden ovan hur formler och översatt text renderas:
- Symboler i löpande text översätts inte till text: Symboler i löpande text som 2m och Z^a har inte översatts till vanlig text, men teckenstorleken för vissa formler i texten har blivit märkbart mindre.
- Fristående ekvationer och numrering justeras korrekt: CSA-formlerna (11) och (12) centreras, ekvationsnumren till höger bevaras tydligt och den logiska härledningen hålls helt obruten.
Steg 3: Öppna originalet och översättningen i två fönster sida vid sida
Öppna det engelska originalet och den nedladdade kinesiska översättningen i separata fönster i Förhandsvisning i macOS, Acrobat, PDF Expert eller Edge och placera de två fönstren sida vid sida:
- Öppna det engelska originalet i fönstret till vänster på skärmen.
- Öppna motsvarande kinesiska översättning i fönstret till höger och bläddra till samma sidnummer.
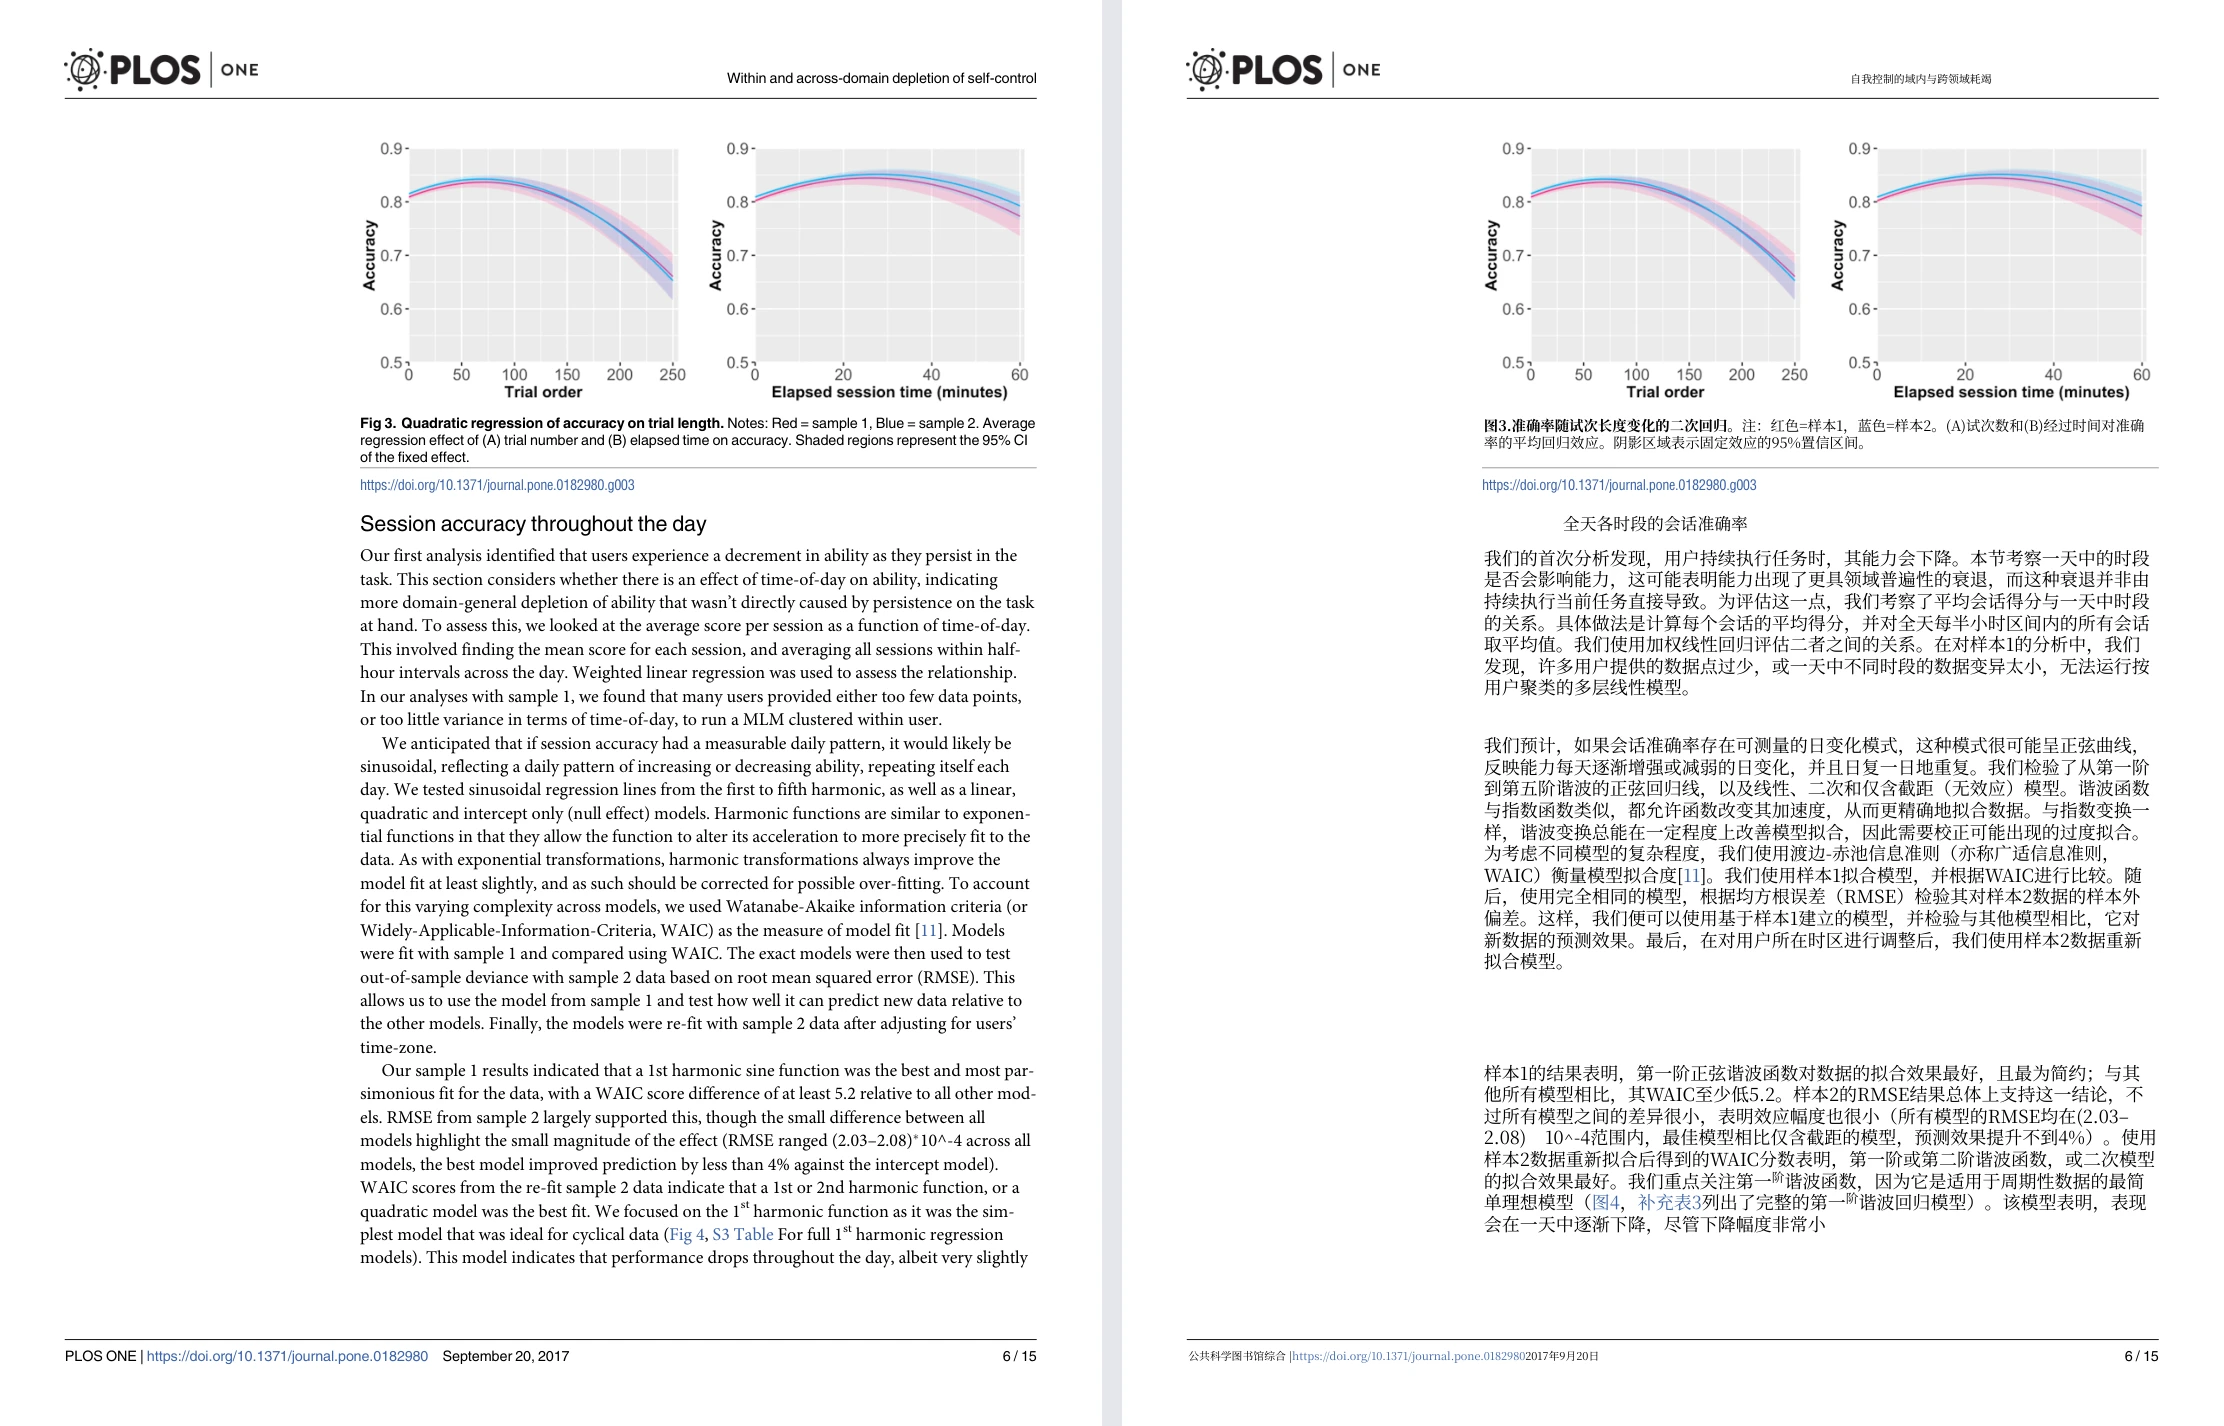
När inställningen är klar visar skärmens vänstra sida det engelska originalet på sida $N$ och den högra sidan motsvarande översättning (i exemplet till kinesiska) på sida $N$:
- Skumma resonemanget till höger för att snabbt greppa författarnas forskningssyfte, huvudteser och experimentella upplägg.
- När du stöter på viktiga formler, förkortningar eller svårtolkad kod flyttar du blicken till det engelska originalet till vänster för att kontrollera den ursprungliga matematiska definitionen.
4. Checklista för att undvika fallgropar vid akademisk djupläsning
När du använder verktyg för att läsa akademisk litteratur är det klokt att hålla fast vid några goda forskningsvanor:
- Gå tillbaka till originaldefinitionen vid viktiga slutsatser: Maskinöversättning sänker tröskeln avsevärt för dig som inte har engelska som modersmål. Men när det gäller citeringar, formella bevis eller kodimplementering bör du alltid utgå från originaltextens exakta formuleringar.
- Var uppmärksam på skillnaden mellan inskannade och vektorbaserade PDF:er: I äldre inskannade artiklar där texten inte har tolkats med högkvalitativ OCR kan layoutåtergivningen bli sämre. Välj om möjligt alltid officiella, vektorbaserade PDF-original från arXiv, IEEE eller ACM.
- Behåll originalnamn i pseudokod: Funktionsnamn, variabelnamn och biblioteksanrop (som termer i PyTorch eller TensorFlow) i algoritmer bör hållas på engelska så att översättningen inte försvårar det praktiska arbetet.
Referenser / Källor
- Equalang dokumentöversättning – officiell webbplats
- arXiv.org – öppen databas för preprints
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- PDFMathTranslate – öppen källkod för översättning av forskningsartiklar