Formules kapot bij arXiv vertalen? Handige tools op een rij
 Equalang
Kort samengevat
Breken LaTeX-formules en lange zinnen in academische PDF's? Ontdek de knelpunten en lees efficiënt met behoud van de tweekolomsopmaak en vergelijking van origineel en vertaling naast elkaar.
Trefwoorden: arXiv-papers vertalen; vertaaltools voor academische literatuur; PDF tweekolomsopmaak behouden; LaTeX-formules vertalen; papers lezen met dubbele paginaweergave
Wanneer je wekelijks de nieuwste preprints op arXiv bijhoudt of de lijst met geaccepteerde papers van topconferenties doorneemt, loop je als promovendus of onderzoeker al snel tegen een onzichtbare muur op. Zodra je alinea's uit een tweekoloms academische PDF kopieert naar een regulier vertaalvenster, veranderen zorgvuldige LaTeX-wiskundige formules, sub- en superscripts en sommatietekens plotseling in betekenisloze reeksen tekens. Afbreekstreepjes (hyphenation) bij kolom- of paginaovergangen knippen woorden genadeloos doormidden, met onsamenhangende machinevertalingen tot gevolg. En heb je eindelijk een pagina vertaald, dan zijn de verwijzingen naar figuren, tabellen en wiskundige afleidingen volledig uit hun verband gerukt. Het voortdurend schakelen tussen vensters om de juiste context terug te vinden, kost dan alle energie die je eigenlijk nodig hebt om de inhoud te begrijpen.
Het grootste struikelblok bij het doorgronden van grensverleggende literatuur is vaak niet een gebrek aan Engelse woordenschat, maar het feit dat verbroken formules, een versnipperde tweekolomsopmaak en het ontbreken van synchrone navigatie tussen bron en vertaling je analytische denkproces voortdurend onderbreken.
In dit artikel zetten we de belangrijkste criteria voor vertaaltools voor academische literatuur op een rij, vergelijken we de mogelijkheden en grenzen van opensource- en gangbare tools, en demonstreren we een efficiënte workflow om papers grondig te bestuderen — mét behoud van formules en de oorspronkelijke tweekolomsopmaak.
1. Waarom zijn academische papers zo lastig voor machinevertaling?
Reguliere vertaaltools (zoals algemene selectie-extensies in de browser of standaard tekstvakken) werken prima voor doorlopende alledaagse teksten, maar schieten bij academische PDF's hopeloos tekort. Dat komt vooral door drie specifieke technische uitdagingen van wetenschappelijke literatuur:
- Vlechting van LaTeX-formules en speciale symbolen: De hoofdtekst van een paper staat vol inline-variabelen (zoals $\theta_i, \mathbf{W}_Q$), sub- en superscripts, complexe breuken en losstaande tensolvergelijkingen. Algemene vertaalmodellen begrijpen de syntaxisboom van de opmaak niet. Ze zien wiskundige variabelen vaak aan voor gewone woorden en vertalen ze geforceerd, of breken een noemer met wortelteken $\sqrt{d_k}$ op in onsamenhangende tekens, waardoor de hele afleiding onbruikbaar wordt.
- Tweekolomsopmaak en fysieke paginaovergangen: Een PDF bestaat in wezen uit statische tekeninstructies voor printers en bevat van nature geen logische alineastructuur. Een tweekolomsindeling leidt bij gewone tools al snel tot verkeerde leesvolgordes over kolommen heen. Bovendien worden lange zinnen onderaan een pagina vaak botweg doormidden geknipt door de paginaovergang, wat resulteert in grove vertaalfouten.
- Verlies van nummering en kruisverwijzingen bij figuren en tabellen: Verwijzingen naar architectuurdiagrammen (Figure), tabellen met ablatie-experimenten (Table) of specifieke formules in de tekst (zoals Equation 3) raken tijdens standaard tekstextractie vrijwel altijd zoek of verschuiven, waardoor de rode draad van het betoog verdwijnt.
Een volwaardige vertaaltool voor academische literatuur moet daarom over drie kerncapaciteiten beschikken: gestructureerde analyse van de PDF-opmaak, behoud van LaTeX-formules op hun oorspronkelijke plek en een synchrone pagina-naast-paginaweergave van bron en vertaling.
2. Vergelijking van gangbare oplossingen voor academische vertaling
In het dagelijkse onderzoekswerk vallen de meest gebruikte vertaaloplossingen uiteen in drie categorieën, elk met duidelijke voor- en nadelen:
Voor situaties waarin nauwkeurige formules, een strakke opmaak en direct gebruiksgemak zonder installatie vereist zijn, laten we hieronder zien hoe dit werkt met ons eigen platform Equalang.
3. Een tweetalige leesworkflow in drie stappen: origineel links, vertaling rechts
Om academische papers soepel te kunnen lezen, kun je het origineel en de gegenereerde vertaling naast elkaar vergelijken voor een meeslepende, grondige bestudering.
Stap 1: Volledige documentanalyse met formule-optimalisatie
Upload de originele PDF die je van arXiv hebt gedownload op de pagina voor documentvertaling in de Equalang-webapplicatie. Bij papers uit de bètahoek, computerwetenschappen of natuurkunde met veel wiskundige formules beschermt het systeem tijdens de analysefase zowel inlinesymbolen als losstaande vergelijkingen.
Lange zinnen die onderaan een pagina worden afgekapt, voegt het systeem op logisch alineaniveau eerst weer samen voordat ze contextueel worden vertaald. Zo voorkom je dat zinnen onsamenhangend over twee pagina's worden verspreid.
Stap 2: Controleer de structuur van complexe formules en symbolen
Zodra de vertaling klaar is, behoudt het gegenereerde document nauwkeurig de kolombreedte, de niveaus van tussenkopjes, de oorspronkelijke figuren en de posities van bijschriften uit het bronpaper.
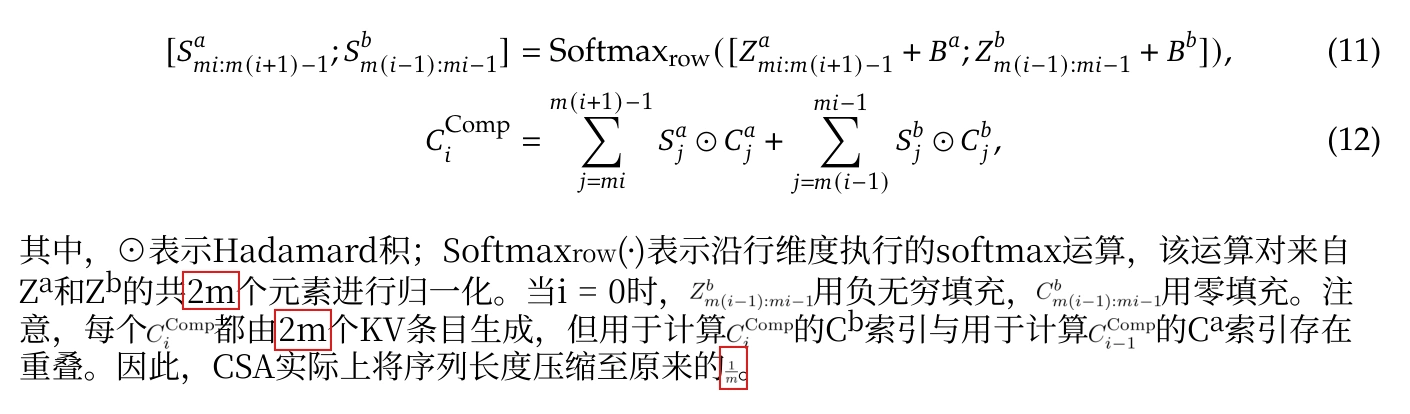
Bij het doornemen van grondige afleidingen, zoals in het DeepSeek-V4-paper, illustreert de bovenstaande afbeelding het effect van de formule- en vertaalopmaak:
- Inlinesymbolen niet vertaald naar tekst: Inlinesymbolen zoals 2m en Z^a zijn niet naar tekst vertaald, al is de lettergrootte van sommige inlineformules wel duidelijk kleiner geworden.
- Losstaande vergelijkingen en nummering blijven uitgelijnd: De CSA-formules (11) en (12) staan netjes gecentreerd en de formulenummers aan de rechterkant blijven behouden, zodat de logische opbouw van de tekst en de afleiding naadloos aansluiten.
Stap 3: Vergelijk het origineel en de vertaling in twee vensters naast elkaar
Open het Engelse origineel en de gedownloade Chinese vertaling afzonderlijk in macOS Voorvertoning (Preview), Acrobat, PDF Expert of Microsoft Edge en zet beide vensters links en rechts naast elkaar:
- Open in het venster aan de linkerkant van het scherm het Engelse origineel.
- Open in het venster aan de rechterkant van het scherm de bijbehorende Chinese vertaling en blader naar hetzelfde paginanummer.
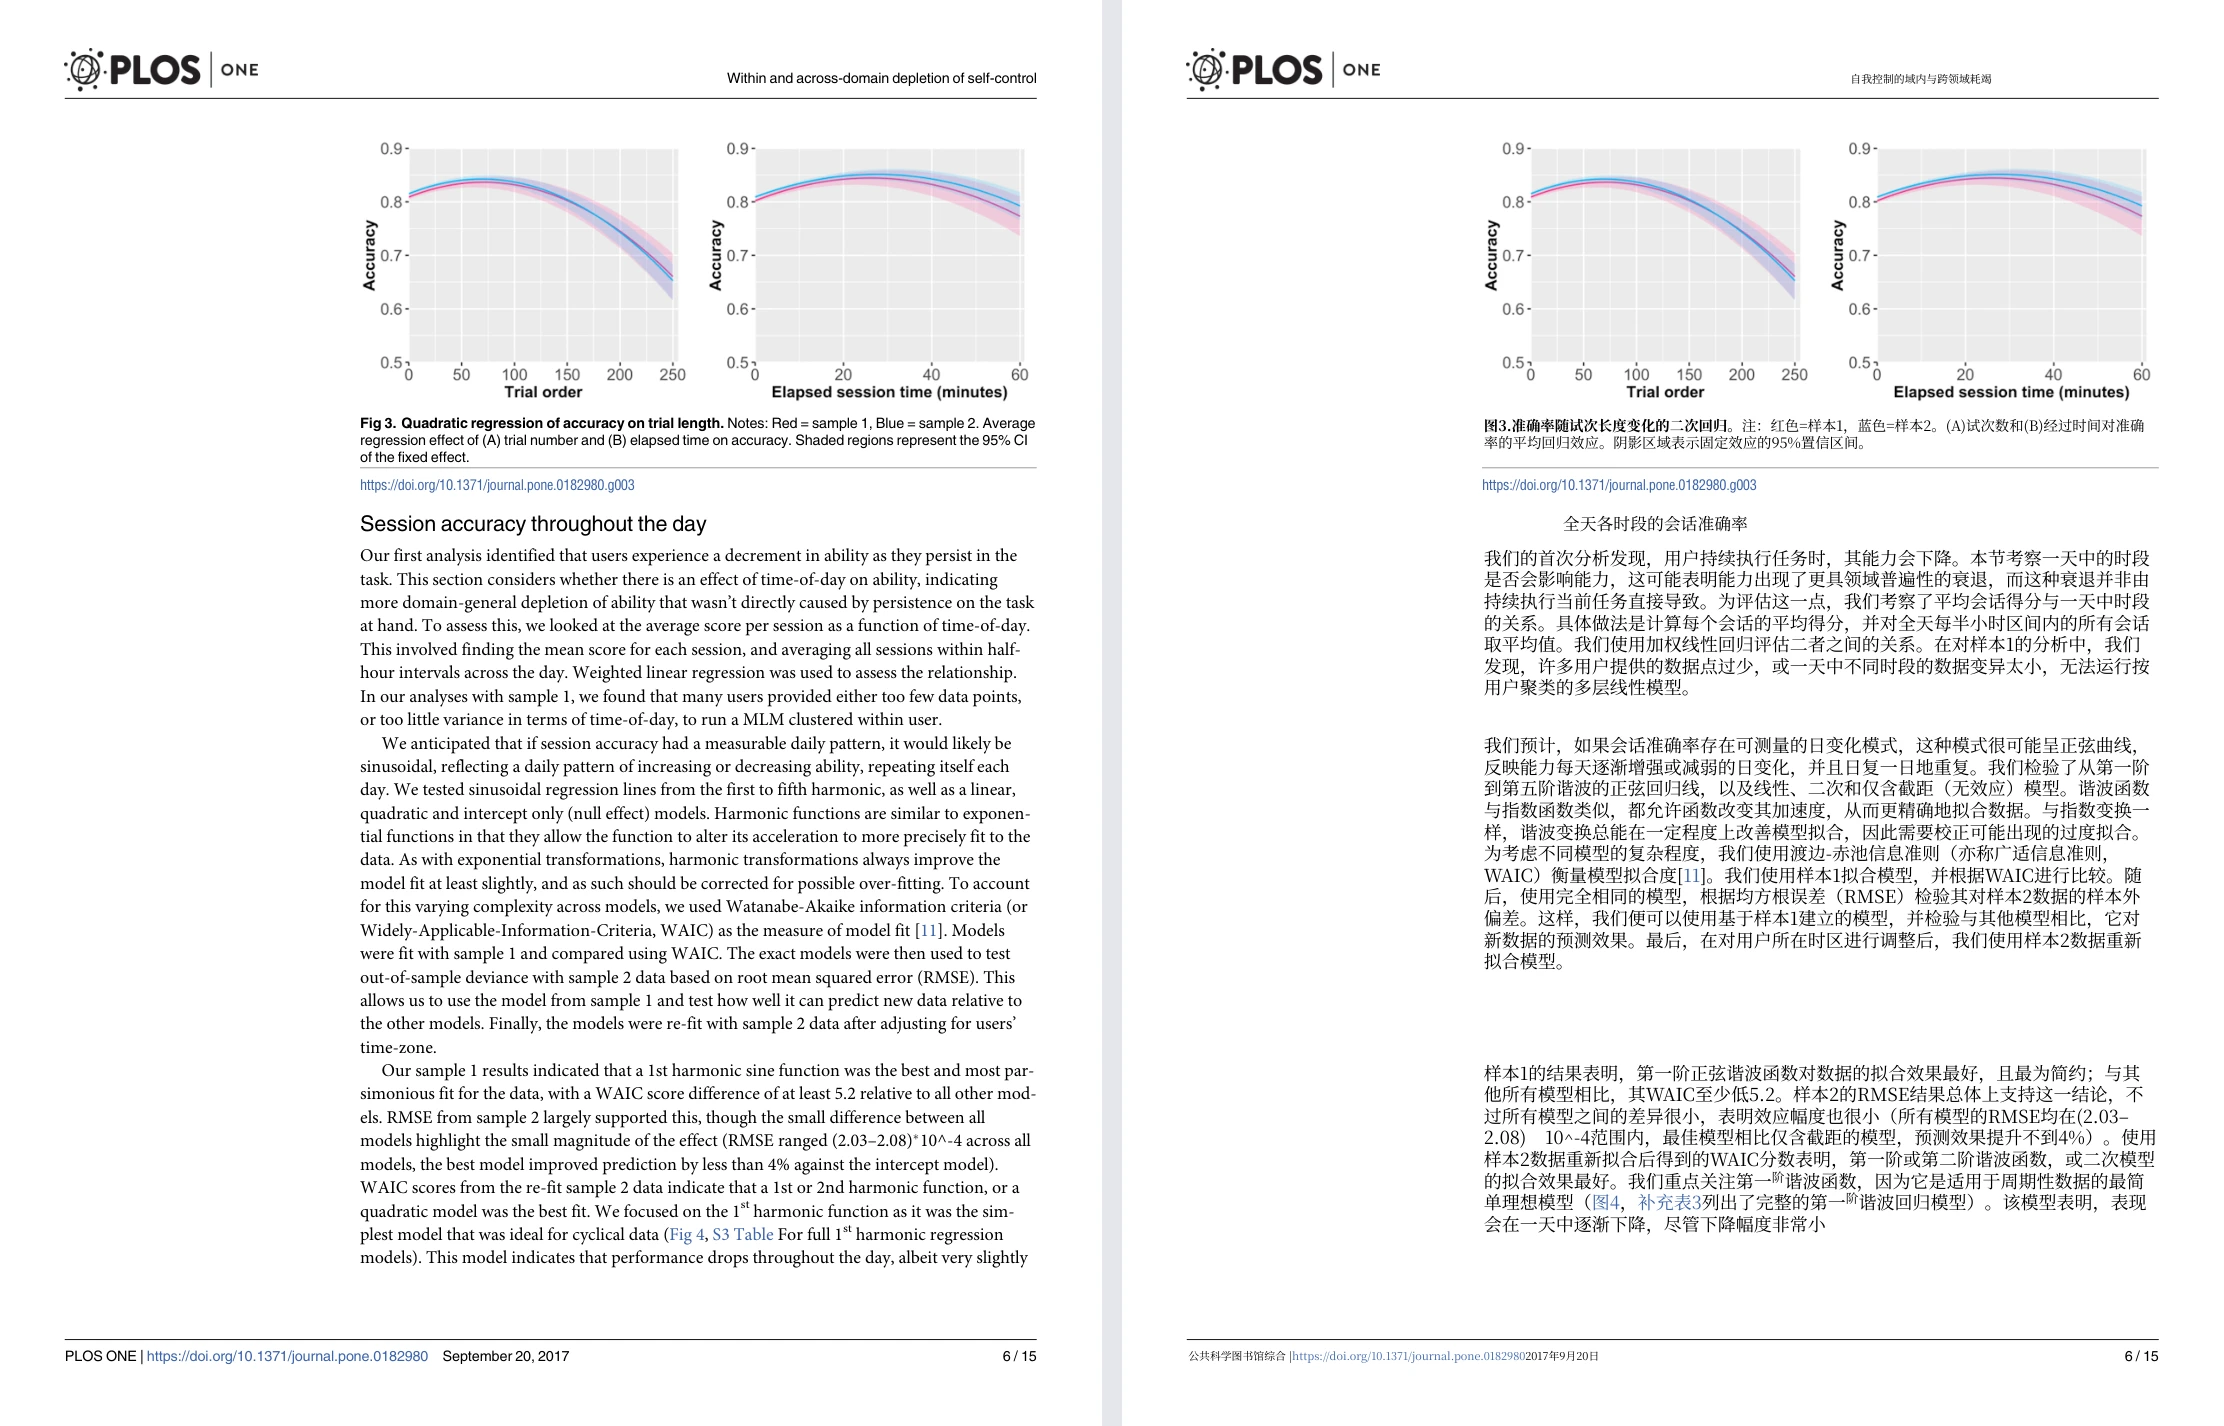
Na deze aanpassing zie je links op het scherm pagina $N$ van het Engelse origineel en rechts pagina $N$ van de Chinese vertaling:
- Kijk bij het doornemen van de tekst naar de Chinese vertaling rechts om snel de onderzoeksmotivatie, kernargumenten en de onderzoeksopzet te begrijpen;
- Stuit je op een cruciale formule, specifieke afkorting of complexe code, dan kijk je direct naar het Engelse origineel aan de linkerkant om de oorspronkelijke wiskundige definitie te controleren.
4. Tips en valkuilen bij tweetalig papers bestuderen
Wanneer je tools gebruikt om academische literatuur te lezen, raden we aan om de volgende gewoonten aan te houden:
- Controleer belangrijke conclusies altijd in het origineel: Machinevertaling verlaagt de drempel voor niet-moedertaalsprekers aanzienlijk. Bij citaties, strikte wiskundige bewijzen of het reproduceren van code moet je echter altijd uitgaan van de exacte formulering in het Engelse origineel.
- Let op het verschil tussen scans en vector-PDF's: Bij oudere gescande artikelen kan de opmaak minder nauwkeurig worden gereconstrueerd als er geen hoogwaardige OCR op is toegepast. Gebruik waar mogelijk de originele vectoriële PDF's van platforms zoals arXiv, IEEE of ACM.
- Behoud Engelse benamingen in complexe pseudocode: Functienamen, variabelen en verwijzingen naar externe bibliotheken (zoals operaties in PyTorch of TensorFlow) moeten in hun oorspronkelijke vorm blijven staan om verwarring bij de implementatie te voorkomen.
Bronnen / Sources
- Officiële pagina voor Equalang-documentvertaling
- arXiv.org open database voor academische preprints
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Projectrepository van de opensource-vertaaltool PDFMathTranslate voor academische papers