西班牙语PDF怎么翻译成英文?保留排版、
 意扣 Equalang
导读
将西班牙语PDF翻译为英文,需解决重音符号乱码、小数逗号与文本收缩问题。本文对比Google翻译、文档导出与意扣并排翻译,提供完整排版保留方案。
关键词:西班牙语PDF翻译成英文; 西班牙语PDF翻译; 西语文档翻译; PDF保留排版翻译; 西班牙语转英语
将西班牙语 PDF 翻译成英文并尽可能保留原始排版,最直接的处理方式取决于文件的排版结构与文字属性:
- 单栏普通文本文档:直接使用 Google 翻译的“文档”功能(支持
.pdf、.docx、.pptx、.xlsx,限制单文件不超过 10 MB 且不超过 300 页;不支持扫描页)。 - 需要深度编辑与重写的文件:通过 Adobe Acrobat 将 PDF 导出为 Word(
.docx)格式,翻译文本后再手动微调版面边距。 - 含多栏排版、复杂数据表格或官方统计报表的文档:使用专业的保留版式文档翻译工具(如意扣 Equalang),系统会自动拼合跨页截断的长句,重建表格单元格结构,并在网页端提供双栏同步对照工作台。
- 纯图片扫描件:常规文档翻译工具会直接跳过未嵌入文字层的扫描页面。处理扫描件必须先进行光学字符识别(OCR)提取文字层,再进行文档翻译(详见扫描版 PDF 的 OCR 与图片翻译对比)。
为什么西班牙语 PDF 译成英文容易排版错乱与字符乱码?
PDF 文件记录的是字符在页面坐标轴上的绝对绘制指令,而非流式排版的文字段落。在将西班牙语翻译为英文的过程中,有四个特殊的语言与技术细节极易引发排版崩溃:
1. 文本收缩与页面留白失衡
许多从事本地化的人熟悉英文译为欧洲语言时的“文本膨胀”,但在西译英场景中,情况往往相反——会出现明显的文本收缩。
W3C 国际化工作组在《翻译中的文本尺寸》(Text size in translation)指南中指出了这一现象:西语短语 “Idioma de la interfaz” 翻译为英文后变为 “Interface language”,字符长度明显减少。在固定宽高的 PDF 容器中,译文变短会导致大量未预期的空白区域(white space)。如果翻译工具不能自适应调整容器间距,多栏排版与表格就会显得空旷零落、对齐失准。
2. 重音字符与 Unicode 规范化问题
西班牙语包含带重音符号的元音(á, é, í, ó, ú)与特殊字母 ñ。在数字 PDF 内部,这些字符通常以两种形式存储:
- 预组字符(Precomposed):作为一个单一的代码点存储(如
U+00E1代表 á)。 - 分解字符(Decomposed):由基础字母与组合重音标记拼接而成(如
U+0061加U+0301)。
正如 W3C 在规范化指南中所阐述,解析软件必须对其进行 Unicode 规范化处理。若提取程序未做规范化,重音字母在导出或翻译时极易沦为乱码(例如将 Índice 错误拆散为 ´Indice 或问号),导致后续检索和翻译彻底失效。
3. 西语正反双重标点符号(¿ 和 ¡)
根据西班牙皇家语言学院(RAE)正字法规范,西班牙语中的疑问句和感叹句必须成对使用标点:句首使用倒置标点(¿ 与 ¡),句尾使用常规标点(? 与 !)。合格的英译工具在处理西语源文本时,必须准确识别并去除开头的倒置标点,同时不能破坏原有分句与大小写边界。
4. 小数逗号与月份缩写差异
西班牙语官方统计与经贸报告惯常使用逗号作为小数分隔符(例如统计局报告中的 4,9%)。翻译为英文时,需要规范转换为英文通用的数字格式(4.9%)。此外,图表横轴上的月份简写(如 ene-25, abr-26, ago-26 分别代表一月、四月与八月)也需要准确映射为英文缩写。
三种翻译西班牙语 PDF 的常见方法与取舍
方案一:Google 翻译的“文档”功能
在浏览器中打开 Google 翻译网页版,切换至“文档”标签页,上传本地 .pdf 文件并设定语言对为西译英。处理完成后即可下载带有翻译结果的新文件。
使用边界:Google 翻译文档模式明确限制单文件不超过 10 MB 和 300 页。官方帮助文档特别指出:扫描页面不予翻译。此外,若页面包含密集表格或双栏学术排版,下载后的文本常会出现层级重叠或跑位。
方案二:Adobe Acrobat 导出为 Word 后翻译
如果后续需要由人工译员逐句润色并修改内容,将 PDF 转换为 Word 是常见做法(关于两种路径的详细对比,可参考PDF转Word与原生文档翻译对比)。
使用边界:PDF 转换为 Word 后,原始版面常被拆解为几十个独立的浮动文本框。当简短的英文替换了较长的西班牙语后,文本框不会自动回缩吸附,往往需要花费大量时间重新调整版心与行距。
方案三:使用意扣(Equalang)进行保留版式翻译
对于必须严格维持原文档结构的官方公报、双栏研究报告和商业报价表,使用保留版式的文档引擎可以在省去重排成本的同时保障阅读质量。
下面用意扣(Equalang)演示完整处理流程。
实测操作:以西班牙国家统计局官方报告为例
本次实测使用西班牙国家统计局(INE)于 2026 年 10 月 30 日发布的《消费者物价指数先行指标》官方公报(adIPC1026.pdf,共 4 页,CC BY 4.0 许可)。
这份官方文件包含了典型的复杂排版要素:多处重音字符(Índice, Armonizado, variación, décima)、小数逗号(4,9%)、两页折线图与柱状图轴标(ene-25 至 oct-26),以及第 4 页关于调查方法学(样本量 177 个市镇等)的双栏表格结构。
第一步:确认 PDF 为数字原生文档
在本地 PDF 阅读器中打开文件,尝试划选文字 «Tasa de variación anual estimada del IPC» 并复制到剪贴板。如果复制出来的文字带有正常的重音符号,说明文件是原生数字文本;若无法划选或选中的是一整张底图,则属于扫描件,需先经过 OCR 处理。
第二步:上传文件发起翻译任务
在电脑端进入意扣文档翻译页面:
- 源语言选择“西班牙语”(或任意语言),目标语言选择“英语”。
- 拖入或选取
adIPC1026.pdf。意扣支持一个接一个上传文件;同一账号最多同时处理 3 份文档,超出部分自动进入排队队列。 - 系统开始提取文本,并在保留分栏、页眉页脚、图注层级的同时,自动把被分页符切断的跨页句子拼回完整语义再行翻译。
第三步:在翻译工作台中比对校核
任务完成后,点击进入翻译工作台。意扣(Equalang)翻译工作台采用左侧西班牙语原文、右侧英语译文的并排架构:
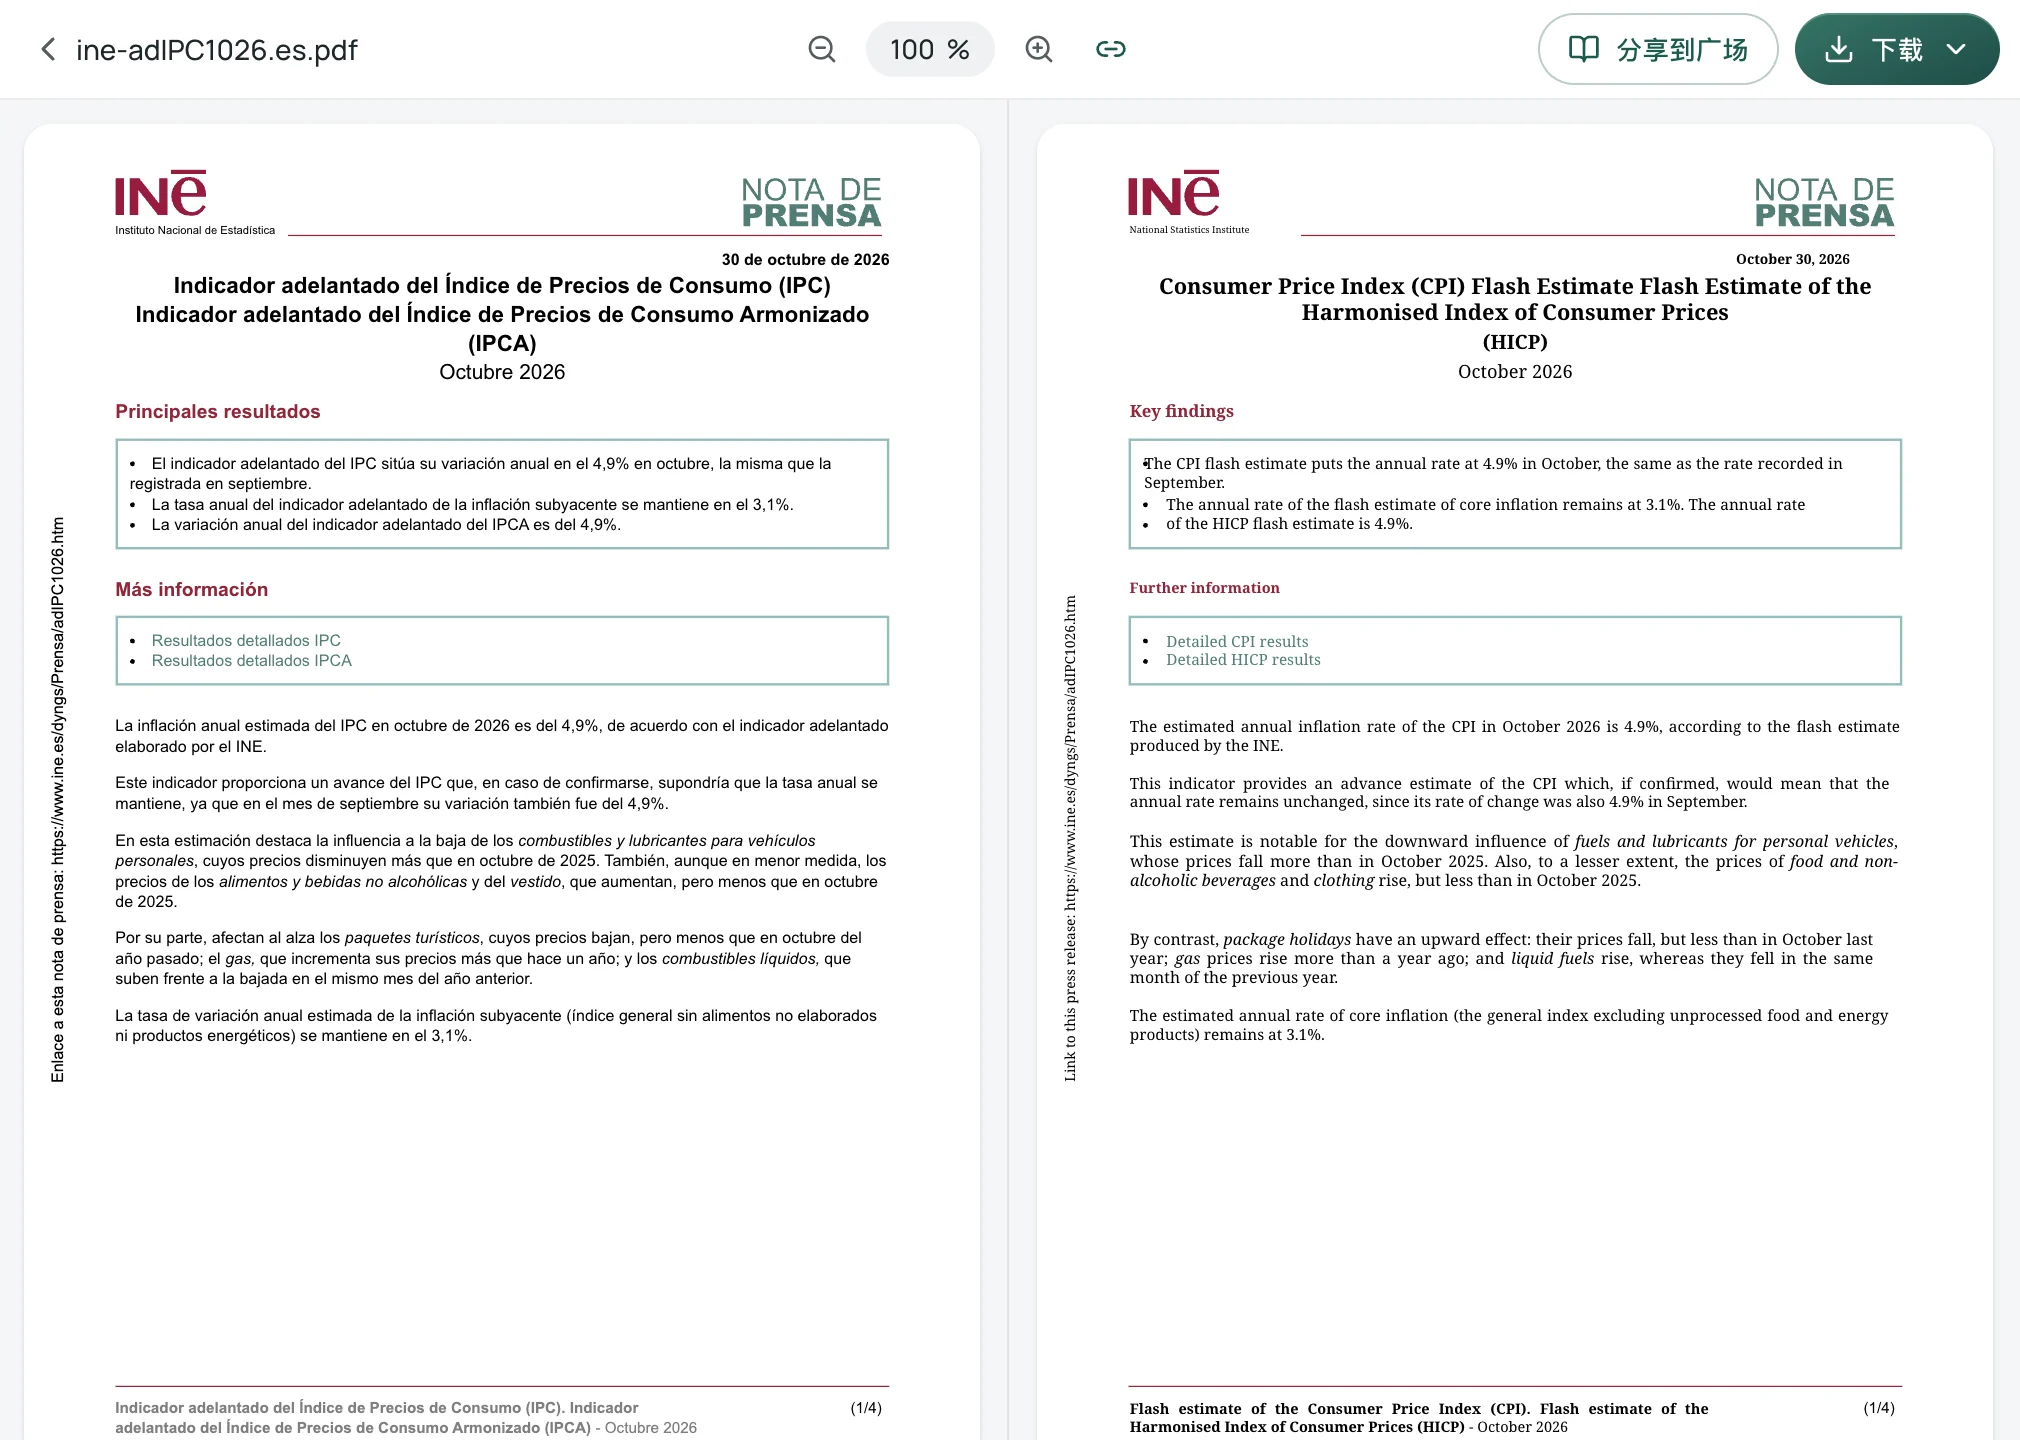
在工作台顶部点击同步滚动图标,向下滑动原文时,右侧译文会同步位移。读者可以快速对照检查两栏内容与数据是否对应,如验证 NOTA DE PRENSA 页眉、标题与要点框是否排入对应位置。
第四步:选择适合的译文形式下载
根据使用需要,意扣提供两种文件输出形态:
- 译文 PDF:页数与原文完全一致的单语英文 PDF,保留原有排版结构与字体加粗样式。
- 对照文件:原文页与译文页逐页交替排列的 PDF。下载后在本地阅读器中打开,切换到“双页视图”并关闭“封面单独显示”,即可在屏幕上获得左页西语、右页英语的高保真对照阅读体验。
西班牙语 PDF 译后核查清单
完成翻译后,建议按以下四项重点快速复核译稿:
- 数字与小数点:检查西语中的小数逗号(如 4,9%)是否已按英文习惯规范转为小数点(4.9%)。
- 标点清理:确认英文译文中没有残留西语特有的句首倒置问号(¿)或感叹号(¡)。
- 图表时间轴:确认折线图或柱状图轴上的西语月份简写(ene, abr, ago)与英文月份(Jan, Apr, Aug)准确对应。
- 跨页接缝处:检查位于页面底部的段落,确保跨页句子语义完整,没有因分页出现漏词或语法断裂。
如需处理包含复杂数学公式或学术文献的 PDF,可进一步参考我们的学术论文 PDF 翻译指南。
参考资料
- W3C 国际化工作组,翻译中的文本尺寸(Text size in translation):https://www.w3.org/International/articles/article-text-size.en
- W3C 国际化工作组,HTML 与 CSS 中的规范化(Normalization in HTML and CSS):https://www.w3.org/International/questions/qa-html-css-normalization
- Google 翻译帮助中心,翻译文档和网页:https://support.google.com/translate/answer/2534559?hl=en&co=GENIE.Platform%3DDesktop
- 西班牙国家统计局(INE),消费者物价指数先行指标(2026年10月):https://www.ine.es/dyngs/Prensa/adIPC1026.pdf (CC BY 4.0)
- 西班牙皇家语言学院(RAE),西班牙语正字法:疑问符号与感叹符号:https://www.rae.es/ortografía/los-signos-de-interrogación-y-exclamación
- 意扣文档翻译:/documents
- 意扣价格方案:/pricing