Översatta PDF:er tappar formateringen – så behåller du den
 Equalang
I korthet
En Word-fil markerar vad som är stycke eller tabell; de flesta PDF-filer gör inte det. Två artiklar visar vad som går sönder och vad du bör kontrollera.
Nyckelord: översätta PDF; dokumentöversättning; PDF-formatering; bevara layouten; forskningsartiklar
En Word-fil registrerar vilka ord som bildar ett stycke och vilka som hör till en tabell. De flesta PDF-filer gör inte det. De lagrar bara bokstäverna och de koordinater där de ska ritas ut; stycken, tabeller och meningar är något som läsarens öga sätter samman. En del PDF-filer har tillgänglighetstaggar (tillagda för skärmläsare) som markerar stycken och tabeller, men många har det inte (de två artiklar vi använder som exempel nedan har inga alls), så ett översättningsverktyg kan inte räkna med dem. Allt du ser som struktur — en tvåspaltig layout, en rubrik som spänner över flera spalter eller en mening som fortsätter på nästa sida — måste återskapas innan någon översättning sker. Sedan ska den översatta texten, som nu blivit längre eller kortare, passa tillbaka in i den ursprungliga layouten. Formateringen försvinner i något av de två stegen.
Vad du bör göra beror på vad du har:
- Originalfilen .docx eller .pptx: översätt den i stället för PDF-filen.
- En enkel textbaserad PDF med få tabeller, under 10 MB: Google Översätts kostnadsfria dokumentuppladdning är det snabbaste alternativet att prova.
- En artikel, handbok eller rapport med tabeller, formler eller två spalter: använd ett översättningsverktyg som återskapar layouten och kontrollera sedan de fyra ställena i avsnitt 3.
- En skannad fil (där du inte kan markera texten): den behöver textigenkänning (OCR) innan den kan översättas. DeepL tar emot skannade filer och sköter det steget själv. Google Översätt lämnar skannade sidor oöversatta.
1. Vad ser ett översättningsverktyg egentligen i en PDF?
Vi bygger ett verktyg för dokumentöversättning, så vi lägger mycket tid på att se vad som kommer ut ur PDF-filer. För att visa det tydligt tog vi två forskningsartiklar om AI-språkmodeller från arXiv, LLaMA och Mistral 7B, och extraherade texten med mutool från MuPDF, ett vanligt PDF-verktyg med öppen källkod. Den texten är ungefär det ett verktyg arbetar med om det inte också läser layouten. Nedan visas varje avsnitt först så som det ser ut på sidan, sedan så som det kommer ut (en rad med bara … betyder att vi hoppade över några rader).
1.1 Tabeller blir en lista med siffror
Tabell 3 i LLaMA-artikeln jämför tio modeller i åtta tester:
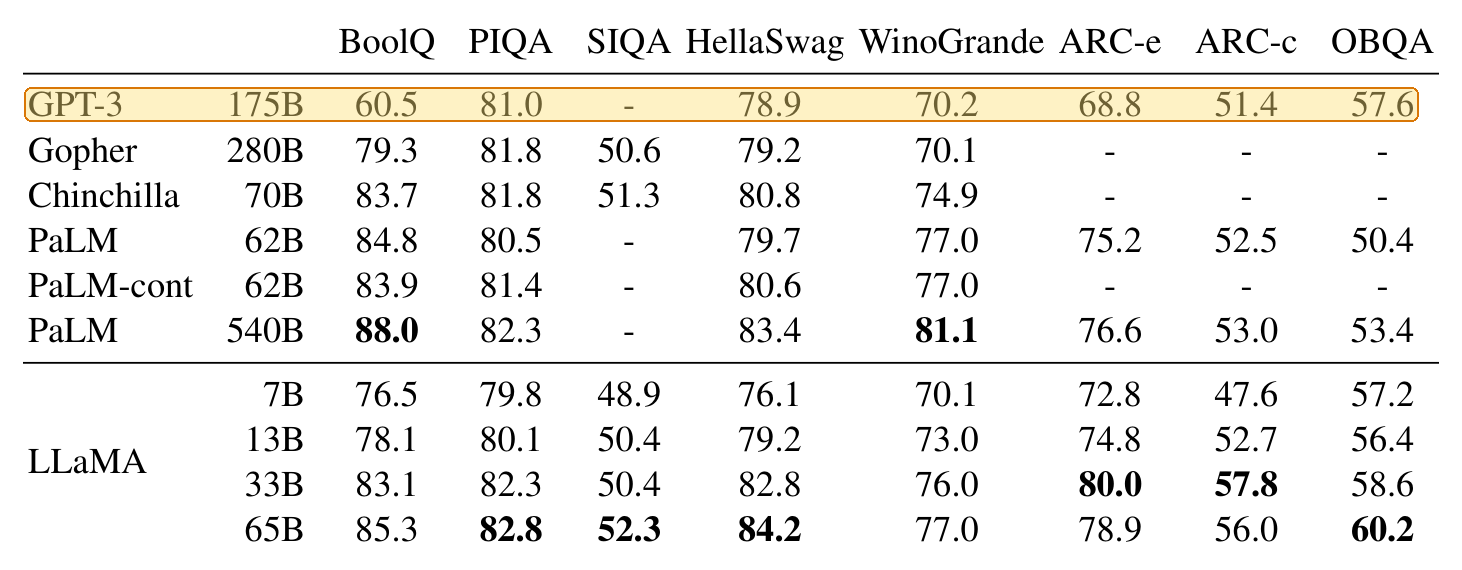
Extraherad är den 102 rader: en rubrik på fem rader, sedan ett värde per rad. Här är de första 16; de tio från GPT-3 till 57.6 är den markerade tabellraden.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Inget talar om för verktyget vilken siffra som hör till vilket test. Om du klistrar in det i en översättningsruta får du samma lista tillbaka. Orden är översatta, men tabellen är borta.
1.2 En mening med en hel tabell inuti
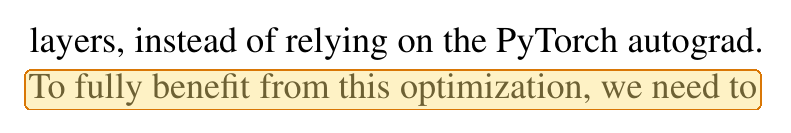
Den sista meningen på sida 3 i LLaMA-artikeln stannar vid ”we need to”:
Den fortsätter i den vänstra spalten på sida 4, strax under tabell 3:
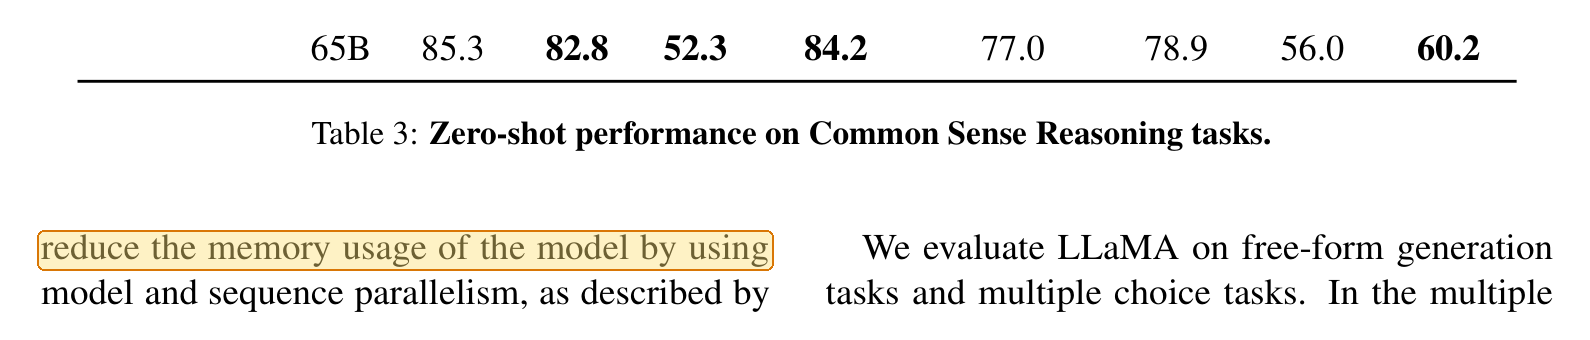
I den extraherade texten ryms en fotnot, sidbrytningen, alla 102 rader i tabellen och dess tabelltext inuti den enda meningen:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Samma sak händer två sidor senare. Sida 5 slutar med ”…the textual description and tests in a”, och ”docstring.” kommer först efter tabell 7 på sida 6, med tabellens 44 rader och en tabelltext på sju rader emellan.
Ett verktyg som översätter sida för sida, eller följer texten i exakt den ordningen, får två fragment som det inte har någon anledning att binda samman. I den översatta filen ser du en mening som dör ut längst ner på en sida, medan dess andra hälft dyker upp någonstans under en tabell.
1.3 Nedsänkta tecken och bråk blir något annat
I Mistral-artikeln skrivs en variabel som h med nedsänkt i:
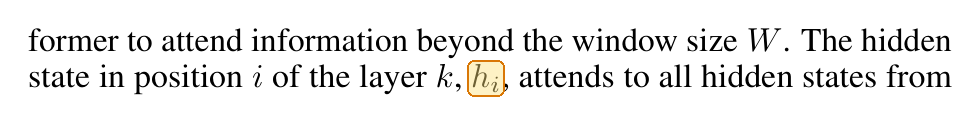
När texten extraheras försvinner det nedsänkta tecknet och bara hi blir kvar:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Ett översättningsverktyg har ingen anledning att behandla det som en variabel. För verktyget är hi bara ett vanligt engelskt ord.
Bråk klarar sig sämre. LLaMA sätter ett värde till två tredjedelar av 4d, skrivet som ⅔·4d där ⅔ är satt som en liten 2:a över en 3:a:
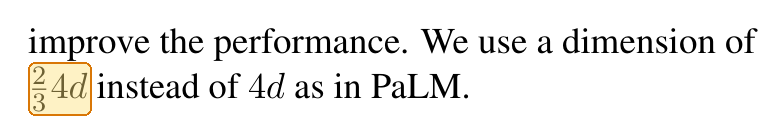
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Två tredjedelar av 4d har blivit 34d. Upphöjda tecken, bråk och symboler från matematiska typsnitt är bara former placerade på vissa positioner. Extraherad text behåller formerna men tappar positionerna.
1.4 Ord bryts vid radslut
Tvåspaltiga artiklar delar många ord vid radslut. I LLaMA bryter 242 rader ett vanligt ord med liten bokstav med bindestreck. Att foga ihop dem igen ser lätt ut, tills du kommer till ett bindestreck som hör till ett namn:
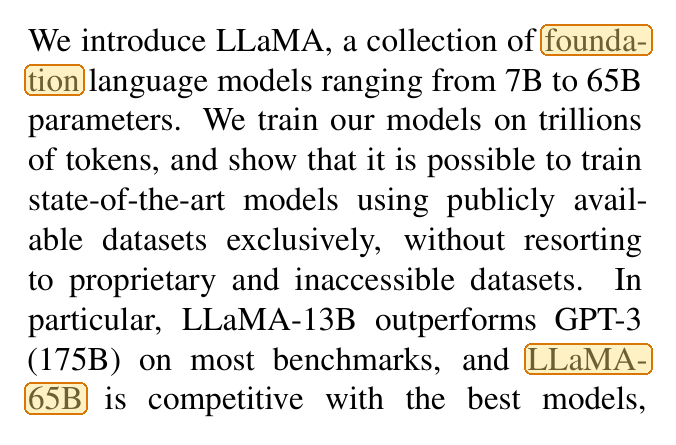
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- och tion blir ett ord utan bindestreck. Men i LLaMA- och 65B är bindestrecket en del av modellens namn och måste vara kvar.
Vi körde bara ett extraheringsverktyg på två artiklar gjorda i LaTeX, ett sättningssystem som är vanligt i akademisk publicering. PDF-filer exporterade från Word, skannade dokument och andra extraheringsverktyg kan ge andra resultat, men dessa fyra typer av skador är vad du ska leta efter.
2. Vilka alternativ har du?
Uppgifterna om Google Översätt och DeepL kommer från deras egna hjälpsidor, kontrollerade den 7 oktober 2026. När en PDF-översättning gör dig besviken är DeepL:s råd att ladda upp originaldokumentet i stället. Det är samma råd som vi ger.
Den sista raden är precis det som Equalangs dokumentöversättning är byggd för, så det är den metod vi känner bäst. Innan översättningen sätter Equalang ihop meningar som en sidbrytning har delat i två. Tabeller med sammanfogade celler och rubriker i flera rader återskapas i sin ursprungliga struktur i stället för att plattas ut till en enda lista. Formler kastas inte bort som oläsbar text, och det finns ett alternativ för formeloptimering för svåra formler som står inne i en textrad.
Vad det inte gör är att återskapa originalet exakt. En översättning som blir längre än originalet flyttar radbrytningar och teckenstorlekar, så sidor med kompakt layout är fortfarande värda att se över. Dokumentöversättning omfattar i dag kinesiska, engelska, japanska, koreanska, spanska, franska och andra språk.
3. Vad bör du kontrollera när en PDF har översatts?
- Tabeller. Står rubrikerna fortfarande över rätt kolumn? Har siffrorna ändrats?
- Sidbrytningar och texten under varje tabell. Läs den sista raden på varje sida och meningen direkt efter varje tabell. En mening som tar slut och aldrig blir färdig är det vanligaste tecknet på att texten översattes i bitar.
- Formler och variabler. Kontrollera några som står inne i en textrad. Leta efter bokstäver som blivit ord och bråk som blivit andra siffror.
- Sidantal och länkar. Ett mycket annorlunda sidantal betyder att text har fallit bort eller spillt över på extra sidor. Klicka på en eller två poster i innehållsförteckningen för att se om de fungerar.
Källor
- Touvron med flera, "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang med flera, "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Hjälpen för Google Översätt, Translate documents & websites, kontrollerad den 7 oktober 2026.
- DeepL:s hjälpcenter, Translate PDF files, kontrollerad den 7 oktober 2026.
- Metod: texten extraherades den 7 oktober 2026 med MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Bilderna är utsnitt av artiklarnas sidor; markeringarna är våra.