pdf vertalen: waarom de opmaak sneuvelt en wat je kunt doen
 Equalang
Kort samengevat
De meeste pdf’s geven niet aan welke woorden een alinea of een tabel vormen. Met twee papers laten we zien wat er misgaat en wat je kunt controleren.
Trefwoorden: pdf vertalen; documentvertaling; pdf-opmaak; lay-out behouden; wetenschappelijke papers
Een Word-bestand legt vast welke woorden samen een alinea vormen en welke bij een tabel horen. De meeste pdf’s doen dat niet. Ze bewaren alleen de letters en de coördinaten waarop die getekend moeten worden; alinea’s, tabellen en zinnen worden pas in het hoofd van de lezer gevormd. Sommige pdf’s hebben toegankelijkheidstags (toegevoegd voor schermlezers) die alinea’s en tabellen markeren, maar veel hebben die niet (de twee papers die we hieronder als voorbeeld gebruiken hebben er geen), dus een vertaaltool kan er niet op vertrouwen. Alles wat jij als structuur ziet (een lay-out met twee kolommen, een kop die over meerdere kolommen loopt, een zin die op de volgende pagina doorgaat) moet eerst opnieuw worden afgeleid voordat er vertaald kan worden. Daarna moet de vertaalde tekst, nu langer of korter, weer in de oorspronkelijke lay-out passen. De opmaak gaat in een van die twee stappen verloren.
Wat je moet doen, hangt af van wat je hebt:
- Het oorspronkelijke .docx- of .pptx-bestand: vertaal dat in plaats van de pdf.
- Een eenvoudige tekst-pdf met weinig tabellen, kleiner dan 10 MB: de gratis documentupload van Google Vertalen is de snelste optie om te proberen.
- Een paper, handleiding of rapport met tabellen, formules of twee kolommen: gebruik een vertaaltool die de lay-out opnieuw opbouwt en controleer daarna de vier punten uit sectie 3.
- Een scan (waarbij je geen tekst kunt selecteren): die heeft tekstherkenning (OCR) nodig voordat hij vertaald kan worden. DeepL accepteert scans en regelt die stap zelf. Google Vertalen laat gescande pagina’s onvertaald.
1. Wat ziet een vertaaltool eigenlijk in een pdf?
Wij bouwen een tool voor documentvertaling, dus we kijken veel naar wat er uit pdf’s komt. Om dat duidelijk te maken, hebben we twee papers over AI-taalmodellen van arXiv genomen, LLaMA en Mistral 7B, en de tekst ervan geëxtraheerd met mutool van MuPDF, een veelgebruikte open-source pdf-tool. Die tekst is ongeveer waar een tool mee werkt als hij ook de lay-out niet leest. Hieronder staat elk fragment eerst zoals het op de pagina staat en daarna zoals het eruit komt (een regel met alleen … betekent dat we regels hebben overgeslagen).
1.1 Tabellen veranderen in een lijst getallen
Tabel 3 in het LLaMA-paper vergelijkt tien modellen op acht tests:
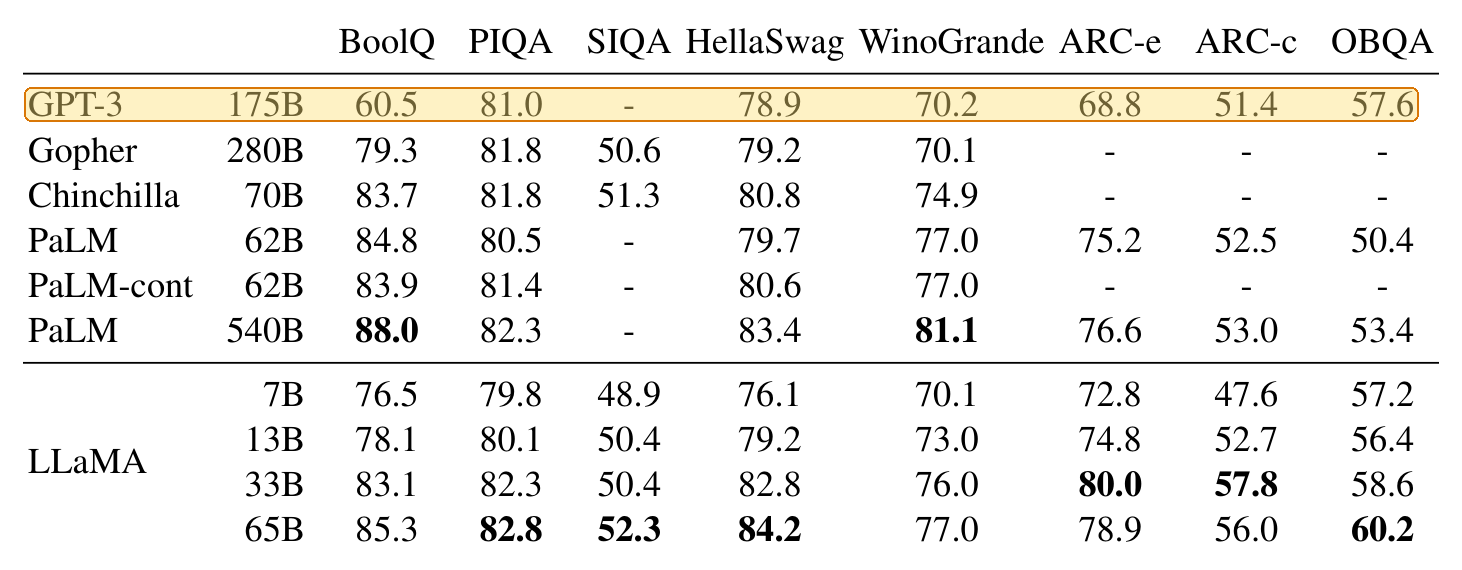
Na extractie zijn het 102 regels: een kop van vijf regels en daarna één waarde per regel. Dit zijn de eerste 16; de tien van GPT-3 tot 57.6 zijn de gemarkeerde rij.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Niets vertelt de vertaaltool bij welke test een getal hoort. Als je dit in een vertaalvak plakt, krijg je dezelfde lijst terug. De woorden zijn vertaald, maar de tabel is verdwenen.
1.2 Eén zin, met een hele tabel erin
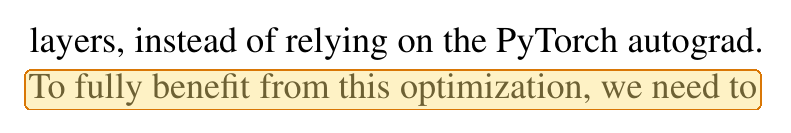
De laatste zin op pagina 3 van het LLaMA-paper stopt bij "we need to":
Hij gaat verder in de linkerkolom van pagina 4, direct onder tabel 3:
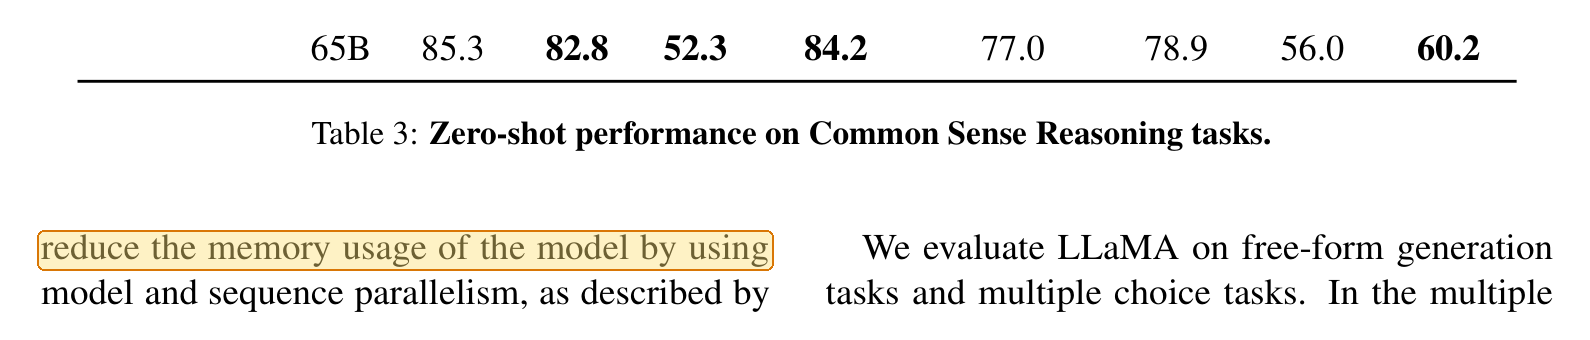
In de geëxtraheerde tekst staan een voetnoot, de pagina-overgang, alle 102 regels van de tabel en het bijschrift ervan middenin die ene zin:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Twee pagina’s later gebeurt het opnieuw. Pagina 5 eindigt met "…the textual description and tests in a", en "docstring." komt pas na tabel 7 op pagina 6, met daartussen de 44 regels van de tabel en het bijschrift van zeven regels.
Een tool die pagina voor pagina vertaalt, of de tekst in precies deze volgorde volgt, krijgt twee fragmenten zonder enige reden om ze aan elkaar te koppelen. In het vertaalde bestand zie je een zin die onderaan een pagina wegsterft, en de andere helft duikt ergens onder een tabel weer op.
1.3 Subscripts en breuken worden iets anders
In het Mistral-paper staat een variabele geschreven als h met subscript i:
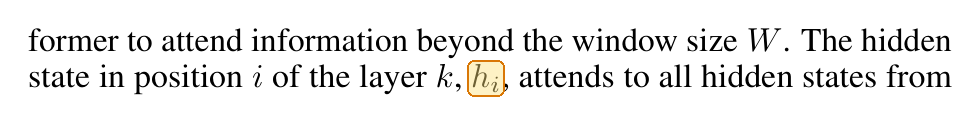
Bij extractie verdwijnt het subscript en blijft hi over:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Een vertaaltool heeft geen enkele reden om dat als variabele te behandelen. Voor de tool is hi gewoon een alledaags Engels woord.
Breuken komen er slechter vanaf. LLaMA stelt een waarde vast op twee derde van 4d, geschreven als ⅔·4d, waarbij de ⅔ is opgebouwd uit een kleine 2 boven een 3:
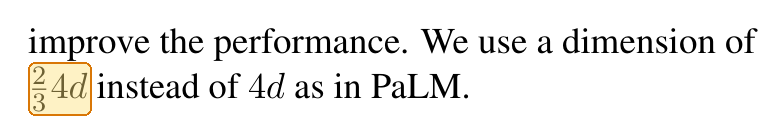
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Twee derde van 4d is 34d geworden. Superscripts, breuken en symbolen uit wiskundige lettertypen zijn alleen vormen op een bepaalde positie. De geëxtraheerde tekst houdt de vormen, maar verliest de posities.
1.4 Woorden worden aan het einde van een regel afgebroken
Papers met twee kolommen breken veel woorden aan het einde van een regel af. In LLaMA breken 242 regels een gewoon woord in kleine letters af met een afbreekstreepje. Ze weer aan elkaar plakken lijkt eenvoudig, tot je bij een streepje komt dat bij een naam hoort:
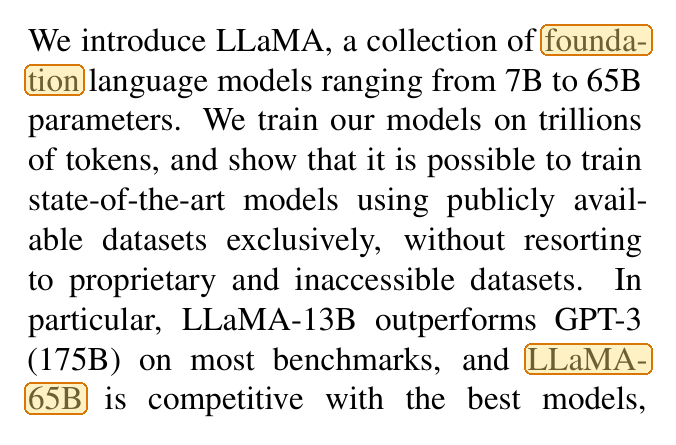
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- en tion vormen samen één woord zonder het streepje. Maar bij LLaMA- en 65B hoort het streepje bij de naam van het model en moet het blijven staan.
We hebben maar één extractietool gebruikt, op twee papers die met LaTeX zijn gemaakt, een opmaaksysteem dat in de academische wereld veel wordt gebruikt. Pdf’s die vanuit Word zijn geëxporteerd, gescande documenten en andere extractietools kunnen iets anders opleveren, maar dit zijn de vier soorten schade waar je op moet letten.
2. Welke opties heb je?
De gegevens over Google Vertalen en DeepL komen uit hun eigen hulppagina’s, geraadpleegd op 7 oktober 2026. Als een pdf-vertaling tegenvalt, adviseert DeepL om in plaats daarvan het oorspronkelijke document te uploaden. Dat is ook ons advies.
De laatste regel is precies waar de documentvertaling van Equalang voor is gemaakt, dus dat is de aanpak die wij het beste kennen. Voordat Equalang vertaalt, worden zinnen die door een pagina-overgang zijn doormidden geknipt weer samengevoegd. Tabellen met samengevoegde cellen en koppen over meerdere rijen worden in hun oorspronkelijke structuur opnieuw opgebouwd, in plaats van platgeslagen tot één lijst. Formules worden niet als onleesbare tekst weggegooid, en er is een optie voor formule-optimalisatie voor lastige formules die midden in een regel tekst staan.
Wat het niet doet, is het origineel exact reproduceren. Een vertaling die langer is dan het origineel verschuift regeleinden en lettergroottes, dus pagina’s met een krappe lay-out zijn nog steeds een controle waard. Documentvertaling ondersteunt momenteel Chinees, Engels, Japans, Koreaans, Spaans, Frans en andere talen.
3. Wat controleer je als de pdf vertaald is?
- Tabellen. Staan de koppen nog boven de juiste kolom? Zijn de getallen ongewijzigd?
- Pagina-overgangen en de tekst onder elke tabel. Lees de laatste regel van elke pagina en de zin direct na elke tabel. Een zin die stopt en nooit meer afkomt, is het duidelijkste teken dat de tekst in stukken is vertaald.
- Formules en variabelen. Bekijk er een paar die midden in een regel tekst staan. Let op letters die woorden zijn geworden en breuken die andere getallen zijn geworden.
- Aantal pagina’s en links. Een heel ander pagina-aantal betekent dat tekst is weggevallen of naar extra pagina’s is uitgelopen. Klik op één of twee ingangen in de inhoudsopgave om te zien of ze werken.
Bronnen
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Help van Google Vertalen, Translate documents & websites, geraadpleegd op 7 oktober 2026.
- Helpcentrum van DeepL, Translate PDF files, geraadpleegd op 7 oktober 2026.
- Methode: tekst geëxtraheerd op 7 oktober 2026 met MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. De afbeeldingen zijn uitgesneden delen van de pagina’s van de papers; de markeringen zijn van ons.