PDFを翻訳するとレイアウトが崩れる理由と確認すべき4か所
 Equalang
この記事の要点
大半のPDFはWordと違い、段落や表の区切りを記録していません。2本の論文で崩れる箇所を確かめ、翻訳方法の比較と訳後に見るべきポイントをまとめました。
キーワード: PDF翻訳; ドキュメント翻訳; PDFのレイアウト; 書式の保持; 論文翻訳
Wordのファイルには、どの単語が段落を構成し、どの単語が表に属しているかの記録があります。しかし、ほとんどのPDFにはそれがありません。PDFが持っているのは文字と、その文字を描画する座標だけです。段落も表も文も、読む人の目が補っているものです。一部のPDFには段落や表を示すアクセシビリティタグ(スクリーンリーダー向けに追加されるもの)が付いていますが、付いていないものも多くあります(後で例に使う2本の論文にはありません)。そのため、翻訳ツールはこのタグを当てにできません。二段組のレイアウト、複数列にまたがる見出し、次のページへ続く文といった「構造」に見えるものはすべて、翻訳の前に組み直す必要があります。そのうえで、長さが変わった訳文を元のレイアウトに収め直さなければなりません。書式が崩れるのは、この2つの工程のどこかです。
どうすればよいかは、手元にあるファイルによって違います:
- 元の .docx や .pptx がある場合:PDFではなく、そのファイルを翻訳してください。
- 表の少ない文字中心のPDFで、10 MB 未満のもの:Google 翻訳の無料のドキュメントアップロードが、まず試すには一番手軽です。
- 表・数式・二段組を含む論文、マニュアル、レポート:レイアウトを再構築するタイプの翻訳ツールを使い、セクション3の4か所を確認してください。
- スキャンデータ(文字を選択できないもの):翻訳の前に文字認識(OCR)が必要です。DeepL はスキャンデータを受け付け、この工程も自前で処理します。Google 翻訳ではスキャンされたページは翻訳されないまま残ります。
1. 翻訳ツールはPDFの中に何を見ているのか
私たちはドキュメント翻訳のツールを作っているので、PDFから取り出される文字を日々見ています。その違いをはっきり示すため、arXiv の AI 言語モデルに関する論文2本(LLaMA と Mistral 7B)を用意し、一般的なオープンソースPDFツールである MuPDF の mutool でテキストを抽出しました。版面(レイアウト)も読み取らないツールが翻訳の材料にするのは、おおよそこのようなテキストです。以下では各箇所について、ページ上の見え方、そして抽出された結果の順に示します(… だけの行は、途中の行を省略した箇所です)。
1.1 表は数字の列に変わる
LLaMA 論文の表3は、10個のモデルを8つのテストで比較しています。
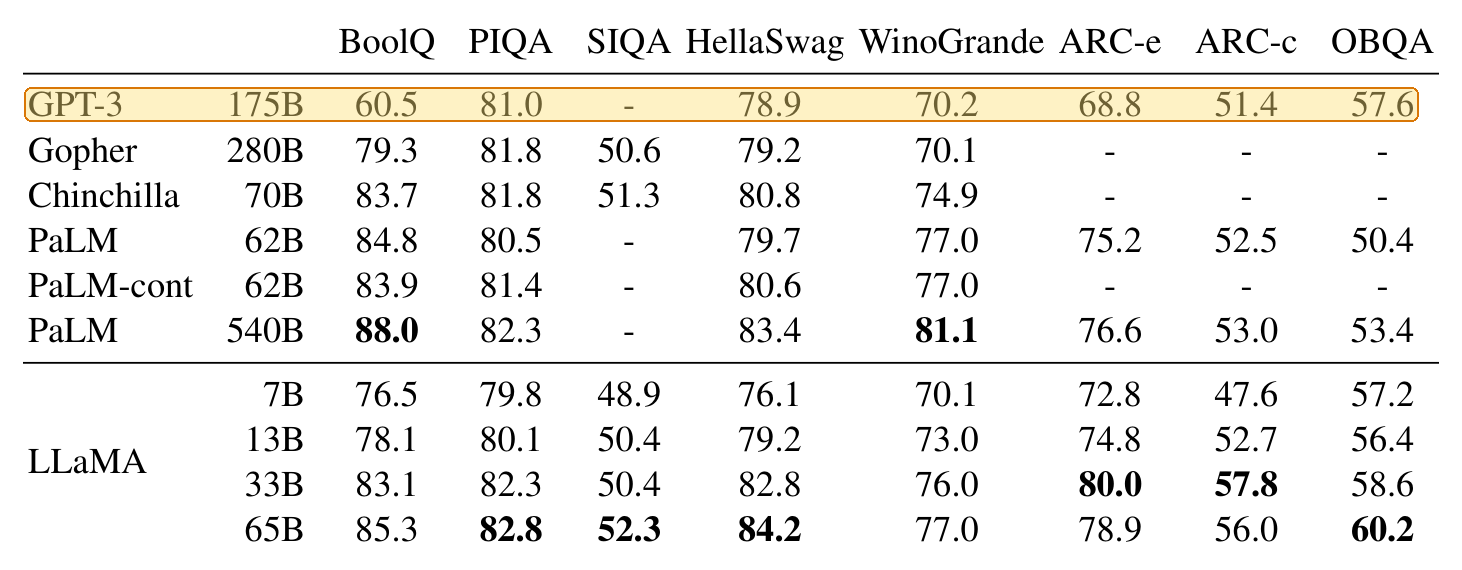
抽出すると102行になります。5行のヘッダーのあと、1行に1つの値です。以下は最初の16行で、GPT-3 から 57.6 までの10行が、強調した行にあたります。
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
どの数字がどのテストに対応するのか、ツールに伝える手がかりはどこにもありません。これを翻訳ボックスに貼り付けても、戻ってくるのは同じ数字の列です。単語は翻訳されますが、表は消えてしまいます。
1.2 1つの文の中に、表がまるごと入り込む
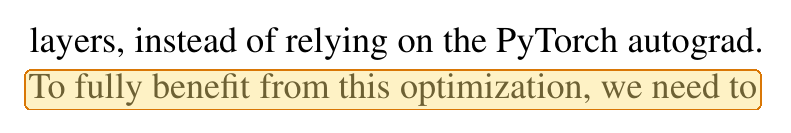
LLaMA 論文3ページの最後の文は "we need to" で途切れています。
続きは4ページ左欄、表3のすぐ下にあります。
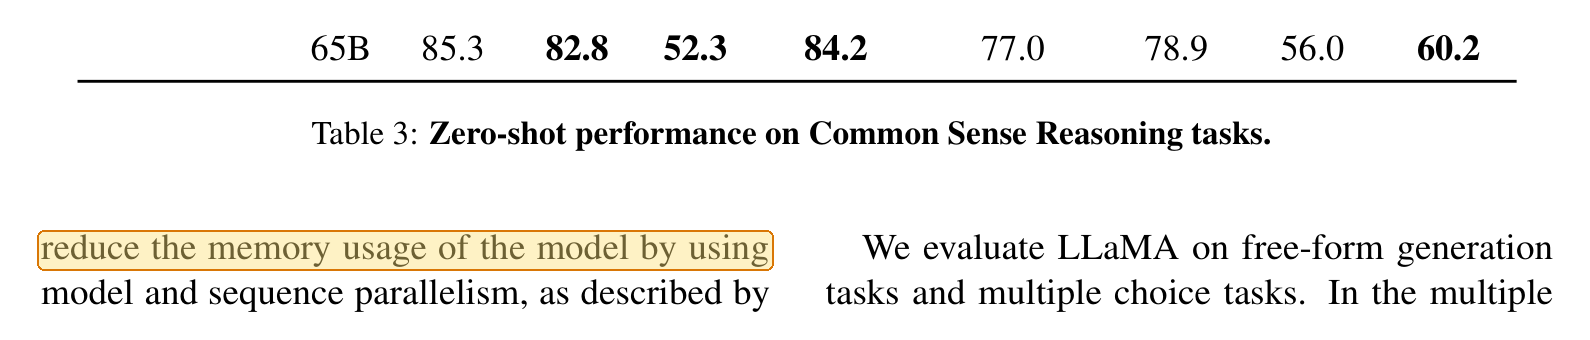
抽出されたテキストでは、脚注、改ページ、表3の102行すべて、そしてその表題が、この1つの文の内側に入り込んでいます。
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
同じことが2ページ後にも起きています。5ページは "…the textual description and tests in a" で終わり、"docstring." は6ページの表7の下に現れます。その間には表7の44行と7行の表題が挟まっています。
ページごとに翻訳するツールや、抽出された順序どおりに翻訳するツールには、この2つの断片をつなぐ理由がありません。翻訳後のファイルでは、ページの下部で途中で切れた文と、表の下のどこかに現れるそのもう半分が、別々に置かれることになります。
1.3 添字と分数は別のものに変わる
Mistral 論文では、変数 h が添字 i 付きで書かれています。
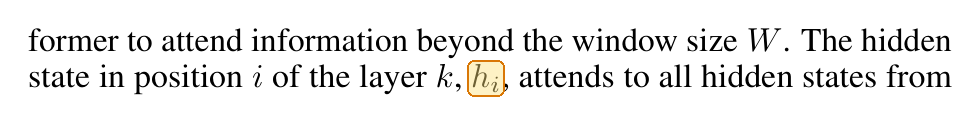
抽出すると添字は消え、hi だけが残ります。
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
翻訳ツールがこれを変数として扱う理由はありません。ツールにとって hi は、ありふれた英語の単語にすぎません。
分数はもっと厄介です。LLaMA のある箇所では、4d の3分の2という値が ⅔·4d と書かれています。⅔ は2を3の上に小さく重ねた形です。
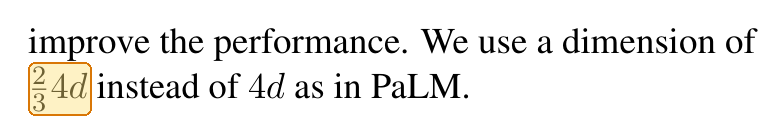
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
4d の3分の2が 34d になってしまいました。上付き文字、分数、数式フォントの記号は、特定の位置に置かれた図形にすぎません。抽出されたテキストには形が残っても、位置の情報は失われます。
1.4 単語が行末で分断される
二段組の論文では、行末で単語が分割されることが多くあります。LLaMA では、ハイフンで分割された小文字の一般単語が242行にのぼります。ハイフンを外してつなぎ直すだけなら簡単に見えますが、固有名に含まれるハイフンに行き当たると話は別です。
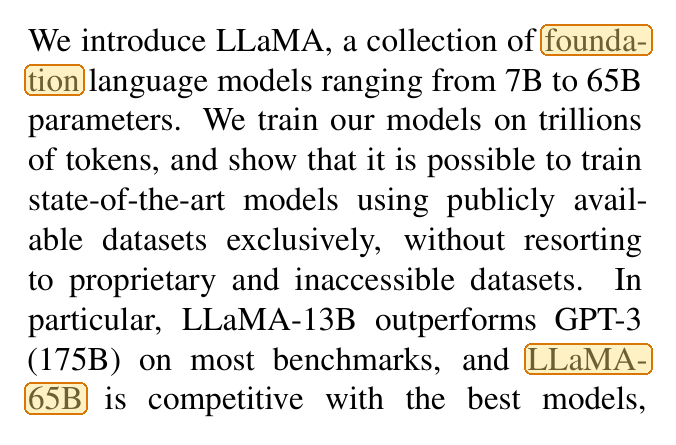
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- と tion は、ハイフンを外して1つの単語になります。しかし LLaMA- と 65B の間のハイフンはモデル名の一部なので、残さなければなりません。
ここで試したのは、LaTeX(学術出版で一般的な組版ツール)で作成された論文2本に対する1種類の抽出ツールだけです。Word から書き出したPDFやスキャン文書、ほかの抽出ツールでは結果が変わる可能性がありますが、探すべきなのはこの4種類の破損です。
2. どのような選択肢があるか
Google 翻訳と DeepL についての記述は、それぞれのヘルプページに基づきます(2026年10月7日確認)。PDFの翻訳結果に満足できないとき、DeepL は元の文書をアップロードするよう案内しています。これは私たちの考えと同じです。
最後の行は、私たちが作っている Equalang のドキュメント翻訳がまさに目指している方法であり、私たちが最もよく知っているアプローチでもあります。Equalang は翻訳の前に、ページの切れ目で2つに割れた文をつなぎ直します。結合セルや複数行のヘッダーを持つ表は、1列につぶすのではなく元の構造のまま再構築します。数式を文字化けとして捨てることはなく、文中にあって扱いが難しいものには数式最適化のオプションを用意しています。
一方で、元ファイルをそっくりそのまま再現することはしません。原文より訳文が長くなれば改行位置やフォントサイズが変わるため、もともと詰まったレイアウトのページは、やはり目を通す価値があります。ドキュメント翻訳が現在対応している言語は、日本語、英語、中国語、韓国語、スペイン語、フランス語などです。
3. PDFを翻訳したら、どこを確認すべきか
- 表。 ヘッダーは対応する列の上にあるままか。数字は変わっていないか。
- 改ページと各表の下のテキスト。 各ページの最終行と、各表の直後にある文を読みましょう。途中で終わり、その先が見つからない文は、テキストが分割されたまま翻訳されたときにもっともよく現れる兆候です。
- 数式と変数。 文中に置かれているものをいくつか確認しましょう。単語に変わってしまった文字や、別の数字になった分数がないかを見ます。
- ページ数とリンク。 ページ数が大きく違うなら、テキストが落ちたか、余分なページにあふれ出た可能性があります。目次の項目を1つか2つクリックして、きちんと機能するか確かめましょう。
参考資料
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Google 翻訳 ヘルプ, Translate documents & websites, 2026年10月7日確認.
- DeepL ヘルプセンター, Translate PDF files, 2026年10月7日確認.
- 実測方法: テキストは2026年10月7日に MuPDF 1.25.6 で抽出(コマンド
mutool draw -q -F txt -o out.txt in.pdf)。図は論文ページの切り抜きで、強調は筆者が入れたものです。