arXiv論文の数式が機械翻訳で崩れる?英語学術論文を快適に読むおすすめ翻訳ツール
 Equalang
この記事の要点
2段組み学術論文のLaTeX数式や改ページ長文が翻訳で崩れていませんか?文献翻訳の技術的課題を整理し、2段組みレイアウト保持と並列対照による効率的な精読フローを解説します。
キーワード: arXiv 論文 翻訳; 学術論文翻訳ツール; PDF 2段組みレイアウト保持; LaTeX 数式 翻訳; 見開き対照読書
毎週のようにarXivの新着プレプリントを追跡したり、トップカンファレンス(国際会議)の採択論文リストを読み込んだりする際、多くの大学院生や研究者が「見えない壁」に突き当たります。2段組みの学術PDFからテキストを少しずつコピーして一般的な翻訳ウィンドウに貼り付けると、LaTeXで書かれた数学公式、上付き・下付き文字、総和記号などが意味不明な文字列へと崩れてしまいます。さらに段組みの境目や改ページ位置にあるハイフネーション(Hyphenation)によって単語が分断され、機械翻訳の出力は文脈を失って不自然になります。ようやく1ページを訳し終えても、原文の図表番号や数式展開の論理がバラバラになり、画面を行き来して該当箇所を探すだけで精根を使い果たしてしまうことも少なくありません。
最新論文を読み解く上での最大の障壁は、必ずしも語彙力や英語力そのものではありません。**「数式が文字化け・崩落する」「2段組みレイアウトが崩壊する」「原文と訳文の位置関係が把握できない」**という問題が、研究者の思考や数式展開の集中(フロー)を寸断してしまうことにあります。
本記事では、学術文献翻訳ツールの選定基準を整理し、オープンソースツールや主要な翻訳ツールの得意・不得意(技術的境界)を比較した上で、数式を崩さず2段組みレイアウトを保ったまま快適に文献を精読できる実践的なワークフローをご紹介します。
1. なぜ学術論文は機械翻訳にとって「最大の難所」なのか?
一般的な翻訳ツール(ブラウザのポップアップ翻訳拡張機能やテキスト入力型の翻訳サービスなど)は、平易な日常文や一般的なWeb記事の翻訳には優れています。しかし、学術PDFに対しては期待通りに機能しないケースが多々あります。これには、学術文献ならではの3つの技術的課題が存在するためです。
- LaTeX数式と特殊記号の混在:論文の本文には、行内変数(例:$\theta_i, \mathbf{W}_Q$)、上下付き文字、複雑な分数、独立したテンソル方程式などが無数に散りばめられています。一般的な機械翻訳モデルは組版構文木(Syntax Tree)を認識できないため、数式変数を通常の英単語と誤認して不自然に翻訳してしまったり、分母の平方根 $\sqrt{d_k}$ をバラバラの無意味な文字に分解してしまったりして、数式展開の理解が不可能になります。
- 2段組みレイアウトと物理的なページ区切り:PDFは本来、印刷を前提とした静的な描画命令で構成されており、文書構造としての自然な段落の論理フローを保持していません。そのため、一般的なツールでは2段組みの左右の段を混同して一行につなげて読み取ってしまう「段またぎの誤読」が頻発します。さらに、ページ末尾で改ページによって途切れた長文が強制的に二分割され、著しい誤訳を引き起こします。
- 図表番号や相互参照(Cross-reference)の欠落:モデルのアーキテクチャ図(Figure)、アブレーション実験の表(Table)、本文中の特定の数式参照(例:Equation 3)などは、単純なテキスト抽出処理を行うと位置がずれたり消失したりしやすく、論文全体の論理的な連関を壊してしまいます。
したがって、学術文献に真に対応できる翻訳ツールには、**「PDFレイアウトの構造解析」+「LaTeX数式のインプレース保護(原位置での保持)」+「原文・訳文の並列対照」**という3つのコア機能が不可欠となります。
2. 主要な学術文献翻訳アプローチの比較
日々の研究現場で利用される文献翻訳のアプローチは、大きく分けて以下の3つに分類されます。それぞれに明確な得意分野と限界があります。
数式の正確さ、レイアウトの美しさ、そして複雑なセットアップ不要で即座に使える手軽さを両立させたい用途に向けて、ここでは私たちが開発している Equalang を用いた具体的な処理フローをご紹介します。
3. 「左に原文・右に訳文」2段組み文献の精読ワークフロー(3ステップ)
文献読解をスムーズにするには、原稿と生成された訳文を左右に並べて対照することで、没入型の精読を実現できます。
ステップ1:全文解析と数式最適化の適用
Equalang Web版のドキュメント翻訳ページで、arXivからダウンロードしたオリジナルのPDFファイルをアップロードします。数学公式が多用される情報工学・物理・理工系の論文に対しては、解析段階で行内(インライン)の数式記号および独立した数式ブロックが集中的に保護されます。
また、ページ下部で物理的に分割されてしまった改ページ長文についても、段落の論理構造レイヤーで文を自動結合した上で前後の文脈を保った翻訳を行うため、ページ間での文章の分断を防ぐことができます。
ステップ2:複雑な数式と記号構造の再現性を確認
翻訳が完了すると、生成された訳文ファイルは元論文の2段組みの幅、見出しの階層構造、図表の配置、キャプションの位置をそのまま保持します。
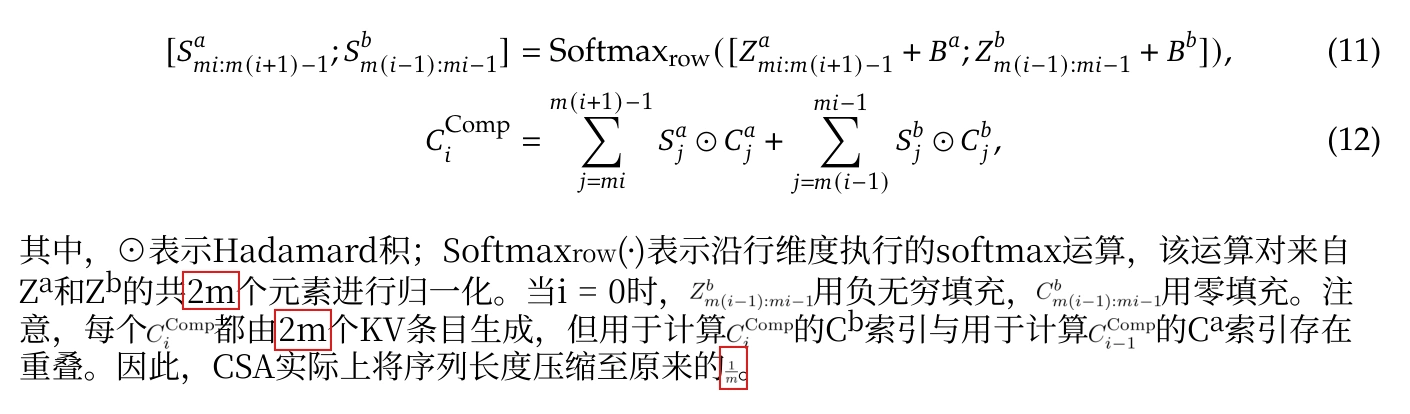
DeepSeek-V4論文など、厳密な数式展開を伴う文献を処理する際、上図は数式と訳文のレイアウト効果を例示したものです:
- 行内記号が文字として翻訳されない:2mやZ^aなどの行内記号は文字として翻訳されていませんが、一部の行内数式でフォントサイズが明らかに小さくなっています。
- 独立数式と式番号のアライメント:CSA数式 (11)(12) は中央揃えのまま配置され、右端の式番号(数式インデックス)も正確に保持されるため、議論の展開と導出ロジックが途切れません。
ステップ3:原文と訳文を2つのウィンドウで左右に並べて対照
英語の原文とダウンロードした中国語訳を、macOS「プレビュー」、Adobe Acrobat、PDF Expert、またはEdgeブラウザでそれぞれ開き、2つのウィンドウを左右に並べます:
- 画面左側のウィンドウで英語の原文を開きます。
- 画面右側のウィンドウで対応する中国語訳を開き、同じページ番号に合わせます。
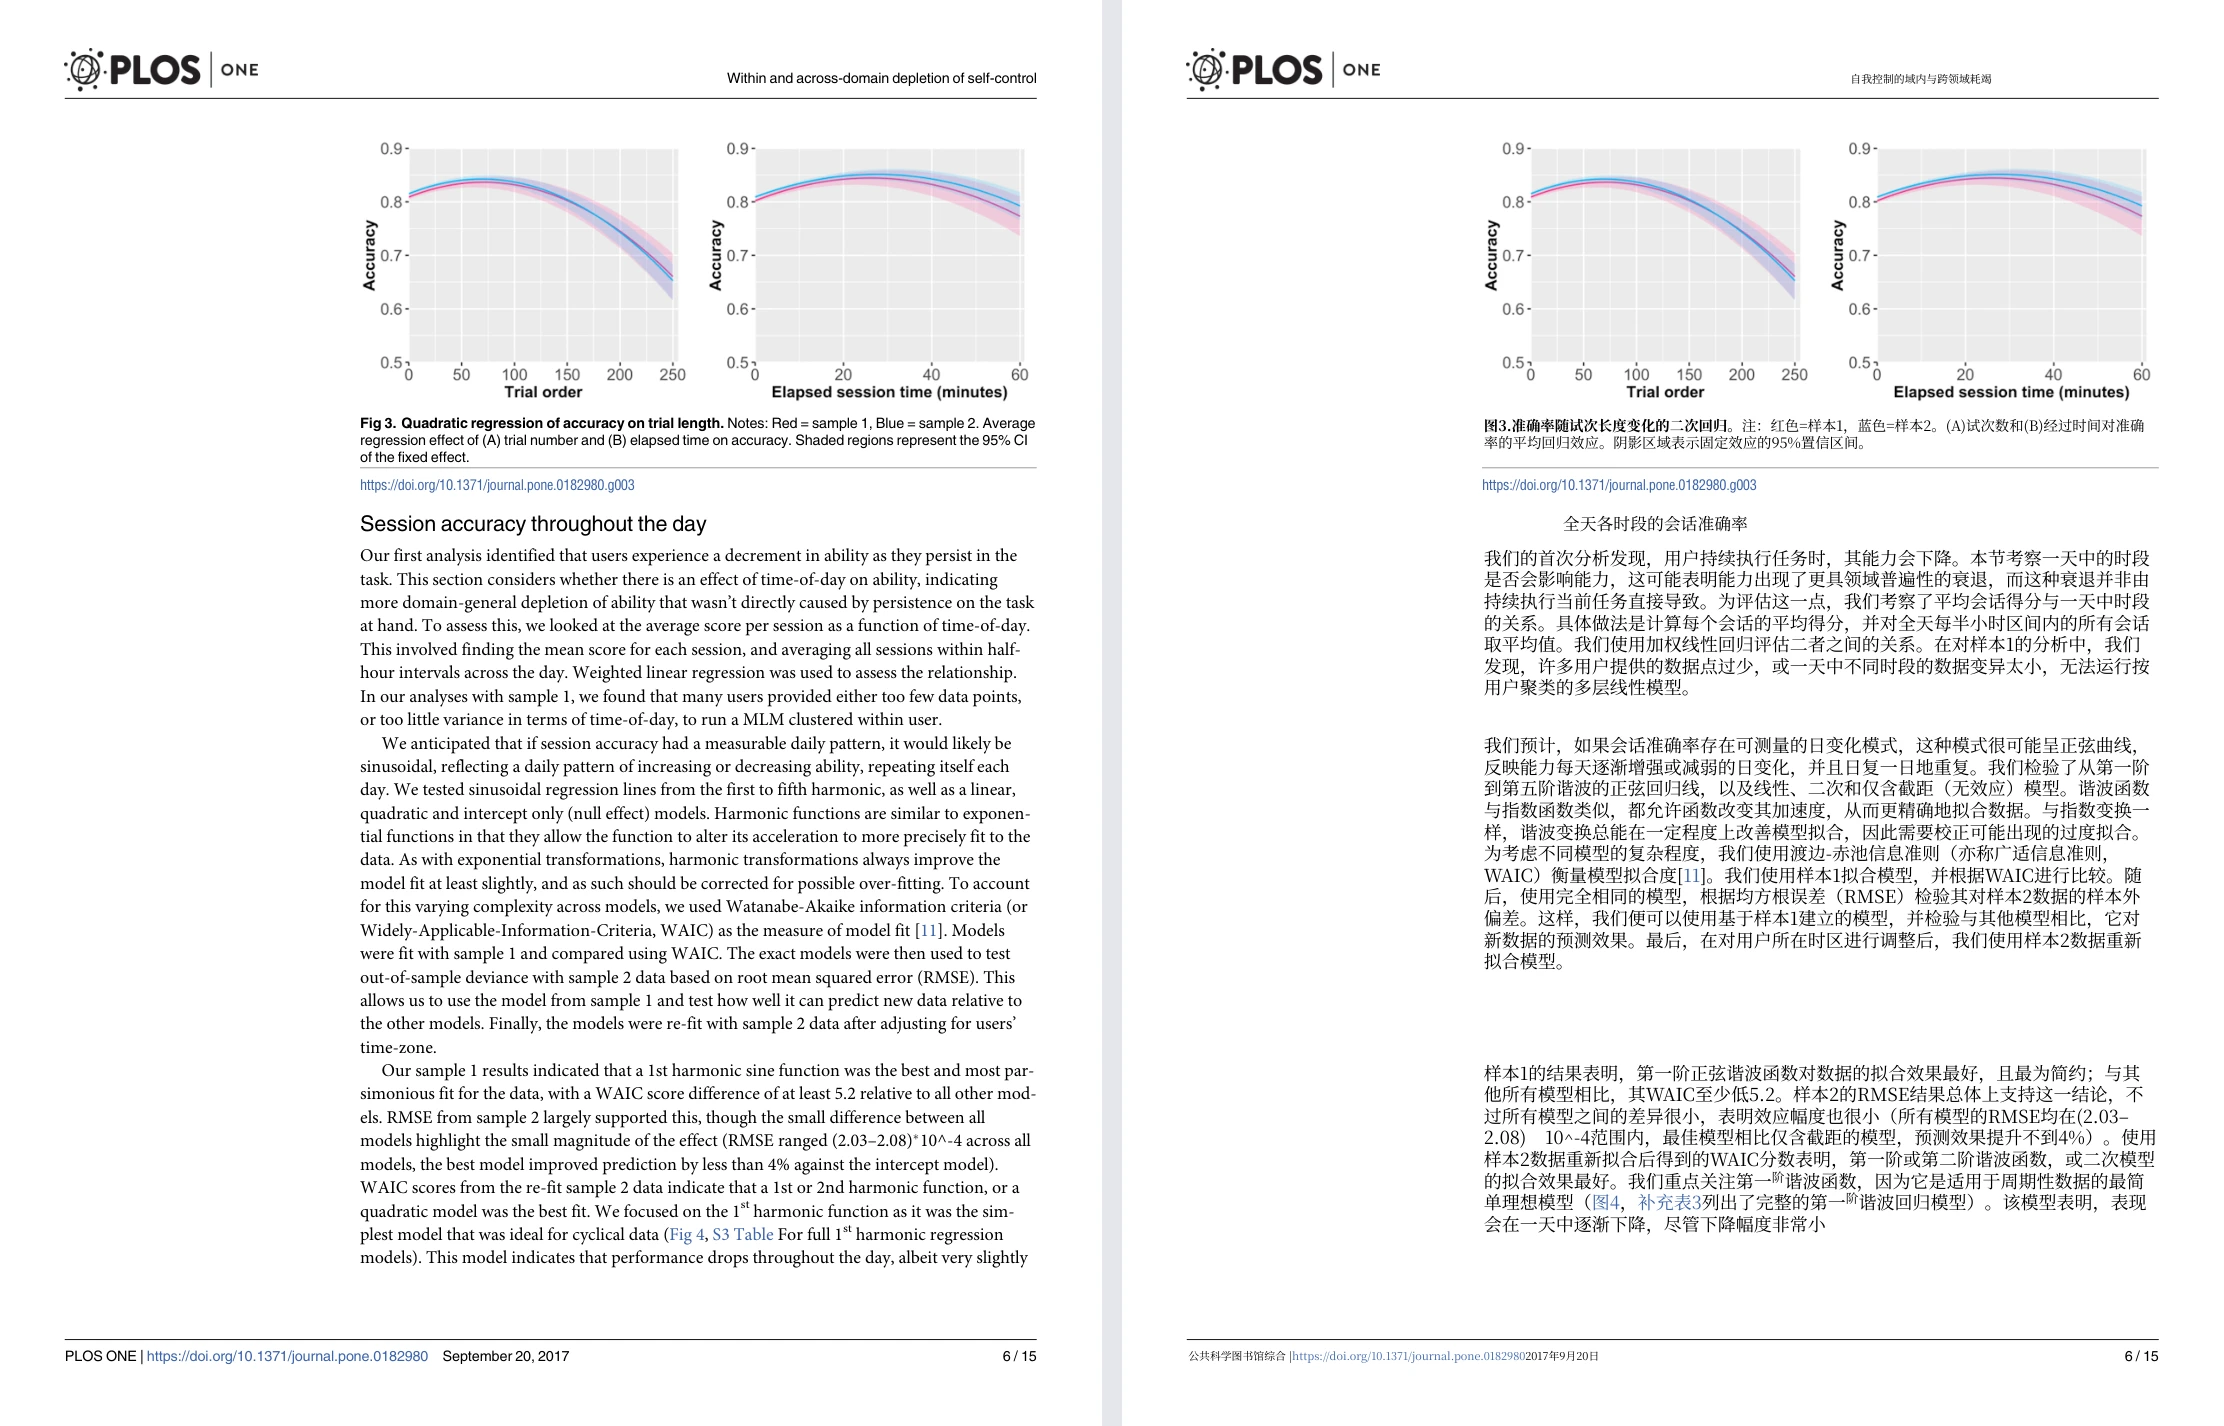
調整が完了すると、画面の左側が第 $N$ ページの英語原稿、右側が対応する第 $N$ ページの中国語訳となります。
この見開き対照ビューを構築することで、以下のような快適な文献精読が実現します。
- 概要や論述の流れを追う際は右側の対応する第 $N$ ページの中国語訳をスムーズに読み進め、研究動機、コアとなる論点、実験設計を素早く把握できます。
- 重要な数式、特殊な専門用語の略称、または難解なコードに遭遇した際は、視線を自然に左側の英語原版へ移し、最も元となる数学的定義を照合できます。
4. 学術文献をバイリンガルで精読する際のチェックリスト(注意点)
日常的に翻訳ツールを活用して学術文献を精読する際は、以下の実践的なポイントを心がけることをおすすめします。
- 重要な結論や定義は原文に立ち返って確認する:機械翻訳は非英語ネイティブの読解負荷を大幅に低減しますが、論文の引用(Citation)、定理の厳密な証明、コードの再現実装を行う段階では、必ず英語原稿の正確な定義を照合してください。
- スキャン版とベクター版(デジタル版)PDFの違いに留意する:古い年代のスキャン文献など、高精度なOCR処理が施されていないファイルではレイアウトの復元精度に影響が出る場合があります。可能な限り、arXivやIEEE、ACMなどの公式サイトから提供されている高品質なベクター版PDFを使用するのが得策です。
- 擬似コードの関数名・変数名は英語のまま把握する:アルゴリズムの処理ステップに登場する関数名、変数名、ライブラリ固有のプリミティブ(PyTorchやTensorFlowのAPI名など)は、無理に翻訳せず英語のまま把握することで、実装時の誤解を防ぐことができます。
参考資料 / Sources
- Equalang ドキュメント翻訳 公式サイト
- arXiv.org オープンアクセス・プレプリントリポジトリ
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- PDFMathTranslate オープンソース学術論文翻訳プロジェクト