翻訳とは記号の置き換えではなく理解すること:
 Equalang
この記事の要点
辞書引きや単語の集計から、単語ベクトル、Transformer、大規模言語モデルまで。機械翻訳が70年かけて歩んだ4つの段階をひもとき、AIが人間の言葉を理解していく過程をわかりやすく解説します。
キーワード: 機械翻訳; Transformer; 大規模言語モデル; ニューラルネットワーク; アテンション機構; 同時通訳
1秒で起きる語順の大移動、その裏にある70年以上の挑戦
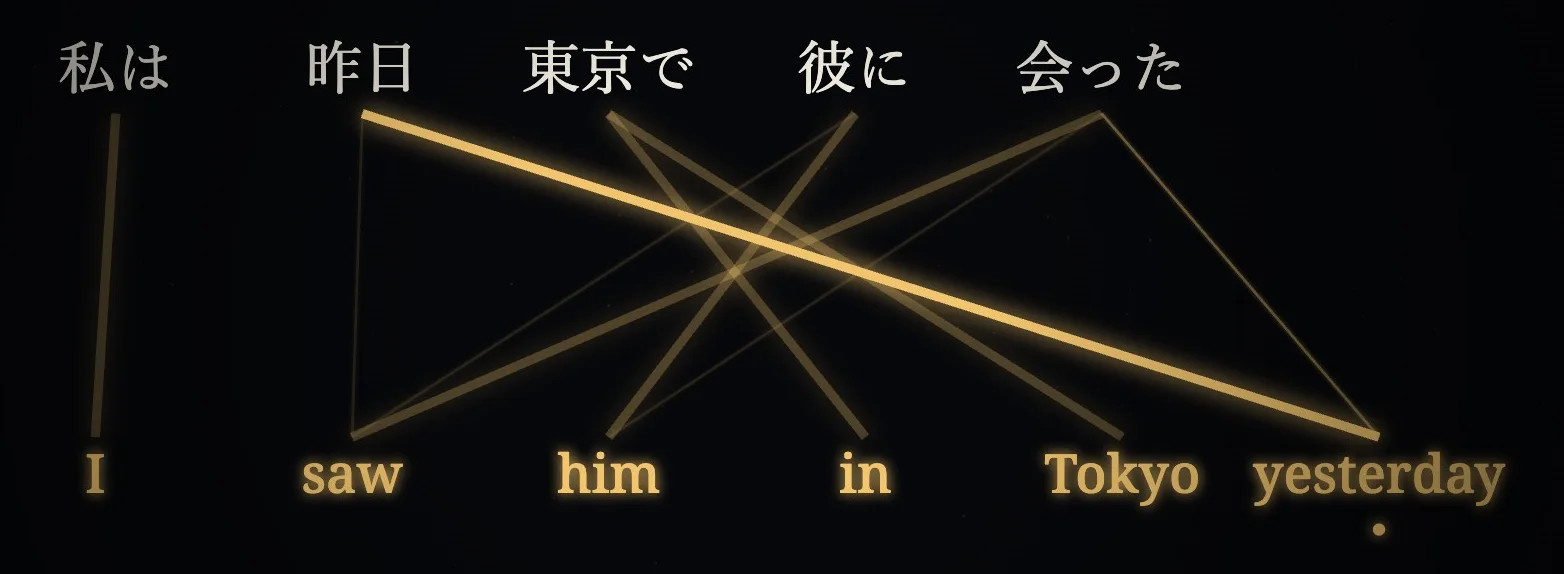
翻訳アプリの入力欄に、日本語を一文打ち込んでみます。「私は昨日東京で彼に会った。」
1秒もたたないうちに、画面には英語の訳文が現れます。「I saw him in Tokyo yesterday.」
この二つの文をじっくり見比べてみると、普段は気にも留めないけれど、実はとても複雑なことが起きていると気づきます。機械はただ日本語の単語を一つずつ英単語に置き換えているわけではありません。原文の前半にあった「昨日」(yesterday)や「東京で」(in Tokyo)は、英語ではすっかり文末へ移動しています。逆に、文末にあった動作「彼に会った」(saw him)は前へと繰り上がっています。もし二つの文の対応する単語を線で結んだなら、線は空中で交差して網の目のようになるはずです。
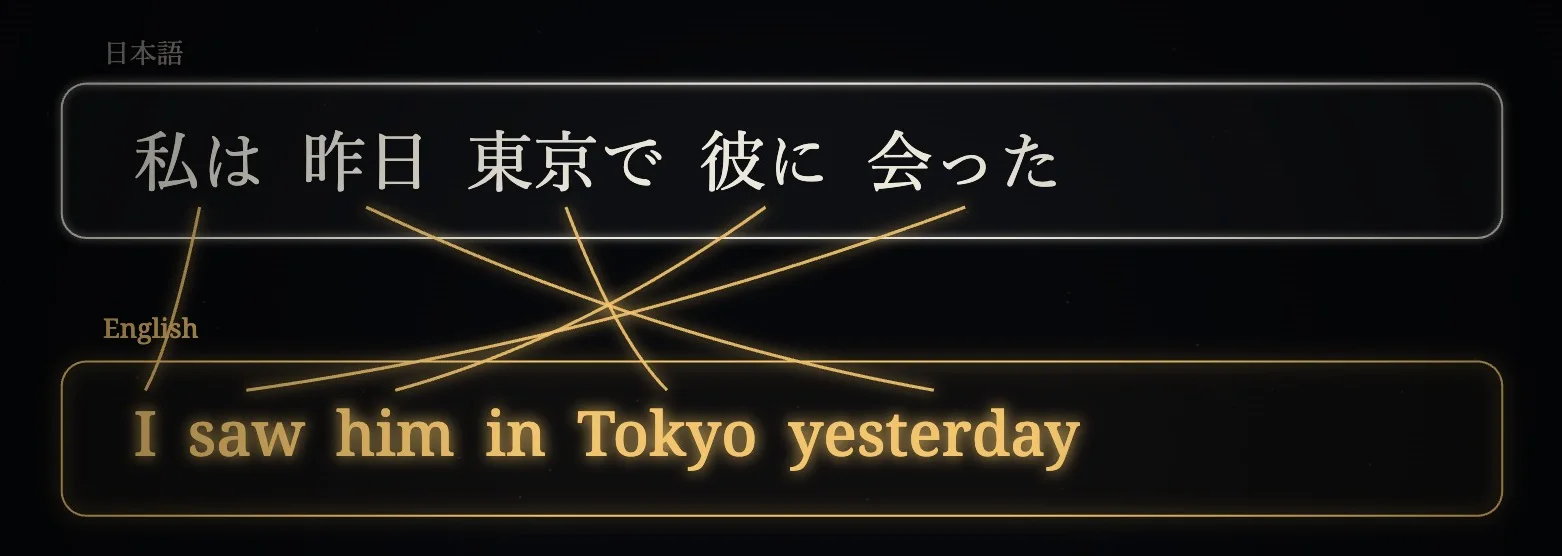
キーを叩いてからわずか1秒の裏には、人類が70年以上も挑み続けてきた難問があります。数字しか扱えない機械に、どうやってある言語を別の言語へと変換させるのか、という問題です。
この70年あまりの歩みを振り返ると、機械翻訳の歴史は単に辞書を大きくしていく作業ではなく、言葉を一段ずつ深く理解していく階段そのものでした。最初は機械的に記号を置き換えるだけだったものが、やがて語義(単語の意味)をつかみ、文全体を読み解き、ついには段落全体の文脈を理解するまでになったのです。
この記事には約9分のアニメーション動画版もあります:https://www.youtube.com/watch?v=5vyNt4tD5DM
第一歩:外国語を「暗号」として解読する手法は、なぜ壁にぶつかったのか?
物語の始まりは1947年です。その年の3月4日、アメリカの数学者ウォーレン・ウィーバー(Warren Weaver)は友人のウィーナーに宛てて手紙を書きました。その中で彼はある直感を語っています。ロシア語の文章を見るといつも、「これは本当は英語で書かれていて、何か奇妙な記号で暗号化されているだけなのだ」と思えてならない、というのです。
ウィーバーにとって、翻訳の本質は一種の暗号解読でした。二つの言語の間にある記号の対応ルールさえ見つけ出し、暗号を解き明かせば、その下から元の英語が自然と現れるはずだと考えたのです。1949年7月、彼はこの発想を覚書にまとめて研究仲間に配りました。タイトルはたった一語、『Translation』(翻訳)でした。
このアイデアは、やがて本物のコンピュータ上で試されることになります。1954年1月7日、IBMとジョージタウン大学が共同で、人類史上初となる機械翻訳の公開実演を行いました。ロシア語をまったく知らない担当者が機械の前に座り、60あまりのロシア語の文をパンチカードで打ち込むと、コンピュータはカタカタと音を立てながら、それらをすべて自動で英語に翻訳してみせたのです。
当時の機械は、どのようにして翻訳していたのでしょうか。その仕組みは、説明書付きの辞書を引く作業によく似ていました。
- 番号を調べる:まず読み込んだロシア語の単語を一つずつパンチカードの辞書と照らし合わせ、対応する数字の番号と、候補となる英語の訳語を引き出します。
- 規則を見る:次にその前後の単語を見て、人間があらかじめ書き込んでおいた文法規則に従い、三つの処理を行います。複数の英語候補から適切なものを選ぶ(語選択)、逆になっている語順を入れ替える(語順調整)、そして英語では不要な余分な語を**削る(語削除)**という作業です。
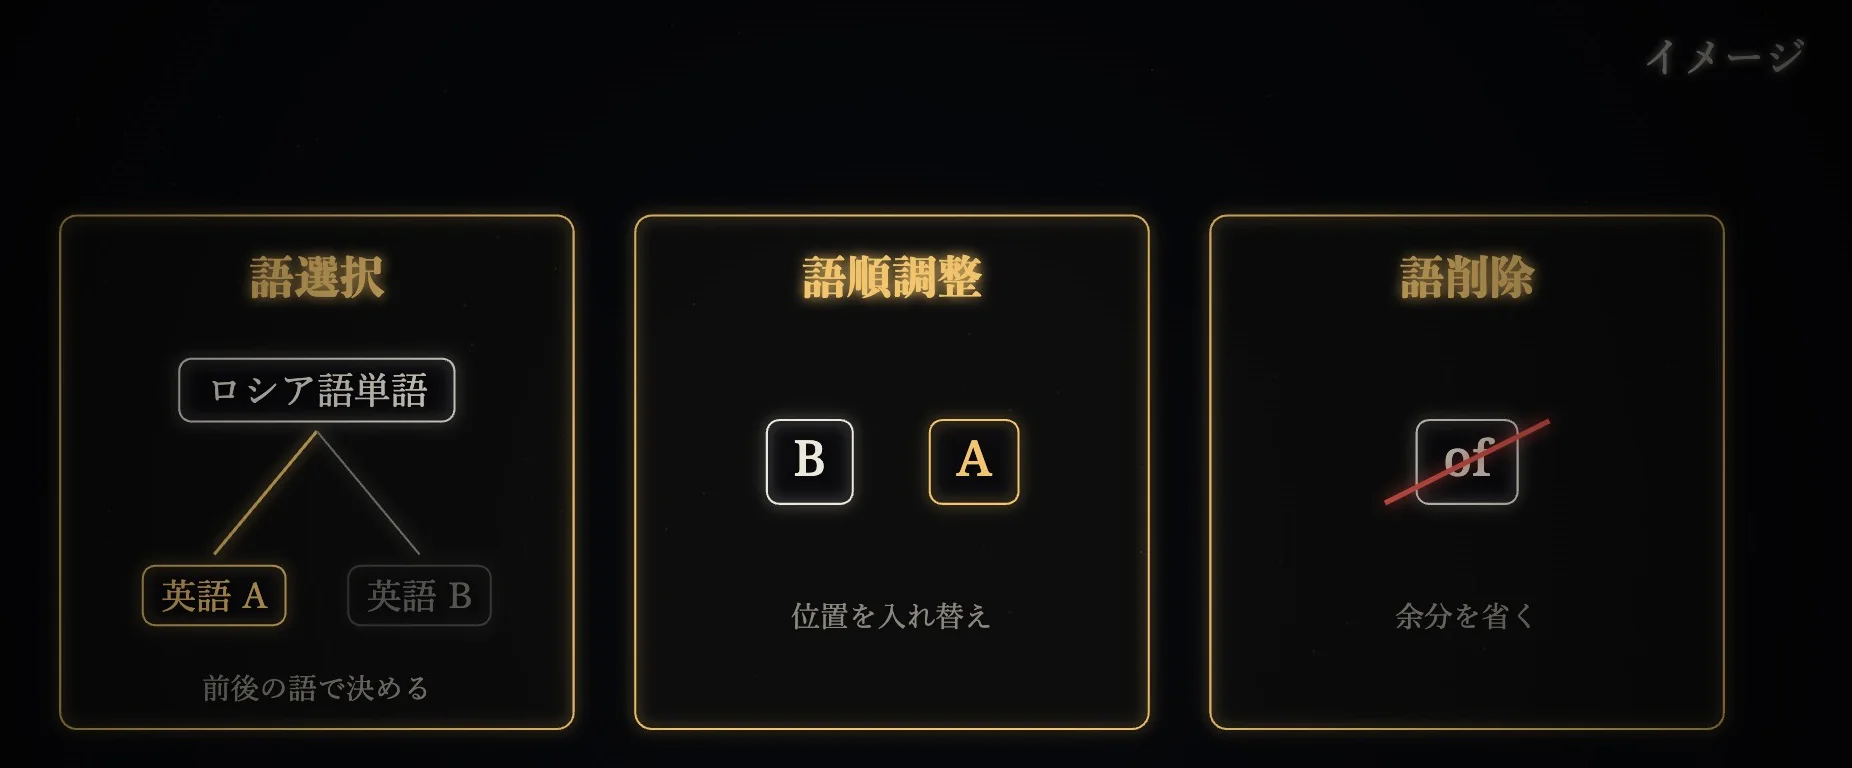
この実演は大きな反響を呼びました。当時の研究者たちは非常に楽観的で、このまま研究を進めれば、3年から5年のうちに機械翻訳の問題は完全に解決できると考えていました。
しかし、会場の観客が知らなかったことがあります。その機械に入っていた辞書は驚くほど小さく、見出し語はわずか250語(語幹と語尾を含む)、文法規則もたった6つしかありませんでした。それどころか、実演に使われた60あまりのロシア語の例文さえ、事前に厳選されたものだったのです。
ひとたび研究室を出て現実世界の文章に向き合うと、3年が過ぎ、5年が過ぎ、10年が過ぎても、期待されていた突破口は一向に見えてきませんでした。1966年、アメリカ政府が設けた自動言語処理諮問委員会(ALPAC)が一本の調査報告書を提出します。その結論は冷ややかなものでした。「10年間の研究は、当初の期待に応えられなかった」。これを機に研究予算は大幅に削られ、機械翻訳は長い冬の時代を迎えることになります。
予算が激減するなかでも、粘り強く研究を続ける人たちがいました。彼らは1954年の手法をさらに細かく発展させていきます。辞書に単語を一つずつ追加し、文法規則を一行ずつ書き足し、すべて人間が手作業で機械に教え込んでいく――こうして生まれたのがルールベース機械翻訳です。
この方式は、特定の分野では実際に役立ちました。たとえばカナダのMETEOシステムは、1981年から天気予報を英語とフランス語の間で翻訳し続けました。これがうまくいったのは、天気予報の言葉が限られた表現しか使わないからです。毎日繰り返される言い回しは決まったパターンばかりで、語彙も文型もその枠から外れることがありません。
ところが、日常会話となるとそうはいきません。普段の言葉はそれほど規則正しくなく、なかでも最大の悩みの種となったのが多義語です。
たとえば、一つの動詞に一つの訳語しか当てないよう辞書で機械的に決めてしまったらどうなるでしょうか。仮に「かける」(「吊るす・掛ける」の意味)という動詞を英語の hang に固定してしまうと、「私は眼鏡をかける」という文を単語ごとに直訳した途端、「I glasses hang.」というおかしな英語になってしまいます(イメージ)。実際の言葉では、同じ「かける」という一つの動詞でも、組み合わせる相手が変われば、英語の表現もまるごと変えなければなりません。
- 電話をかける:call
- 眼鏡をかける:wear glasses
- 鍵をかける:lock the door
- 水をかける:pour water
たった一つの言葉でもこれほどの使い分けがあり、正しく訳すには組み合わせごとに判定ルールを書かなければなりません。表現が一つ増えるたびに規則も一つ増え、規則も例外もきりがありません。人間が一つずつ文法を機械に教え込むやり方は、トランプで高い塔を積むようなものです。例外のカードが積み重なるにつれ、遅かれ早かれ塔全体が崩れ落ちてしまいます。
文法を教えるのをやめ、レシピの応用と「数え上げ」へ:統計翻訳はどう賢くなったのか?
規則を書き切れないのなら、発想を変えられないでしょうか。
1984年、日本の研究者である長尾真が提案したのが用例ベース機械翻訳です。機械に文法規則を丸暗記させるのではなく、手本となる例文をまねて翻訳させるという考え方です。
これは料理のレシピを応用するのに似ています。手元にすでにあるレシピ――たとえば「私は昨日東京で彼に会った」を「I saw him in Tokyo yesterday」と訳した例文があるとします。そこへ新しく「私は昨日大阪で彼女に会った」という文が来たら、機械は蓄えてある例文の中から一番似たものを探し出します。そして見比べてみると、「東京→大阪」「彼→彼女」の二か所だけが違うと分かります。あとは元の英訳をそのまま使い、材料を入れ替えるように対応する二か所の単語だけを取り替えれば、新しい訳文のできあがりです(イメージ)。
さらに1990年頃になると、IBMワトソン研究所の研究者たちはもっと大胆な道を選びました。文法も規則も教えるのを一切やめ、人間が翻訳した大量の対訳文を機械に読ませて、どの二つの単語が常にペアで現れるかを機械自身に数えさせたのです。
日本語と英語の対訳文が次々と機械の中に流し込まれる様子を想像してみてください。機械は日本語の文字も英単語の意味も知りませんが、計算はできます。日本語の文に「りんご」が現れ、対応する英語の文にも apple が現れるたび、機械はこの二つの単語を結ぶカウンターの数字を1ずつ増やしていきます。
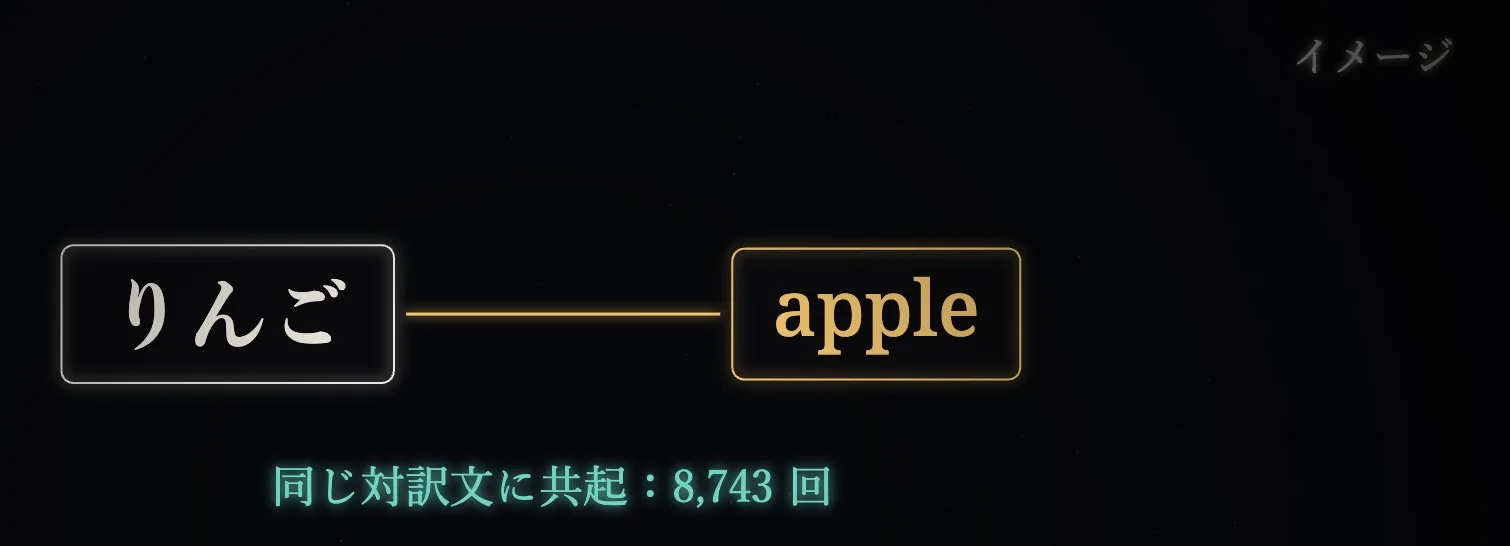
1組、10組、何万組もの対訳文を数えていくうちに、「りんご」と apple が一緒に現れる回数はどんどん積み上がり、機械がはじき出す確率も高まっていきます。こうして機械は、この二つの記号が同じ意味を表しているのだと確信を深めていきます。これは、知らない外国語の apple という単語でも、果物屋に行くたびに赤い果物の横にその札が添えてあれば、自然と意味がわかるのと同じです(イメージ)。
これが統計的機械翻訳です。この瞬間から、翻訳は「規則を引く作業」から「確率の計算」へと変わりました。
もっとも、単語のペアを数えるだけでは、完全な文を組み立てることはできません。たとえば日本語の「彼」は、英語にすると主格の he にも目的格の him にもなります。いったいどちらを選べばよいのでしょうか。「彼」という単語一語のペアの確率だけを見ても、機械には答えが出せません。
そこで研究者たちは、機械にもう一つの武器を持たせました。英語の文の中で、どの語の後にどの語が続きやすいかを数えさせたのです。たとえば直前までで「I saw _」と訳せていたなら、機械は自分が集計した英語の記録を調べ、saw の後には he よりも him が続く回数のほうが圧倒的に多く、スコアが高いことを見つけ出します(イメージ)。このように、直前の数語から次に来る言葉を予測する仕組みを言語モデルと呼びます。
この二つを組み合わせることで、統計的機械翻訳の流れが完成しました。
- 翻訳モデル(単語ペアを引く):原文を小さな塊に分け、それぞれ確率表を引いて、候補となる英単語をいくつか洗い出します(たとえば「彼」に対して he と him の二つの候補を出します)。
- 言語モデル(自然な並びを選ぶ):直前の数語とのつながりを見て、候補の中から一番自然な単語を選び出します(前が saw なので him を残して he を消し、最後に文としてつなぎ合わせます)(イメージ)。
2006年に登場したGoogle翻訳も、裏側ではこの統計的機械翻訳を使っていました。
しかし統計的機械翻訳も、初期のルールベース翻訳と同じく、まだ**「記号」**の段階にとどまっていました。機械の目には、どの単語もただの独立した番号にしか見えていなかったのです。たとえば「猫」は #4127 番、「犬」は #9853 番といった具合で(番号はイメージ)、二つの番号の間には何のつながりもありません。機械には「猫」と「犬」の意味が近いこともわからなければ、「猫」で学んだ翻訳の経験を「犬」へ応用することもまったくできません。訓練データにあまり出てこなかった言葉の組み合わせに出会うと、集計回数が足りないために途方に暮れてしまったのです。
ここからさらに一歩進むには、単語をただの無機質な番号として数えるのではなく、まず**語義(単語の意味)**をつかむ必要がありました。
単語ベクトルからアテンション機構へ:機械はどうやって「文全体」を読み解くようになったのか?
転機が訪れたのは2013年です。この年、word2vec の登場によって、以前から提唱されていた単語ベクトルという技術が一気に広まりました(単語ベクトルの発想自体は、2000年に Bengio らの研究者がすでに提案していました)。
単語ベクトルが成し遂げたのは、とても巧妙な工夫でした。各単語に独立した番号札を一つ渡すのではなく、それぞれの単語を「数百個の数字の並び」で表すようにしたのです。
この数百個の数字は、単語ごとに作られた詳しい「特徴の採点表」のようなものだと考えるとわかりやすいでしょう。1番目のマスは「動物かどうか」、2番目のマスは「食べられるかどうか」、3番目のマスは「都市かどうか」といった項目になっていて、それぞれに点数をつけていくような仕組みです(注:実際には各次元に人間が読んでわかる独立した意味があるわけではなく、AIが自らまとめた抽象的な特徴になっています)。
では、その数字はどうやって決めるのでしょうか。人間が書き込むのではなく、機械に大量の穴埋め問題を解かせるのです。たとえば「私は _ を飼っている」という文を出し、空欄の部分を隠して、そこにどんな言葉が入るかを機械に当てさせます(イメージ)。何万もの文を見ていくと、「猫」と「犬」はいつもよく似た空欄に現れます。機械が言葉を当てようとして数字を繰り返し調整するうちに、似た空欄によく入る「猫」と「犬」の数字の並びは、だんだん似通ってくるのです。
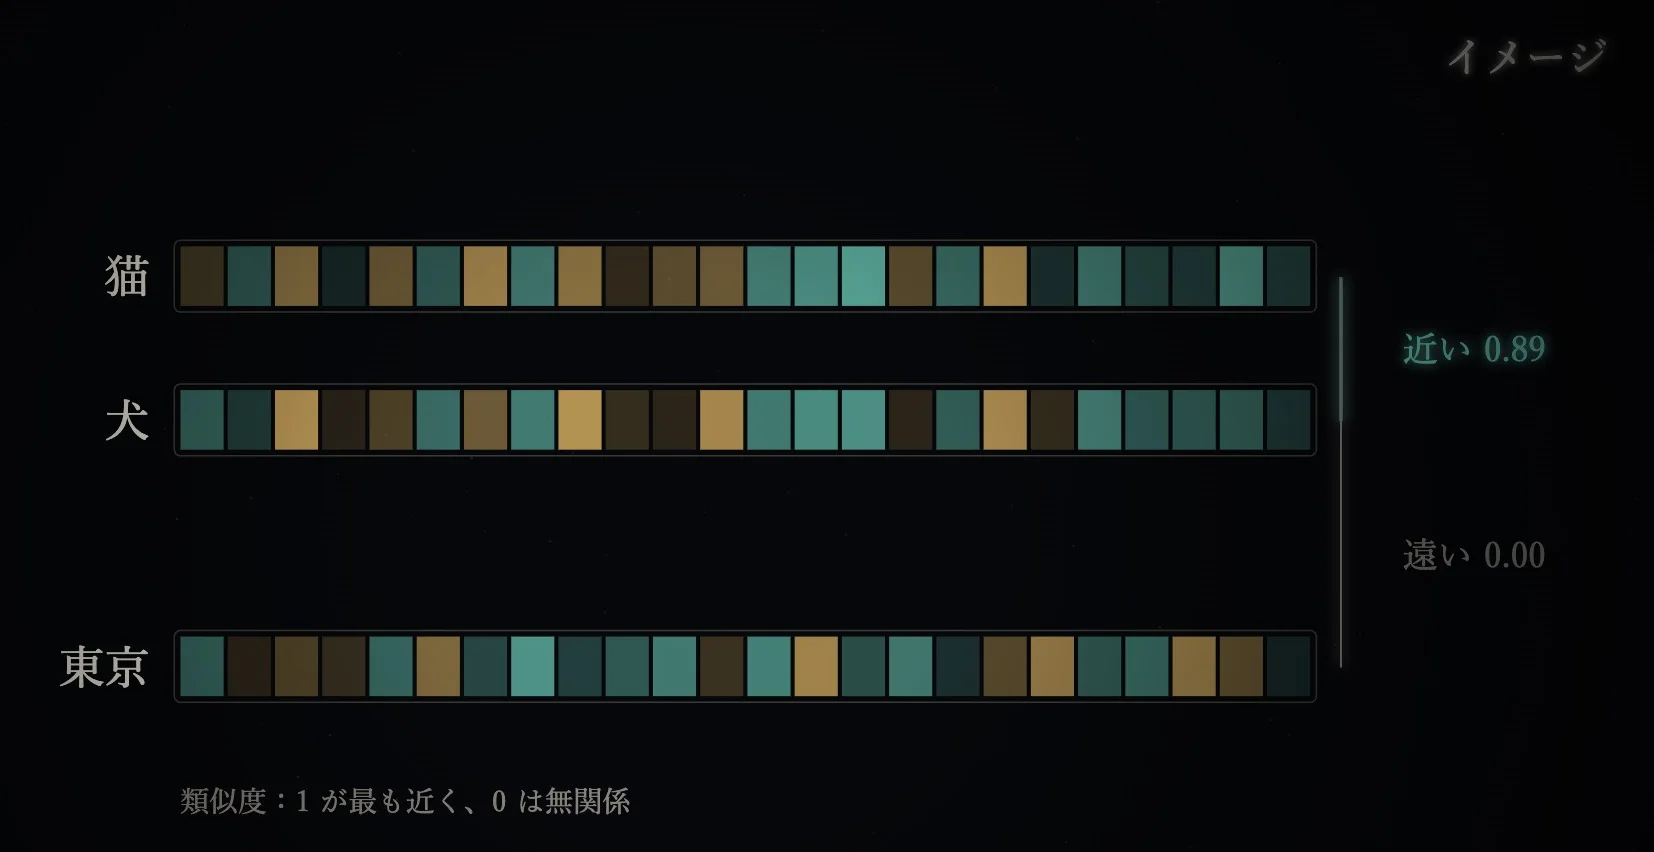
その結果、不思議なことが起きます。意味が近い言葉ほど数字の並びも似てきて、「猫」と「東京」のように無関係な言葉ほど数字もかけ離れていくのです。似た言葉は数字も近いため、機械は「猫」で学んだ法則をそのまま「犬」にも応用できるようになりました。さらに重要なのは、単語が連続した数値になったことで、ついにその数字を使って文全体の意味を計算できるようになったことです。
こうして2014年、人工ニューラルネットワークによる機械翻訳(略してニューラル機械翻訳)が登場しました。文を細かく切って表を引くのではなく、人間の通訳者と同じような手順で翻訳を行います。
- 最後まで読み取る(エンコーダ):まず日本語の文を最初から最後まで読み取り、文全体の意味をギュッと一つの数値の「記憶」に圧縮します。
- 一語ずつ語り出す(デコーダ):その記憶を受け取り、それを頼りに英語の訳文を一語ずつ語り出していきます。しかも一語出すたびにその語も記憶に重ね、次に何を言うべきかを考えながら続けていきます。
当時、この記憶を蓄えて訳文を紡ぎ出す役割を担っていたのが、再帰型ニューラルネットワーク(長短期記憶[LSTM]など)と呼ばれる構造でした。このネットワークは、文を読むとき、一語ずつ順番に読み込んでは前のステップまでの記憶に重ね合わせ、新しい記憶に更新して次のステップへと渡していきます。
しかし、このやり方はすぐに壁にぶつかりました。記憶の枠には限りがあるという問題です。5、6語の短い文でも、数十語におよぶ長い文でも、同じ固定サイズの記憶の枠に無理やり詰め込まなければなりません。長い電話番号を一度に覚えようとするようなもので、文が長くなると、後半を覚える頃には前半の内容がどんどん薄れて忘れられてしまうのです。
長い文で前半を忘れてしまう問題をどう解決するか。同じ年に研究者たちが提案したのがアテンション機構(Attention、注意機構)です。
アテンション機構の発想は、試験で長文読解問題を解くときのやり方によく似ています。機械は英単語を一語書くたびに、固定サイズの記憶の枠だけに頼るのではなく、原文の対応する箇所を直接振り返って見ることができるようになりました。今書いている語に最も関連の深い原文の位置へと、その都度スポットライトを当てるのです。たとえば「I saw him in Tokyo yesterday」と書き出していく過程で、saw を書くときには日本語の「会った」に注目し、yesterday を書くときには原文の前半にある「昨日」を振り返って見ます。ニューラル機械翻訳が最も得意とする技の一つが、このような離れた位置にある言葉の語順の入れ替え(特に動詞の移動)でした。
2015年には百度(Baidu)がいち早く「再帰型ニューラルネットワーク+アテンション機構」を組み合わせた大規模なニューラル機械翻訳システムを導入し、翌2016年にはGoogle翻訳も全面的にこの構造へと切り替えました。Googleの2016年の報告によれば、それまで10年間使われてきた統計的機械翻訳システムと比べ、ニューラル機械翻訳は翻訳の誤りを平均で約60%減少させました。
ただ、再帰型ニューラルネットワークにはまだ生まれつきの弱点が残っていました。一語ずつ順番に読むしかないという点です。各ステップの記憶は前のステップの計算が終わらないと受け取れないため、前の語の処理が終わるまで後ろの語は待つしかありません。訓練のときに原文と訳文の全文がすでに目の前に揃っていても、一度にまとめて計算することができず、バトンリレーのように時間がかかってしまったのです。
順番待ちを捨て、全員が拡声器を持つ:Transformerと大規模言語モデルはどう文脈をつないだのか?
2017年、Googleの8人の研究者が、機械翻訳の実験を題材にした一本の論文を発表しました。タイトルは『Attention Is All You Need』。その意味するところは明快です。再帰型ニューラルネットワークは捨てろ、アテンションだけで十分だ。
翻訳研究から生まれたこの論文が提唱した新しい構造こそ、後に広く知られることになる Transformer です。これは機械翻訳を塗り替えただけでなく、後のBERT(2018年)やGPTシリーズ(2018年〜)、そしてChatGPT(2022年末)など、現代のほとんどの大規模言語モデルの土台となりました。『Nature』誌の2025年の集計によれば、この論文は21世紀で最も多く引用された科学論文のトップ10に入っています。
Transformer は従来の再帰型ニューラルネットワークと何が違うのでしょうか。言葉を伝えるゲームにたとえるとわかりやすくなります。
- 再帰型ニューラルネットワークは伝言ゲーム:一列に並んだ人たちが、隣の語へと順番にささやき声を伝えていくようなものです。遠くへ行くほど内容が薄れてしまうだけでなく、後ろにいる語は自分の番が回ってくるまでじっと順番を待つしかありません。
- Transformer は全員が拡声器を持つ:並んでいるすべての単語が同じ瞬間に一斉に声を上げ、どの単語も他のすべての単語の声を直接聞くことができます。どれだけ離れていても、距離に関係なくはっきりと届きます。
全員が同時に声を上げたら、騒がしくて収拾がつかなくなるのではないでしょうか。そうはなりません。なぜなら各単語は、相手を選んで耳を傾けるからです。文の中で自分と関連の深い語の声を重点的に聞き取り、それによってこの文における自分の正確な意味を決めます。このように文の中の単語同士がお互いを見渡し、関連の深さに応じて情報を集める仕組みを**自己注意(セルフアテンション)**と呼びます。
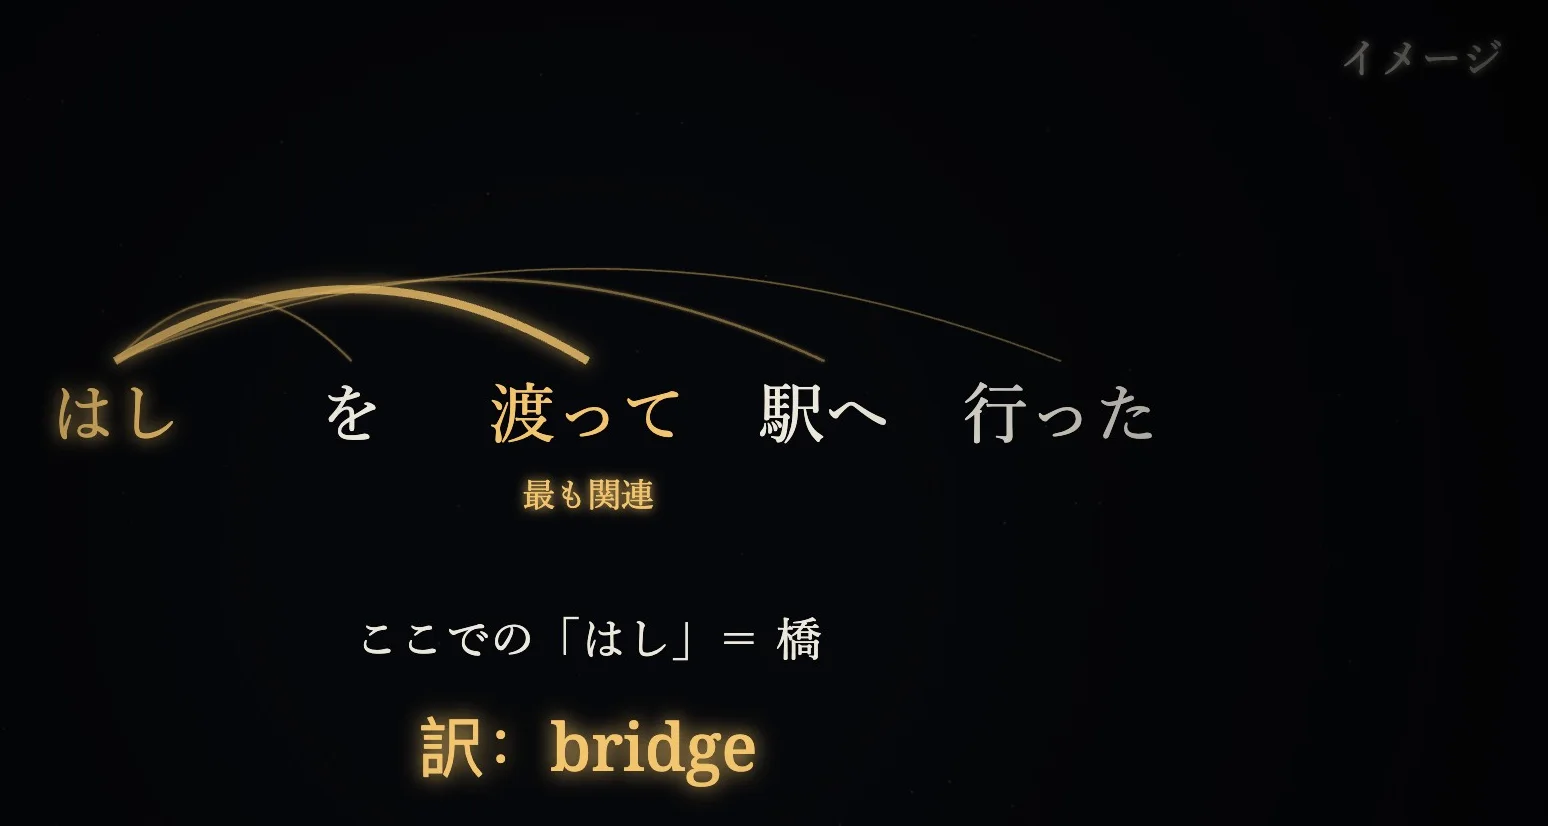
自己注意が多義語の問題をどう解決するのか見てみましょう。同じ「はし」という言葉でも、二つの異なる文に置かれるとどうなるでしょうか。
- 「はしを渡って駅へ行った」という文では、「はし」が拡声器を持って文全体を見渡し、すぐ後ろの「渡って」が自分と一番関連が深いことに気づきます。「渡って」の情報に最も注目することで、ここでの自分は川などにかかっている「橋」だと分かり、英語に訳すときは bridge になります(イメージ)。
- 一方、「はしですしを食べた」という文では、「はし」は文末の動詞「食べた」に一番注目します。すると今度は食事に使う「箸」だと分かり、英語では chopsticks と訳し分けられます(イメージ)。
文全体のつながりを見渡せることに加え、Transformer には実用上の大きな強みがありました。順番待ちがいらないことです。モデルを訓練するとき、ページ全体のすべての単語を同時に並列計算できるため、計算速度が飛躍的に上がりました。高速に処理できるようになったことで、それまでは考えられなかったほど膨大なテキストを機械に読み込ませて訓練できるようになったのです。
やがて研究者たちは、この Transformer を使って大規模言語モデル(LLM)を作り上げました。大規模言語モデルは翻訳専用に作られたものではなく、あらゆる汎用タスクをこなすために生まれたもので、翻訳はその数ある得意技の一つにすぎません。しかも事前学習の段階で徹底的に訓練するのは、たった一つの基本動作――次の語を当てることだけです。
どこかで聞き覚えがないでしょうか。先ほど統計的機械翻訳のところで登場した n-gram 言語モデルも、「直前の数語から次の語を予測する」仕組みでした。たとえば「昨日東京で会ったのは _」に続くなら、機械は最もありそうな言葉として「彼」を予測します。しかし動詞が「食べたのは _」に変われば、次に続く候補はすべて食べ物の名前になります(イメージ)。数学ではこれを条件付き確率と呼びます。日常の会話と同じで、次にどんな言葉が来るかは、前に何を言ったかで決まるのです。
どちらも「次の語を当てている」のなら、大規模言語モデルと昔の統計的な言語モデルとでは、本質的に何が違うのでしょうか。決定的な違いは二つあります。
- 見渡せる範囲の広さ:昔の統計的な言語モデルは視野が狭く、空欄の直前の数語しか見ることができませんでした。それに対して大規模言語モデルは、段落全体を見渡せます(たとえば GPT-3 のコンテキストウィンドウは2048個のトークンを収められます)。仮に「先週から大阪に出張している。昨夜食べたのは _」という文章があったとします。昔の言語モデルは直前の「昨夜食べたのは」という数語しか枠に入れられないため、話し手が大阪にいることがわかりません。しかし大規模言語モデルは段落全体を視野に入れ、前に「大阪」と書いてあるのを見て取れるため、後に続くのは名物の「たこ焼き」である可能性が高いと予測できるのです(イメージ)。
- 応用が利くかどうか:昔の言語モデルは言葉の並びが何回現れたかをそのまま数えていたため、訓練データで「たこ焼きを食べた」は見たことがあっても、「いか焼きを食べた」を見たことがなければ、未知の表現に対応できず正確に計算できませんでした。一方、大規模言語モデルはニューラルネットワークの「単語を連続した数値にする」力を受け継いでいます。数値の空間では「たこ焼き」と「いか焼き」はとても近い位置にあるため、たとえ「いか焼きを食べた」という表現が珍しくても、学習結果を応用してうまく計算できるのです(イメージ)。
ただ、ここで一つ素朴な疑問が湧いてきます。毎日ひたすら「前の文脈に続く次の語を当てる」練習ばかりしていたモデルが、翻訳の専門訓練を受けたわけでもないのに、なぜ突然翻訳までできるようになったのでしょうか。
2023年のある研究が、その重要な手がかりを明らかにしています。研究者がある大規模言語モデル(PaLM)の訓練データを詳しく調べたところ、インターネットから集められたウェブページや文書の中に、少なくとも44言語にわたる3000万組以上の対訳テキストがすでに紛れ込んでいたのです。言い換えれば、人間は知らず知らずのうちに、日常のウェブページに挟まれた膨大な「翻訳の教科書」をモデルに読み込ませていたことになります。だからこそ、入力欄に翻訳の指示と原文を書けば、大規模言語モデルがその続きとして最も自然だと予測する言葉が、そのまま外国語の訳文になるのです(イメージ)。
2020年に登場した GPT-3 も、こうして鍛えられました。数千億語におよぶテキストを読み込み、プログラムのコード書きから要約、そして翻訳まで、指示(プロンプト)に続けてあらゆる文章を書けるようになりました。GPT-3 の裏には、ある大胆な賭けがありました。モデルを大きくし、多くの文章を読ませるほど、性能は上がっていくはずだ、という見立てです。
ここでいう「大きさ」とは、モデル内部で調整できる数値――すなわちパラメータ――の数を指します。2018年から2020年にかけて、モデルのパラメータ規模は爆発的に増えました。
- GPT-1(2018年):1億1700万パラメータ
- GPT-2(2019年):15億パラメータ(約13倍に増加)
- GPT-3(2020年):1750億パラメータ(さらに約117倍に増加)
- 2022年11月に登場した ChatGPT(当初はファインチューニングされた GPT-3.5 ベース)や2023年の GPT-4 になると、公式にはパラメータ数が非公開となりました(報道では GPT-4 は約1兆規模とも言われますが、未確認です)。
この規模拡大の競争の中で、研究者たちは一つの法則を見出しました。スケーリング則(Scaling Law)です。パラメータの数と訓練データ、そして計算量をバランスよく増やしていけば、モデルの性能はべき乗則に従って着実に伸びていくという法則です。対数グラフの上では、投入する資源を10倍にするごとに性能が直線に沿って一段ずつ上がっていき、どれだけ伸びるかをあらかじめ計算で予測することさえできます。
2022年11月30日に ChatGPT が登場すると、翻訳はいつでも相談しながら進められる対話へと変わりました。以前の翻訳ソフトでは、出てきた訳文をそのまま受け入れるしかありませんでしたが、今は最初の訳がしっくりこなければ、一言添えるだけで済みます。たとえば「明日の会議は午後3時に変更です」と英訳させて、まず「Tomorrow's meeting is moved to 3 pm.」という普通の訳が出たとします。そこに「取引先に出すので、もう少し丁寧にして」と書き添えれば、その場でビジネス向けの口調に変えて「Please note that tomorrow's meeting has been rescheduled to 3:00 p.m.」と訳し直してくれます(イメージ)。
さらに重要なのは、長い文脈を読み取れるようになったことで、翻訳がついに「文字通りの意味」の壁を越えたことです。たとえば「彼は旅立った」という短い一文は、文字通りに読めば旅へ「出発した」(left)という意味ですが、人の死を婉曲に伝える「彼は亡くなった」(passed away)という表現でもあります。もし直前の文脈で病院や病状の話をしていたなら、大規模言語モデルはその場面をくみ取り、死を婉曲に言う表現だと見抜いて直訳を避けられるかもしれません(イメージ)。
大規模言語モデルが登場する前の翻訳ソフトは、たとえ文の意味は合っていても、原文の構造に引きずられた不自然な「機械翻訳調」がどうしても残りました。たとえばビジネスでよく使われる「その件は後ほど確認してご連絡します」という一言も、以前の翻訳ソフトでは原文の語順通りに「That matter later I will check and contact you.」と直訳してしまうことがありました(イメージ)。しかし大規模言語モデルなら、「I'll check on that and get back to you later.」といった自然な英語の言い回しを出してくれます(イメージ)。そして2023年の国際的な機械翻訳の評価(WMT23)では、トップ層の機械翻訳の質が人間の翻訳に肩を並べるまでになりました。
文字の先にある舞台:エンドツーエンドの同時通訳はどうやって「いつ話し始めるか」を決めるのか?
書き言葉の翻訳を乗り越えた機械は、今さらに難しい課題に挑んでいます。相手が話すそばからリアルタイムで外国語へと訳して語り出す、同時通訳です。
初期の音声翻訳は、三つの段階を順番に進むカスケード方式をとっていました。
- 音声認識(ASR):まず聞き取った声を原文の文字にします。
- 機械翻訳(MT):次にその文字を外国語の文字へと翻訳します。
- 音声合成(TTS):最後に外国語の文字を合成音声で読み上げます。
この三段階のリレー方式には、二つの大きな弱点がありました。一つ目は、遅いうえに誤りが連鎖しやすいことです。前の段階の計算が終わるまで次の段階が待たなければならないため、三段階分の待ち時間が積み重なって遅延が大きくなります。しかも最初の音声認識で一語でも聞き間違えると、続く翻訳と読み上げでも誤りがそのまま引き継がれてしまいます。二つ目は、感情が消えてしまうことです。人間の声に含まれる口調や抑揚、感情はすべて音波の中に宿っていますが、途中の段階でいったん無機質な文字にしてしまうせいで、そうした言葉以外の情報がすっかり抜け落ち、最後に読み上げられる訳文は抑揚のない機械的な声になってしまいます。
途中の文字の段階を飛び越えるため、研究者たちが向かったのがエンドツーエンド(End-to-End)モデルです。単一のモデルで、ある言語の音声から別の言語の音声へと直接変換します。三段階に分けないため、前の段階の誤りが後ろへ伝わることもなく、一度の変換で済むので待ち時間も省けます。2019年にGoogleが発表した Translatotron はその一例で、音声から音声へ直接変換するだけでなく、外国語の訳文を話すときに元の話し手の声色まで保つことができました。もっとも、当時はまだ話し手が一文を最後まで言い終えるのを待たなければ訳し始められず、本当の意味での同時通訳とは言えませんでした。
本当の同時通訳を実現するうえで最大の難所となるのは、いつ話し始めるかという問題です。
ここで、冒頭で触れた「語順の違い」という問題が再び立ちはだかります。日本語と英語では語順が大きく異なり、特に日本語は重要な動詞が文末に来ます。話し手が前半を口にした時点では、肝心の動詞はまだ後半に残っていて発話されていません。機械が長く待てば待つほど、情報が揃って訳は正確になりますが、イヤホンで訳を待っている聞き手はじれてしまいます。逆に、時間を稼ごうとして単語が聞こえたそばから訳し出すと、後半を聞いていないせいで誤訳しやすくなります。優れた同時通訳システムは、「待つ」ことと「話す」ことの間で絶妙なバランスを取らなければなりません。たとえば前半を聞いた時点でまず訳し出し、後半の動詞を聞いてから続きを自然につなぐ、といった芸当が求められます(イメージ)。
2025年になると、新しい世代の同時通訳モデルは全二重(Duplex)構造へと進化しました。一つのモデルが「聞く」ことと「話す」ことを同時に行えるようになったのです。その土台にあるのはやはり言語モデルで、一歩ずつ次の展開を予測している点では同じですが、予測するのは「次に来る単語」だけではありません。一瞬ごとにリアルタイムで、今は聞き続けるべきか、それとも話し出すべきかまで判断しています(イメージ)。
2025年にはある研究チームの報告で、こうしたエンドツーエンドの全二重同時通訳モデルが、相手の話を聞きながら同時に話し手本人の声色のままで外国語に訳し出し、声色を保った同時通訳の平均の遅れを従来の10秒近くから約3秒へと、約7割も縮めたといいます。
70年で登った4つの段:うまく訳すには、まず理解すること
時計の針を1947年に戻し、この70年あまりの探求を一枚のグラフに描いてみると、機械翻訳が経験した三度の大きな飛躍がはっきりと浮かび上がります。1990年頃の統計的機械翻訳、2014年に台頭したニューラル機械翻訳(2016年のGoogleの検証で誤訳が約6割減少)、そして2020年代の大規模言語モデル(2023年の国際評価でトップ層が人間に迫る品質に到達)です。
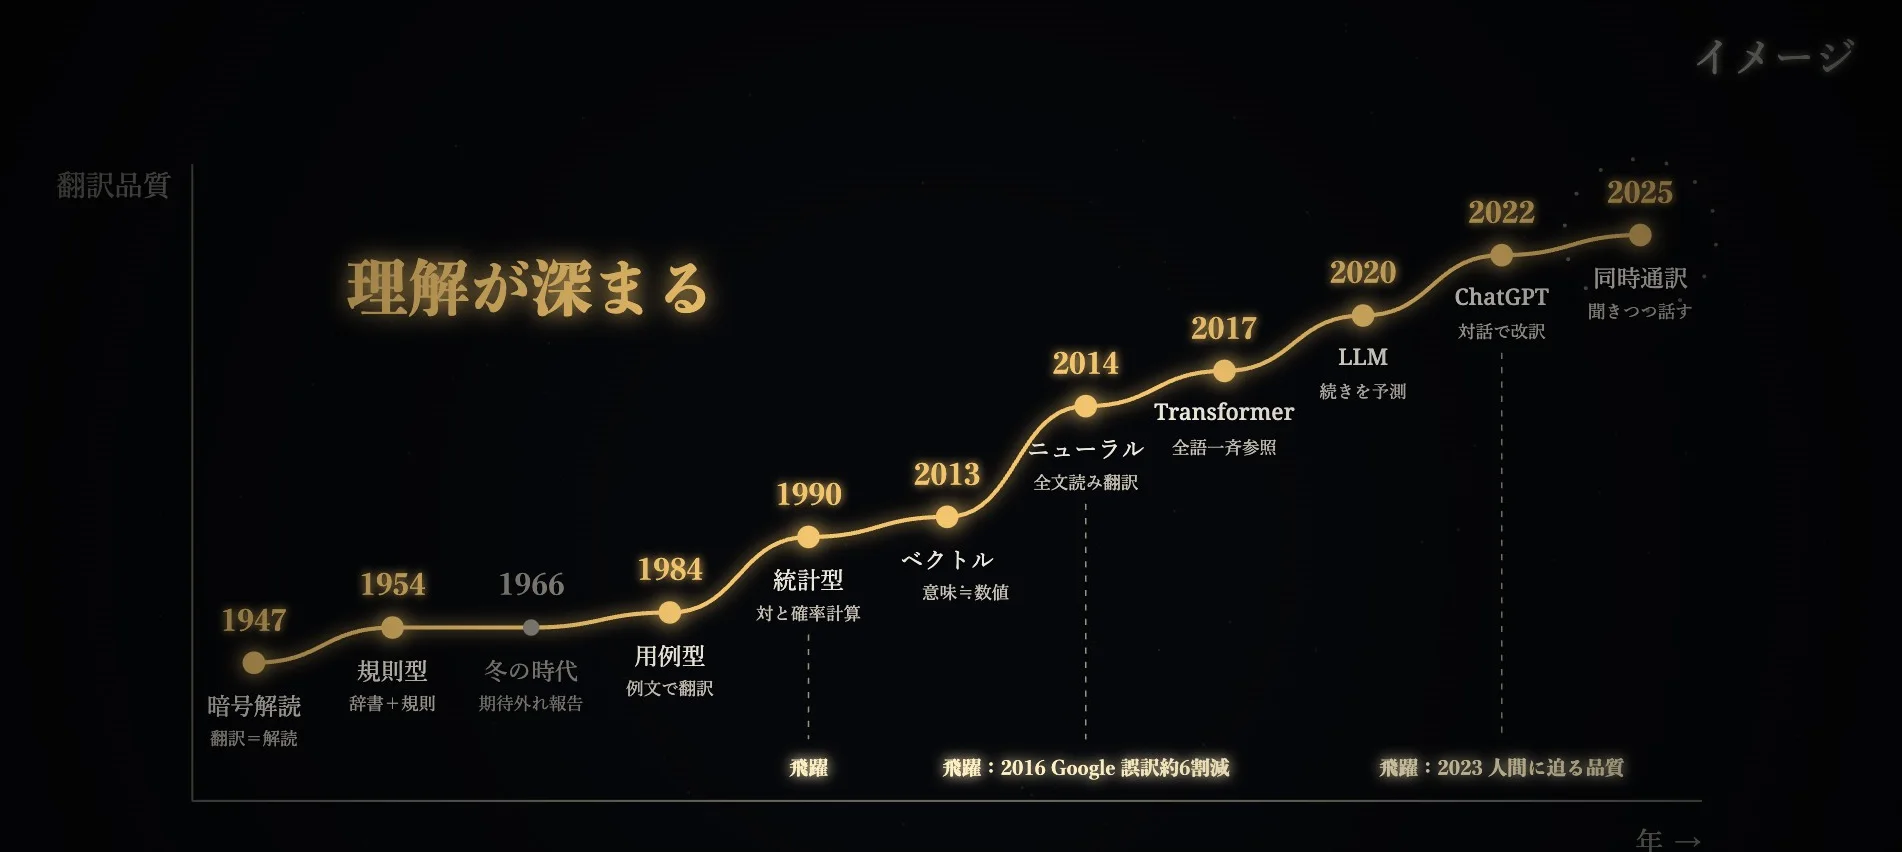
当初、翻訳とは暗号解読のようなもので、二つの言語の間で対応する記号を当てはめれば済むと思われていました。しかし何度も壁にぶつかるうちに、規則だけでは言葉の例外をとても書き切れず、単語ペアの出現回数を数える統計翻訳でも、言葉の本当の意味まではつかめないことがわかってきました。
機械翻訳が一歩前に進むたび、機械は人間の言葉を一段ずつ深く理解するようになっていきました。
- 1段目:記号(1954〜2013年)。人間が辞書と文法を書くルールベース翻訳であれ、大量の対訳文から単語ペアを数える統計翻訳であれ、機械にとっての単語はただの独立した記号にすぎず、記号と記号を対応させていただけでした。
- 2段目:語義(2013年)。単語ベクトルが各単語を数百個の連続した数字に変えたことで、機械は初めて言葉同士の意味の近さを計算できるようになり、学習した結果を似た言葉へ応用できるようになりました。
- 3段目:文全体(2014〜2017年)。再帰型ニューラルネットワークやアテンション機構から Transformer へと進み、機械は文全体を一つの記憶として読み取り、文の中で自己注意によってお互いの関連を見渡し、文全体のつながりから各単語の意味と語順を決められるようになりました。
- 4段目:文脈(2020年〜現在)。大規模言語モデルは視野を一文から段落全体、さらには対話全体へと広げ、前後の場面や口調の指定、さらには話し手の声色まで踏まえて、その場にふさわしい訳文を出せるようになりました。
冒頭で見た「私は昨日東京で彼に会った」というごくありふれた一文でさえ、いくつかの単語を適切な位置へ入れ替えて自然に訳すには、まずその文を理解しなければなりません。なぜなら、翻訳とは単なる記号の置き換えではなく、理解することだからです。
参考文献
- 1947年3月4日のWeaverからWienerへの書簡;1949年の覚書 "Translation"
- 1954年 Georgetown–IBM実験
- ALPAC報告書 (1966): Language and Machines: Computers in Translation and Linguistics https://nap.nationalacademies.org/catalog/9547
- カナダのMETEO天気予報翻訳システム(1981年〜)
- Makoto Nagao (1984): A Framework of a Mechanical Translation between Japanese and English by Analogy Principle
- 統計的機械翻訳, Brown et al. (1990): A Statistical Approach to Machine Translation https://aclanthology.org/J90-2002/
- Google翻訳が2006年にサービス開始(統計的機械翻訳)
- word2vec, Mikolov et al. (2013): Efficient Estimation of Word Representations in Vector Space https://arxiv.org/abs/1301.3781
- Sequence to sequence, Sutskever et al. (2014): Sequence to Sequence Learning with Neural Networks https://arxiv.org/abs/1409.3215
- Cho et al. (2014): Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation https://arxiv.org/abs/1406.1078
- アテンション機構, Bahdanau et al. (2014): Neural Machine Translation by Jointly Learning to Align and Translate https://arxiv.org/abs/1409.0473
- Baiduが2015年にニューラル機械翻訳を開始;Google, Wu et al. (2016, 誤りが平均約60%減少): Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation https://arxiv.org/abs/1609.08144
- Transformer, Vaswani et al. (2017): Attention Is All You Need https://arxiv.org/abs/1706.03762 ;引用データはNature (2025)より: Exclusive: the most-cited papers of the twenty-first century https://www.nature.com/articles/d41586-025-01125-9
- GPT-1 (2018): Improving Language Understanding by Generative Pre-Training https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf ; GPT-2 (2019): Language Models are Unsupervised Multitask Learners https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- GPT-3, Brown et al. (2020): Language Models are Few-Shot Learners https://arxiv.org/abs/2005.14165
- スケーリング則, Kaplan et al. (2020): Scaling Laws for Neural Language Models https://arxiv.org/abs/2001.08361
- GPT-4 Technical Report (2023, パラメータ数非公開;Semaforの報道では約1兆、未確認) https://arxiv.org/abs/2303.08774
- Briakou et al. (2023): Searching for Needles in a Haystack: On the Role of Incidental Bilingualism in PaLM's Translation Capability https://arxiv.org/abs/2305.10266
- ChatGPT: 2022年11月30日のOpenAIリリースノート, Introducing ChatGPT https://openai.com/index/chatgpt/
- WMT23 (2023): Findings of the 2023 Conference on Machine Translation (WMT23): LLMs Are Here But Not Quite There Yet https://aclanthology.org/2023.wmt-1.1/
- Translatotron, Jia et al. (2019): Direct speech-to-speech translation with a sequence-to-sequence model https://arxiv.org/abs/1904.06037
- STACL, Ma et al. (2018): STACL: Simultaneous Translation with Implicit Anticipation and Controllable Latency using Prefix-to-Prefix Framework https://arxiv.org/abs/1810.08398
- Moshi (2024, リアルタイム音声対話モデル): Moshi: a speech-text foundation model for real-time dialogue https://arxiv.org/abs/2410.00037
- Hibiki (2025): High-Fidelity Simultaneous Speech-To-Speech Translation https://arxiv.org/abs/2502.03382
- Seed LiveInterpret 2.0 (2025): Seed LiveInterpret 2.0: End-to-end Simultaneous Speech-to-speech Translation with Your Voice https://arxiv.org/abs/2507.17527