Formule rotte su arXiv? Come tradurre paper accademici in PDF
 Equalang
In breve
La traduzione automatica spezza formule LaTeX e frasi su due colonne nei paper? Scopri come preservare il layout originale e leggere con l'originale e la traduzione affiancati.
Parole chiave: traduzione paper arXiv; strumenti traduzione accademica; layout PDF a due colonne; traduzione formule LaTeX; lettura bilingue a due pagine
Quando segui ogni settimana gli ultimi preprint su arXiv o passi in rassegna gli articoli accettati alle conferenze più prestigiose, ti scontri spesso con un muro invisibile: copiando il testo di un PDF accademico a due colonne nei classici riquadri di traduzione, le rigorose formule matematiche in LaTeX, i pedici, gli indici e i simboli di sommatoria si riducono all'istante a frammenti incomprensibili. I trattini di sillabazione (hyphenation) tra colonne o a fondo pagina spezzano le parole a metà, producendo frasi incoerenti; quando finalmente finisci di tradurre una pagina, i riferimenti a figure e tabelle e il filo logico delle derivazioni sono andati perduti, costringendoti a passare di continuo da una finestra all'altra per ritrovare i punti corrispondenti e prosciugando tutte le tue energie.
Il vero ostacolo nella lettura degli articoli scientifici non è quasi mai un vocabolario inglese carente, bensì il fatto che le formule vengano distrutte in caratteri casuali, il layout a due colonne venga stravolto e sia impossibile allineare testo originale e traduzione, interrompendo il flusso di concentrazione di chi fa ricerca.
In questo articolo analizzeremo i criteri tecnici fondamentali per scegliere uno strumento di traduzione per la letteratura accademica, confronteremo i limiti reali delle soluzioni open source e dei tool più diffusi, e ti mostreremo un flusso di lavoro efficiente per studiare i paper preservando sia le formule matematiche sia il layout originale a due colonne.
1. Perché i paper accademici sono un osso duro per la traduzione automatica?
Gli strumenti di traduzione generici (come le estensioni del browser per selezionare il testo o i normali campi di testo) funzionano bene con paragrafi lineari e quotidiani, ma mostrano tutti i loro limiti davanti a un PDF accademico. Ciò è dovuto principalmente a tre sfide tecniche specifiche della letteratura scientifica:
- Formule matematiche LaTeX e simboli speciali interconnessi: il corpo del testo è fitto di variabili inline (come $\theta_i, \mathbf{W}_Q$), pedici e apici, frazioni complesse ed equazioni tensoriali a sé stanti. I motori di traduzione generici non riconoscono l'albero sintattico di formattazione, quindi tendono a trattare le variabili matematiche come normali parole inglesi da tradurre a tutti i costi, spezzando elementi come la radice quadrata al denominatore $\sqrt{d_k}$ in caratteri casuali e mandando in tilt l'intera dimostrazione.
- Layout a due colonne e interruzioni di pagina fisiche: i file PDF sono essenzialmente istruzioni grafiche statiche nate per la stampa e non contengono un flusso logico nativo dei paragrafi. Il layout a due colonne fa sì che i tool tradizionali leggano da parte a parte scavalcando le colonne; inoltre, le frasi lunghe a fondo pagina vengono spesso troncate a metà, generando gravi errori di traduzione.
- Perdita di didascalie e riferimenti incrociati: diagrammi architetturali (Figure), tabelle di studi di ablazione (Table) e riferimenti a equazioni specifiche nel testo (come Equation 3) finiscono facilmente fuori posto o svaniscono durante l'estrazione generica del testo, spezzando la catena logica dell'argomentazione.
Per questo motivo, uno strumento di traduzione per la letteratura accademica davvero valido deve possedere tre capacità fondamentali: analisi strutturata del layout PDF, protezione in situ delle formule LaTeX e confronto affiancato tra testo originale e traduzione.
2. Confronto tra le principali soluzioni di traduzione per la letteratura accademica
Nella ricerca quotidiana, le soluzioni più comuni per tradurre la letteratura scientifica si dividono principalmente in tre categorie, ciascuna con confini di applicazione ben definiti:
Se hai bisogno di formule accurate, un layout ordinato e una soluzione pronta all'uso senza configurazioni complesse, ecco come funziona il flusso di lavoro pratico con la piattaforma che abbiamo sviluppato noi di Equalang.
3. Tre passaggi per impostare un flusso di lettura bilingue per paper a due colonne
Per rendere la lettura fluida, puoi confrontare l'originale e la traduzione generata affiancandoli l'uno all'altro, per un'esperienza di studio immersiva.
Passaggio 1: analizza l'intero documento e attiva l'ottimizzazione delle formule
Carica il file PDF originale scaricato da arXiv nella sezione di traduzione documenti sull'interfaccia web di Equalang. Per gli articoli scientifici, informatici o fisici ricchi di formule matematiche, il sistema protegge in modo mirato sia i simboli inline sia le equazioni separate fin dalla fase di analisi.
Se una frase lunga viene interrotta a fondo pagina, il sistema la ricompone prima a livello di logica di paragrafo e poi ne elabora una traduzione coerente con il contesto, evitando che il senso si spezzi tra una pagina e l'altra.
Passaggio 2: controlla la corrispondenza delle formule complesse e dei simboli
Una volta completata la traduzione, il documento generato conserva integralmente la larghezza delle due colonne, la gerarchia dei titoli di sezione, le immagini originali di figure e tabelle e la posizione delle rispettive didascalie.
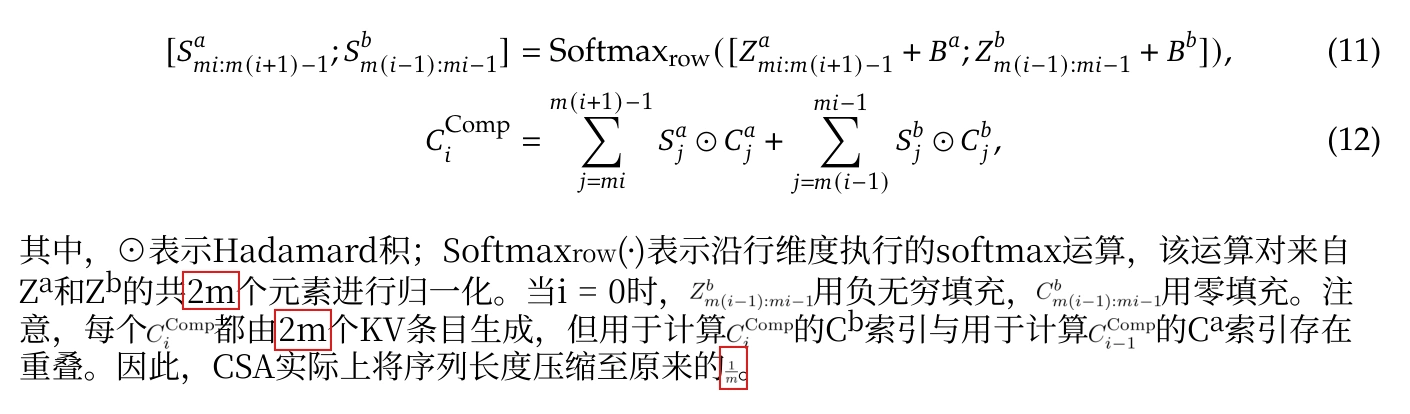
Quando analizzi dimostrazioni rigorose come quelle nel paper DeepSeek-V4, l'immagine sopra illustra la resa dell'impaginazione di formule e traduzione:
- Simboli inline non tradotti come testo: i simboli inline come 2m e Z^a non vengono tradotti in testo, ma la dimensione del carattere di alcune formule inline risulta visibilmente ridotta.
- Equazioni separate e numerazione allineate: le formule CSA (11) e (12) rimangono centrate, con il numero di riferimento a destra perfettamente preservato, garantendo la continuità logica e matematica del testo.
Passaggio 3: affianca l'originale e la traduzione in due finestre
Apri l'originale in inglese e la traduzione in cinese scaricata in Anteprima di macOS, Acrobat, PDF Expert o nel browser Edge, disponendo le due finestre affiancate sullo schermo:
- Apri l'originale in inglese nella finestra a sinistra dello schermo.
- Apri la corrispondente traduzione in cinese nella finestra a destra dello schermo, portandoti alla stessa pagina.
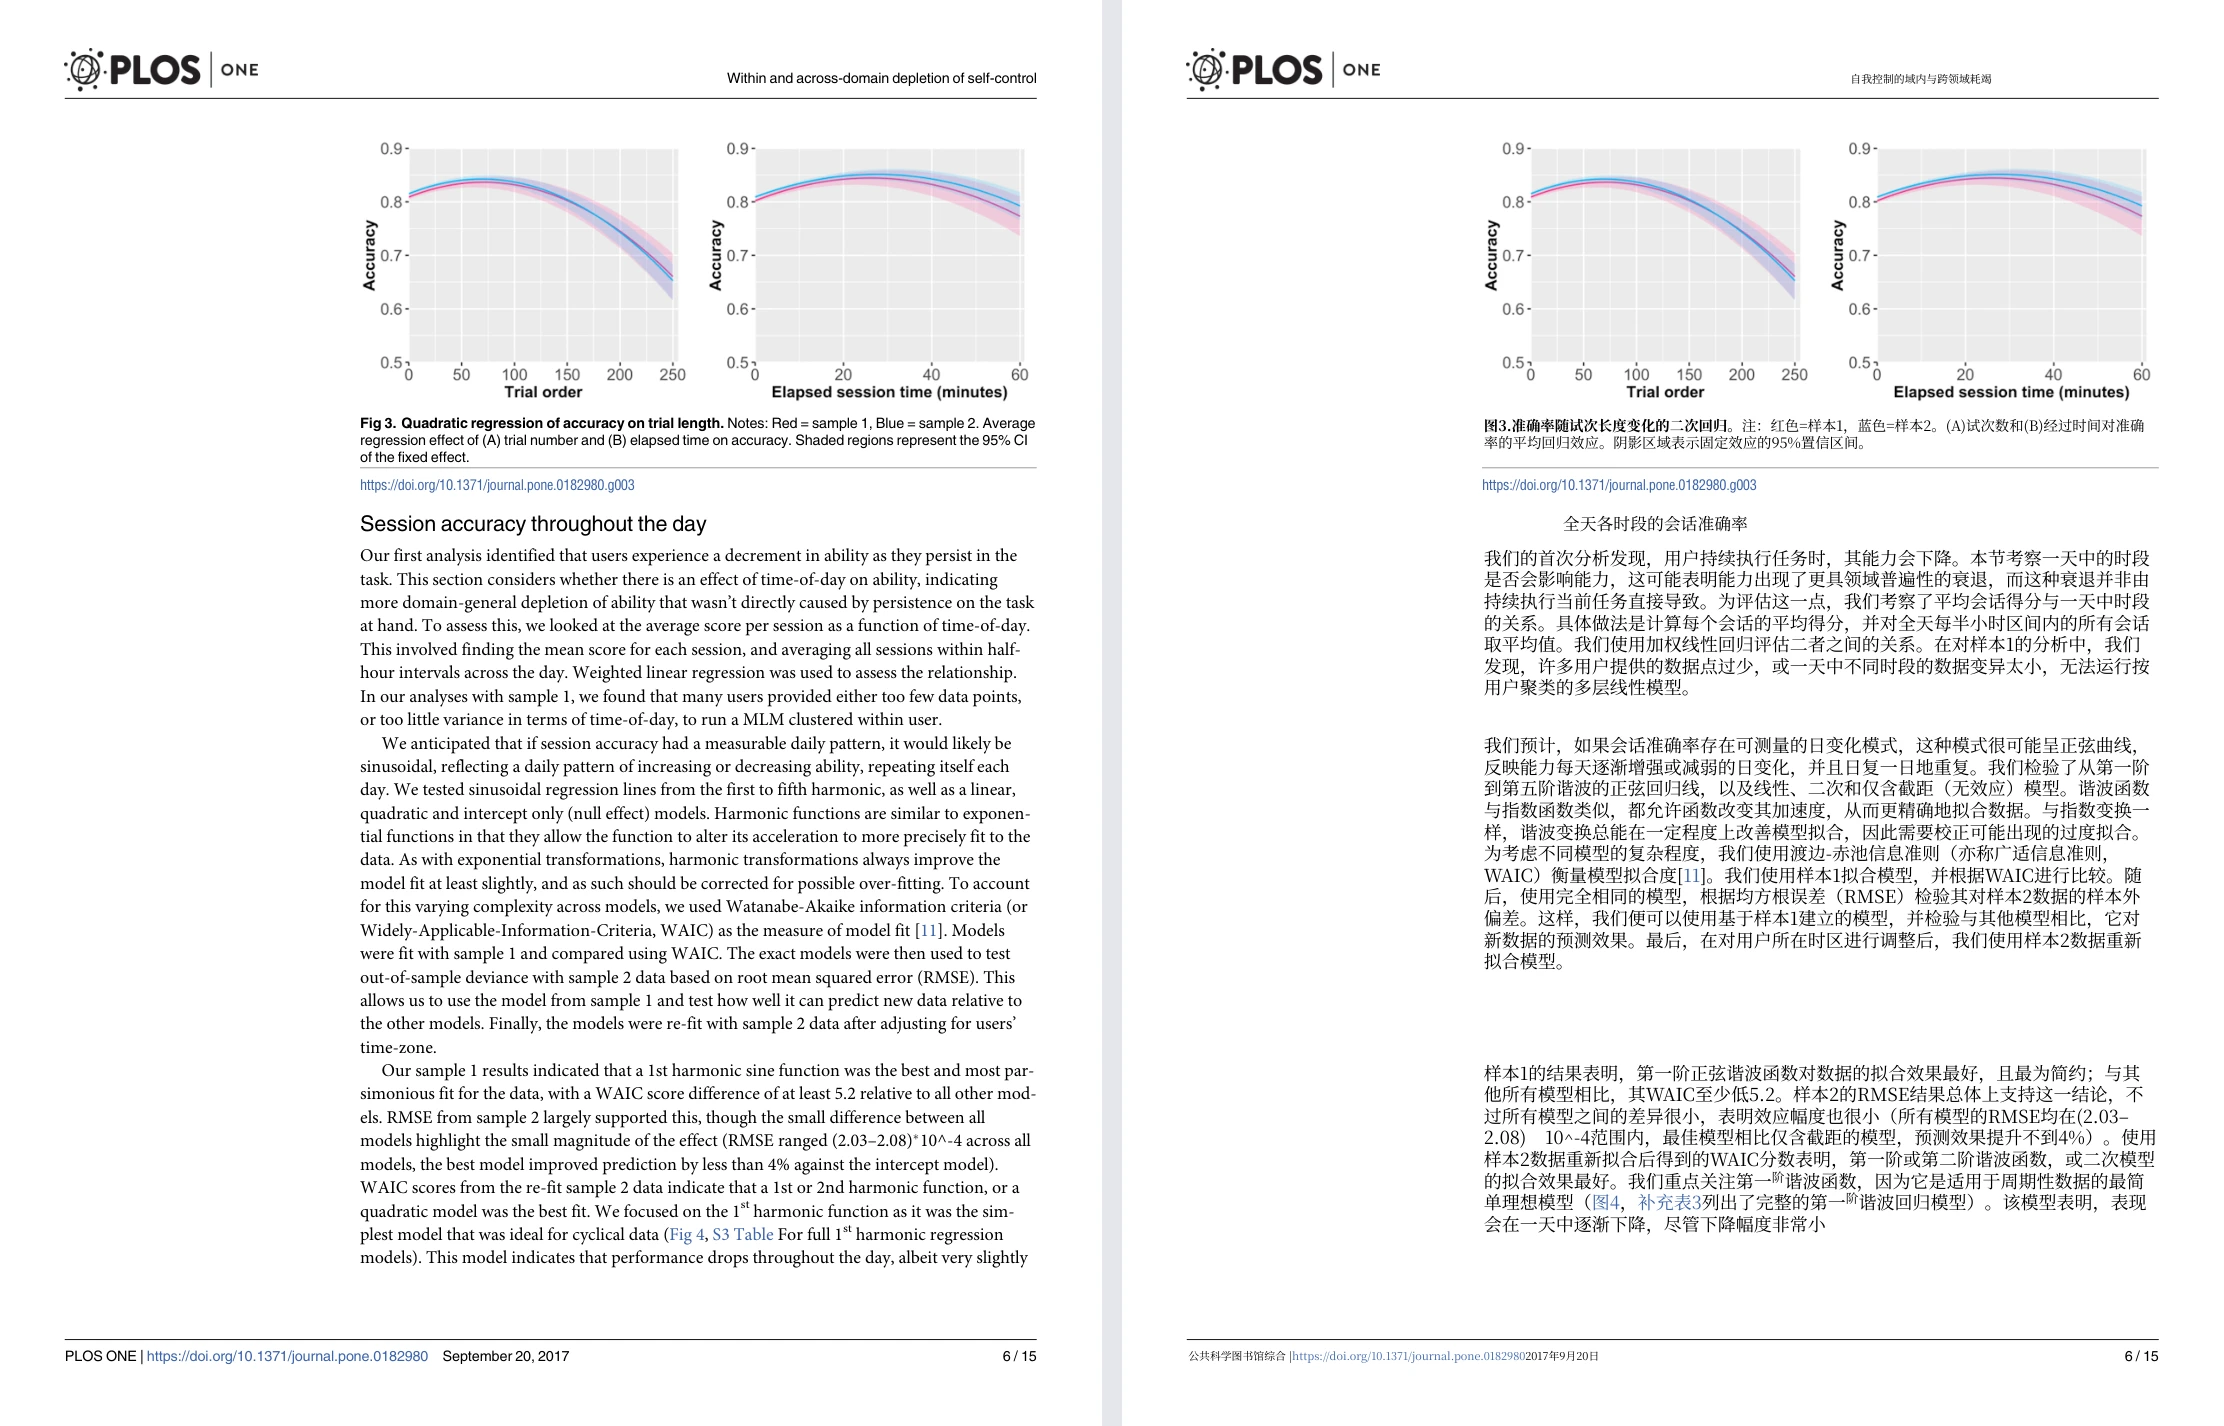
Una volta completata la regolazione, sul lato sinistro dello schermo avrai la pagina $N$ dell'originale in inglese e a destra la corrispondente pagina $N$ della traduzione in cinese dell'esempio:
- Quando scorri l'argomentazione, leggi la traduzione a destra per comprendere rapidamente le motivazioni della ricerca, i punti cardine e l'impostazione degli esperimenti;
- Di fronte a formule decisive, abbreviazioni specialistiche o codice ostico, puoi spostare con naturalezza lo sguardo sull'originale in inglese a sinistra per verificare l'esatta definizione matematica.
4. Errori da evitare nella lettura bilingue della letteratura scientifica
Quando utilizzi questi strumenti per studiare paper accademici, ti consigliamo di mantenere alcune buone abitudini di ricerca:
- Controlla sempre le definizioni originali per le conclusioni importanti: la traduzione automatica abbatte le barriere linguistiche per chi non è madrelingua inglese, ma quando devi citare un paper (Citation), verificare una dimostrazione rigorosa o riprodurre del codice, fai sempre riferimento alla formulazione esatta del testo originale in inglese.
- Presta attenzione alla differenza tra PDF scansionati e vettoriali: nei paper datati disponibili solo come scansione, l'assenza di un OCR ad alta precisione può compromettere la fedeltà del layout; quando possibile, utilizza sempre i PDF vettoriali originali forniti da arXiv o dagli archivi ufficiali IEEE/ACM.
- Mantieni lo pseudocodice complesso in lingua originale: i nomi di funzioni, variabili e librerie esterne (come le primitive di PyTorch o TensorFlow) all'interno dei passaggi algoritmici devono rimanere inalterati per non creare confusione durante l'implementazione pratica.
Fonti e riferimenti
- Portale di traduzione documenti di Equalang
- Database aperto di preprint scientifici arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Repository del progetto open source PDFMathTranslate