医学与生命科学论文 PDF 翻译:
 意扣 Equalang
导读
阅读英文医学与生命科学论文译稿时,如何避免基线表(Table 1)数字错列、临床缩写误译以及 P 值与置信区间误读?本文提供一套分步核对方法与对照阅读工作流。
关键词:医学论文PDF翻译, 生命科学文献阅读, Table 1基线表核对, 临床医学缩写翻译, 统计指标P值置信区间, 双语对照阅读
读英文医学或生命科学论文的译稿时,最危险的不是某句长难句翻得生硬,而是基线表(Table 1)数字串行、专科缩写被拆成字面意思、或者统计指标的符号与修饰语错位。一旦把对照组和干预组的人数看反,或者把置信区间上下限的连字符当成负号,整篇文献的循证结论就会被读偏。
要想既利用 PDF 翻译工具加快文献初筛,又不掉进数据与术语陷阱,核心做法是:先抓摘要和结论建立假设框架,再把 Table 1、临床缩写表和关键统计指标拉回原文逐项核对。翻译工具只能辅助提速,不能替代研究者的专业判断,更不能作为任何临床决策或医疗建议的依据。
为什么医学论文 PDF 翻译容易在关键处出错?
医学与生命科学期刊(尤其是遵循 CONSORT、STROBE 等报告规范的临床研究)大多采用紧凑的双栏排版、跨栏三线表和大量缩写注脚。常规复制粘贴或直接看单语译稿,常遇到三类问题:
- Table 1(基线特征表)列位与层级错乱:医学表格普遍包含多行表头、亚组缩进以及
n (%)、Mean ± SD、Median (IQR)等复合格式。如果转换时丢了列对齐,数字一旦左右错位一格,就会把 A 组的不良反应率算到 B 组头上。 - 多义缩写被按字面硬翻:医学缩写高度依赖上下文。同一个三字母缩写,在肿瘤学、心血管和免疫学里可能代表完全不同的概念;脱离表注或首次定义直接看中文译名,极易张冠李戴。
- 统计符号与限定词丢失:比如把 $P < 0.001$ 的小于号弄丢、把
95% CI的区间范围连字符吃掉,或者把“非劣效性(non-inferiority)”和“优效性(superiority)”的统计结论混为一谈。
四步核对法:从摘要初筛到核心数据复核
拿到一篇几十页的英文医学 PDF,建议按以下四个步骤结合原文与译文阅读:
第一步:先读摘要、结论与报告规范框架
不要一上来就扎进正文细节。先对照阅读摘要(Abstract)的 Methods、Results 和 Conclusions,以及正文末段的讨论首段,明确三件事:
- 研究设计是什么(随机对照试验、队列研究、病例对照还是基础实验)?
- 主要终点(Primary Endpoint)和次要终点是什么?
- 作者声称的核心发现受哪些入排标准限制?
在核对研究设计要素时,可以参考 EQUATOR Network 报告指南(如针对随机对照试验的 CONSORT 清单、针对观察性研究的 STROBE 清单),按标准条目定位文中必须交代的样本量、随访与统计方法。
第二步:逐行对齐核对 Table 1(基线表)
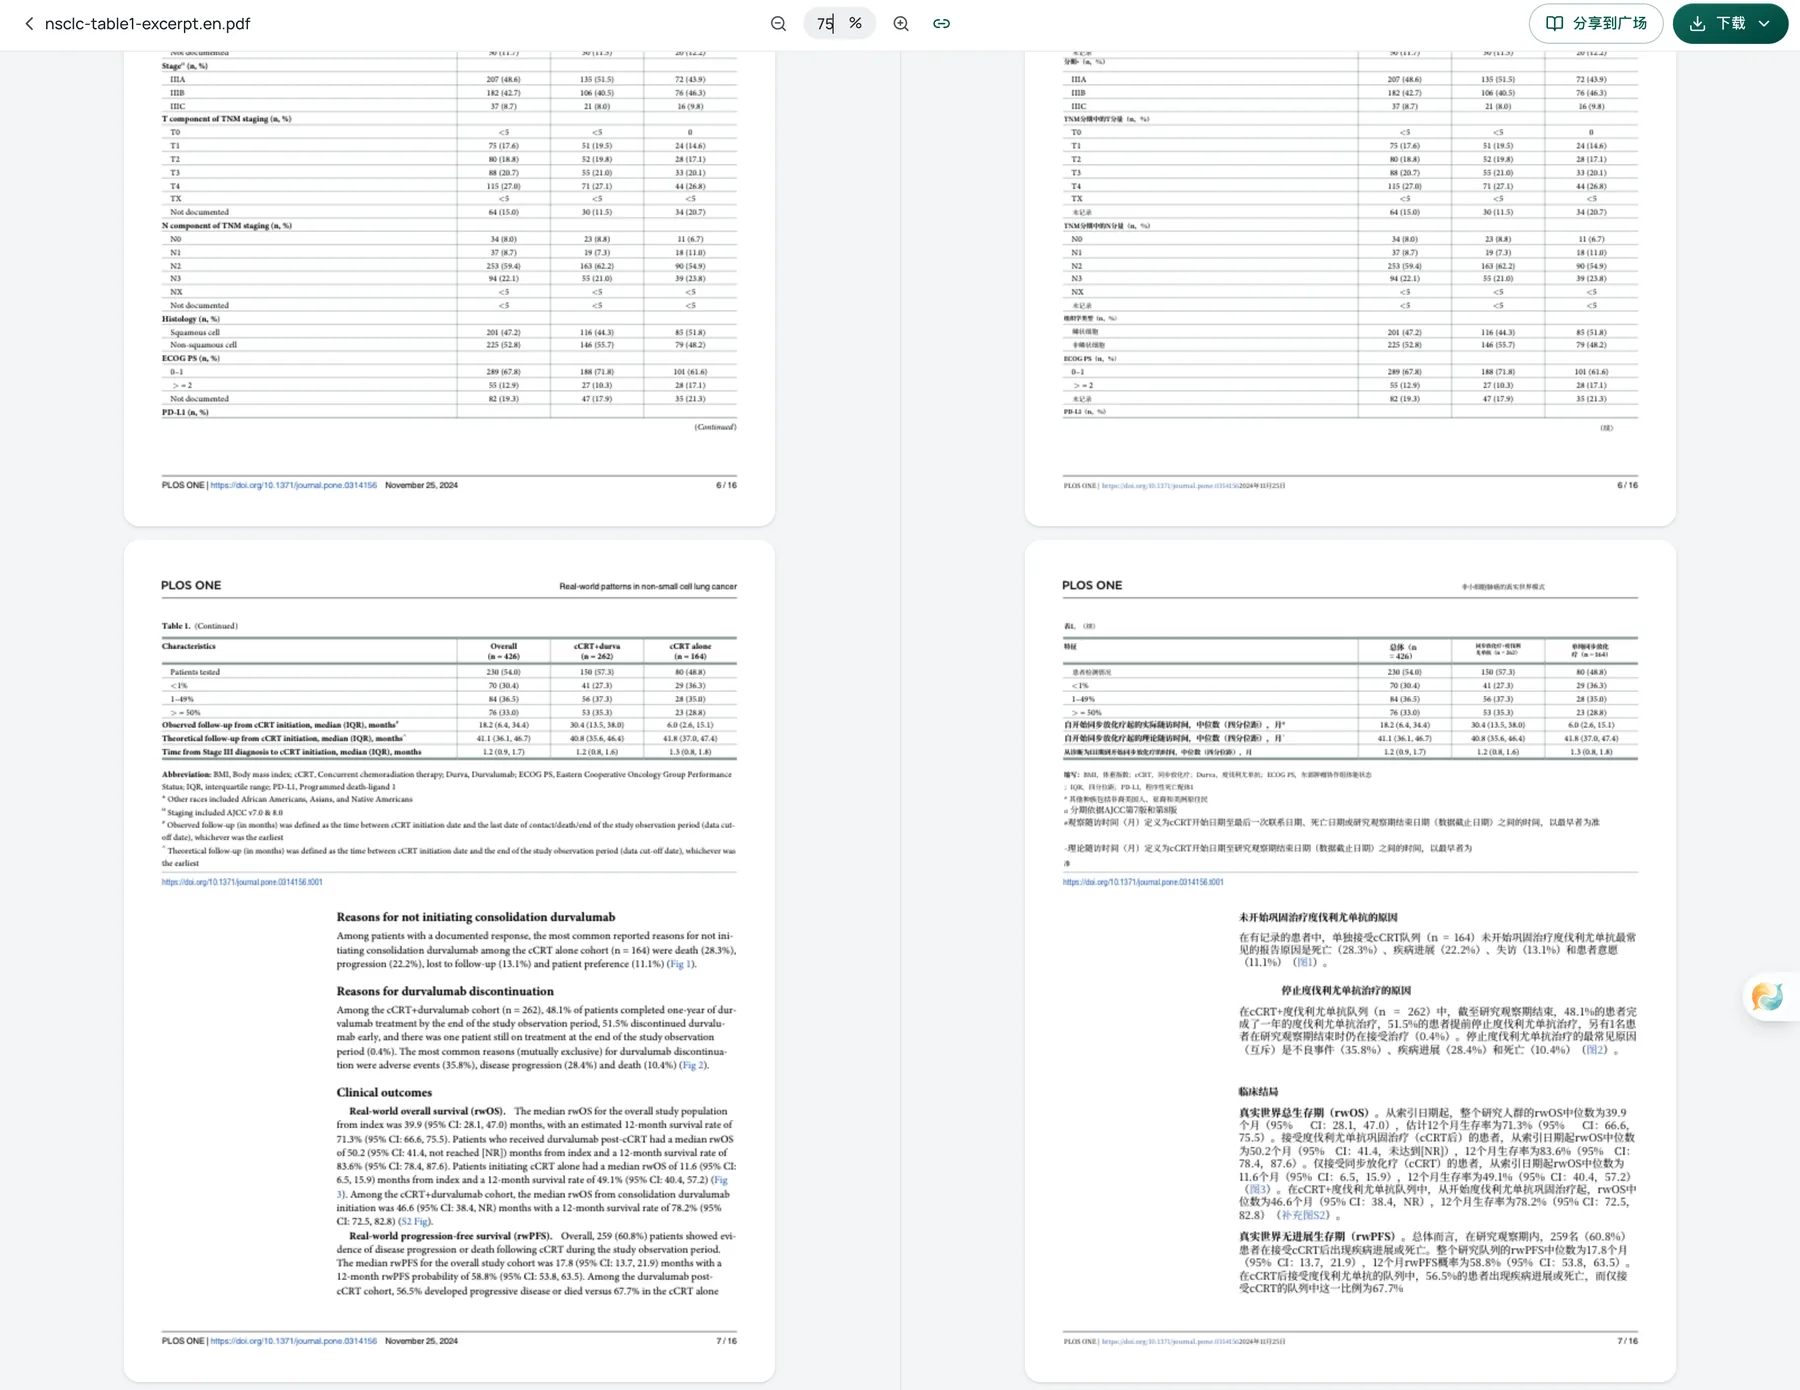
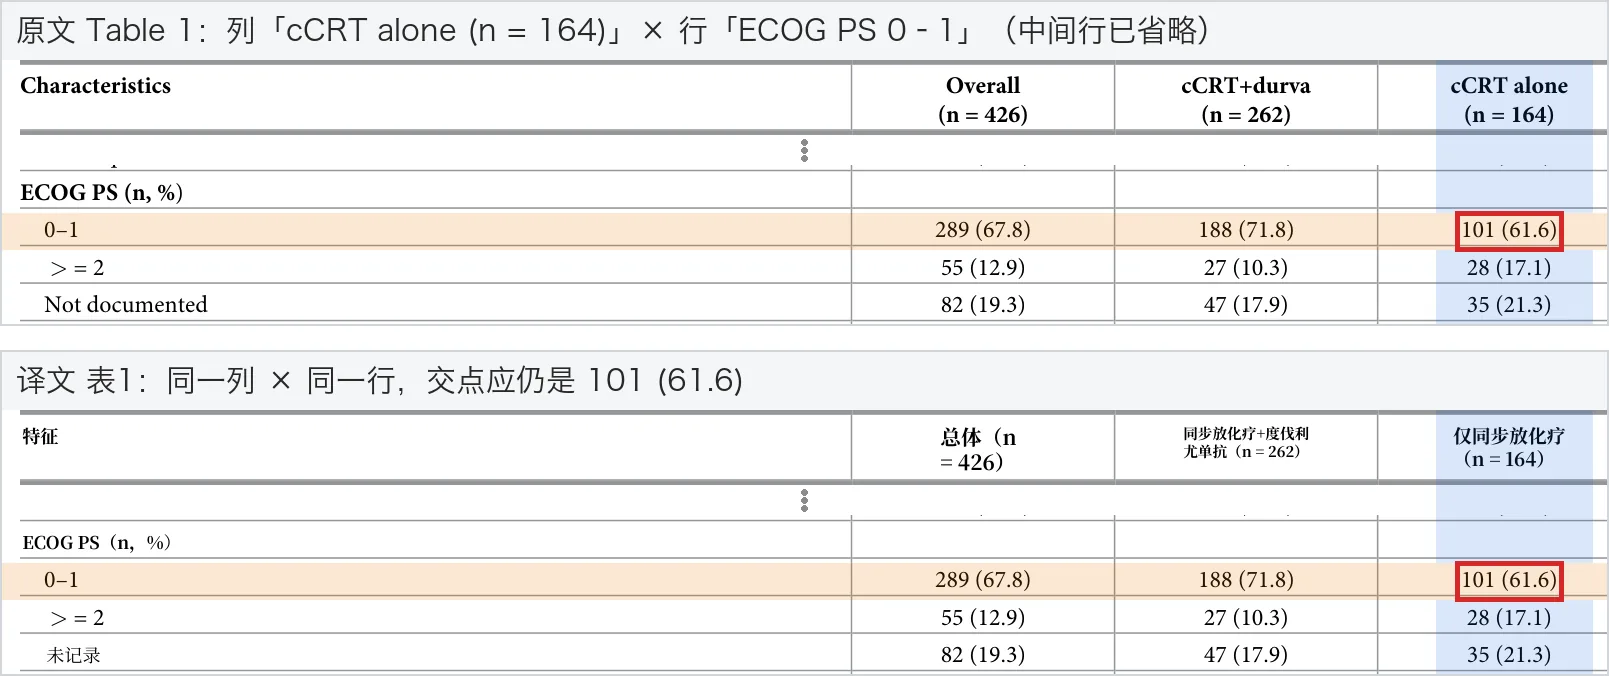
进入结果部分后,先把原文和译文的 Table 1 并排打开。比如在意扣(Equalang)的翻译工作台(Translation workspace)中,可以将左边原文、右边译文并排显示并同步滚动,作为对照式 PDF 阅读的辅助视图。但受中英文字符宽度、字号和换行变化影响,跨列或复杂排版的表格仍需人工复核边界,涉及引用的具体数值必须做“十字定位”核查:
- 锁表头与总样本量(N):先看每列顶部的分组名称和括号里的
N = ...,确认译文列数与原文一致。 - 查缩进与亚组行:比如性别、年龄分层、ECOG 评分或疾病分期,核对缩进子项的百分比加总是否符合逻辑。
- 逐行交叉核对关键数值:用“行名 + 列名”定位到英文原表,逐一核对均值、中位数、括号内的百分比或区间范围,确认没有因单元格换行而发生列位错移。
第三步:建立“首次定义 + 表注”缩写核查表
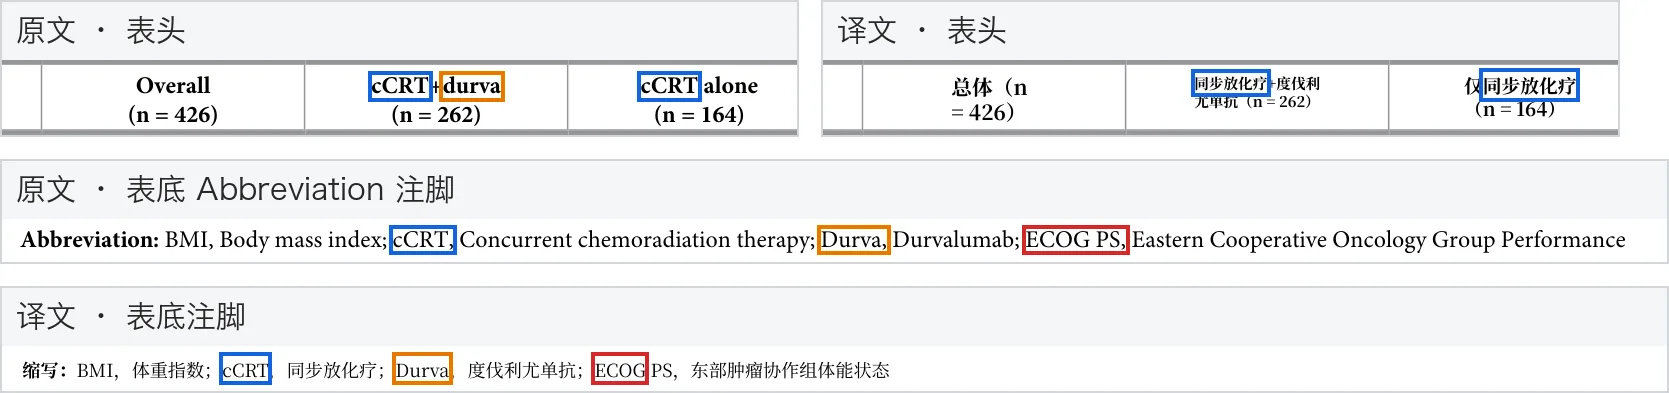
医学论文中的缩写通常出现在两个地方:正文首次提及时的括号全称,以及表格下方的 Abbreviations 注脚。阅读译稿时:
- 查首次出现位置:遇到核心干预手段、终点指标或生物标志物缩写时,先回看正文首次提及处括号里的英文全称,确认译名符合所在专科的规范用法。
- 查表格下方小字注脚:临床基线表底部的缩写说明往往字号很小,且同一缩写在不同科室或研究设计中可能代表完全不同的含义。如果只看表内缩写字母而不核对表底
Abbreviations注脚,很容易与其他领域的同名缩写混淆。
第四步:复核统计指标、公式与显著性表述
在摘录结果数据写综述、做汇报或录入 Meta 分析表格前,必须回到英文原稿逐字核对统计表达式。自动翻译工具不能替代对数学符号、上下标和统计公式的校验,凡涉及计算公式、效应量区间与显著性水准的边界,均需人工逐项复核原稿:
医学论文译稿高频核对清单
为了方便科研团队和医学编辑在日常审读中使用,可以将以下高频风险点作为固定核查表:
实操工作流:用双语对照提升文献处理效率
在课题组文献汇报(Journal Club)或系统评价初筛时,可以把工具与人工复核结合成三步走:
- 生成对照式初读译稿:将英文论文 PDF 上传至意扣(Equalang)等支持文档翻译的工具,生成可供快速扫读的中文初稿,用于梳理研究背景与整体行文脉络。
- 在并排视图中对照通读:利用左原文、右译文的对照式 PDF 阅读视图(或原文与译文交替的对照文件)快速通读引言和讨论,遇到存疑表述时直接视线平移回看左侧英文原句。
- 锁定原文完成数据摘录:凡是要写进论文、标书、审稿意见或汇报幻灯片的 Table 1 基线数字、终点效应量(HR/OR/RR)、95% 置信区间和 P 值,一律以左侧英文原稿的数字和符号为准进行二次复核。
最后需要再次强调:无论是阅读临床试验报告还是基础医学文献,自动化翻译工具的作用仅限于降低跨语言检索和初读的门槛。任何工具输出都不能替代医学生、科研人员、医学编辑和临床研究团队的专业学术判断,更不能直接用于临床诊断、治疗方案选择或患者医疗建议。
参考资料
- EQUATOR Network: Enhancing the QUAlity and Transparency Of health Research — Reporting Guidelines: https://www.equator-network.org/reporting-guidelines/
- 意扣(Equalang)文档翻译与说明:https://equalang.com/documents
- 文中配图使用的示例论文:Arunachalam A. 等,Real-world treatment patterns and outcomes among unresectable stage III non-small cell lung cancer,PLOS ONE,2024,CC BY 4.0,配图用的是其中第 5–7 页的摘录:https://doi.org/10.1371/journal.pone.0314156