PDFMathTranslate、
 意扣 Equalang
导读
从部署门槛、输入输出、公式与复杂表格排版、批处理能力及人工复核成本五个维度,对比开源本地工具 PDFMathTranslate、BabelDOC 与云端工具意扣(Equalang)的适用场景与边界。
关键词:PDFMathTranslate, BabelDOC, Equalang, 意扣, 学术PDF翻译, 开源PDF翻译, 论文翻译工具对比
处理英文学术 PDF 时,选择本地开源工具还是云端文档翻译服务,核心取决于两个变量:你是否愿意维护本地运行环境与大模型 API,以及文档是否允许上传到云端处理。
先给结论:
- 选 PDFMathTranslate:你有 Python 环境或 Docker 使用经验,手头已有可用的翻译服务或大模型 API Key,主要需求是在本地批量生成双语对照或单语学术 PDF,且希望数据留在本地或可控接口中。
- 选 BabelDOC:你关注文档解析与版面还原的开源实现,希望把 PDF 翻译或版面处理能力集成进自己的自动化脚本、内部工具链,或者作为开源组件与 PDFMathTranslate 等生态配合使用。
- 选意扣(Equalang):你不想配置 Python、Docker 或管理第三方 API 额度,手头有包含双栏、合并单元格、多行表头等复杂排版的学术或技术 PDF,希望打开网页直接上传处理,并且文档不涉及禁止上云的涉密内容。
下面从部署门槛、版面与公式表格处理、批处理工作流以及复核成本四个方面展开对比,帮你按手头的具体文档做决定。
一、三类工具的定位与工作流差异
虽然三者都能处理含公式和双栏排版的学术 PDF,但它们在工具链中的位置不同:
- PDFMathTranslate:面向终端用户与开发者的开源学术 PDF 翻译工具。支持命令行(CLI)、图形界面(GUI)和 Docker 部署,核心工作流是在本地解析 PDF 版面与公式位置,调用用户自己配置的翻译接口,再重排生成译文 PDF 与双语对照 PDF。
- BabelDOC:面向文档结构解析与翻译流程的开源项目。它更侧重底层的 PDF 版面分析、段落与公式识别及文档重建管线,适合需要定制解析流程、排查版面拆解问题或将其嵌入自有工程的开发者。
- 意扣(Equalang):开箱即用的云端文档翻译服务。用户不需要在本地装环境或配置 API,直接上传文档即可获得保留分栏、页眉页脚、图注与段落层级的译文文件,计费与额度通过平台积分管理。
二、核心维度对比表
以下对比基于公开仓库说明与产品当前功能边界整理,不设主观打分:
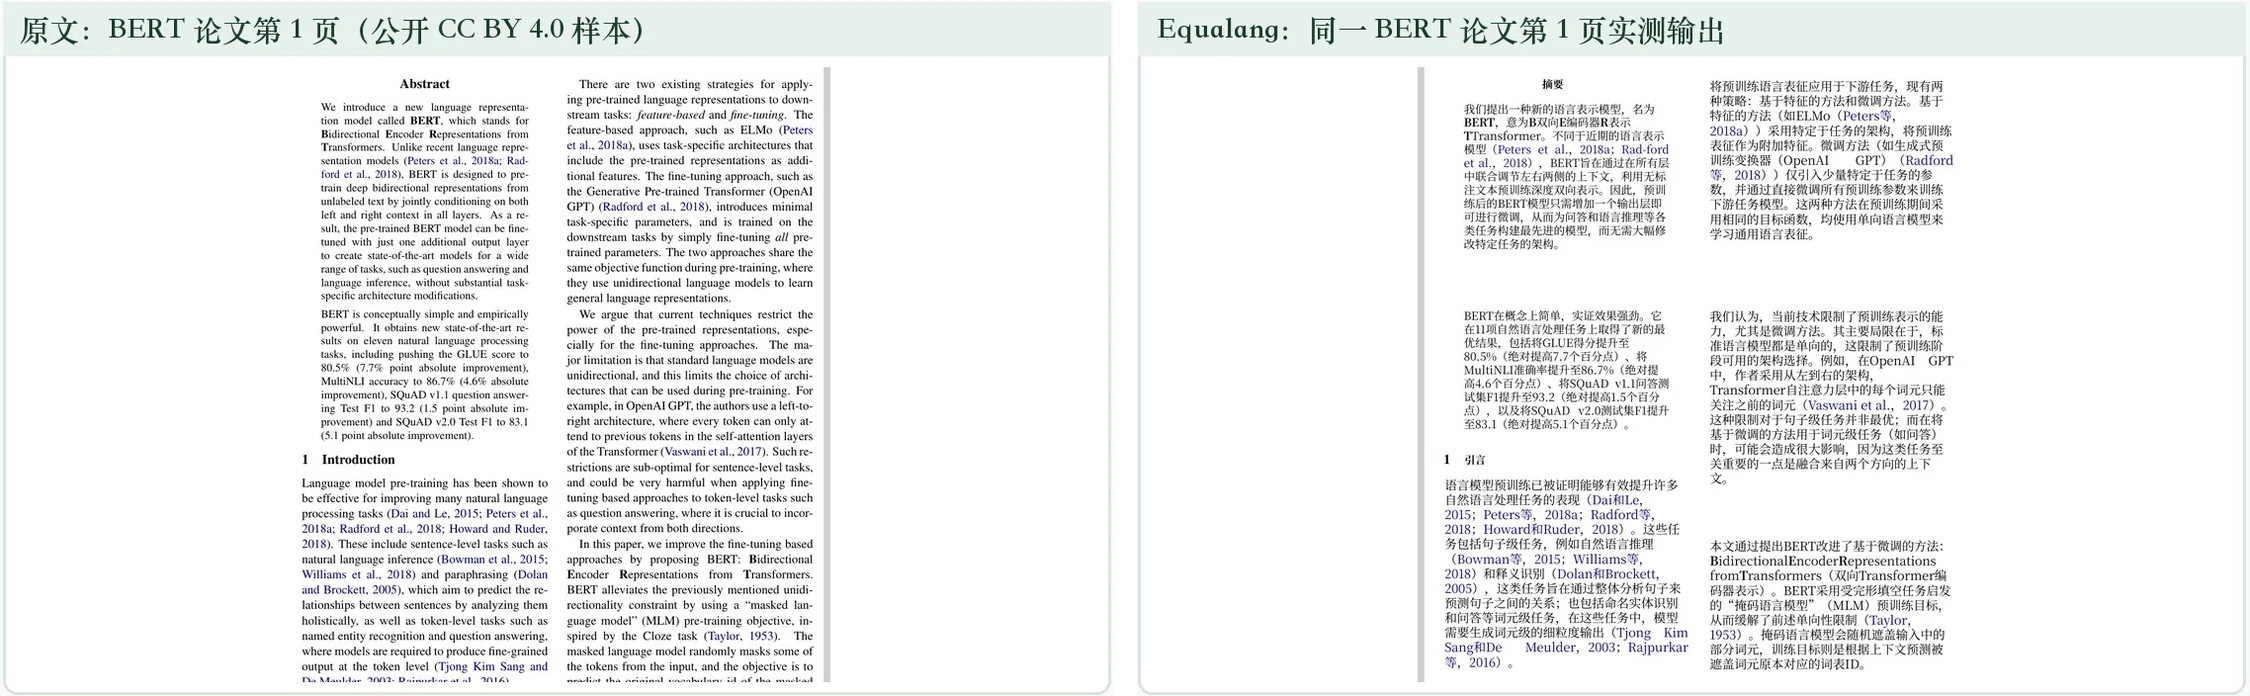
图注:本图仅展示意扣对 BERT 论文第 1 页的处理效果。PDFMathTranslate 和 BabelDOC 的版面效果请读者到各自项目主页查看演示,图不构成三款工具在统一输入下的对比。
三、公式、图注与复杂表格:实际处理中的边界
学术 PDF 最容易翻车的不是正文翻译,而是中英文字符宽度变化引发的版面挤压。英文译为中文后字数通常变少、单字变宽、行高需求不同,三类方案在这里表现出的边界各有侧重。
1. 公式与正文的混排
开源方案(PDFMathTranslate 与 BabelDOC)的核心思路是把公式区域或符号特征锁定,只把周围的自然语言送去翻译,再填回原版面。这种方式能避免翻译接口篡改公式里的变量名,但如果原 PDF 使用了非标准 Type 3 字体、或者公式与上下标是用零散文本框拼出来的,本地解析时可能会把行内变量拆碎。
Equalang 在处理 PDF 时同样致力于保留公式与上下文结构,但必须明确:没有任何自动工具能保证所有公式无损。遇到扫描件转文字图层错位、老旧 LaTeX 模板生成的特殊宏包符号,或者跨行长公式与句号、括号紧贴的情况,云端输出同样可能出现角标偏移或符号粘连。
2. 图注、页眉页脚与复杂表格
很多研究论文除了公式,还包含大量实验数据表。如果表格里带有合并单元格、多行表头或斜线表头,纯靠文本框坐标替换的工具很容易把译文挤出单元格边界,或者把图注(Figure Caption)跟正文的段落层级混在一起。
在这类场景下,Equalang 针对文档结构做了专门处理:除了保留分栏、页眉页脚、图注和段落层级外,会将合并单元格、多行表头与斜线表头按原结构重建,减少因译文长度变化导致的串行问题。而使用本地开源工具时,如果重点看实验数据表,建议开启双语对照输出,方便在译文表格局部拥挤时直接对照上方的原表核对数字。
四、四步决策法:按你的手头任务选工具
如果你现在手头就有一批论文或技术报告要处理,可以按以下四个步骤快速决定用哪套方案:
第一步:检查数据合规与网络条件
- 文档属于未公开专利、内部受控报告,或机构明令禁止上传外部云端:直接排除公有云工具,选择 PDFMathTranslate 或 BabelDOC,并在本地接入合规的内部大模型接口或离线翻译模型。
- 文档是公开预印本(如 arXiv)、已发表期刊论文或普通技术手册:本地与云端方案均可进入下一步筛选。
第二步:评估本地环境与 API 维护意愿
- 不想配环境、没有现成 API Key、或者换了台办公电脑临时要用:选 Equalang。省去拉取镜像、下载模型权重、处理字体缺失和排查 API 限流(Rate Limit)的时间,直接用积分处理当前文档。
- 日常就在用命令行,已有稳定的 OpenAI 兼容接口或翻译源:用 PDFMathTranslate 命令行或 GUI 可以低成本跑通日常阅读流程。
- 需要改写解析逻辑或嵌入内部系统:研究 BabelDOC 的仓库代码与调用方式。
第三步:看文档的版面重心
- 纯理论推导、全文以双栏文字 + 密集标准 LaTeX 公式为主,且希望保留“一页原文一页译文”或“同页双语对照”:PDFMathTranslate 的双语对照模式非常适合快速扫读。
- 文档包含大量实验对比表(多行表头、合并单元格、斜线表头),且要求输出的译文保持原刊的分栏、页眉页脚与图注层级:优先考虑 Equalang,能省掉大量手动调整表格错位的时间。
第四步:预留人工复核时间(无论选哪一种)
无论使用本地开源工具还是云端服务,把机器翻译直接用于汇报、投稿参考或技术落地前,都必须做完以下三项人工复核:
- 核对公式内外的变量指代:检查正文里的“where $x$ denotes...”译成中文后,变量符号是否与独立公式块中的角标、大小写一致。
- 核对表格数值与单位:特别是带有上下标的物理量单位(如 $\text{mg/m}^3$、$10^{-5}$)以及合并单元格对应的行列归属,防止排版重建时发生列偏移。
- 核对跨栏与跨页截断句:双栏学术 PDF 在栏尾或页尾断句时,有时会被解析器切成两段独立句子分别翻译,阅读关键结论段时需对照原 PDF 确认语义连贯。
五、常见组合用法建议
在实际科研与工程工作流中,这三者并不互斥。很多团队与个人研究者会采用“本地初筛 + 云端精排”的组合策略:
- 文献粗筛阶段:用 PDFMathTranslate 配合低成本 API 批量跑完几十篇候选论文,生成双语对照版,快速看懂摘要、方法框图和结论,筛掉不相关的文献。
- 精读与组会分享阶段:针对筛出的 2–3 篇核心论文,或者内部需要跨部门传阅、包含大量复杂数据表与图注的行业报告,交给意扣(Equalang)处理,获得段落层级清晰、复杂表头按原结构重建的译文版本,再花十来分钟重点复核公式与核心数据即可投入使用。
参考资料
- Equalang 文档翻译
- PDFMathTranslate 开源仓库:https://github.com/PDFMathTranslate/PDFMathTranslate
- BabelDOC 开源仓库:https://github.com/funstory-ai/BabelDOC
- BERT 论文公开来源(ACL Anthology):https://aclanthology.org/N19-1423/