Perché i PDF perdono la formattazione quando li traduci
 Equalang
In breve
La maggior parte dei PDF non indica quali parole formano un paragrafo o una tabella. Con due paper ti mostriamo cosa si rompe e cosa controllare.
Parole chiave: tradurre PDF; traduzione documenti; formattazione PDF; mantenere l’impaginazione; articoli scientifici
Un file Word registra quali parole formano un paragrafo e quali appartengono a una tabella. La maggior parte dei PDF non lo fa. Conservano soltanto le lettere e le coordinate in cui disegnarle: paragrafi, tabelle e frasi li ricompone l’occhio di chi legge. Alcuni PDF hanno tag di accessibilità (aggiunti per i lettori di schermo) che segnano paragrafi e tabelle, ma molti non li hanno (i due paper che usiamo come esempio più avanti non ne hanno nessuno), quindi uno strumento di traduzione non può contarci. Tutto ciò che vedi come struttura (un’impaginazione a due colonne, un’intestazione che si estende su più colonne, una frase che continua nella pagina seguente) va ricostruito prima di tradurre. Poi il testo tradotto, ora più lungo o più corto, deve rientrare nell’impaginazione originale. La formattazione si perde in uno di questi due passaggi.
Cosa conviene fare dipende da ciò che hai:
- Il file .docx o .pptx originale: traduci quello invece del PDF.
- Un PDF di solo testo, con poche tabelle, sotto i 10 MB: il caricamento gratuito di documenti di Google Traduttore è la soluzione più rapida da provare.
- Un paper, un manuale o un report con tabelle, equazioni o due colonne: usa uno strumento di traduzione che ricostruisce l’impaginazione, poi controlla i quattro punti della sezione 3.
- Una scansione (in cui non riesci a selezionare il testo): richiede il riconoscimento del testo (OCR) prima di poter essere tradotta. DeepL accetta le scansioni e gestisce questo passaggio da sé. Google Traduttore lascia le pagine scansionate senza traduzione.
1. Cosa vede davvero uno strumento di traduzione in un PDF?
Costruiamo uno strumento di traduzione di documenti, quindi passiamo molto tempo a guardare cosa esce dai PDF. Per mostrarlo chiaramente, abbiamo preso due paper sui modelli linguistici di IA da arXiv, LLaMA e Mistral 7B, e ne abbiamo estratto il testo con mutool di MuPDF, un diffuso strumento PDF open source. Questo testo è più o meno ciò con cui lavora uno strumento, se non legge anche l’impaginazione. Di seguito, ogni passaggio è mostrato prima come appare nella pagina e poi come esce (una riga con solo … significa che abbiamo saltato delle righe).
1.1 Le tabelle diventano un elenco di numeri
La tabella 3 del paper LLaMA confronta dieci modelli su otto test:
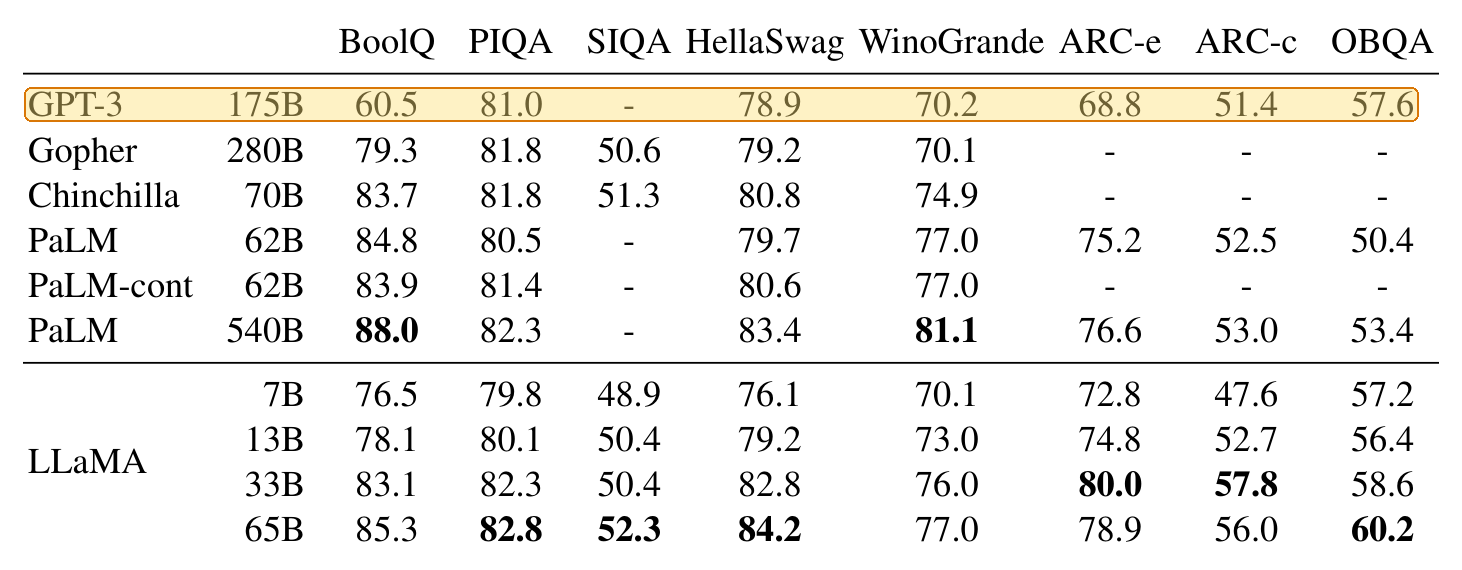
Una volta estratta, conta 102 righe: un’intestazione di cinque righe, poi un valore per riga. Queste sono le prime 16; le dieci da GPT-3 a 57.6 sono la riga evidenziata.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Nello strumento di traduzione non c’è nulla che indichi a quale test appartiene ogni numero. Se incolli tutto questo in un riquadro di traduzione, ottieni indietro lo stesso elenco. Le parole sono tradotte, ma la tabella è sparita.
1.2 Una frase, con una tabella intera dentro
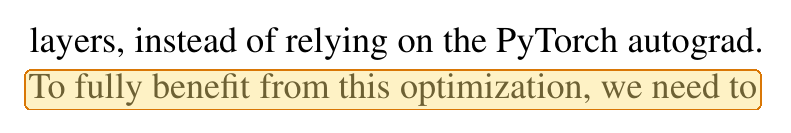
L’ultima frase a pagina 3 del paper LLaMA si ferma a "we need to":
Riprende nella colonna sinistra di pagina 4, subito sotto la tabella 3:
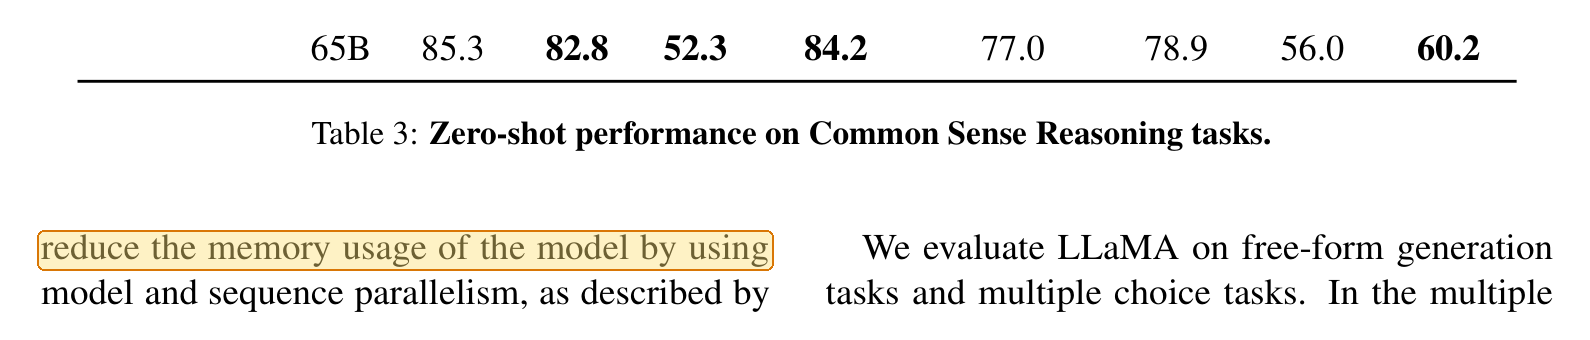
Nel testo estratto, una nota a piè di pagina, il cambio pagina, tutte le 102 righe della tabella e la sua didascalia finiscono dentro quell’unica frase:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Succede di nuovo due pagine dopo. Pagina 5 termina con "…the textual description and tests in a", e "docstring." arriva soltanto dopo la tabella 7 di pagina 6, con in mezzo le 44 righe della tabella e la sua didascalia di sette righe.
Uno strumento che traduce pagina per pagina, o che segue il testo in questo ordine preciso, ottiene due frammenti senza alcun motivo per collegarli. Nel file tradotto vedrai una frase che si spegne in fondo a una pagina, e l’altra metà che ricompare da qualche parte sotto una tabella.
1.3 Pedici e frazioni diventano qualcos’altro
Nel paper Mistral una variabile è scritta h con pedice i:
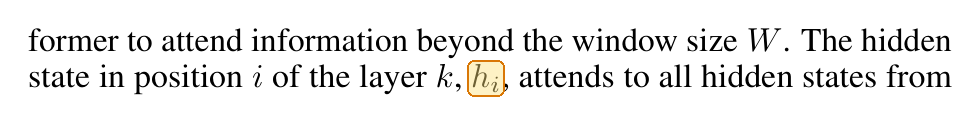
Con l’estrazione il pedice scompare e resta hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Uno strumento di traduzione non ha motivo di trattarlo come una variabile. Per lui hi è semplicemente una parola comune dell’inglese.
Le frazioni se la passano peggio. LLaMA imposta un valore a due terzi di 4d, scritto ⅔·4d, con il ⅔ composto da un 2 piccolo sopra un 3:
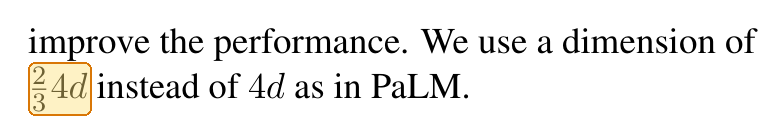
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Due terzi di 4d sono diventati 34d. Apici, frazioni e simboli dei font matematici sono solo forme collocate in posizioni particolari. Il testo estratto conserva le forme, ma perde le posizioni.
1.4 Le parole vengono spezzate a fine riga
I paper a due colonne spezzano molte parole a fine riga. In LLaMA, 242 righe interrompono una parola normale in minuscolo con un trattino. Rimetterle insieme sembra facile, finché non si arriva a un trattino che fa parte di un nome:
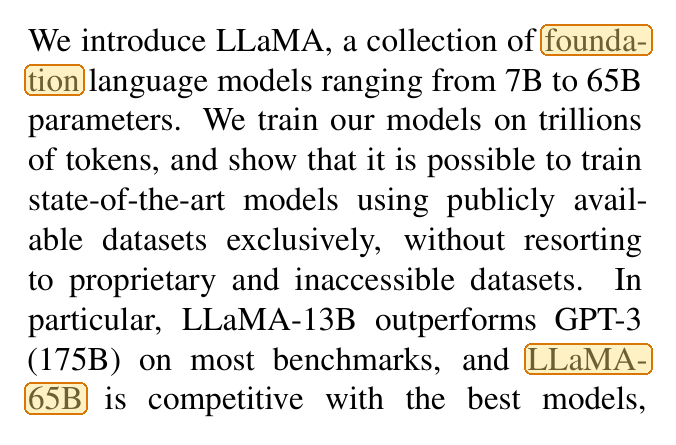
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- e tion formano una sola parola senza il trattino. Ma in LLaMA- e 65B il trattino fa parte del nome del modello e deve restare.
Abbiamo usato un solo strumento di estrazione, su due paper realizzati con LaTeX, un sistema di composizione tipografica diffuso nell’editoria accademica. I PDF esportati da Word, i documenti scansionati e altri strumenti di estrazione possono dare risultati diversi, ma questi sono i quattro tipi di danno da cercare.
2. Quali opzioni hai?
Le informazioni su Google Traduttore e DeepL provengono dalle rispettive pagine di aiuto, consultate il 7 ottobre 2026. Quando una traduzione di PDF delude, il consiglio di DeepL è di caricare il documento originale. Coincide con il nostro.
L’ultima riga è esattamente ciò per cui è stata costruita la traduzione documenti di Equalang, quindi è l’approccio che conosciamo meglio. Prima di tradurre, Equalang ricompone le frasi che un’interruzione di pagina ha spezzato in due. Le tabelle con celle unite e intestazioni su più righe vengono ricostruite nella loro struttura originale, invece di essere appiattite in un unico elenco. Le equazioni non vengono buttate via come testo illeggibile, ed è disponibile un’opzione di ottimizzazione delle formule per quelle difficili che si trovano dentro una riga di testo.
Ciò che non fa è riprodurre l’originale in modo identico. Una traduzione più lunga dell’originale sposta le interruzioni di riga e le dimensioni dei caratteri, quindi le pagine con un’impaginazione fitta meritano ancora un controllo. La traduzione documenti attualmente copre cinese, inglese, giapponese, coreano, spagnolo, francese e altre lingue.
3. Cosa controllare una volta tradotto il PDF?
- Tabelle. Le intestazioni sono ancora sopra la colonna giusta? I numeri sono rimasti uguali?
- Interruzioni di pagina e testo sotto ogni tabella. Leggi l’ultima riga di ogni pagina e la frase subito dopo ogni tabella. Una frase che si interrompe e non finisce mai è il segnale più comune che il testo è stato tradotto a pezzi.
- Equazioni e variabili. Controllane alcune che si trovano dentro una riga di testo. Cerca lettere diventate parole e frazioni diventate altri numeri.
- Numero di pagine e link. Un numero di pagine molto diverso significa che del testo è andato perso o è finito su pagine in più. Fai clic su una o due voci dell’indice per vedere se funzionano.
Fonti
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Guida di Google Traduttore, Translate documents & websites, consultata il 7 ottobre 2026.
- Centro assistenza DeepL, Translate PDF files, consultato il 7 ottobre 2026.
- Metodo: testo estratto il 7 ottobre 2026 con MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Le figure sono ritagli delle pagine dei paper; le evidenziazioni sono nostre.