PDF traducidos: por qué pierden el formato y cómo evitarlo
 Equalang
En breve
La mayoría de los PDF no marcan qué palabras forman un párrafo o una tabla. Con dos artículos te mostramos qué falla y qué revisar después.
Palabras clave: traducir PDF; traducción de documentos; formato del PDF; conservar el diseño; artículos científicos
Un archivo de Word registra qué palabras forman un párrafo y cuáles pertenecen a una tabla. La mayoría de los PDF no lo hace. Solo guardan las letras y las coordenadas donde dibujarlas; los párrafos, las tablas y las oraciones los arma el ojo de quien lee. Algunos PDF llevan etiquetas de accesibilidad (añadidas para los lectores de pantalla) que marcan párrafos y tablas, pero muchos no las tienen (los dos artículos que usamos como ejemplo más abajo no tienen ninguna), así que una herramienta de traducción no puede contar con ellas. Todo lo que ves como estructura (un diseño a dos columnas, un encabezado que abarca varias columnas o una oración que continúa en la página siguiente) hay que reconstruirlo antes de traducir. Después, el texto traducido, ahora más largo o más corto, tiene que volver a encajar en el diseño original. El formato se pierde en uno de esos dos pasos.
Lo que conviene hacer depende de lo que tengas:
- El .docx o .pptx original: traduce ese archivo en lugar del PDF.
- Un PDF de texto simple, con pocas tablas, de menos de 10 MB: la subida gratuita de documentos de Google Traductor es lo más rápido que puedes probar.
- Un artículo, un manual o un informe con tablas, ecuaciones o dos columnas: usa una herramienta de traducción que reconstruya el diseño y revisa después los cuatro puntos de la sección 3.
- Un escaneo (donde no puedes seleccionar el texto): necesita reconocimiento de texto (OCR) antes de poder traducirse. DeepL acepta escaneos y se encarga de ese paso. Google Traductor deja las páginas escaneadas sin traducir.
1. ¿Qué ve realmente una herramienta de traducción en un PDF?
Creamos una herramienta de traducción de documentos, así que pasamos mucho tiempo mirando lo que sale de los PDF. Para mostrarlo con claridad, tomamos dos artículos sobre modelos de lenguaje de IA de arXiv, LLaMA y Mistral 7B, y extrajimos su texto con mutool, de MuPDF, una herramienta de PDF de código abierto muy usada. Ese texto es, más o menos, lo que una herramienta usa como materia prima si no lee también el diseño. Abajo, cada pasaje aparece primero tal como se ve en la página y luego tal como sale (una línea con solo … significa que nos saltamos algunas líneas).
1.1 Las tablas se convierten en una lista de números
La tabla 3 del artículo de LLaMA compara diez modelos en ocho pruebas:
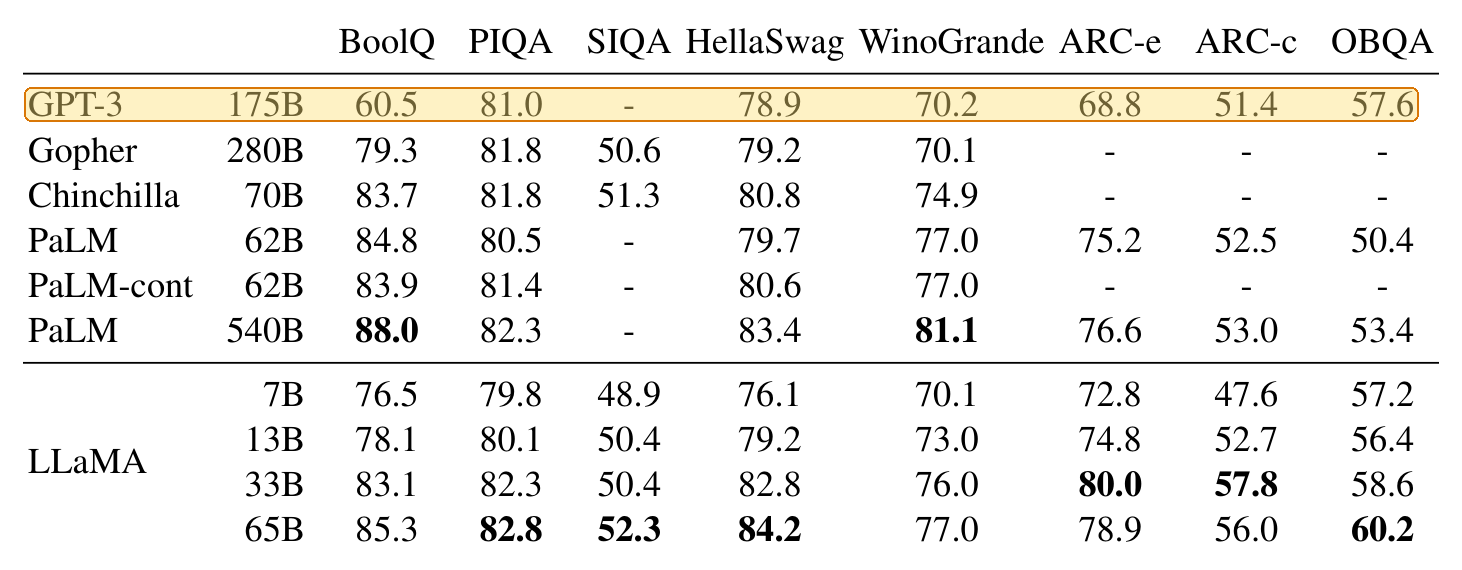
Extraída, son 102 líneas: cinco líneas de encabezado y, después, un valor por línea. Estas son las primeras 16; las diez que van de GPT-3 a 57.6 son la fila resaltada.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Nada le indica a la herramienta de traducción qué número corresponde a qué prueba. Si pegas eso en un recuadro de traducción, obtienes la misma lista de vuelta. Las palabras están traducidas, pero la tabla ha desaparecido.
1.2 Una oración, con una tabla entera dentro
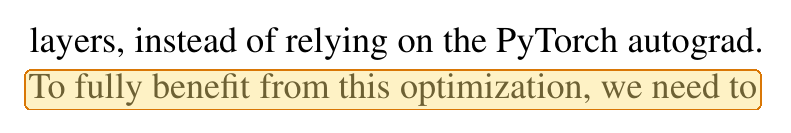
La última oración de la página 3 del artículo de LLaMA se detiene en "we need to":
Continúa en la columna izquierda de la página 4, justo debajo de la tabla 3:
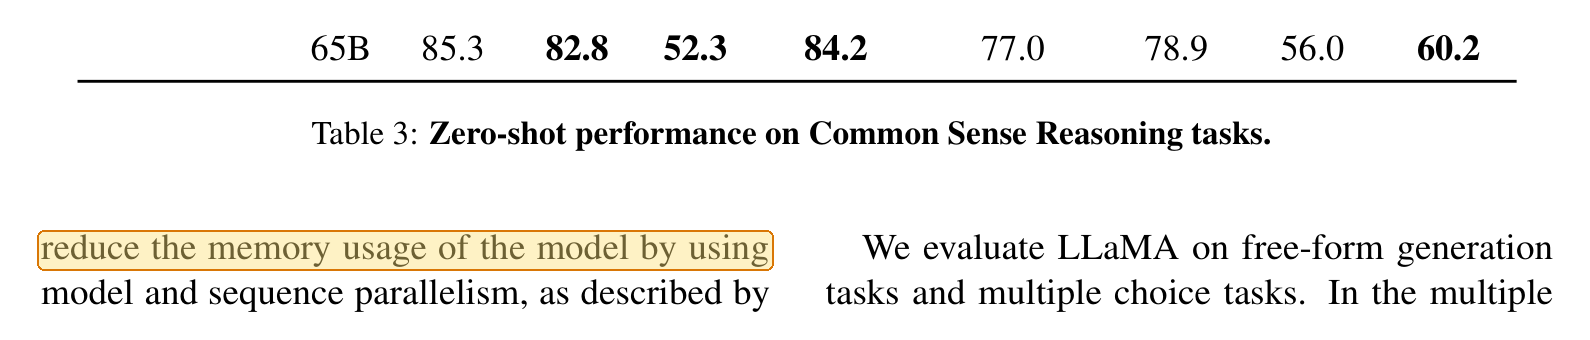
En el texto extraído, una nota al pie, el salto de página, las 102 líneas de la tabla y su título quedan dentro de esa única oración:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Vuelve a pasar dos páginas más adelante. La página 5 termina en "…the textual description and tests in a", y "docstring." aparece solo después de la tabla 7 de la página 6, con las 44 líneas de la tabla y su título de siete líneas en medio.
Una herramienta que traduce página por página, o que sigue el texto en ese orden exacto, recibe dos fragmentos sin motivo para conectarlos. En el archivo traducido verás una oración que se apaga al final de una página, y su otra mitad aparece en algún lugar debajo de una tabla.
1.3 Los subíndices y las fracciones se convierten en otra cosa
En el artículo de Mistral, una variable se escribe h con un subíndice i:
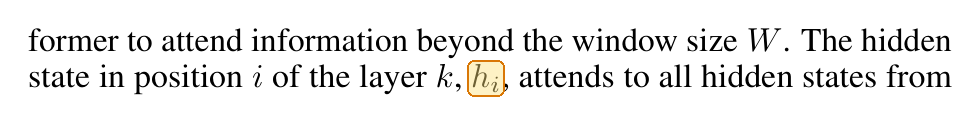
Al extraerlo, el subíndice desaparece y queda hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Una herramienta de traducción no tiene motivos para tratar eso como una variable. Para ella, hi es simplemente una palabra común del inglés.
Las fracciones salen peor paradas. LLaMA fija un valor en dos tercios de 4d, escrito ⅔·4d, con el ⅔ compuesto por un 2 pequeño sobre un 3:
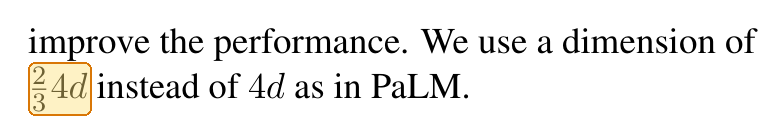
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Dos tercios de 4d se han convertido en 34d. Los superíndices, las fracciones y los símbolos de las fuentes matemáticas son solo formas colocadas en posiciones concretas. El texto extraído conserva las formas, pero pierde las posiciones.
1.4 Las palabras se parten al final de la línea
Los artículos a dos columnas separan muchas palabras al final de la línea. En LLaMA, 242 líneas parten una palabra normal en minúsculas con un guion. Volver a unirlas parece fácil hasta que llegas a un guion que forma parte de un nombre:
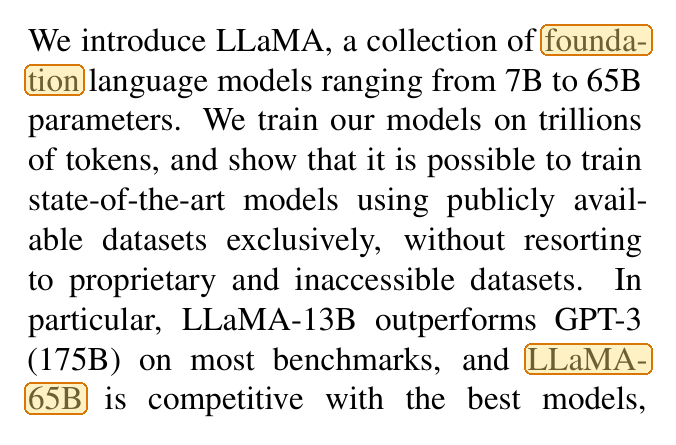
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- y tion forman una sola palabra sin el guion. Pero en LLaMA- y 65B, el guion forma parte del nombre del modelo y debe quedarse.
Probamos una sola herramienta de extracción, con dos artículos hechos en LaTeX, un sistema de composición habitual en la publicación académica. Los PDF exportados desde Word, los documentos escaneados y otras herramientas de extracción pueden dar resultados distintos, pero estos son los cuatro tipos de daño que hay que buscar.
2. ¿Qué opciones tienes?
Los datos de Google Traductor y DeepL vienen de sus propias páginas de ayuda, consultadas el 7 de octubre de 2026. Cuando una traducción de PDF decepciona, el consejo de DeepL es subir el documento original en su lugar. Coincide con el nuestro.
La última fila es justo lo que la traducción de documentos de Equalang está hecha para hacer, así que es el enfoque que mejor conocemos. Antes de traducir, Equalang recompone las oraciones que un salto de página partió en dos. Reconstruye las tablas con celdas combinadas y encabezados de varias filas respetando su estructura original, en lugar de aplanarlas en una única lista. Las ecuaciones no se descartan como texto ilegible, y hay una opción de optimización de fórmulas para las difíciles que van dentro de una línea de texto.
Lo que no hace es reproducir el original exactamente igual. Una traducción más larga que el original desplaza los saltos de línea y los tamaños de letra, por lo que las páginas con un diseño apretado siguen mereciendo una revisión. La traducción de documentos cubre actualmente chino, inglés, japonés, coreano, español, francés y otros idiomas.
3. ¿Qué revisar una vez traducido el PDF?
- Tablas. ¿Siguen los encabezados sobre la columna correcta? ¿Los números siguen igual?
- Los saltos de página y el texto debajo de cada tabla. Lee la última línea de cada página y la oración justo después de cada tabla. Una oración que se detiene y nunca termina es la señal más común de que el texto se tradujo por partes.
- Ecuaciones y variables. Revisa algunas de las que están dentro de una línea de texto. Busca letras convertidas en palabras y fracciones convertidas en otros números.
- El número de páginas y los enlaces. Un número de páginas muy distinto significa que se perdió texto o que se derramó en páginas de más. Haz clic en una o dos entradas del índice para ver si funcionan.
Fuentes
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Ayuda de Google Traductor, Translate documents & websites, consultada el 7 de octubre de 2026.
- Centro de ayuda de DeepL, Translate PDF files, consultado el 7 de octubre de 2026.
- Método: texto extraído el 7 de octubre de 2026 con MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Las imágenes son recortes de las páginas de los artículos; los resaltados son nuestros.