¿Fórmulas rotas al traducir artículos de arXiv? Herramientas recomendadas para leer literatura científica
 Equalang
En breve
¿La traducción automática descompone tus fórmulas LaTeX y divide frases en PDFs a doble columna? Analizamos los retos técnicos y mostramos una solución para leer con maquetación intacta y comparación en paralelo entre el original y la traducción.
Palabras clave: traducción de artículos de arXiv; herramientas de traducción académica; maquetación PDF a dos columnas; traducción de fórmulas matemáticas LaTeX; lectura bilingüe paralela
Al seguir los últimos preprints de arXiv o revisar las listas de artículos aceptados en conferencias destacadas, muchos investigadores y estudiantes de posgrado se topan con un obstáculo recurrente: al copiar y pegar fragmentos de texto desde un PDF académico a dos columnas en una ventana de traducción convencional, las fórmulas matemáticas en LaTeX, subíndices, superíndices y sumatorios se convierten de inmediato en caracteres inconexos; los guiones de partición de palabras (hyphenation) entre columnas o saltos de página cortan términos y generan oraciones incoherentes; y, al terminar una página, las referencias a figuras, tablas y la lógica deductiva quedan desordenadas, consumiendo tiempo y concentración al alternar pantallas para ubicar cada elemento.
El principal obstáculo para comprender la literatura científica de vanguardia rara vez es el dominio del vocabulario técnico en inglés; más bien, radica en que las fórmulas se transforman en texto ilegible, la maquetación a dos columnas se desmorona y resulta difícil alinear el original con la traducción, interrumpiendo el flujo de concentración analítica.
En este artículo analizamos los criterios clave para elegir herramientas de traducción académica, comparamos el alcance de las alternativas de código abierto frente a las soluciones comerciales y mostramos un flujo de trabajo para leer en profundidad conservando intactas las fórmulas y la maquetación a dos columnas.
1. ¿Por qué los artículos académicos son un desafío para la traducción automática?
Las herramientas de traducción convencionales (como extensiones de selección de texto o cuadros de entrada estándar) manejan con soltura textos continuos, pero muestran claras limitaciones frente a un PDF académico. Esto se debe principalmente a tres retos técnicos propios de las publicaciones científicas:
- Fórmulas matemáticas en LaTeX y símbolos especiales intercalados: El texto académico incluye constantes variables en línea (como $\theta_i, \mathbf{W}_Q$), subíndices, superíndices, fracciones complejas y ecuaciones tensoriales independientes. Los motores de traducción genéricos carecen de análisis sintáctico del árbol de maquetación, por lo que suelen interpretar variables matemáticas como palabras comunes en inglés, fragmentar expresiones como $\sqrt{d_k}$ y desarticular la derivación matemática.
- Maquetación a dos columnas y saltos de página físicos: El formato PDF está compuesto por instrucciones de dibujo orientadas a la impresión y carece de un flujo lógico de párrafos nativo. Los diseños a doble columna provocan lecturas transversales erróneas en herramientas básicas; asimismo, las oraciones subordinadas largas que quedan cortadas al pie de página se traducen de forma aislada, generando errores de sentido graves.
- Pérdida de numeración de figuras, tablas y referencias cruzadas: Los diagramas de arquitectura (Figure), las tablas de experimentos de ablación (Table) y las referencias dentro del texto a ecuaciones específicas (por ejemplo, Equation 3) suelen desalinearse o perderse durante la extracción de texto sin formato, rompiendo el hilo argumental.
Por tanto, una solución adecuada para la traducción de literatura científica debe incorporar tres capacidades fundamentales: análisis estructural de la maquetación del PDF, preservación en su posición de las fórmulas LaTeX y visualización paralela entre el texto original y la traducción.
2. Comparativa de las principales soluciones de traducción académica
En el trabajo diario de investigación, las soluciones más habituales se dividen en tres categorías principales, cada una con ventajas y límites claros:
Para situaciones donde se requiere precisión en fórmulas, maquetación ordenada y un uso directo sin configuraciones complejas, mostramos el proceso paso a paso utilizando Equalang, la plataforma desarrollada por nuestro equipo.
3. Flujo de trabajo en tres pasos para una lectura paralela a doble columna
Para lograr una lectura fluida, puedes colocar el original y la traducción generada lado a lado en paralelo para compararlos, logrando una lectura en profundidad inmersiva.
Paso 1: Procesar el documento completo con optimización de fórmulas activada
Sube el archivo PDF original descargado de arXiv en la sección de traducción de documentos en la plataforma web de Equalang. En artículos de ingeniería, informática o física con alta densidad de expresiones matemáticas, el sistema prioriza la protección de variables en línea y ecuaciones independientes durante la fase de análisis estructural.
En cuanto a las frases largas cortadas al final de una página, el sistema las reconstruye en el nivel lógico del párrafo antes de traducirlas, garantizando la coherencia contextual y evitando rupturas abruptas entre páginas continuas.
Paso 2: Verificar la fidelidad de las fórmulas complejas y símbolos especiales
Una vez concluida la traducción, el documento resultante conserva el ancho de las dos columnas del artículo original, la jerarquía de títulos de sección, las figuras originales y la ubicación de las leyendas.
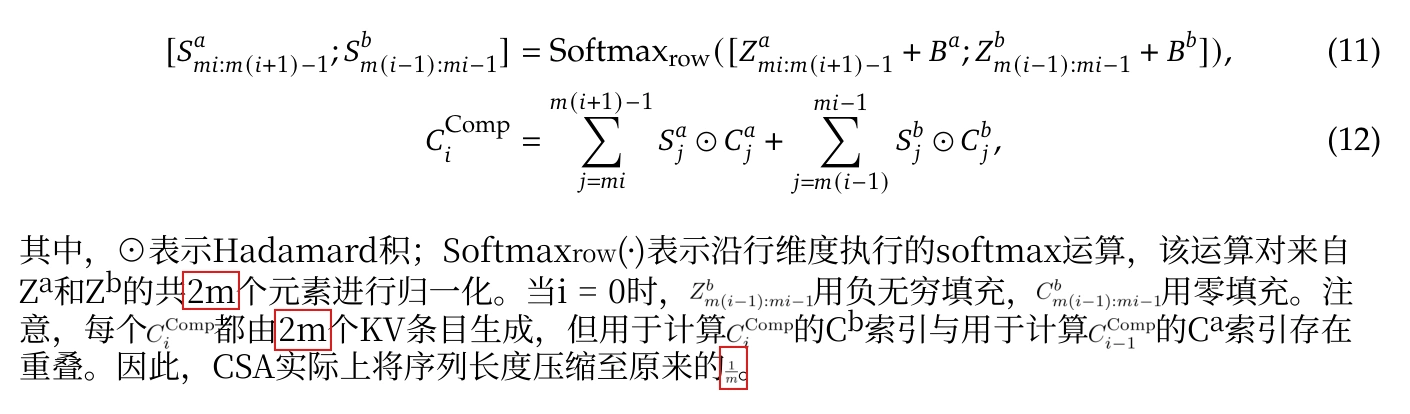
Al procesar deducciones rigurosas, como las del artículo de DeepSeek-V4, la imagen superior ilustra el resultado de la maquetación de las fórmulas y la traducción:
- Símbolos en línea no traducidos como texto: Símbolos en línea como 2m o Z^a no se han traducido como texto, aunque el tamaño de fuente de algunas fórmulas en línea se reduce notablemente.
- Ecuaciones independientes y numeración alineada: Las fórmulas CSA (11) y (12) permanecen centradas y conservan intacta la numeración en el margen derecho, facilitando el seguimiento del razonamiento.
Paso 3: Cotejar el original y la traducción en dos ventanas en paralelo
Abre por separado el original en inglés y la traducción al chino descargada en Vista Previa de macOS, Acrobat, PDF Expert o el navegador Edge, y coloca ambas ventanas lado a lado:
- En la ventana izquierda de la pantalla, abre el original en inglés.
- En la ventana derecha de la pantalla, abre la traducción al chino correspondiente y desplázate hasta el mismo número de página.
Una vez realizados los ajustes, la parte izquierda de la pantalla muestra la página $N$ del manuscrito original en inglés y la derecha, la página $N$ correspondiente de la traducción al chino:
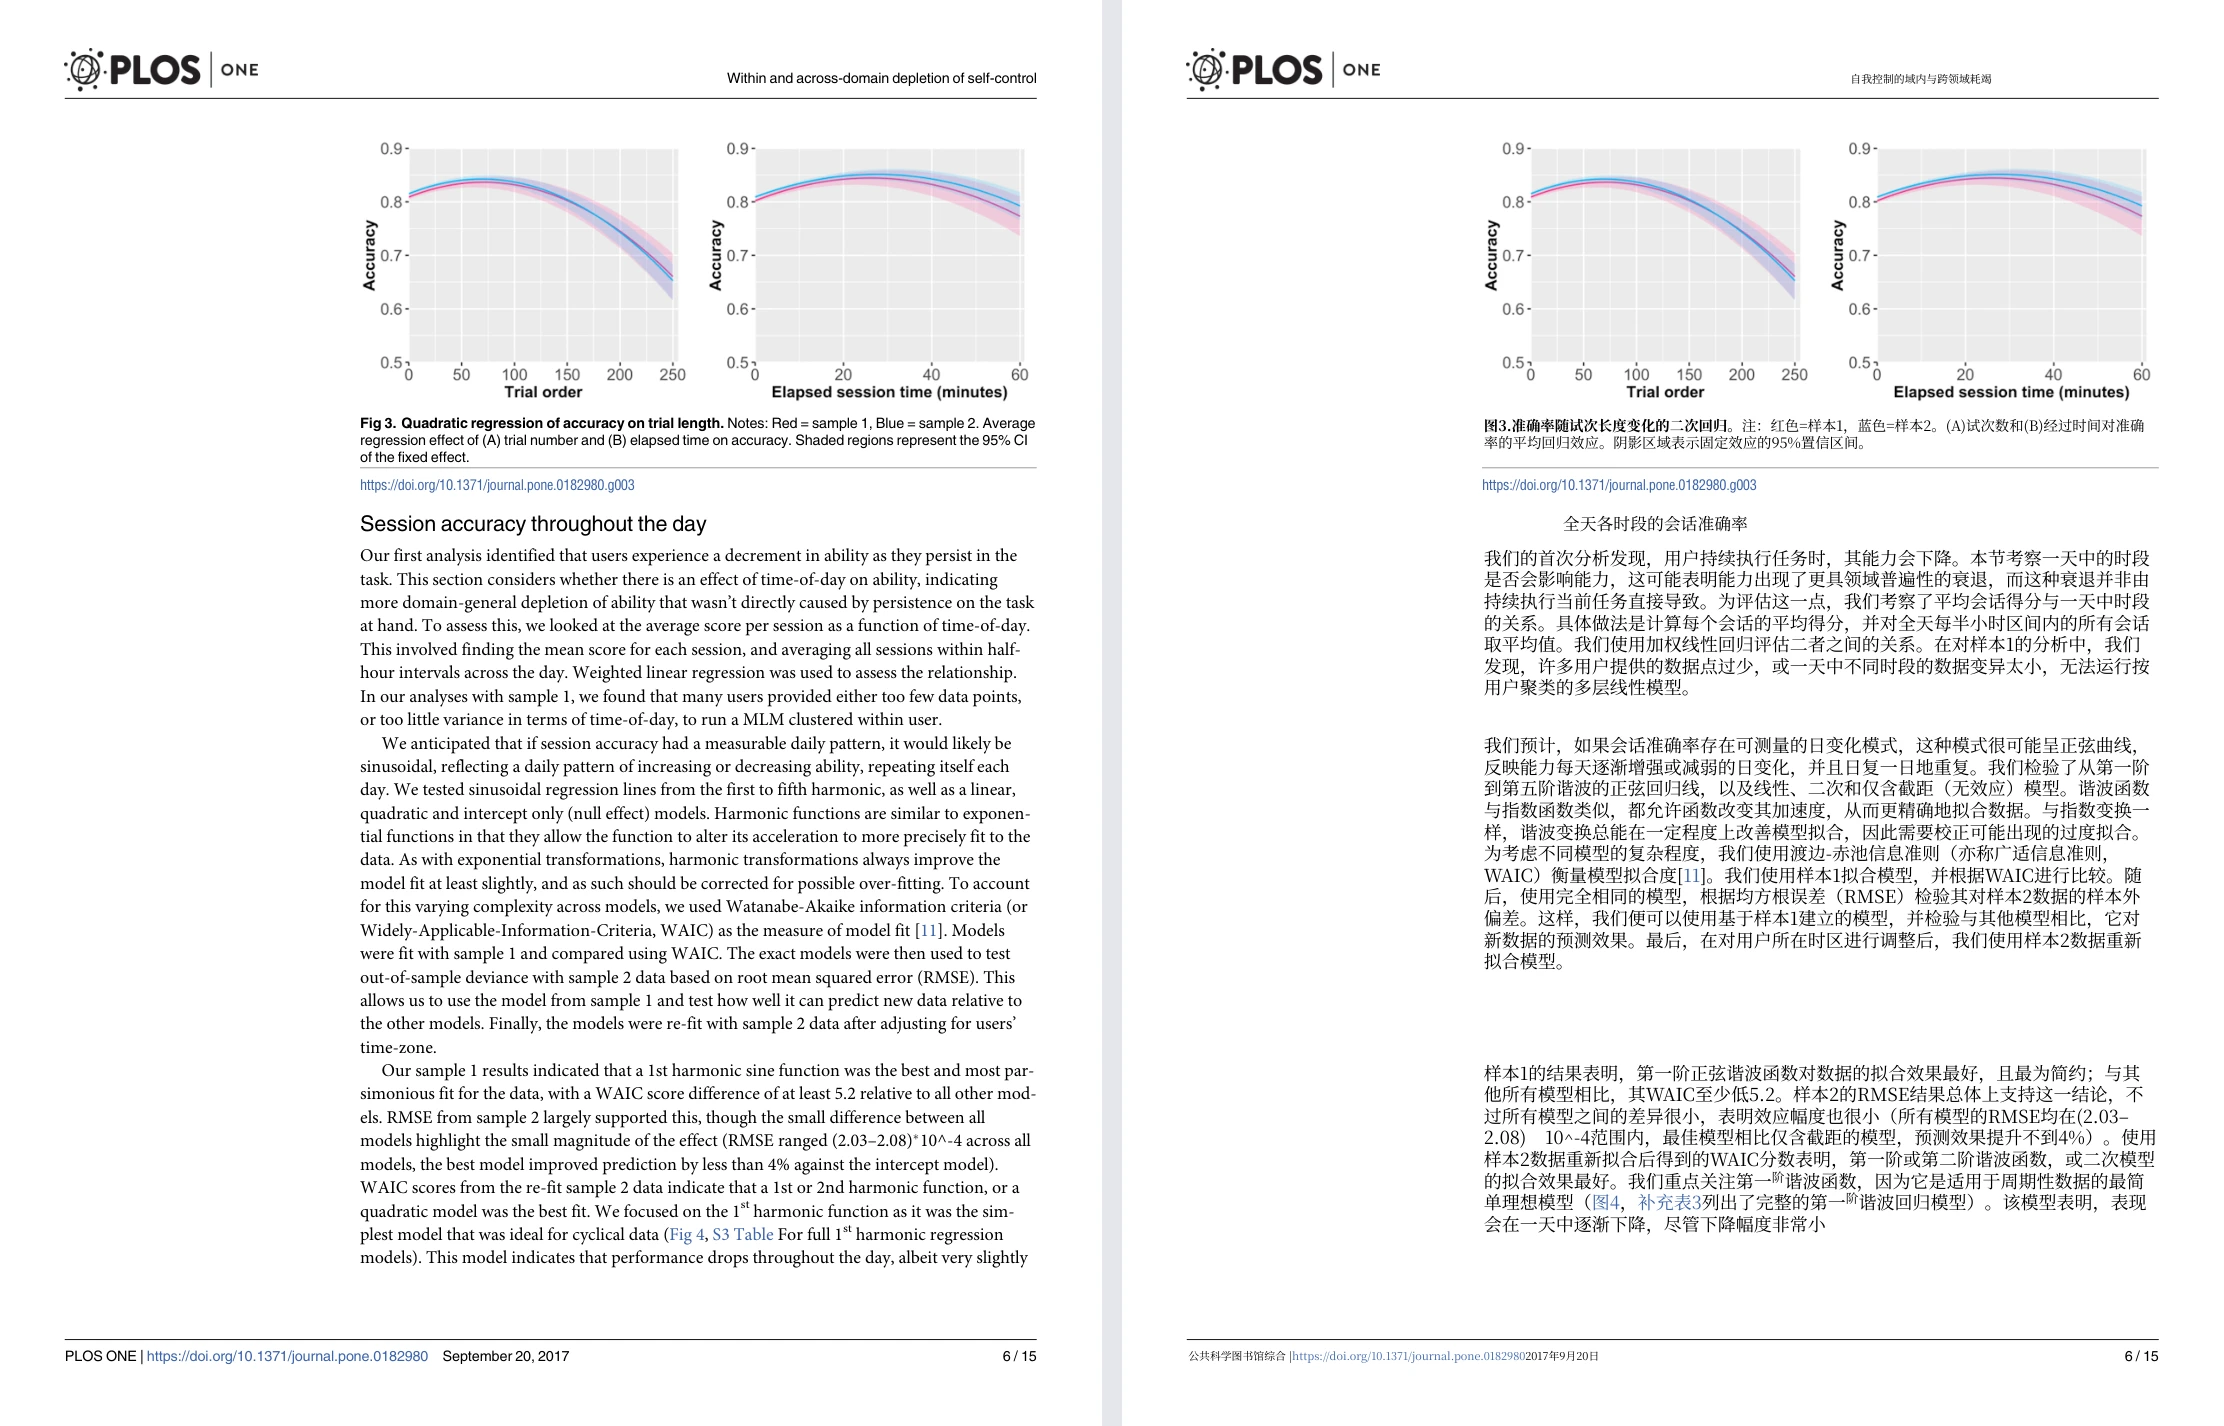
- Al realizar una lectura rápida de las explicaciones, consulta la traducción al chino a la derecha para comprender con agilidad la motivación de la investigación, los argumentos centrales y el diseño experimental;
- Al encontrarte con fórmulas clave, abreviaturas de términos especializados o fragmentos de código complejos, dirige la mirada de forma natural al original en inglés a la izquierda para verificar las definiciones matemáticas originales.
4. Recomendaciones prácticas para la lectura bilingüe de artículos científicos
Al apoyarse en herramientas de traducción para estudiar literatura académica, conviene tener presentes estas buenas prácticas de investigación:
- Verificar las definiciones en el texto original antes de citar: Aunque la traducción automática reduce la barrera idiomática, a la hora de citar formalmente (Citation), verificar demostraciones de teoremas o replicar código, siempre se debe tomar como referencia la formulación rigurosa del artículo en inglés.
- Distinguir entre documentos escaneados y PDFs vectoriales: En publicaciones antiguas escaneadas sin un reconocimiento óptico de caracteres (OCR) de alta fidelidad, la precisión de la maquetación puede verse afectada. Siempre que sea posible, es preferible utilizar los PDFs vectoriales originales provistos por arXiv, IEEE, ACM u otros repositorios oficiales.
- Mantener términos y pseudocódigo en su nomenclatura original: Los nombres de funciones, variables e identificadores de bibliotecas (como llamadas a primitivas de PyTorch o TensorFlow) deben conservarse en inglés para evitar confusiones al implementar los algoritmos.
Fuentes y referencias
- Traducción de documentos en Equalang
- Repositorio abierto de preprints académicos de arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Repositorio del proyecto de traducción académica de código abierto PDFMathTranslate