HTML 帮助文档翻译:
 意扣 Equalang
导读
翻译 HTML 帮助文档时经常遇到标签错位、代码块被意译或链接属性失效的问题。本文基于 DOM 规范梳理文本节点与受保护元素的边界,并提供一套静态页面翻译与验收清单。
关键词:HTML 帮助文档翻译, HTML 文件翻译, DOM 结构保护, 技术文档本地化, 代码块不翻译
把 HTML 格式的帮助中心或 API 文档直接丢进通用文本翻译框,拿回来的结果往往无法直接上线:<code> 里的命令行参数被翻成了中文,<a href="..."> 的相对路径被塞进了全角空格,或者嵌套的 <ul><li> 列表因为缺少闭合标签把整页侧边栏撑垮。
要让译后的 HTML 页面直接可部署,核心原则只有一条:按 DOM(文档对象模型)树处理,只翻译面向读者的文本节点(Text Nodes)和少数可读属性,严格隔离标签名、控制属性与代码元素。
下面直接给出翻译前的节点分层规则、处理步骤,以及发版前的静态页面验收清单。
一、先分清:HTML 里哪些能翻,哪些不能动
根据 WHATWG 的 HTML DOM 规范,一份 HTML 文档是由元素节点(Element)、属性(Attribute)和文本节点(Text)组成的树状结构。翻译工具或脚本如果把源码当成纯字符串切分,就会破坏标签配对。在动手处理前,需要先把节点分成三类:
特别是帮助文档里常见的行内混合句子,例如:
<p>Run <code>npm install</code> and check the <a href="/docs/config#env">environment variables</a>.</p>
合格的处理应当将 <code>npm install</code> 视为不可拆分的占位整体,仅翻译两侧的文本节点与 <a> 标签内部的文字,同时确保 href="/docs/config#env" 一字不改。
二、HTML 帮助文档翻译的实操流程
无论是维护静态站点生成(SSG)产物,还是直接交付单页 HTML 帮助文件,都可以按以下四步推进:
1. 预处理:标记不翻译的区域
如果文档中有些段落虽然放在普通 <span> 或 <p> 里(例如产品专有名称、配置项路径或固定报错原文),在送译前先加上 W3C 标准的 translate="no" 属性或团队约定的固定类名。这样无论后续走解析脚本还是文档翻译工具,都有明确的跳过依据。
2. 使用支持 HTML 格式的文件翻译流程
不要把 HTML 源码复制到网页聊天框里分段粘贴——上下文截断几乎一定会造成闭合标签丢失。应当直接以 .html 文件为单位处理。
以意扣(Equalang)为例,其文档翻译支持直接上传 HTML、TXT、PDF、DOCX、EPUB 等文件,走「上传文件 → 翻译任务 → 下载结果」的流程。在处理少量独立的 HTML 帮助页或离线说明文档时,直接用文件任务处理比手工拆装字符串更省事。任务完成后,可以在意扣(Equalang)的翻译工作台里打开,左边原文、右边译文并排显示并支持同步滚动,方便先扫一遍标题层级和段落对应关系,再下载译文文件。
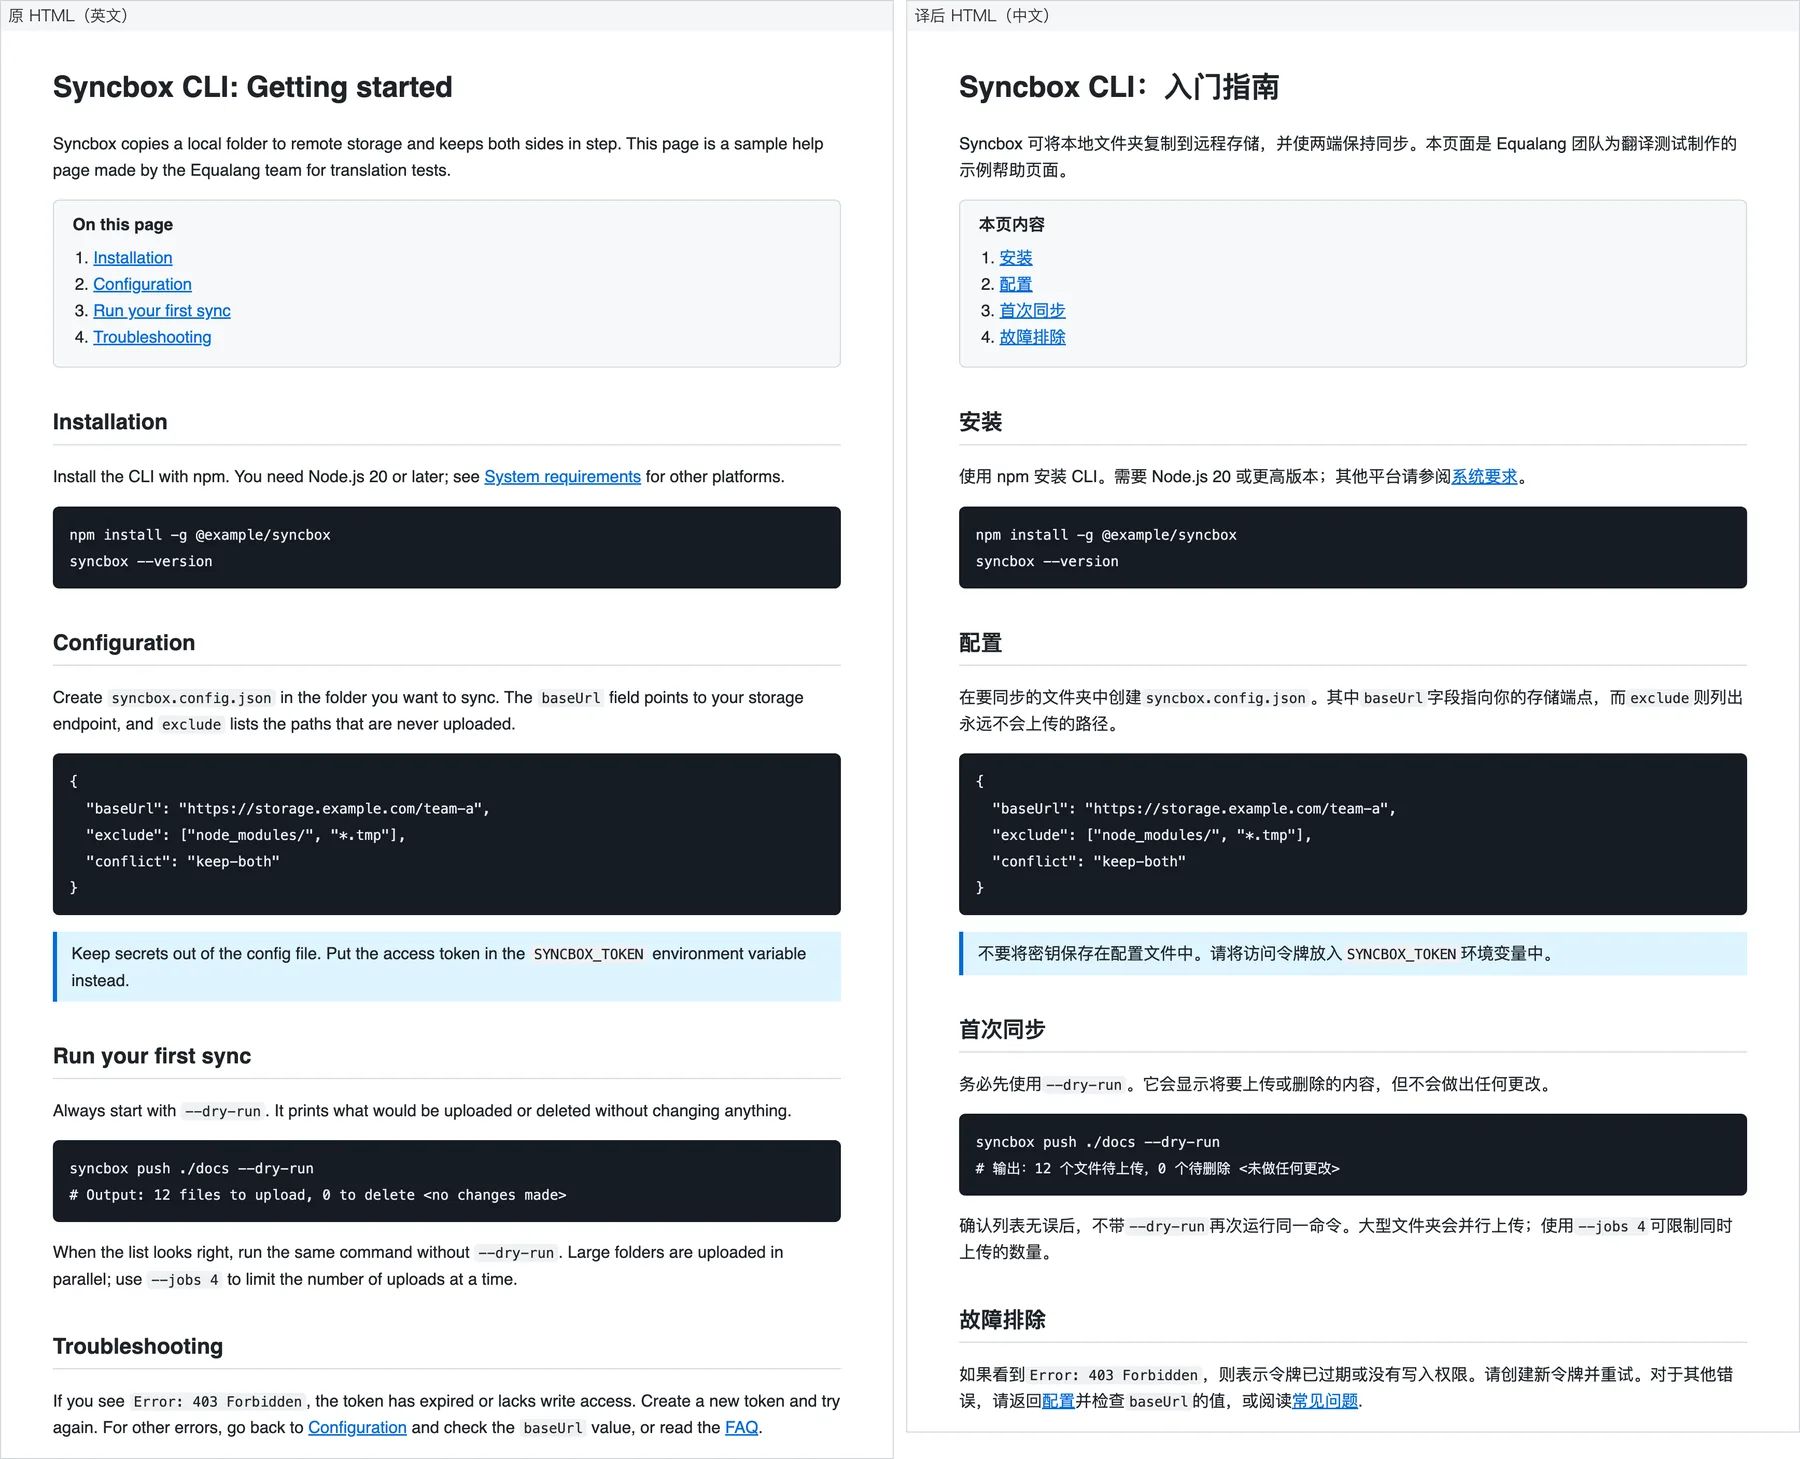
不过,无论使用意扣(Equalang)还是其他解析工具,工具替你省下的是提取与回填文本的体力活,不能代替上线前的 DOM 结构与链接核验。不同文档框架生成的自定义组件、行内脚本或特殊转义字符各不相同,拿到译后 .html 文件后,必须跑一遍下面的静态验收。
三、上线前的静态页面验收清单
拿到译文 HTML 后,不要只用肉眼看一段正文就合并分支。建议用命令行或简短脚本配合浏览器做完这五项检查:
1. 核对标签树与闭合完整性
最快速的办法是对比源文件与译文文件的元素标签计数。如果 <pre>、<code>、<a>、<ul>、<li>、<table> 的数量在翻译前后不一致,说明一定发生了标签吞没或未闭合。
- 检查
<head>中的<meta charset="utf-8">与<link rel="stylesheet">是否完好。 - 更新根节点的语言声明,例如将
<html lang="en">改为<html lang="zh-CN">,避免浏览器触发多余的自动翻译提示或影响字体回退。
2. 抽查代码块与命令参数
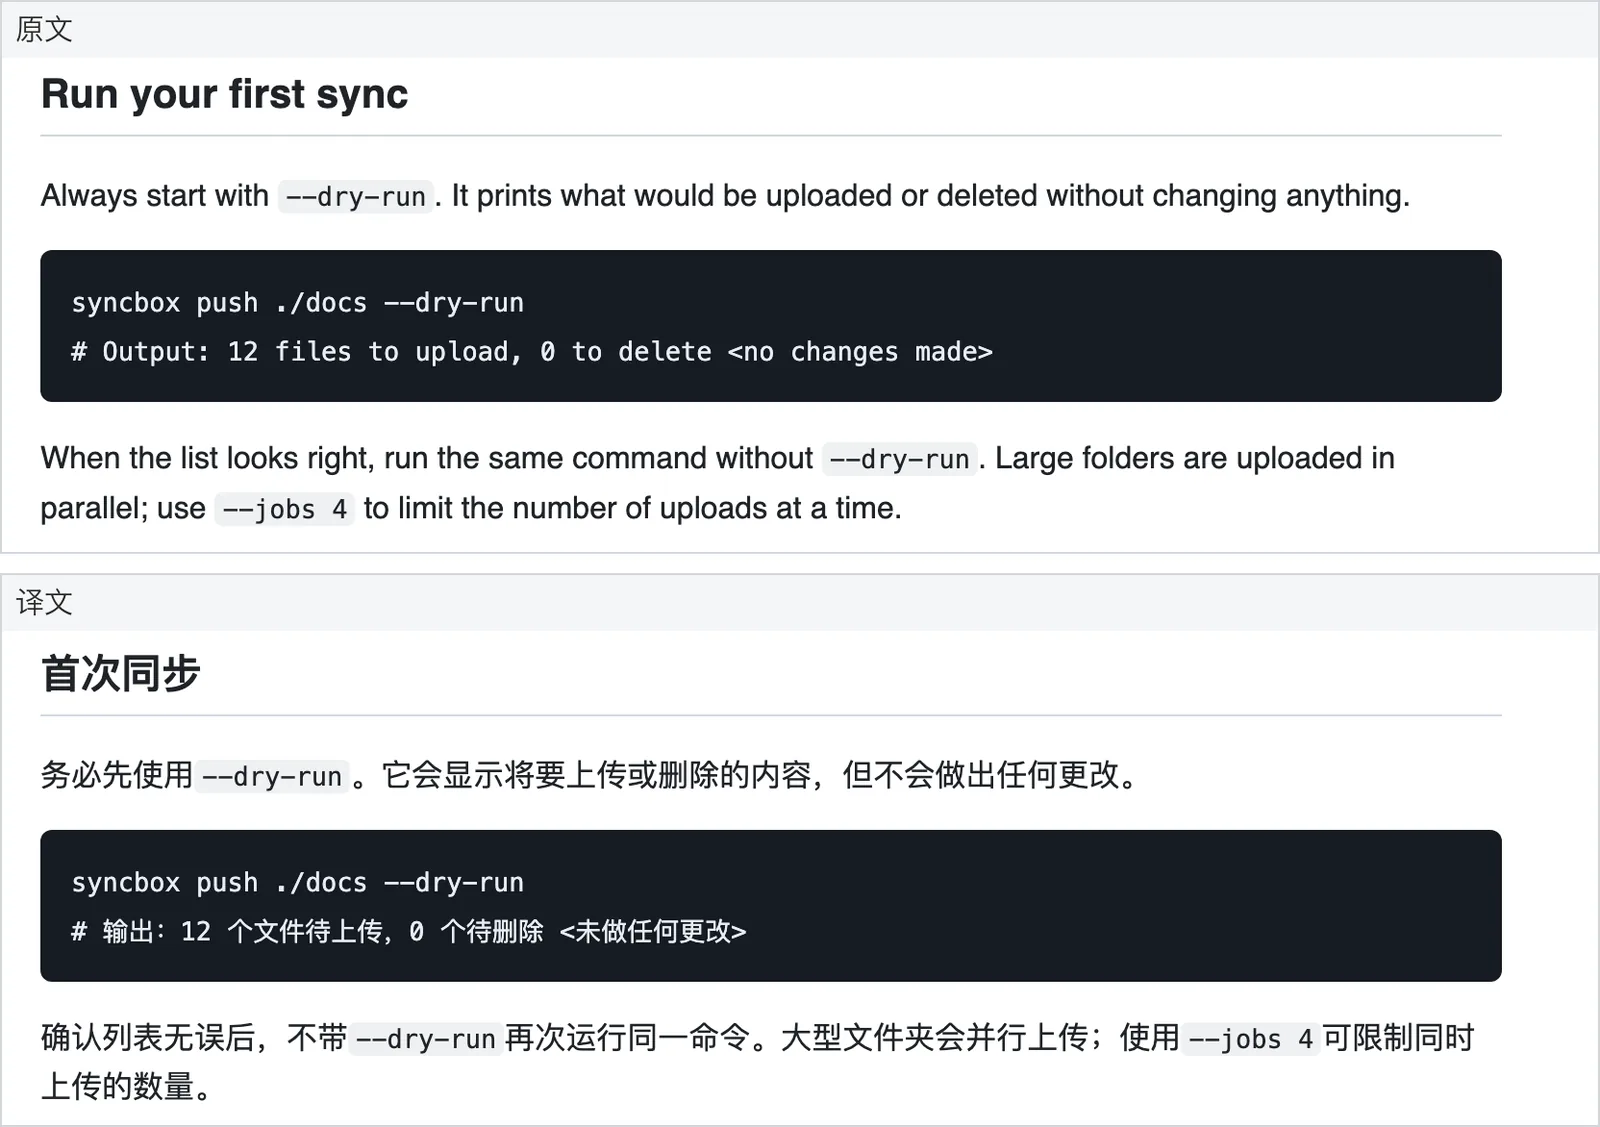
在浏览器中打开译后页面,重点查看包含终端命令、API 请求示例和配置片段的章节:
<pre><code>块内的缩进与换行是否原样保持(未被压缩成单行)。- HTML 实体转义(如
<、>、&)是否仍然正确,没有因为二次解码变成真正的标签而被浏览器吞掉。 - 行内
<code>中的参数名(如--dry-run、baseUrl)是否保持英文原样。
3. 验证相对链接与页内锚点
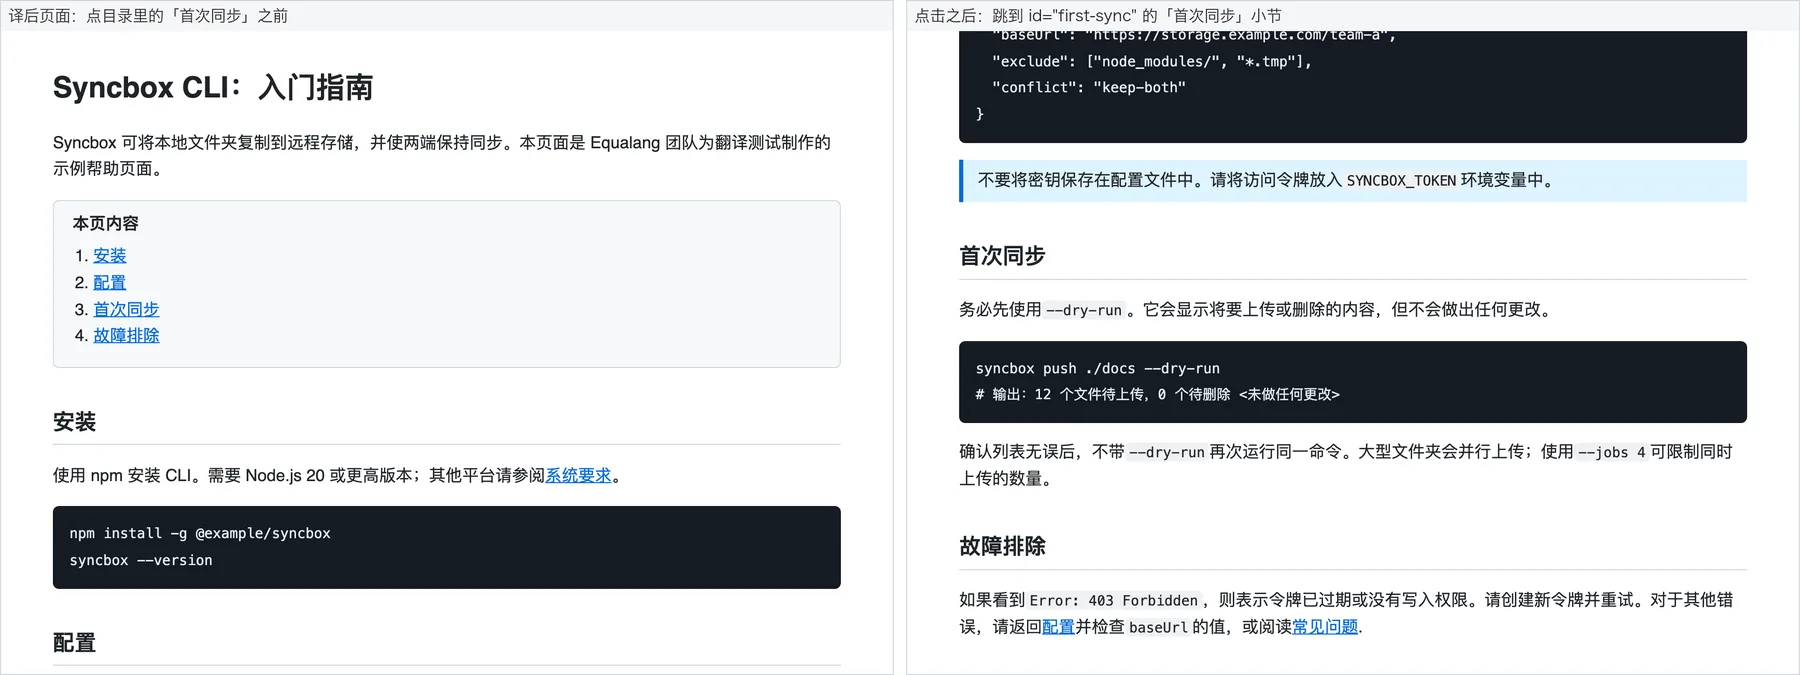
帮助文档里有大量跨页相对路径和本页目录跳转(TOC),这是机器翻译最容易误伤的地方:
- 外部与相对链接:检查所有
<a href="...">是否多出了编码后的空格(%20)或被误改了路径层级。 - 页内锚点配对:如果页面顶部目录指向
href="#installation",而正文的标题写成了<h2 id="installation">安装步骤</h2>,必须确认href和对应标题的id保持一致。如果构建工具会根据中文标题自动重写id,则需要同步更新目录中的锚点引用。
4. 检查可访问性与 SEO 属性
打开开发者工具(DevTools)抽查源码:
- 图片的
alt属性、输入框的placeholder是否已经译出。 <title>和<meta name="description" content="...">是否已翻译,且属性值内部没有因为出现未转义的双引号而截断标签。
5. 本地静态渲染与交互回归
把译文 HTML 放进本地静态服务器(例如运行 python3 -m http.server)打开:
- 切换代码块右上角的「复制代码」按钮,粘贴出来看是否有夹杂的译文或乱码。
- 点击折叠面板(
<details><summary>)或标签页切换组件,确认绑定在data-*或class上的交互脚本没有因为属性变动而失效。
四、什么情况下不适合直接翻 HTML 文件?
直接翻译 .html 文件适合这几类场景:第三方软件导出的单文件 HTML 帮助手册、历史遗留的无源码静态网页、或者结构规整的独立说明页。
如果你的帮助中心基于 Docusaurus、VitePress、Nextra 等现代文档框架构建,且源码本身是 Markdown(.md / .mdx),更稳妥的做法是在构建前翻译源文件或接入多语言路由,再由框架统一编译出 HTML。当手里只有现成 HTML 产物、或者需要快速交付静态页面时,先用像意扣(Equalang)这样支持 HTML 格式的工具完成文件级初翻,再严格按上述 DOM 清单核验代码块与链接,才是既省时间又不出线上事故的做法。