想在微信读书里看原版书?整本 EPUB 电子书该如何保留排版翻译
 意扣 Equalang
导读
读原版外文电子书总丢失目录和插图?本文介绍整本 EPUB 翻译实操,保留完整章节跳转、文内插图与字体样式。
关键词:EPUB 电子书翻译; 微信读书导入原版书; 保留排版翻译电子书; EPUB 目录跳转; Kindle 电子书翻译
很多热爱阅读的朋友都有过类似的经历:海外刚出了一本备受好评的商业传记、前沿科技或非虚构原版书,国内出版社尚未引进中译本;好不容易找来了原版 EPUB 电子书,打算导入日常习惯的微信读书、Kindle 或 Apple Books 慢慢读,但面对数十万字的大段外文,硬啃起来极为缓慢。
尝试用市面上的通用工具翻译整本电子书,结果往往让人崩溃:原本精巧的多级目录树(TOC)彻底失效,点击章节无法跳转;作者精心编排的原书插图、数据架构图全被丢弃;段落间距和内嵌 CSS 样式损坏,导入微信读书后无法正常计算分页,甚至连文末注释的双向锚点链接都变成了无法点击的死文本。
读原版电子书的核心障碍,不是找不到优质图书资源,而是**「目录跳转瘫痪、插图错位丢失、排版崩塌打乱阅读节奏」**。
这篇文章拆解 EPUB 电子书的底层排版逻辑,并演示如何保留目录层级与插图排版,将整本外文书翻译为中文电子书。
一、为什么整本 EPUB 翻译比普通文档更难?
很多读者以为 EPUB 只是换了个后缀的纯文本,其实不然。EPUB 本质上是一个遵循国际数字出版论坛(IDPF / W3C)标准的打包网页容器,里面包含了 XHTML 章节结构、CSS 样式表、NCX/OPF 元数据以及多媒体资产文件。
普通机翻工具在处理 EPUB 时,往往会在以下几个关键环节“翻车”:
- 破坏 XML/XHTML 标记与目录树(TOC):正规电子书依赖
nav.xhtml或toc.ncx实现从封面、序言到各章节的多级跳转。通用翻译脚本如果粗暴提取文本,就会破坏节点 ID,导致在微信读书或电子书阅读器中打开时“目录为空”或“点击全无反应”。 - 丢失内嵌图片与图文混排:纪实、传记或科普读物中包含大量的历史照片、数据图表与作者手绘插图。如果翻译流程忽略了对
Images资源目录的引用维护,译后书籍里的插图就会变成空白红叉或错位漂移。 - 注释去程与回程锚点断裂:学术著作与深度读物中大量存在的角标注释(Footnotes / Endnotes),依赖 HTML 内的超链接锚点(Anchor)实现“点击角标看注释,点击注释回原文”。普通翻译极易把超链接代码当作多余符号抹除。
- 长篇专有名词前后不一致:在数十万字的长篇读物中,同一主角名、地名或专业术语如果前几章叫一个名字,后几章换了另一种叫法,会极大破坏阅读的沉浸感。
因此,真正能用的整本电子书翻译,必须做到**「解包解析结构 → 保护 XHTML 标签与样式 → 保留插图与超链接锚点 → 原样重新封装为合规 EPUB」**。
二、常见电子书翻译方案的横向比较
针对外文电子书的翻译需求,目前市场上常见的尝试路径主要有以下几种:
对于希望省去繁琐配置、追求拿到文件就能直接拖入阅读器看书的读者,专业整文件翻译是更高效的选择。下面用我们团队开发的 Equalang(意扣) 演示实操全流程。
三、三步完成整本 EPUB 翻译并放进阅读器
整个操作在网页端即可完成,无需在本地安装复杂的电子书编辑工具。
第一步:在文档翻译入口上传原版 EPUB
登录 Equalang 网页端,点击进入文档翻译功能模块。
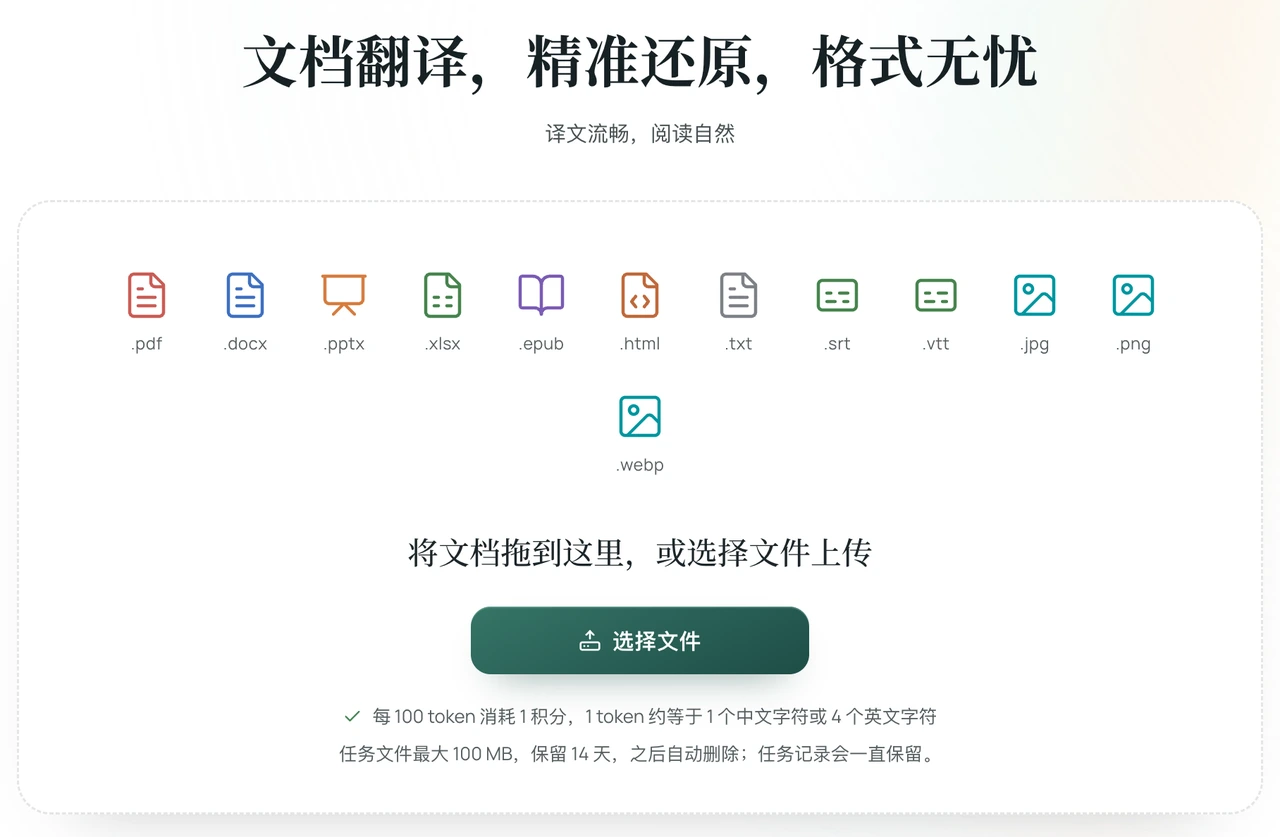
- 点击或拖入准备好的外文原版
.epub文件(同时支持 PDF、DOCX、XLSX、PPTX 等常见格式); - 目标语言选择「简体中文」(系统支持自动检测源语言);
第二步:下载译本并校验目录与排版完整性
系统处理完成后,即可下载生成的中文版 .epub 文件。
在正式导入手机之前,可在电脑自带的「图书(Apple Books)」或开源阅读器中进行简单检查:
- 目录跳转测试:打开目录抽屉,点击任意子章节,阅读器能够瞬间跳转至对应的正文起始位置;
- 插图与图注:文内插图完整保留,没有被压缩或裁切,图注文字居中贴合在图像下方;
- 文内注释回跳:点击正文中的角标编号,能顺畅跳转到章节末尾的详细注解,并能通过返回链接回到刚刚阅读的段落。
第三步:导入常用阅读器
经过合规封装的 EPUB 文件,目录、文内链接、章节和插图会保留:
- 导入阅读器:译好的中文 EPUB 可以导入支持本地 EPUB 文件的阅读器(例如微信读书的本地导入)。各阅读器的导入入口和对排版的处理不尽相同,我们没有逐一测试,导入后请先翻看目录和插图;
- 调整字号:我们测试的样书译稿在阅读器里可以调字号,显示效果也会受阅读器字体环境影响。
四、电子书阅读与导入的避坑指南
为了获得最舒适的电子书阅读体验,建议在实操中注意以下细节:
- 排查带 DRM 保护的图书:从某些专有平台直接导出的图书可能带有版权数字加密(DRM),这类文件任何第三方工具都无法直接解析,上传前需确保文件属于开放未加密的合规 EPUB。
- 阅读器字体选择:中文 EPUB 导入阅读器后,若发现字形显得单薄,可以在阅读器设置里换一种中文字体再看。
- 多端积分统一管理:Equalang 平台在文档翻译与插件端使用统一的积分体系,新注册即可获赠 200 积分用于体验测验,整本电子书按真实处理体量计费。
参考资料 / Sources
- Equalang 意扣文档翻译官方入口
- W3C EPUB 3 官方标准规范文档
- 微信读书官方网站与移动端导入说明
- IDPF (International Digital Publishing Forum) 开放出版物数据结构定义
- Sigil 开源 EPUB 编辑器项目官方指南