翻译不是换符号,
 意扣 Equalang
导读
从查词典、数词频,到词向量、Transformer 与大语言模型,拆解机器翻译七十年走过的四个阶段,看懂 AI 如何一步步学会理解人类语言。
关键词:机器翻译; Transformer; 大语言模型; 神经网络; 注意力机制; 同声传译
一秒钟的词序乾坤大挪移,人类磨了七十多年
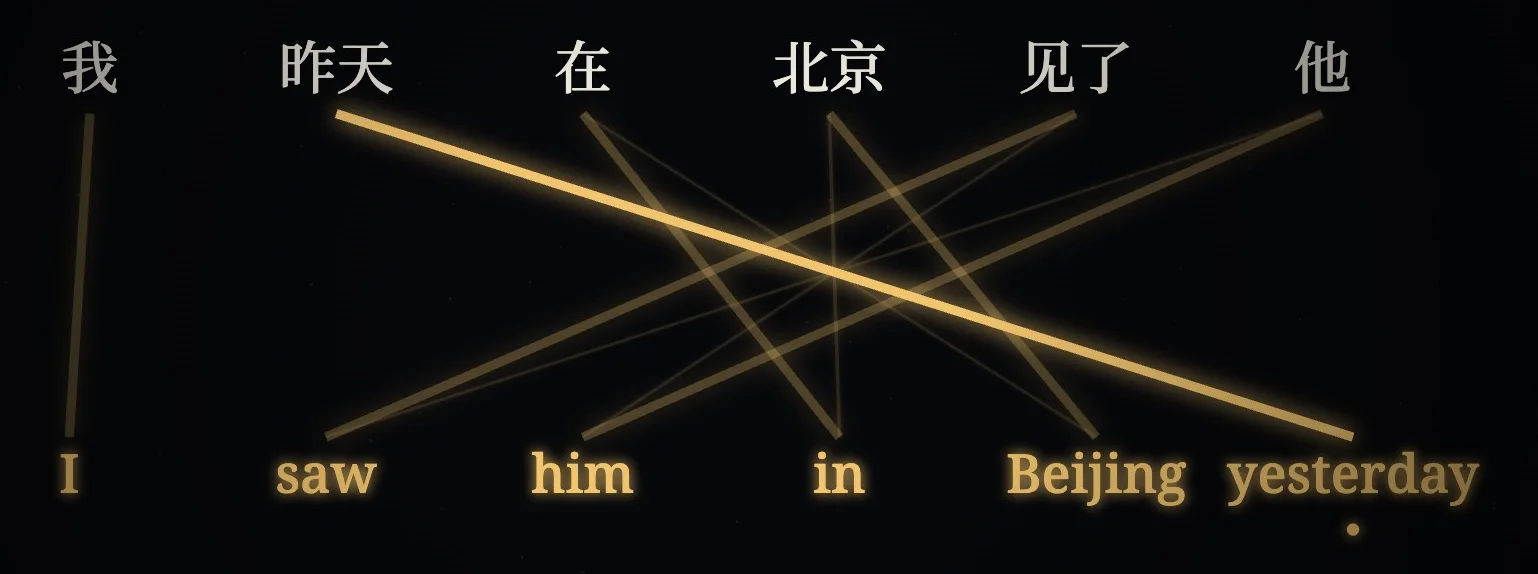
在翻译软件的输入框里敲下一句中文:「我昨天在北京见了他。」
不到一秒,屏幕上跳出英文译文:「I saw him in Beijing yesterday.」
如果仔细对照这两句话,会发现一件习以为常却很不简单的事:机器并不是把中文词一个个换成英文词就算完事。原句里排在开头的「昨天」(yesterday)和「在北京」(in Beijing),到了英文里统统跑到了句尾;原本在句末的动作「见了他」(saw him),反而提到了前面。要是把两句话里对应的词用线连起来,这些连线会在半空中交叉成一张网。
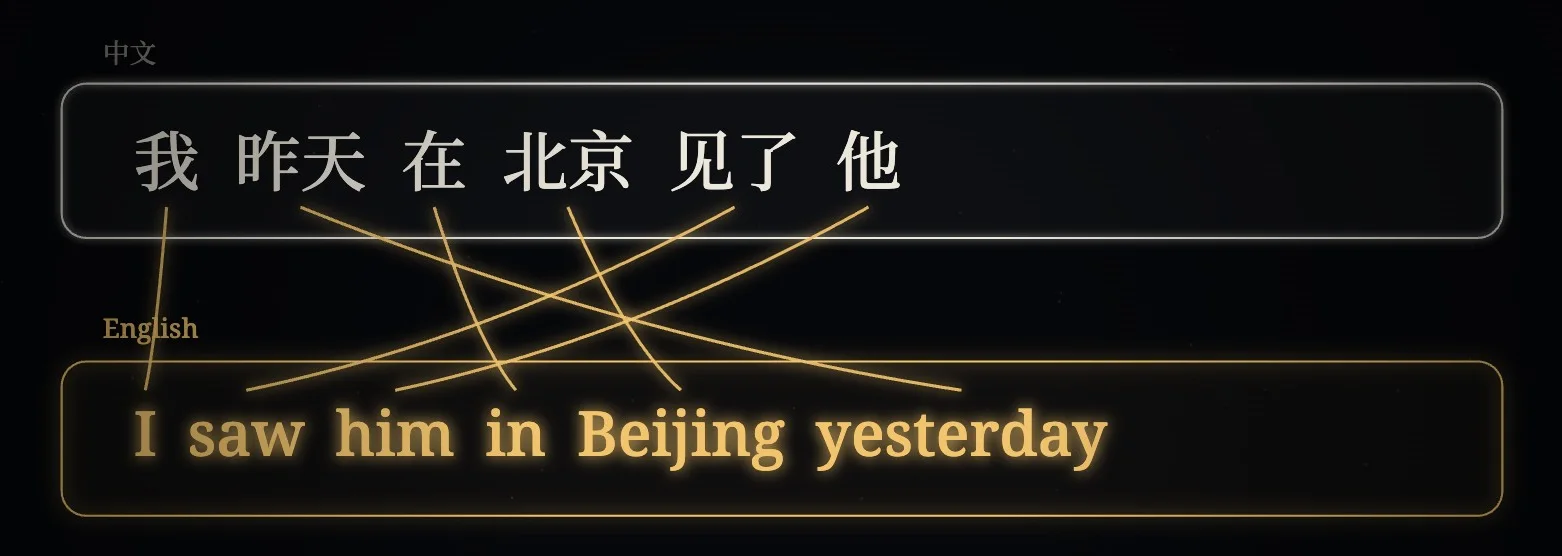
敲下回车的一秒钟背后,是人类研究了七十多年的一道难题:怎么让一台只认数字的机器,把一种语言变成另一种语言?
回头看这七十多年的探索,机器翻译并不是把词典越做越大那么简单,而是走过了一段步步读懂语言的阶梯——从最初死板地替换符号,到摸清词义,再到读懂整句话,最后看懂一整段话的上下文。
这篇文章有一支 8 分钟的动画版:https://www.bilibili.com/video/BV1pcWG6eE2P/
第一步:把外语当成密码来破译,为什么会撞墙?
故事的起点在 1947 年。那年 3 月 4 日,美国数学家韦弗(Warren Weaver)给朋友维纳写了一封信。他在信里聊起一个直觉:每次看到一篇俄文文章,他都会想——「这其实是英文,只是被人用奇怪的符号加了密。」
在韦弗看来,翻译本质上就是一道解密题。只要找出两门语言之间的符号对应规律,把密文解开,底下的英文自然就出来了。1949 年 7 月,他把这个想法整理成一份备忘录发给同行,标题只有一个词:《Translation》(翻译)。
这个想法很快被搬上了真正的计算机。1954 年 1 月 7 日,IBM 与乔治城大学联手,做了一场人类历史上首次公开的机器翻译演示。一位完全不懂俄语的操作员坐在机器前,把六十多句俄语敲进穿孔卡片,计算机咔哒作响,把它们全部自动译成了英语。
当时这台机器是怎么翻译的?原理很像查一本带说明书的词典:
- 查编号:先把读进来的每个俄语词,在穿孔卡片词典里查出对应的数字编号,以及可能对应的英文译法。
- 看规则:接着看这个词旁边的词是什么,按照人预先写好的语法规则,完成三件事——在几个候选英文词里选词、把颠倒的词序调过来、或者删掉英文里不需要的多余词。
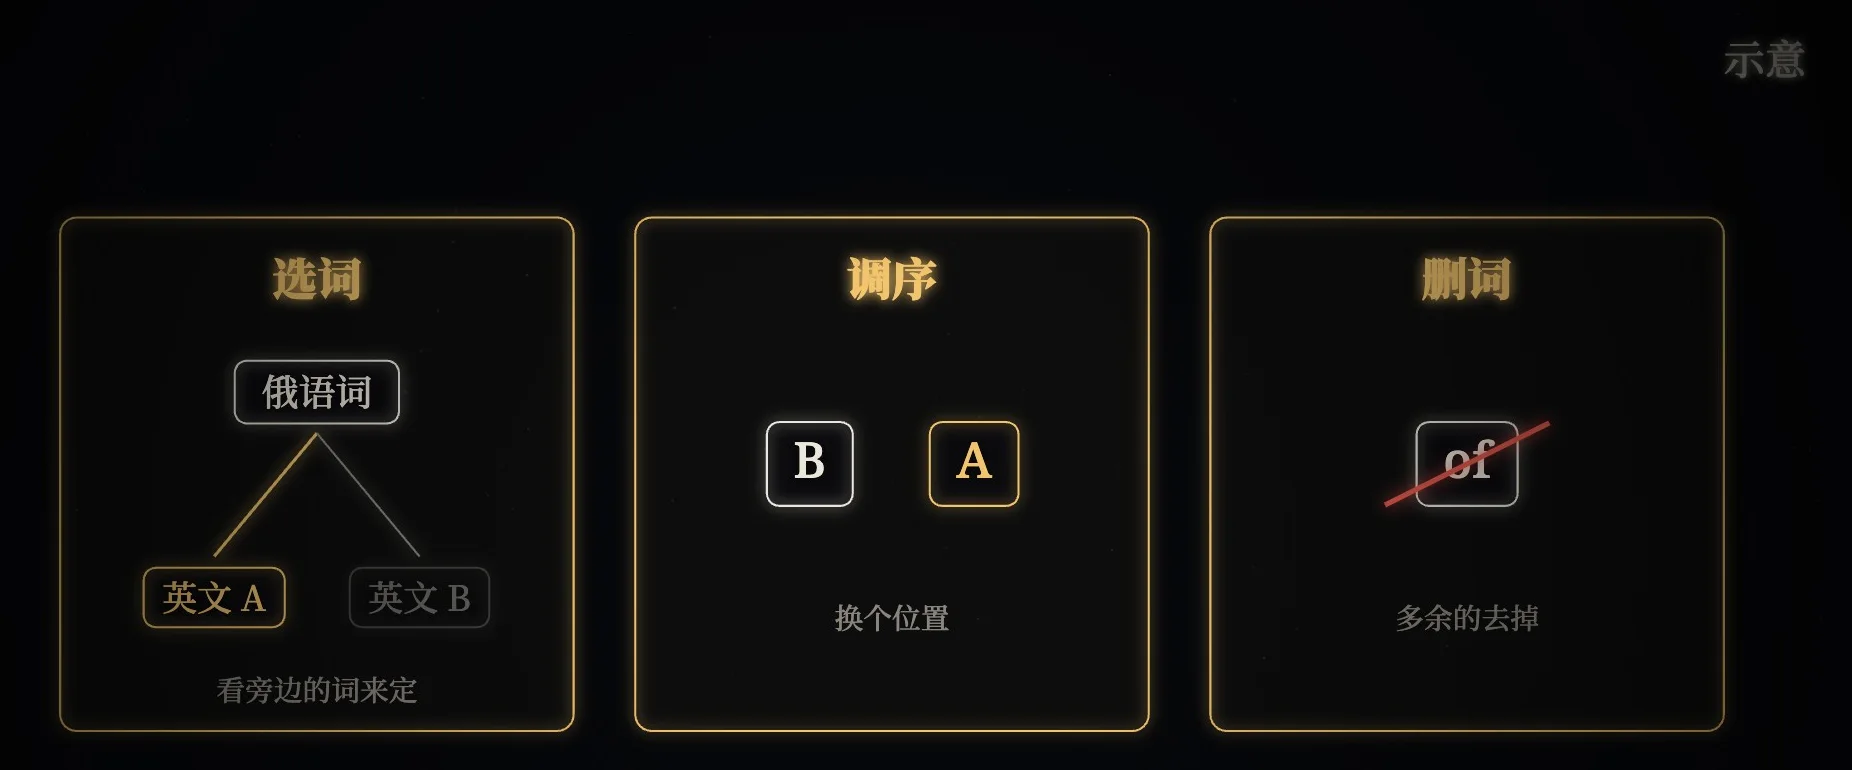
这场演示轰动一时。当时的研究者非常乐观,觉得只要沿着这条路走下去,三到五年内,机器翻译就能彻底解决。
但台下的观众不知道,那台机器的词典小得可怜,一共只有 250 个词条(包含词干和词尾),语法规则也只有寥寥 6 条;就连上台表演的那六十多句俄语,也是事先精心挑选出来的。
一旦走出实验室,去面对真实世界里的文章,三年过去了,五年过去了,十年过去了,预想中的突破迟迟没有到来。1966 年,美国政府组织的自动语言处理顾问委员会(ALPAC)交出了一份调查报告,结论很冷静:十年的研究,并没有兑现当初的期待。随后,研究经费被大幅削减,机器翻译一头跌进了漫长的寒冬。
尽管经费骤减,还是有研究者咬牙接着往下做,把 1954 年那套思路越磨越细。词典一个词一个词地添,语法一条一条地写,全部由人亲手教给机器——这就是基于规则的机器翻译。
这套办法在特定场合真的派上了用场。比如加拿大的 METEO 系统,从 1981 年起就用来把天气预报在英法双语之间互译。它之所以能胜任,是因为天气预报属于受限的语言,每天翻来覆去就那么几种固定说法,词汇和句式都出不了圈。
可一旦放到日常说话里,规则就不灵了。日常语言没那么规矩,最让人头疼的就是一词多义。
拿中文里最常见的「打」字来说。如果词典里死板地规定每个字只对应一种译法,比如把「打」绑死在英文的 hit(击打)上,那么「我打车去公司」逐词硬翻出来就会变成闹笑话的错句(示意)。在真实语言里,同一个「打」字,换个后面的搭配,英文就得彻底换一种说法:
- 打电话,是 call;
- 打车,是 take a taxi;
- 打折,是 discount;
- 打伞,是 hold an umbrella。
光一个「打」字就有这么多种搭配,为了译对它,人就得给每一种搭配写一条判断规则。每多一种说法,就要多补一条规则;规则写不完,语言里的例外更写不完。靠人一条条教机器语法,就像用纸牌搭高楼,例外卡片越堆越多,迟早会把整座楼撞散。
不教语法改查菜谱和数数:统计翻译是怎么变聪明的?
既然规则永远写不完,能不能换个思路?
1984 年,日本学者长尾真提出了基于实例的机器翻译:不让机器死背语法规则,而是让它照着现成的例子翻。
这就像下厨翻菜谱。假如手里已经有一道旧菜谱——比如知道「我昨天在北京见了他」译成「I saw him in Beijing yesterday」;现在来了一道新菜「我昨天在上海见了她」,机器只需要在存好的例句库里找到最像的那句旧话,对比出只有「北京→上海」「他→她」两处不同,照抄旧译文,再像换配料一样把对应的两处词换掉,新译文就出来了(示意)。
到了 1990 年前后,IBM 华生研究中心的研究者们走得更干脆:连语法带规则统统不教了,只给机器喂海量由人工翻译好的双语句对,让机器自己去数——哪两个词总是成对出现。
想象一摞摞中英对照的句子不断掉进机器里。机器不认识汉字,也不懂英文单词,但它能做算术。每当中文句子里出现「苹果」,对应的英文句子里也出现了 apple,机器就在这对词之间的计数器上加一。
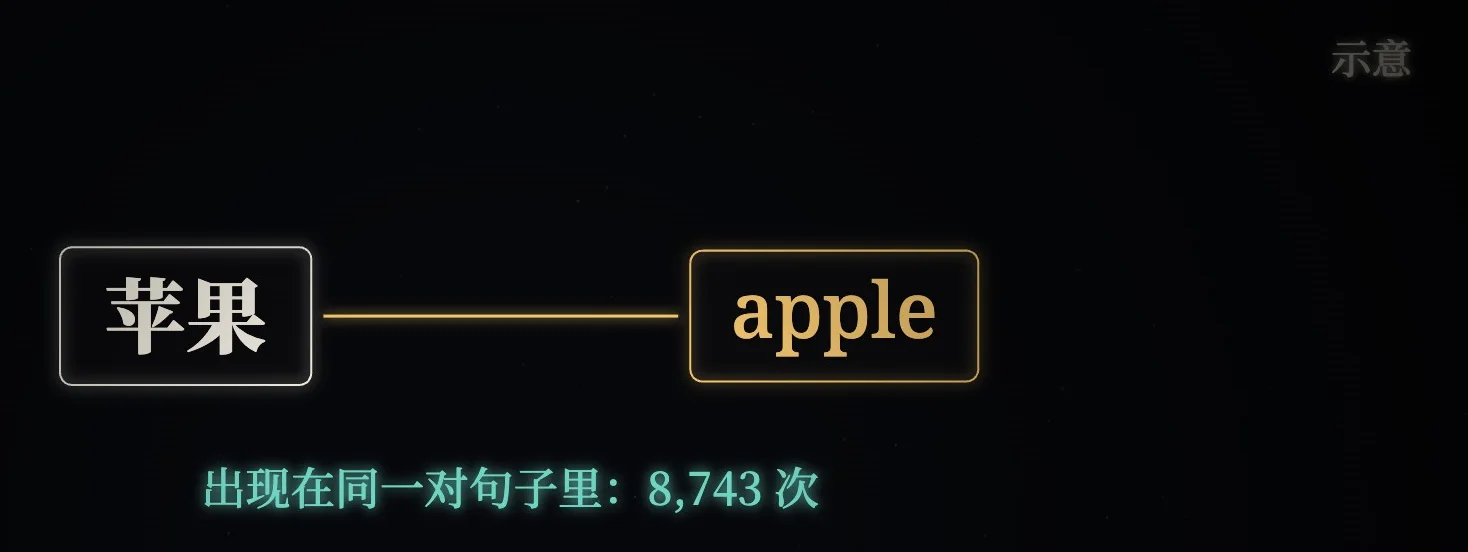
一对、十对、成千上万对句子数下来,「苹果」和 apple 同时出现的次数越来越多,机器算出的概率就越来越高,也就越相信:这两个符号说的是同一个意思。这就像一个人完全不认识 apple 这个外文词,但每次去水果摊,都看见这张标签贴在红彤彤的果子旁边,见得多了,自然就懂了。
这就是统计机器翻译。从这一刻起,翻译从「查规则」变成了「算概率」。
不过,光靠数中英词对,还应付不了完整的句子。比如中文里的「他」,翻成英文既可以对应主格的 he,也可以对应宾格的 him。到底选哪个?单看「他」这一个词的词对概率,机器答不上来。
于是研究者又给机器配了一件法宝,去数纯英文句子里哪个词常跟在哪个词后面。比如前面已经翻出了「I saw _」,机器去翻自己数过的英文账本,发现 saw 后面跟着 him 的次数远比跟着 he 多,分数更高(示意)。这种「看前几个词,猜下一个词是什么」的模型,就叫语言模型。
把这两样东西合在一起,统计机器翻译的流水线就齐了:
- 翻译模型(查词对):把原句切成小块,一块块查概率表,找出几个可能的英文候选词(比如给「他」挑出 he 和 him 两个候选);
- 语言模型(挑顺句):看前几个词的搭配习惯,从候选译法里挑出最通顺的那个词(因为前面是 saw,所以留住 him、划掉 he),最后拼成完整的句子(示意)。
2006 年,谷歌翻译正式上线,背后用的正是这套统计机器翻译。
但统计机器翻译和早年的规则翻译一样,还困在**「符号」**这一层。在它眼里,每一个词都只是一个孤立的编号。比如「猫」是 #4127 号,「狗」是 #9853 号(编号为示意),这两个编号之间没有任何关系。机器完全看不出「猫」和「狗」在意思上很亲近,在「猫」身上学到的翻译经验,也半点借不到「狗」身上。一旦遇到训练语料里没怎么出现过的词组搭配,统计次数不够,它就抓瞎了。
要想再往前走一步,机器不能只把词当成冷冰冰的编号来数,它得先弄懂词义。
从词向量到注意力机制:机器如何学会读懂整句话?
转机出现在 2013 年。这一年,word2vec 让早就提出的词向量技术真正流行开来(早在 2000 年,Bengio 等研究者就已经提出了词向量的思路)。
词向量做了一件很巧妙的事:它不再给每个词发一个孤立的号码牌,而是把每个词变成一长串数字——通常有几百个数字那么长。
可以把这几百个数字想象成给每个词列了一张详细的「特征打分表」:第一格代表是不是动物?第二格代表能不能吃?第三格代表是不是城市?每一项都打一个分(注:各维度实际上没有独立可读的含义,而是 AI 自己总结的抽象特征)。
这些数字是怎么算出来的?不是人填的,而是让机器去做海量的填空题。比如给出一句话:「我养了一只 _」,遮住最后一个词,让机器猜空里填什么(示意)。在成千上万的句子里,「猫」和「狗」总是出现在相似的空位里,机器在反复调整数字来猜词的过程中,就会把「猫」和「狗」那几百个数字调得越来越像。
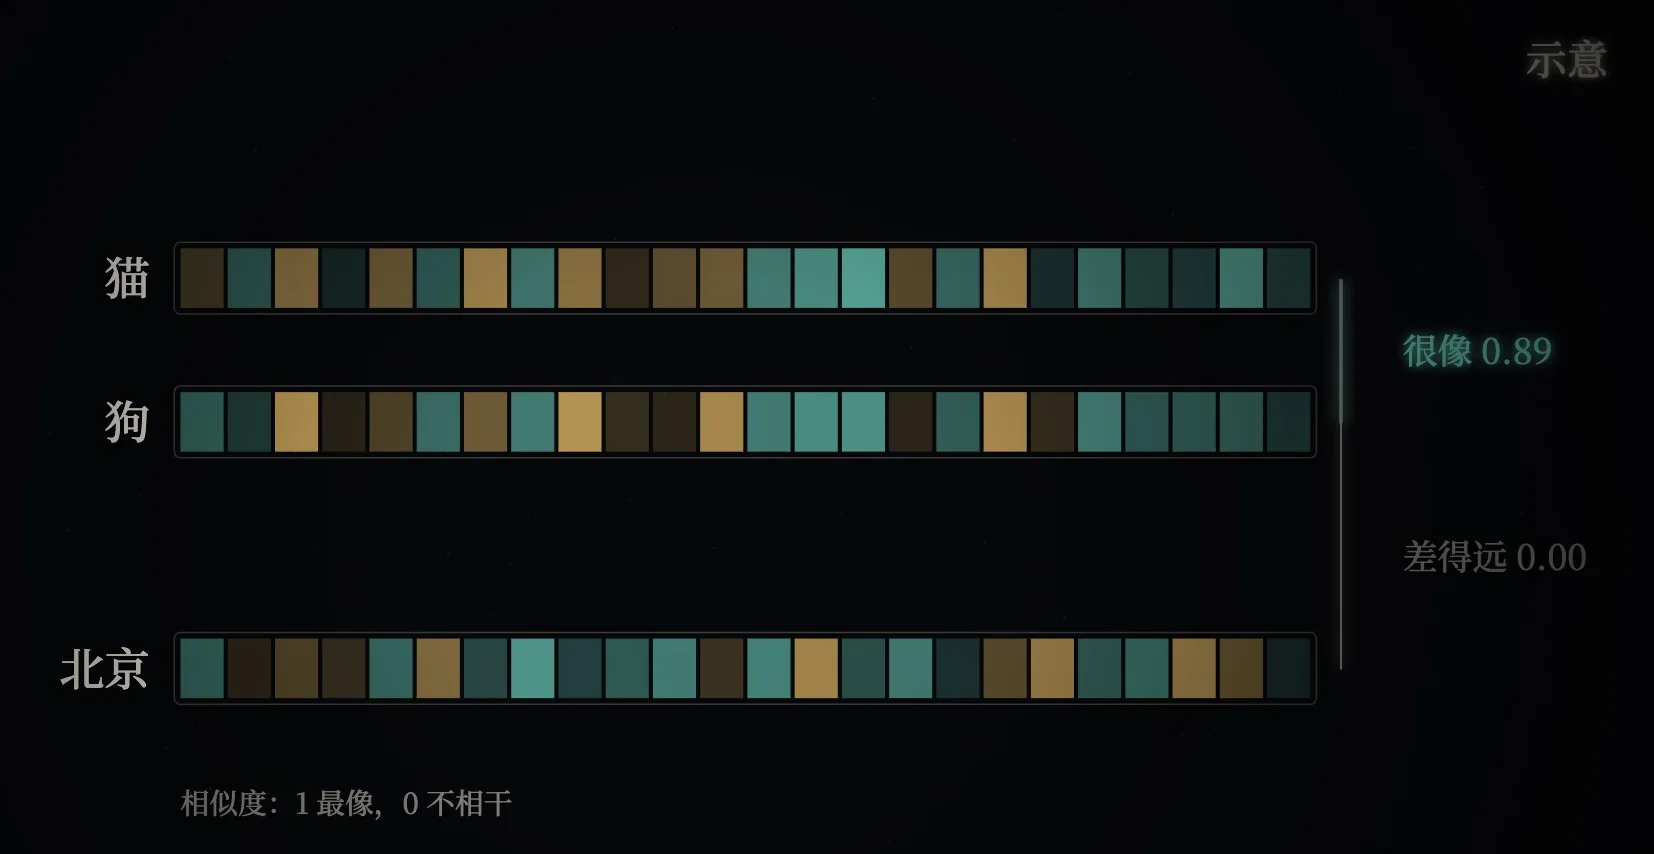
结果非常奇妙:意思越相近的词,它们的数字长条就越像;意思八竿子打不着的词,比如「猫」和「北京」,数字就差得十万八千里。因为相近的词数字也相近,机器在「猫」身上学到的规律,终于能顺理成章地举一反三用到「狗」身上;更重要的是,词变成了连续的数字,机器终于可以拿这些数字去计算整句话的意思了。
2014 年,基于人工神经网络的机器翻译(简称神经机器翻译)应运而生。它的工作方式不再是切碎句子查表,而是像一位真正的口译员:
- 先读完(编码器):先把整句中文原原本本地读完,把整句话的意思压缩成一份数字形式的「记忆」;
- 再说出(解码器):接过这份记忆,一个词一个词地往外说出英文译文,而且每说出一个词,都会把这个词也融进记忆里,带着往前考虑下一个词该说什么。
当时,负责攒这份记忆和说译文的,是一种叫循环神经网络(比如长短期记忆网络 LSTM)的结构。它读句子时就像排队过安检,挨个词读进去,每读进一个新词,就和上一步攒下的记忆融合在一起,更新成新的记忆传给下一步。
可这个办法很快就遇到了瓶颈:记忆框就那么大。不管是五六个词的短句,还是几十个词的长句,都得硬塞进同一个固定大小的记忆框里。句子一长,就像让人一口气背一长串电话号码——记住了后面,最前面说的话早就越缩越淡、忘得差不多了。
怎么解决长句忘词的问题?同年,研究者提出了注意力机制(Attention)。
注意力机制的思路,很像人在考场上做阅读理解:机器在写译文的每一个英文词时,不再死抠那个固定大小的记忆框,而是被允许回头瞄一眼原文。写到哪个词,就把目光重点投向原文里最相关的那个位置。比如在写出「I saw him in Beijing yesterday」的过程中,写到 saw 时重点看中文的「见了」,写到 yesterday 时回头去盯中文开头的「昨天」。神经机器翻译最拿手的本事之一,正是这种跨远距离的词序调换(尤其是动词的调序)。
2015 年,百度率先上线了用「循环神经网络 + 注意力机制」搭建的大规模神经机器翻译系统;到了 2016 年,谷歌翻译也全面换上了这一套架构。根据谷歌 2016 年的实测报告,和之前用了十年的短语统计翻译系统相比,神经机器翻译把翻译错误平均减少了约 60%。
但循环神经网络还有一个天生的毛病改不掉:它必须逐词排队读。因为每一步的记忆都得等上一步算完才能传过来,前面的词没处理完,后面的词就只能干等。哪怕在训练时已经把整篇原文和译文都摆在机器面前,它也没法一眼扫过去同时算,训练起来慢得像接力传话。
抛掉排队、手握大喇叭:Transformer 与大语言模型如何打通上下文?
2017 年,谷歌的八位研究者发表了一篇以机器翻译实验为主的论文,题目叫《Attention Is All You Need》。题目的意思很直白:抛掉循环神经网络,只靠注意力机制就够了。
这篇做翻译出身的论文提出的新架构,就是后来鼎鼎大名的 Transformer。它不仅改写了机器翻译,还成了后来 BERT(2018 年)、GPT 系列(2018 年起)以及 ChatGPT(2022 年底)等大多数现代大语言模型的共同底子。据《自然》(Nature)2025 年统计,这篇论文已跻身 21 世纪被引用次数最多的十篇科学论文之列。
Transformer 和循环神经网络到底有什么不同?可以用一个传话的比方来理解:
- 循环神经网络像接力传话:一排人站成一列,悄悄话只能从第一个词传给第二个词,再传给第三个词。不仅传得远了容易走样,排在后面的人在传话送到之前,只能站在原地干等。
- Transformer 像人手一只大喇叭:队伍里所有词在同一时刻一起开喊,全场每个词都能直接听见其他所有词的声音,不管距离多远,听得一样清楚。
既然所有人同时开喊,会不会乱成一锅粥?不会,因为每个词还会挑着听——句子里谁跟自己最相关,就多听谁的,借此敲定自己在这句话里的准确意思。这种在句子内部互相打量、按相关程度汇总信息的机制,就叫自注意力(Self-Attention)。
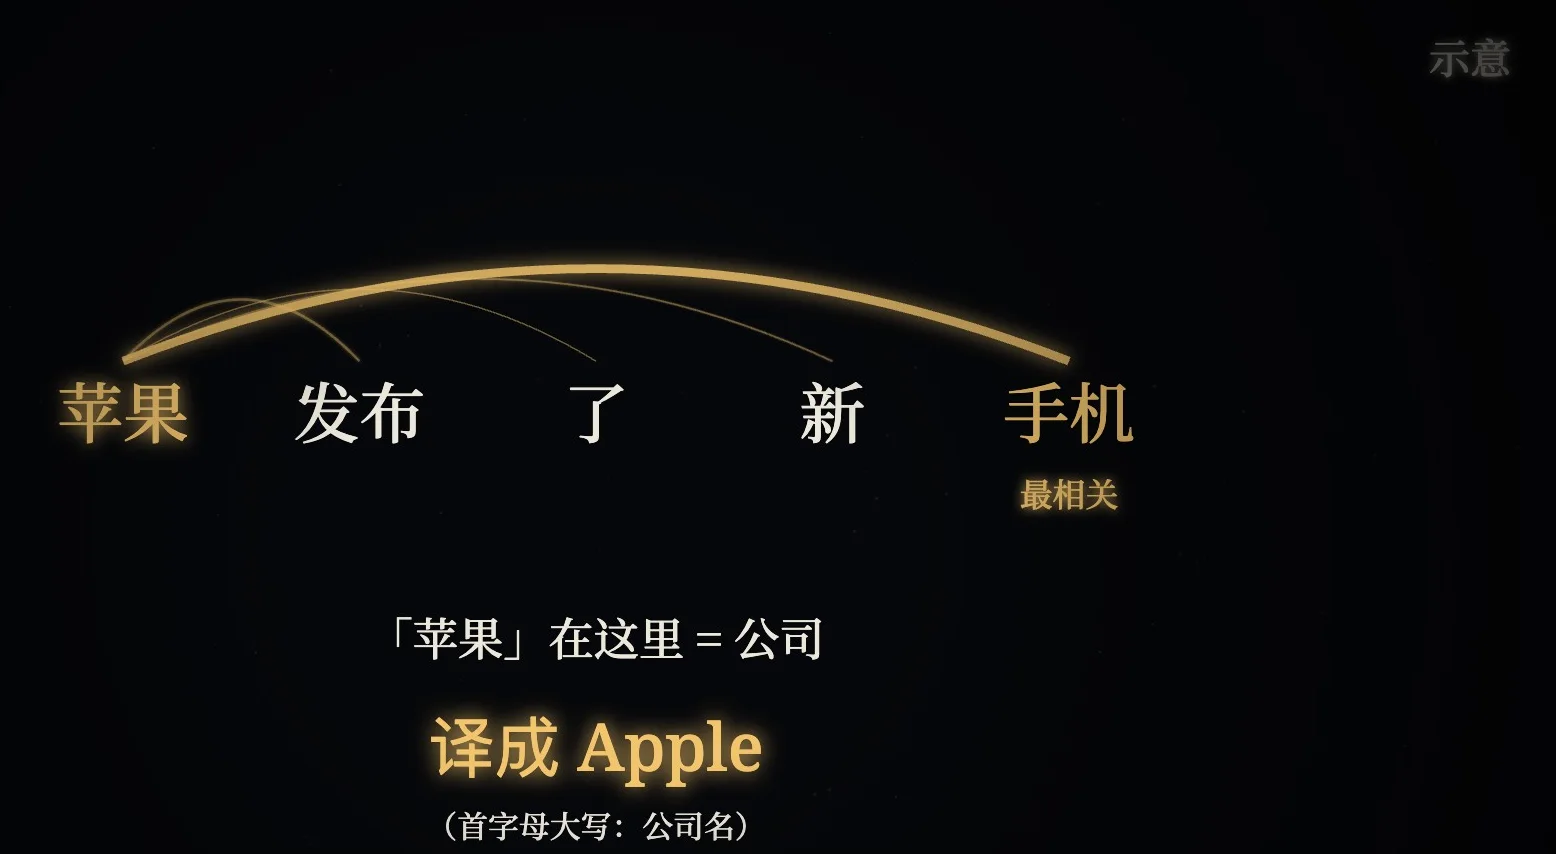
来看看自注意力是怎么解决一词多义的。同样是「苹果」这个词,放在两句不同的话里:
- 在「苹果发布了新手机」这句话里,「苹果」拿着大喇叭环顾全句,发现句尾的「手机」跟自己最相关,重点听取了「手机」的信息,当场就敲定自己在这里指的是一家科技公司,翻译时得写成首字母大写的 Apple(示意)。
- 而在「我吃了一个苹果」这句话里,「苹果」转去重点听最相关的动词「吃」,立刻明白自己在这里指的是能吃的水果,翻译时就写成小写的 apple(示意)。
除了能看清全句的关联,Transformer 还有一个巨大的工程优势:不用排队。在训练模型时,一整页文字里的所有词可以同时并行计算,训练速度大幅飙升。既然算得快了,人们终于可以把原本不敢想的海量文字喂给机器去练。
后来,研究者们用 Transformer 搭出了大语言模型(LLM)。大语言模型并不是专门为了做翻译而造的,它为解决通用任务而生,翻译只是它顺手能做的众多子任务之一。而在预训练阶段,它苦练的基本功只有一件事:猜下一个词。
听着是不是很耳熟?前面统计机器翻译里的 n-gram 语言模型,干的也是「看前几个词,猜下一个词」。比如前面是「我昨天在北京见了 _」,机器算出后面最可能接「他」;如果把动词换成「吃了 _」,后面最可能接的候选词就全变成了食物(示意)。在数学上,这就叫条件概率——就像日常聊天接话茬,下一个词接什么,全看前面说了什么。
既然都在猜下一个词,大语言模型和当年的统计语言模型有什么本质差别?核心差别有两点:
- 看得有多远:当年的统计语言模型窗口很短,只能看空格前面的寥寥几个词;而大语言模型能看前面一整段话(比如 GPT-3 的上下文窗口能装下 2048 个词块)。假设有一段话:「上周我去北京出差,昨天晚上吃了 _」。当年的语言模型眼光只够框住「晚上吃了」这几个字,根本不知道说话的人在哪儿;而大语言模型能把整段话尽收眼底,看到前文提过「北京」,就能猜出下文更可能是「烤鸭」(示意)。
- 能不能举一反三:当年的语言模型靠死数词组出现过几次,要是训练语料里见过「吃了 烤鸭」、没见过「吃了 烤鹅」,遇到「烤鹅」就会因为数据稀疏而算不准;大语言模型继承了神经网络把词变成连续数字的本领,在数字空间里「烤鸭」和「烤鹅」非常接近,哪怕「吃了 烤鹅」很少见,也能举一反三算得八九不离十(示意)。
不过,这里还有一个耐人寻味的问题:一个每天只练习「顺着上文猜下一个词」的模型,怎么也没专门学过翻译,怎么突然就会翻译了?
2023 年的一项研究找到了一条重要线索:研究者在一个大语言模型(PaLM)的训练文字里仔细排查,结果在那些从互联网上搜集来的网页和文档里,数出了超过 3000 万对现成的双语对照译文,横跨至少 44 种语言。换句话说,人类早就把海量的翻译教材夹在日常网页里喂给它了。所以,当你在输入框里写下翻译要求和中文原句,大语言模型顺着这句话往下猜出来的最合理的「下文」,自然就是对应的英文译文(示意)。
2020 年发布的 GPT-3 就是这样练出来的。它读了几千亿个词的文字,不管是写代码、写摘要还是做翻译,都能顺着提示往下接。GPT-3 背后是一场大胆的押注:模型做得越大、读的文字越多,表现就会越好。
这里的「大」,指的是模型内部可调节的数字——也就是参数——有多少。从 2018 年到 2020 年,模型的参数规模一路暴涨:
- GPT-1(2018 年):1.17 亿个参数;
- GPT-2(2019 年):15 亿个参数,涨了约 13 倍;
- GPT-3(2020 年):1750 亿个参数,又涨了约 117 倍;
- 到了 2022 年 11 月问世的 ChatGPT(最初基于微调过的 GPT-3.5)和 2023 年的 GPT-4,官方不再公布具体参数量(据媒体报道 GPT-4 约为万亿级,但未经证实)。
在这场规模狂飙中,研究者摸出了一条规模定律(Scaling Law):只要把参数规模、训练数据量和计算力按比例往上加,模型的表现就会沿着幂律规律稳步提升——在对数坐标图上,每多投入十倍资源,表现就沿着一条直线往上走一截,甚至可以预先算出来。
2022 年 11 月 30 日 ChatGPT 发布后,翻译真正变成了一场人人都可随时商量的对话。以前用翻译软件,给什么译文只能受着;现在觉得初稿不够得体,只管再叮嘱一句。比如让它翻译「明天的会改到下午三点」,它先给出普通的「Tomorrow's meeting is moved to 3 pm.」;你追一句「这是写给客户的,正式一点」,它当场就能换一副商务口吻重译成:「Please note that tomorrow's meeting has been rescheduled to 3:00 p.m.」(示意)。
更重要的是,因为它能看懂大段上下文,翻译终于跨过了字面意思的门槛。比如中文里一句简单的「他走了」,单看这三个字,既可能是指「他离开了房间」(left),也可能是委婉地说「他去世了」(passed away)。如果前文一直在聊医院和病情,大语言模型就能结合场景看出这是一句委婉语,不会按字面硬翻(示意)。
在大语言模型出来之前,哪怕神经机器翻译已经能把句子的意思翻对,读起来也常常有一股挥之不去的「机翻味」——死抠原文结构,句子生硬。比如一句日常的职场客套话「这个方案我们还要再研究一下」,以前的翻译软件往往会老老实实直译成「This plan we still need to research a little.」(示意);而大语言模型给出的是地道的英文表达:「We need to look into this plan a bit more.」(示意)。到了 2023 年的国际机器翻译评测(WMT23)里,顶尖机器译文的质量已经很难和人工翻译分出高下。
文字之外的考场:端到端同声传译怎么决定何时开口?
攻克了书面的文字翻译,机器还在学一件更难的事:同声传译——说话的人在台上滔滔不绝,机器得一边听,一边把外语译文亲口说出来。
最早的语音翻译走的是「三步走」的级联路线:
- 语音识别(ASR):先把听到的声音变成原文文字;
- 机器翻译(MT):再把原文文字翻译成外文文字;
- 语音合成(TTS):最后把外文文字用合成语音念出来。
这种三步接力的做法有两个明显的痛点。第一是慢且容易错上加错:后一步必须干等前一步算完,三段延迟累加在一起,反应就慢了;而且一旦第一步语音识别听错了一个字,后面的翻译和朗读就会一步错、步步错。第二是丢情绪:人说话时的语气、轻重和情绪全藏在声波里,一旦在中间那一步被压成冷冰冰的纯文字,这些非语言信息就彻底消失了,最后念出来的译文只能是毫无波澜的机器腔。
为了跨过中间的文字环节,研究者转向了端到端(End-to-End)模型:用一个模型,直接从一种语言的声音译成另一种语言的声音。不再拆成三步,前一步的错不会往后传,只需解码一次,反应也更快。2019 年谷歌提出的 Translatotron 就是这样一个直接从声音到声音的模型,它甚至能在说出外语译文时保留原说话人自己的嗓音;不过那时候它还得等说话人把整句话说完,才能开口翻译,算不上真正的同传。
要做真正的同声传译,最大的难点在于四个字:何时开口。
这就回到了文章一开头提到的那个问题——中英文的词序是不一样的。说话的人刚吐出前半句,关键的动词可能还留在后半句没说出口。机器如果等得越久,听到的信息越全,翻译得就越准,但戴着耳机听译文的人就会急得抓耳挠腮;反过来,如果为了赶时间一听到词就往外蹦,又很容易因为没听到后半句而翻错。优秀的同传系统必须在「等」和「说」之间走钢丝:比如听到前半句够意思了先翻出来,等后半句一出口,再顺着前面的话茬接上去(示意)。
到了 2025 年,新一代同传模型做成了全双工(Duplex)架构:一个模型可以同时「听」和「说」。它的底子依然是语言模型,仍然在一步步猜下一步该干什么——但现在它猜的不只是「下一个词接什么」,还在每一刻实时判断:这一秒是该继续听,还是该开口说(示意)。
2025 年已有研究团队报告,这类端到端全双工同传模型已经能够一边听人说话,一边用说话人自己的声音同步说出外语译文,并且将克隆嗓音同传的平均延迟从此前方案的近 10 秒大幅压缩到了约 3 秒,延迟缩短了约七成。
七十年走过四级台阶:要翻好,先读懂
把时间轴拉回 1947 年,把这七十多年的探索画成一张图,就能清晰地看见机器翻译走过的三次大跃升——1990 年前后的统计机器翻译、2014 年兴起的神经机器翻译(2016 年谷歌实测错误减少约六成),以及 2020 年代的大语言模型(2023 年评测中顶尖机器系统与人工译文已很难分出高下)。
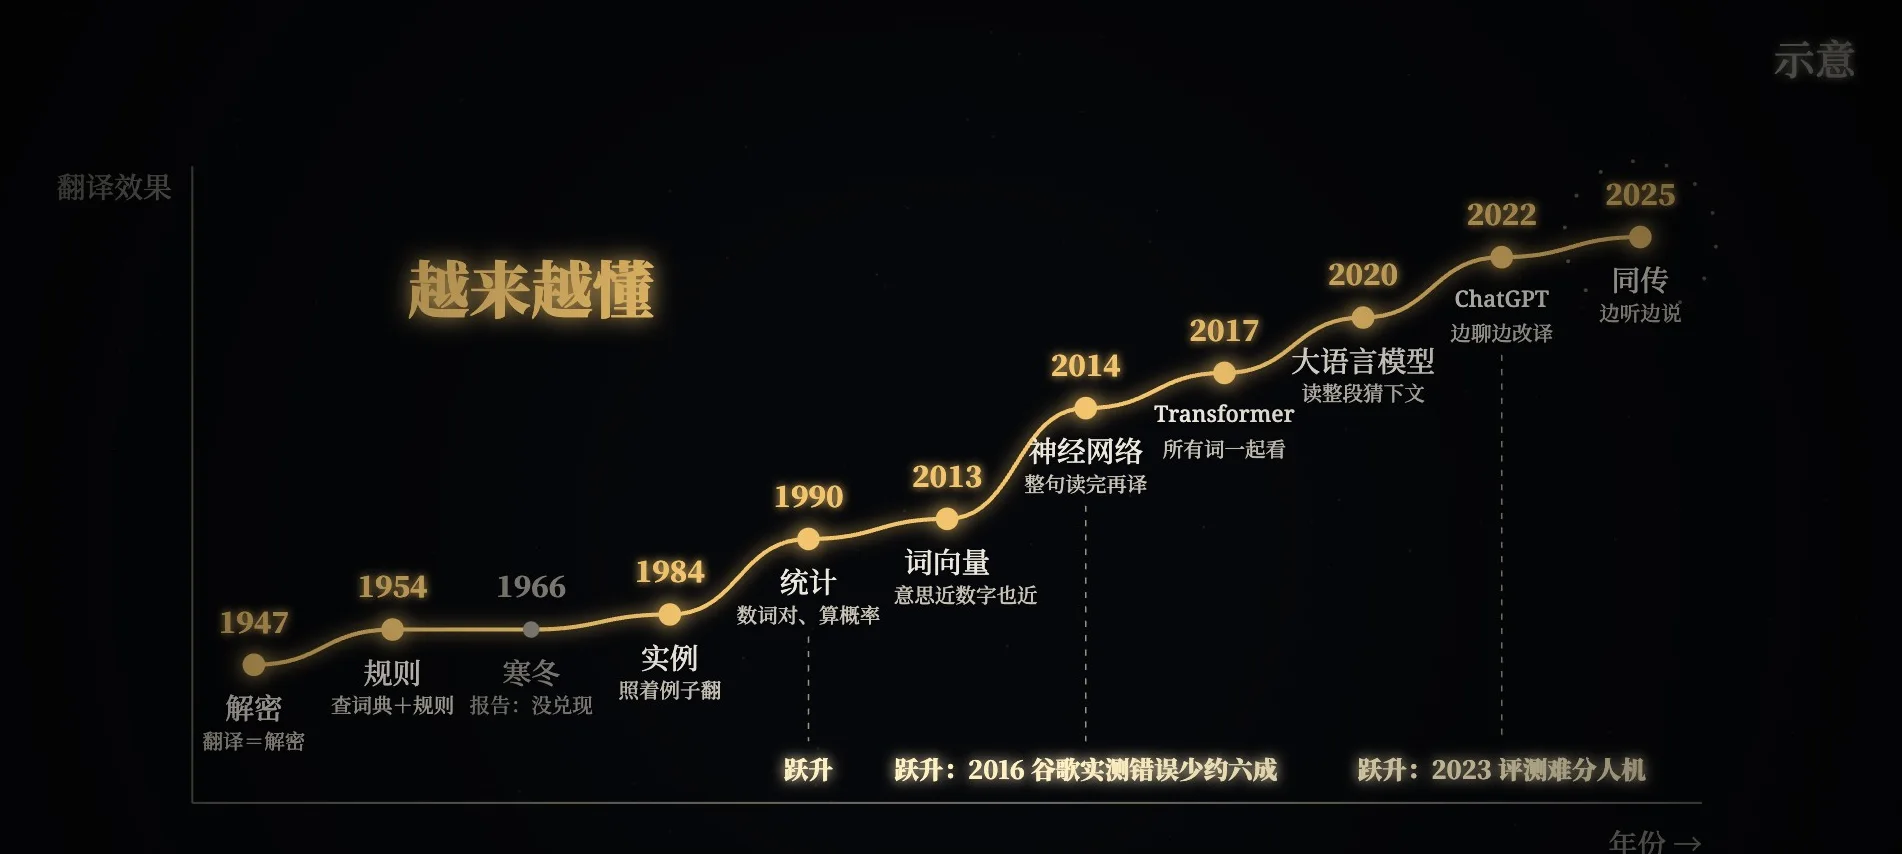
最早,人们以为翻译只是一道密码破译题,只要在两门语言之间找到对应的符号就行。后来在一次次碰壁中才发现,死板的语法规则永远写不完语言里的例外,只知道数词对出现次数的统计翻译也抓不住真正的意思。
机器翻译每往前迈一步,都是在比上一步多读懂一层人类语言:
- 第一级台阶:符号(1954—2013)。无论是人写词典和语法的规则翻译,还是靠海量句对数词频的统计翻译,机器眼里的词都只是孤立的符号,只在做符号之间的对号入座。
- 第二级台阶:词义(2013)。词向量把每个词变成几百个连续的数字,让机器第一次算出了词与词之间的意思远近,学会了举一反三。
- 第三级台阶:句子(2014—2017)。从循环神经网络、注意力机制到 Transformer,机器学会了把整句话读成一份记忆,并在句子内部靠自注意力互相打量,根据整句话的搭配敲定每个词的含义与词序。
- 第四级台阶:上下文(2020 至今)。大语言模型把视野从一句话拉长到一整段话甚至整场对话,结合前文场景、语气要求乃至说话人的声音,给出恰如其分的译文。
就像开头那句再普通不过的「我昨天在北京见了他」,哪怕只是把几个词调换到合适的位置上,要翻好它,也得先读懂它。因为翻译从来不只是换符号;翻译,是理解。
参考资料
- 韦弗 1947 年 3 月 4 日致维纳的信;1949 年备忘录《Translation》
- 1954 年 Georgetown–IBM 实验
- ALPAC 报告(1966):Language and Machines: Computers in Translation and Linguistics https://nap.nationalacademies.org/catalog/9547
- 加拿大 METEO 天气预报翻译系统(1981 年起)
- 长尾真(1984):A Framework of a Mechanical Translation between Japanese and English by Analogy Principle
- 统计机器翻译,Brown 等(1990):A Statistical Approach to Machine Translation https://aclanthology.org/J90-2002/
- 谷歌翻译 2006 年上线(统计机器翻译)
- word2vec,Mikolov 等(2013):Efficient Estimation of Word Representations in Vector Space https://arxiv.org/abs/1301.3781
- 序列到序列,Sutskever 等(2014):Sequence to Sequence Learning with Neural Networks https://arxiv.org/abs/1409.3215
- Cho 等(2014):Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation https://arxiv.org/abs/1406.1078
- 注意力机制,Bahdanau 等(2014):Neural Machine Translation by Jointly Learning to Align and Translate https://arxiv.org/abs/1409.0473
- 百度 2015 年上线神经机器翻译;谷歌,Wu 等(2016,错误平均少约六成):Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation https://arxiv.org/abs/1609.08144
- Transformer,Vaswani 等(2017):Attention Is All You Need https://arxiv.org/abs/1706.03762 ;被引次数据 Nature(2025):Exclusive: the most-cited papers of the twenty-first century https://www.nature.com/articles/d41586-025-01125-9
- GPT-1(2018):Improving Language Understanding by Generative Pre-Training https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf ;GPT-2(2019):Language Models are Unsupervised Multitask Learners https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- GPT-3,Brown 等(2020):Language Models are Few-Shot Learners https://arxiv.org/abs/2005.14165
- 规模定律,Kaplan 等(2020):Scaling Laws for Neural Language Models https://arxiv.org/abs/2001.08361
- GPT-4 Technical Report(2023,参数量未公布;约万亿级为 Semafor 报道,未证实)https://arxiv.org/abs/2303.08774
- Briakou 等(2023):Searching for Needles in a Haystack: On the Role of Incidental Bilingualism in PaLM's Translation Capability https://arxiv.org/abs/2305.10266
- ChatGPT:OpenAI 2022 年 11 月 30 日发布说明 Introducing ChatGPT https://openai.com/index/chatgpt/
- WMT23(2023):Findings of the 2023 Conference on Machine Translation (WMT23): LLMs Are Here But Not Quite There Yet https://aclanthology.org/2023.wmt-1.1/
- Translatotron,Jia 等(2019):Direct speech-to-speech translation with a sequence-to-sequence model https://arxiv.org/abs/1904.06037
- STACL,Ma 等(2018):STACL: Simultaneous Translation with Implicit Anticipation and Controllable Latency using Prefix-to-Prefix Framework https://arxiv.org/abs/1810.08398
- Moshi(2024,实时语音对话模型):Moshi: a speech-text foundation model for real-time dialogue https://arxiv.org/abs/2410.00037
- Hibiki(2025):High-Fidelity Simultaneous Speech-To-Speech Translation https://arxiv.org/abs/2502.03382
- Seed LiveInterpret 2.0(2025):Seed LiveInterpret 2.0: End-to-end Simultaneous Speech-to-speech Translation with Your Voice https://arxiv.org/abs/2507.17527