看剧学外语关掉字幕就听不懂?可理解性输入与双语字幕三阶段进阶法
 意扣 Equalang
导读
追了几百集外语剧,关掉中文字幕依然听不懂?本文结合可理解性输入(i+1)原理,提供三阶段双语字幕看剧法、CEFR 选片矩阵与口语提取模板。
关键词:双语字幕学外语;可理解性输入;看美剧学英语;双语字幕插件;外语听力训练
周五晚上十一点,当我们终于刷完一部热门美剧或西语剧,满怀信心地关掉底部的中文字幕准备二刷时,熟悉的角色一开口,传进耳朵里的依然是一串黏糊糊的连读音节——除了几句简单的打招呼,核心笑点和剧情转折全靠猜。
我们很多人都踩过这个坑:明明投入了几百个小时看原声剧、刷外语博主,为什么听力还是原地踏步?二语习得领域的经典研究给出了很扎心的结论:当我们看剧时只盯着底部的纯母语字幕,练的根本不是外语听力,而是中文快速阅读。
这篇文章不讲空泛的“坚持多听”,而是结合语言学中的“可理解性输入”理论,带来一套能直接落地的三阶段双语字幕进阶法、按 CEFR 等级划分的选片矩阵,以及一份每次只记 5 个高频表达的语料提取模板。
一、为什么单看母语字幕练不出听力?拆解 Krashen 的 i+1 输入假说
语言学家克拉申(Stephen Krashen)提出过著名的输入假说(Input Hypothesis):人类习得语言靠的是接触大量可理解性输入(Comprehensible Input),即公式 i + 1:
i(当前水平):我们目前已掌握的词汇与听音能力。+ 1(略高半阶的增量):借助情境与辅助提示,刚好能理解的那一小部分新表达。
为什么我们看剧容易失效?因为我们常在两个极端之间反复横跳:
- 只看中文字幕(
i + 0纯母语阅读):大脑天生追求省力。当熟练的汉字与陌生语音同时出现,视觉瞬间接管注意力,大脑直接屏蔽了语音切分,看剧变成了带背景音的中文速读。 - 硬啃无字幕生肉(
i + 10无效噪音):连读、弱读与俚语同时砸来。一旦每分钟有超过三成句子抓不到主干,声音就退化成了白噪音,除了挫败感很难沉淀出语言习得。
多项二语习得实证研究表明:让外语原文与母语译文建立即时对齐,并在熟悉剧情后逐步撤掉母语拐杖,才是把影视素材转化为 i + 1 有效输入的科学路径。
二、怎么挑对你的 i+1 素材?CEFR 分级选片矩阵
判断一部剧或视频是不是我们的 i + 1,可以用**“三分钟测试法”**:开启双语字幕看三分钟,如果看着外语原文能理解 75%–85% 的词句,剩下 15%–25% 扫一眼中文译文就能恍然大悟,这就是黄金训练素材。
三、三阶段双语字幕看剧法:把一集 20 分钟榨出多倍价值
选好片子后,不用一口气连刷十集。针对核心素材,建议采用**“三遍递进工作流”**。
在语言输入训练中,最常见的两难是:开着纯中文字幕容易退化为中文阅读,关掉字幕硬啃生肉又常因语速飞快而受挫。解决这个痛点的关键,在于让外语原声、原语言字幕与母语译文在视线范围内即时对齐。
这一步需要视频播放器支持双语字幕同屏或实时语音识别。下面以 Equalang(意扣)浏览器插件 为例演示完整工作流;在日常学习中,也可以对照选用业界其他工具(例如 Language Reactor 适合在 YouTube/Netflix 上进行字幕精读,本地离线视频可借助 PotPlayer 等播放器挂载双语字幕轨)进行类似训练。
第一阶段:双语同屏对齐期(第 1 遍,建立“声音—外语—母语”三角映射)
第一遍的目标是弄清剧情,把听到的声音碎片和外语单词对上号。
在电脑浏览器打开 YouTube、Netflix、哔哩哔哩或 Viki 等视频网站,开启播放器自带的原语言字幕(如英语 CC),再点击播放器右下角插件图标开启「字幕翻译」,模式选择「双语字幕」,译文位置选择「原文下方」。
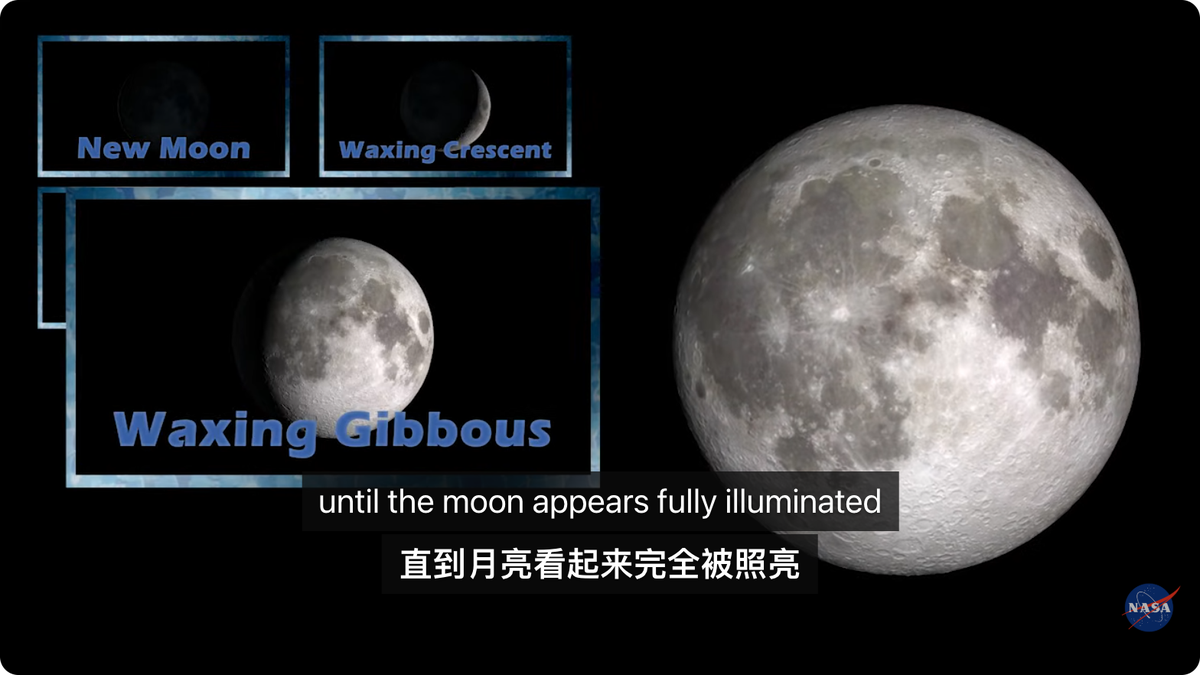
如上图 NASA Johnson 的《STEMonstrations: Moon Phases》科普短片实测所示,上方显示英语原字幕 until the moon appears fully illuminated,下方紧贴中文译文 直到月亮看起来完全被照亮。
视线习惯是:眼睛盯紧第一行外语原文,只有长难句卡壳时才用余光扫一眼下方的中文。 这样既不用频繁按空格暂停,又能把耳边的连读发音直接挂载到外语词形上。
实操与边界提醒:若视频使用的是平台自动生成的 CC 字幕,由于原音断句或专有名词发音模糊,原字幕偶尔可能存在偏差;此外,画面内原本压制的硬字幕属于图像像素,字幕插件仅处理字幕轨道,不会翻译视频画面内的图形文字。
第二阶段:外语为主与无字幕片段补齐期(第 2 遍,排查听音盲区)
隔天或稍后进入第二遍,我们要开始逐步撤掉母语拐杖。
如果遇到没有原文字幕轨的视频(比如 Netflix España 在 YouTube 官方频道发布的西语剧《Valeria》官方预告片,原片未内置字幕轨),可以打开播放器上的控制面板,开启「实时听译」并指定原语言(如西班牙语)。
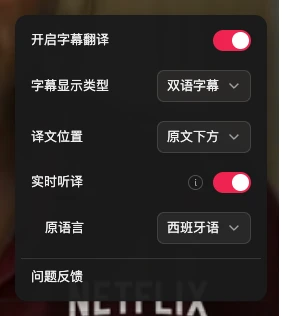
开启后,插件会根据视频音频实时生成语音识别原文与中文译文:
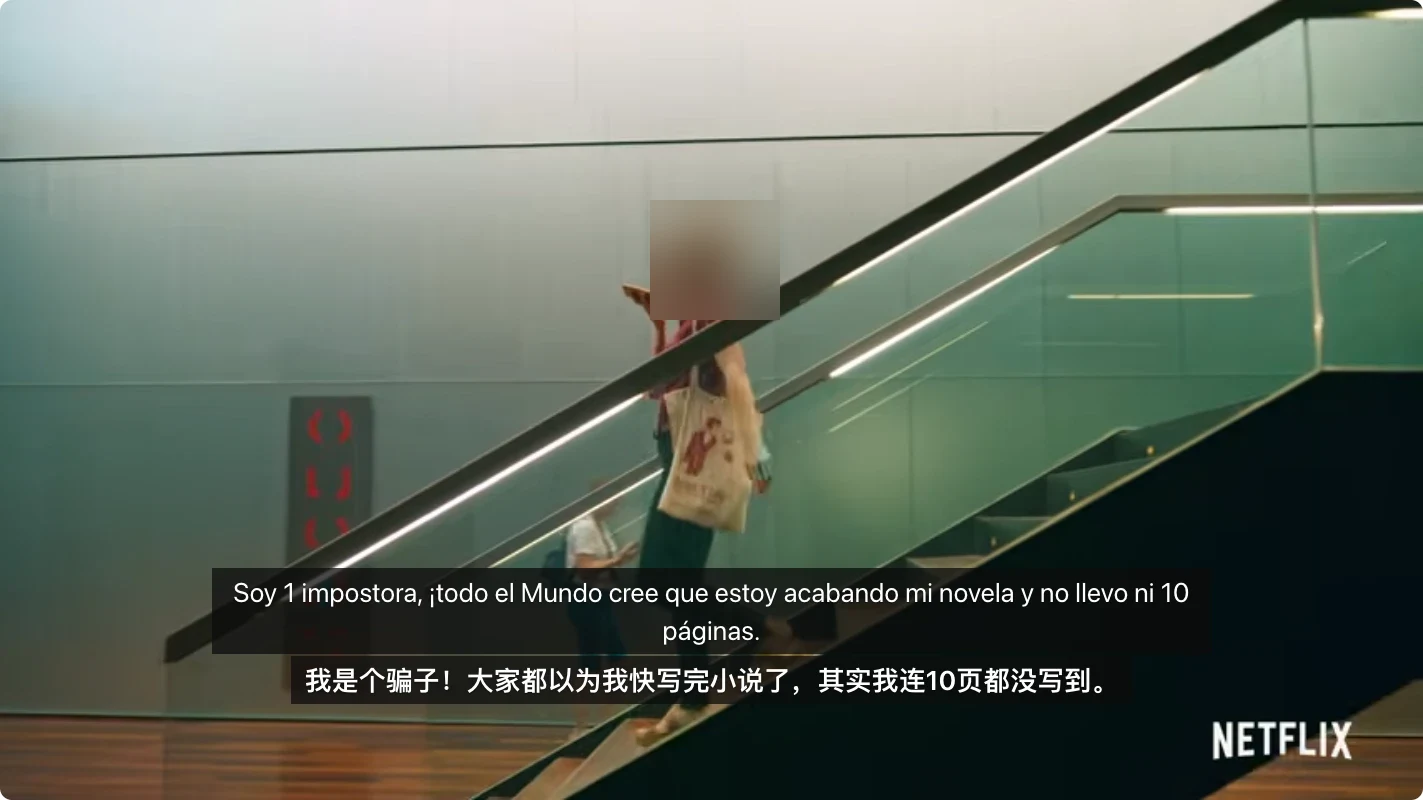
如《Valeria》预告片第 16 秒实测,女主角快步下楼抱怨,实时听译在画面下方生成了识别出的西语原文 Soy 1 impostora, ¡todo el Mundo cree que estoy acabando mi novela y no llevo ni 10 páginas. 以及中文 我是个骗子!大家都以为我快写完小说了,其实我连10页都没写到。
这里有两点技术与使用边界需要客观说明:
- 实时听译依赖语音识别:如上图中口语
una识别成了发音相近的数字1;当视频内出现强烈背景配乐(BGM)、爆破音效或多人抢话重叠时,识别率会受到一定干扰,无法保证逐字无误。 - 正版流媒体加密限制:此截图来自 YouTube 上的公开预告片。如果在 Netflix 正站(
netflix.com)看正片,受浏览器 DRM 加密保护,音频流无法被外部扩展捕获进行实时听译;但在 Netflix 正站上,只要剧集自带原字幕轨,依然可以直接使用字幕翻译功能生成双语同屏字幕。
在第二遍中,一旦遇到“不看字幕耳朵听不出”的吞音弱读(如西语 estoy acabando 元音连读,或英语 gonna / should've 弱读),倒回重听三遍并记入语料表。
第三阶段:关字幕盲听与跟读内化期(第 3 遍,完成闭环)
第三遍通常在通勤或做家务时关掉字幕只用耳朵听。因为大脑已经建立了“声音—词块—情境”索引,原本机关枪一样的台词会变得清晰可辨。挑出地道表达进行影子跟读(Shadowing),语感才能真正内化。
四、拿来即用的“看剧语料提取表”(每次只记 5 个高频词块)
看剧学外语最忌讳每分钟暂停去抄几十个生僻词。记住一个原则:核心是积累母语者常用的“语块(Chunks)”和地道反应。每集严格限制最多挑 5 个表达:
把这张表存在笔记软件里,每周积累 15 个带声音记忆的高频语块,远比死背两百个单词更扎实。
五、今晚就可以开始的 15 分钟看剧实验
不需要等到周末或专门抽出两小时,今晚找一部 10 分钟左右的短视频即可开始第一轮实测:
- 准备双语同屏环境:在浏览器中装好双语字幕工具,确认播放器能正常加载原语言字幕与母语译文。
- 选定一段
i + 1视频:参考上文的 CEFR 分级矩阵挑一个短片(初级可选动画片段或街头采访,中高级可选科普短片或情景剧选段)。 - 执行三遍递进法:
- 第 1 遍开双语同屏,视线锚定外语原文,遇生词扫中文辅助理解;
- 第 2 遍只看外语字幕,重点排查吞音与连读;
- 挑出 3–5 个地道语块填入语料表,关掉字幕复听跟读一次。
坚持用具体的语块替代死记硬背,耳朵对真实语流的钝感就会在每天 15 分钟的积累中逐步消退。
参考资料 / Sources
- Krashen, S. D. (1985). The Input Hypothesis: Issues and Implications. Longman.
- Vanderplank, R. (2016). Captioned Media in Foreign Language Learning and Teaching. Palgrave Macmillan.
- Montero Perez, M., et al. (2013). Captioned video for L2 listening and vocabulary learning. System, 41(3), 720–739.
- NASA Johnson. STEMonstrations: Moon Phases(实测源片):https://www.youtube.com/watch?v=SDhlPEMkiOo 与 NASA 科普页 https://www.nasa.gov/stem-content/stemonstrations-moon-phases/
- Netflix España. Valeria | Tráiler oficial(无原字幕实时听译实测源片):https://www.youtube.com/watch?v=V1uFnwhUSs0
- Equalang(意扣)浏览器插件官方说明:https://equalang.com/zh-CN/extension