用 AI Agent 批量翻译论文文件夹:
 意扣 Equalang
导读
针对研究生、实验室助理与知识管理者,提供一套用 AI Agent 处理整批 PDF 论文文件夹的可执行流程,涵盖文件命名整理、估价确认、失败任务追踪与双页对照阅读。
关键词:PDF批量翻译, 论文文件夹翻译, AI Agent文献处理, 双页对照阅读, Equalang, 意扣
拿到导师发来的课题组文献包,或是从数据库刚导出的 20 篇 PDF 论文,逐个打开网页上传、等待、下载、重命名,不仅打断阅读节奏,还容易在下载目录里留下一堆 10.1038_s41586-023-xxx (1).pdf 这样难以辨认的文件。遇到几篇中途报错的文档,最后还得人工比对到底漏了哪一篇。
如果使用能加载 Skill 并访问本地文件的 AI 助手,你可以把「逐个上传和整理文件」的机械动作交给它:让助手扫描指定文件夹,先对每篇 PDF 分别估价并汇总,等你一次确认后,按顺序逐个处理并把结果保存在原目录中。
下面是一套从 20 个混乱 PDF 到直接进入双页对照阅读的完整工作流。
为什么成批处理文献总是乱套?
在实验室文献汇总或系统性综述(Systematic Review)初筛阶段,手动处理整批 PDF 通常会卡在三个地方:
- 文件名毫无规律:直接从出版商或文献管理软件导出的 PDF,文件名往往是期刊缩写、DOI 编号或乱码,翻译后很难和原文一一对应。
- 译件与对照文件四处散落:原文在课题文件夹,下载的译文在系统默认下载目录,过两天就分不清哪个是纯译文、哪个是用于对照阅读的版本。
- 异常中断难以排查:20 篇文献里只要有两三篇因为扫描件或文件损坏处理失败,手动记录进度非常繁琐,重跑时还容易重复提交已经翻译好的文件。
把这套流程交给本地 AI Agent 的核心逻辑,不是追求「20 篇同时并发」,而是用一套清晰的目录与命名约定,让助手替你完成排队、核对和归档。
第一步:整理待处理文件夹与命名规范
在唤醒 AI 助手之前,先花两分钟把待处理的 20 篇 PDF 放进同一个工作目录(例如 ./papers-batch-01/),并统一命名规则。清晰的前缀能让后续排查和阅读省去一半时间。
建议采用 序号_第一作者_年份_简短主题.pdf 的格式。你可以直接让本地 AI 助手帮你批量重命名,或者整理成如下结构:
01_Smith_2023_Battery_Degradation.pdf02_Chen_2024_Solid_Electrolyte.pdf03_Muller_2022_Thermal_Runaway.pdf
整理时顺手做一次初筛:
- 剔除纯扫描件或加密文件:如果某篇早年文献是纯图片扫描且无文字层,或者带有复制与打印密码限制,建议先单独移出,避免在批处理队列中直接报错。
- 把补充材料(Supplementary Information)分开存放:动辄上百页的附图和原始数据表往往不需要全文翻译,放进单独的
suppl/子目录可以节省额度与处理时间。
第二步:用 AI Agent 加载 Skill 并执行一次确认流程
当你的 AI 助手支持访问本地文件系统,并加载了意扣(Equalang)的官方 Skill(或通过 MCP 接入)时,助手就可以按你的要求逐个处理文件夹内的 PDF 文档。具体支持接入的入口与配置方式以正式页面说明为准。
需要注意的是,这并不是调用某个「原生并发批量接口」,也不建议让几十份任务在后台盲目同时运行。更稳妥的做法是在给 AI Agent 的指令中明确约定工作流:让助手先遍历文件夹中的 PDF,如果所接入的工具提供估价或预检能力,就先逐个估价并汇总清单,向你发起一次确认后再开始处理。
你可以直接向 AI 助手发送类似下面的指令来约定流程:
请读取
./papers-batch-01/目录下所有
这个「先分别估价、合计后一次确认」的环节有两个实际作用:
- 核对账单与范围:在真正扣费或消耗额度前,你能清楚看到每篇论文的页数和预计消耗,防止把几百页的附录误塞进队列。
- 提前揪出问题文件:如果某个 PDF 无法解析或读取失败,在估价阶段就会暴露出来,不用等到翻译了一半才发现异常。
当你回复确认后,助手就会按顺序逐个提交并等待结果返回。
第三步:文件归档约定与失败任务追踪
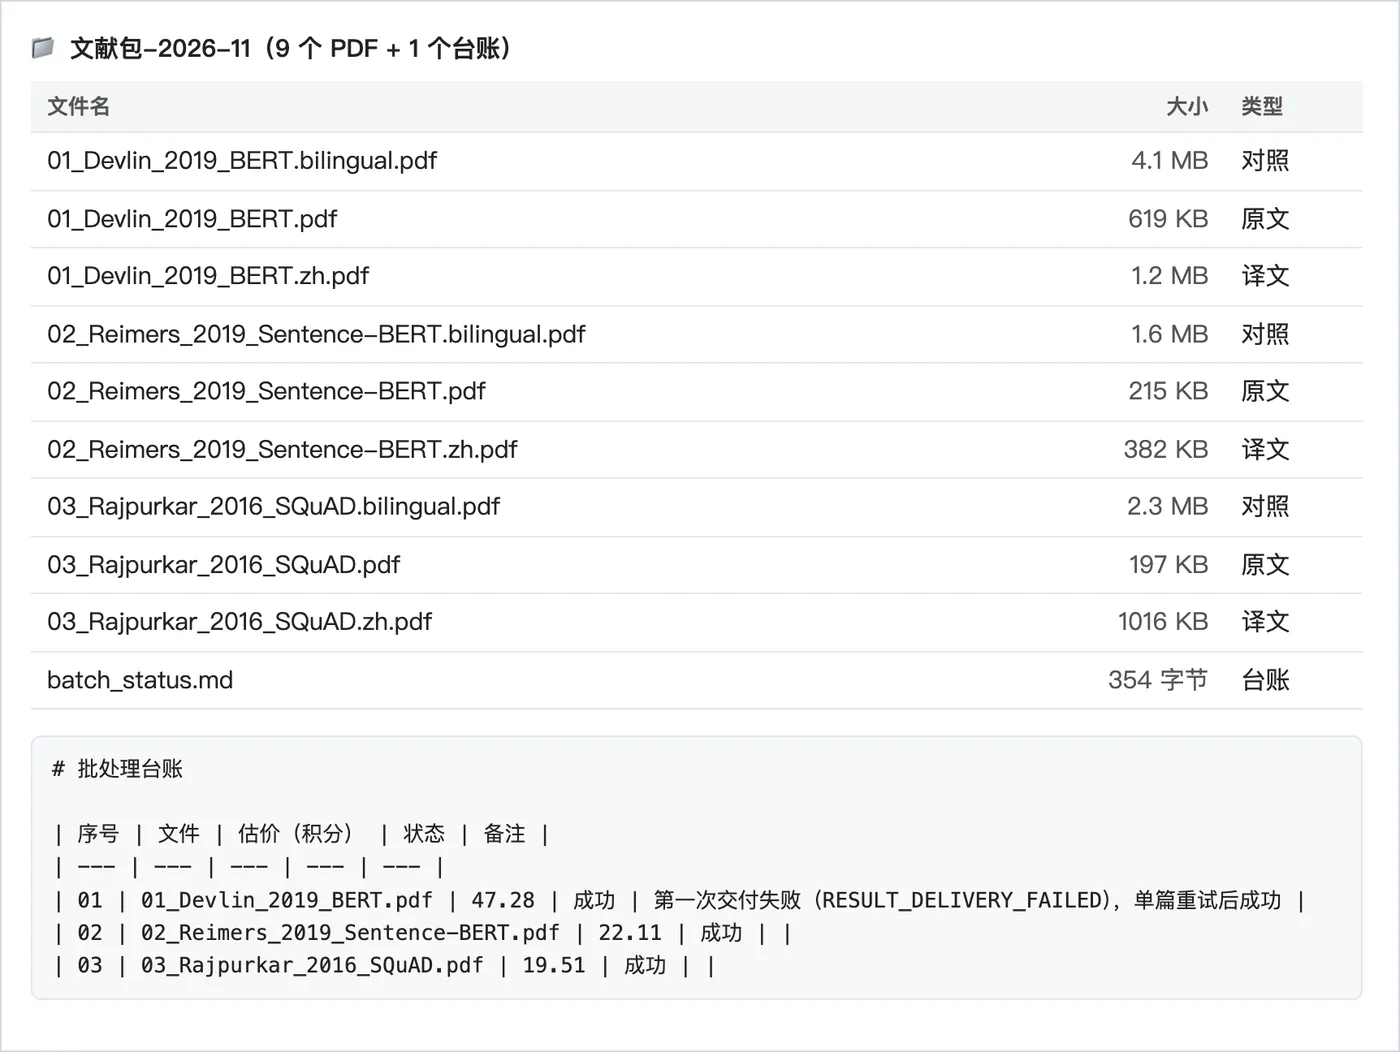
为了让这一批文献的原文和翻译产物井然有序,你可以在给 AI Agent 的指令中要求它将生成的翻译结果保存在原文件所在目录,按固定后缀整理文件名,并生成一份状态记录表(如 batch_status.md)。具体生成的文件数量与是否包含整合版,均以工具实际返回的结果为准。
建议在同一目录或子目录中区分以下文件角色:
如何追踪和重试失败任务?
逐个处理多篇 PDF 时,可能会遇到个别文件因网络波动或排版极端复杂而未完成。此外还需要注意:不同任务实际返回的产物数量可能不同,并非每次都会生成供双页阅读的整合版文件,具体以实际返回为准。
因此,在助手跑完一轮队列后,让它检查当前目录下的产物并输出一份核对清单:
- 成功且齐全:原文、纯译文和整合版均已保存在目录中,标记为
[已完成]。 - 仅返回纯译文,缺少整合版:记录在清单中,阅读时直接采用纯译文配合原文窗口,或单独检查该文件。
- 处理失败:助手只需针对标记为
[失败]的那 1–2 个文件重新发起估价与单篇重试,无需把整个文件夹重跑一遍。
第四步:进入双页对照阅读与人工复核
当批处理全部落盘后,你就拥有了一套命名整齐的本地文献库。对于已经生成了整合版的文件,可以直接在支持双页视图的 PDF 阅读器中打开,进入左原文、右译文(或对应双页排版)的对照阅读模式。
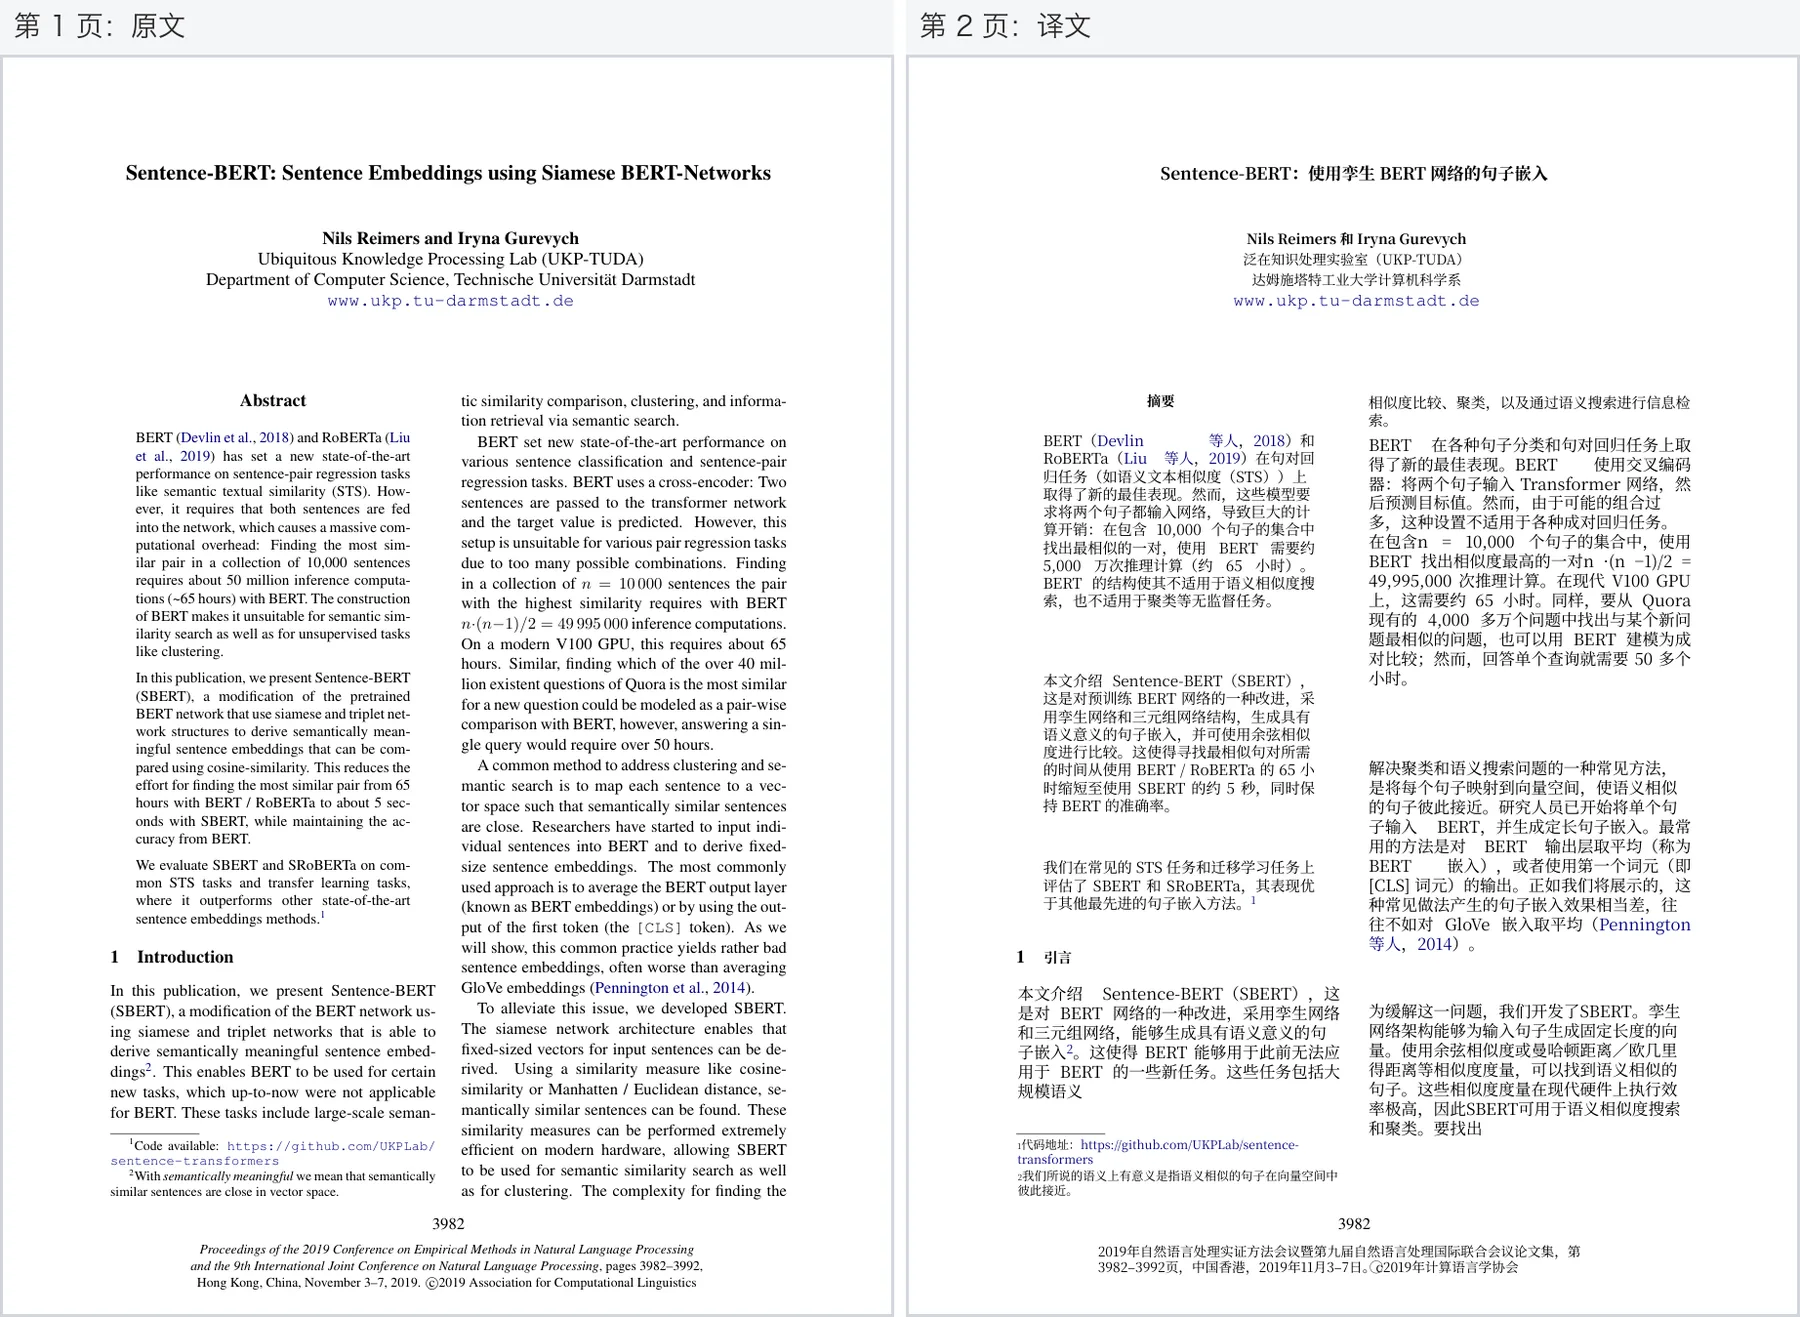
在利用意扣(Equalang)生成的文档进行文献精读、组会汇报或撰写综述引用时,务必了解工具的边界并做好人工复核:
- 复杂版面与图表细节:学术 PDF 中常有跨栏表格、密集子图标签、页眉页脚粘连或特殊排版公式。文档翻译在版面还原与文本提取上存在客观局限,不能替代对原图的直接查看。
- 新兴术语与缩略语:如 Nature 相关探讨(The AI tools powering scientific literature reviews)所指出的,AI 工具能显著加速文献初筛与信息梳理,但科学判断仍需研究者把关。领域内刚出现的缩写、特定基因名或合成材料代号,直接采用字面译名可能引起歧义。
- 关键数据核对:凡是要写进你自己论文的实验参数、剂量、统计显著性(p 值)及核心推论,请在双页对照阅读时,以左侧英文原版的数据和表述为准进行逐一核实。
通过「规范命名 → 指令约定清单确认后逐个处理 → 要求保存在原目录并记录状态 → 双页对照与人工复核」这四个步骤,你可以把原本零散耗时的多篇论文准备工作,收敛成一次指令确认和清晰的本地文件队列,把精力真正留给文献精读与实验设计。
参考资料
- Nature: https://www.nature.com/articles/d41586-023-03448-1
- 配图使用的三篇示例论文(各取 2–4 页摘录,BERT 取的是原文第 1、3、6、7 页,ACL Anthology 以 CC BY 4.0 许可公开):Jacob Devlin 等,BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding,NAACL 2019,https://aclanthology.org/N19-1423/;Nils Reimers、Iryna Gurevych,Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks,EMNLP-IJCNLP 2019,https://aclanthology.org/D19-1410/;Pranav Rajpurkar 等,SQuAD: 100,000+ Questions for Machine Comprehension of Text,EMNLP 2016,https://aclanthology.org/D16-1264/。