从 arXiv 预印本到 Obsidian 文献卡片:
 意扣 Equalang
导读
结合 Keshav 三遍阅读法、双页对照 PDF 批量处理与可直接复制的 Obsidian 文献笔记模板,搭建不碎公式、不乱排版的日常文献工作流。
关键词:arXiv 论文精读; Obsidian 文献笔记模板; 学术 PDF 翻译保留公式; 三遍阅读法; 双语对照读论文
每周一早上打开 arXiv 每日推送,或是赶在组会(Lab Meeting)前突击刚放出的顶会录用论文列表,我们大概率都经历过同一种折磨:一口气往本地文件夹存了十几篇 PDF,点开第一篇硬啃双栏英文;读到第三页,跨栏长难句和密集符号让阅读速度断崖式下跌;把文字复制到普通翻译框里,原本工整的 LaTeX 行内公式、上下标、张量符号瞬间被拆成乱码,图表编号也全错位。折腾一整晚,读懂的没两篇,剩下的十几篇从此静静躺在下载文件夹里吃灰。
阻碍我们高效追踪前沿的,往往不是缺论文下载链接,而是**「初筛耗尽精力、排版与公式断裂打断推导、读完缺乏结构化沉淀」**这三个环节卡在了一起。
这篇文章梳理一套可直接复用的**「Keshav 三遍阅读法 → 双页对照论文批量整理 → Obsidian 结构化文献卡片」**完整流水线,文末附带一份开箱即用的 Markdown 笔记模板。
一、为什么我们的论文文件夹总是「只下不读」?
在动手搭工具链之前,先看清日常卡壳的三个瓶颈:
- 用精读的力气做初筛:下载的 PDF 篇篇从 Abstract 抠到 Method,耗费一小时才发现实验假设与自己的课题毫无关系。
- 版式与公式在复制中碎裂:双栏跨栏跨页截断,正文中夹杂 $\mathcal{L}{\text{total}}$、$\mathbb{E}{x \sim p_{\text{data}}}$ 等符号,普通翻译把上下标拆散、双栏串行,在原文译文间找坐标极耗心力。
- 只有高亮没有沉淀:PDF 涂满彩色标记,几个月后写开题或 Related Work 时,完全想不起关键结论在哪篇论文里。
打通这三点的稳妥路径,是将滑铁卢大学 S. Keshav 教授经典的「三遍阅读法(Three-Pass Approach)」与保留版式、公式的双页对照阅读结合起来。
二、Keshav「三遍阅读法」与双语对照的配合节奏
Keshav 教授在 How to Read a Paper 中提出,读论文绝不能从头到尾匀速推进,而应像雷达扫描一样分三轮完成。配合「左英右中」对照,节奏会格外清晰:
三、第一步:把攒下的 arXiv PDF 整理成「左英右中」双页对照本
对于母语为中文的研究者,硬啃双栏英文不仅速度慢,遇到长难句还容易打断定理推导;如果把 PDF 一段段复制到普通翻译工具里,排版和公式往往碎成一团。
这一步需要整篇翻译 PDF 并保留双栏排版与数学公式,生成可供左右并排阅读的双页对照本。完成这一步可以借助开源的 PDFMathTranslate、BabelDOC,或者在桌面端编写脚本批量调用模型;下面以 Equalang(意扣) 为例演示流转过程。
平时只有一两篇核心论文时,可以直接在网页端使用文档翻译上传处理;若需要对整个待读文件夹(例如 2026-W42-arXiv-Reading)集中整理,也可以通过开源的 Equalang Skill 配合桌面 AI 助手(如 Claude Code、Codex、WorkBuddy)批量打理:
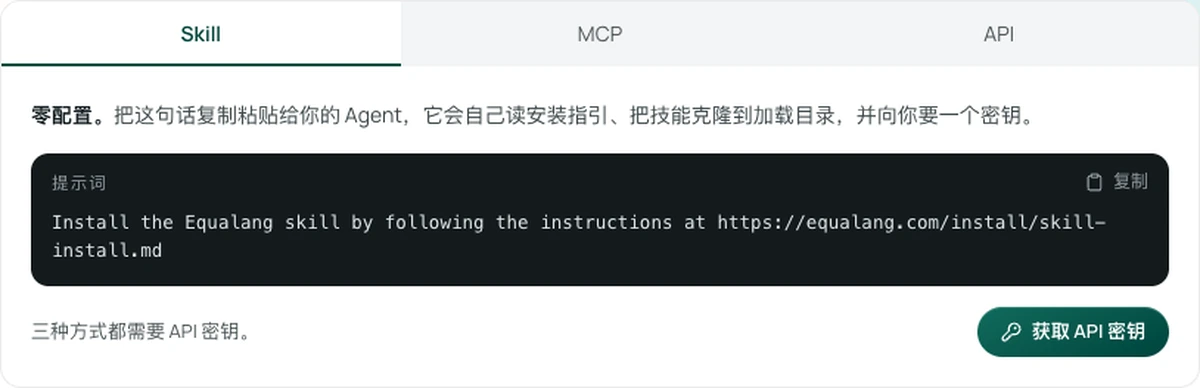
先估算、后执行:本地文件夹批量整理
在桌面助手里交代需求后,助手会先逐篇估算所需用量并汇总确认,再依次翻译、归档原稿与双页对照版本保存在本地目录中:
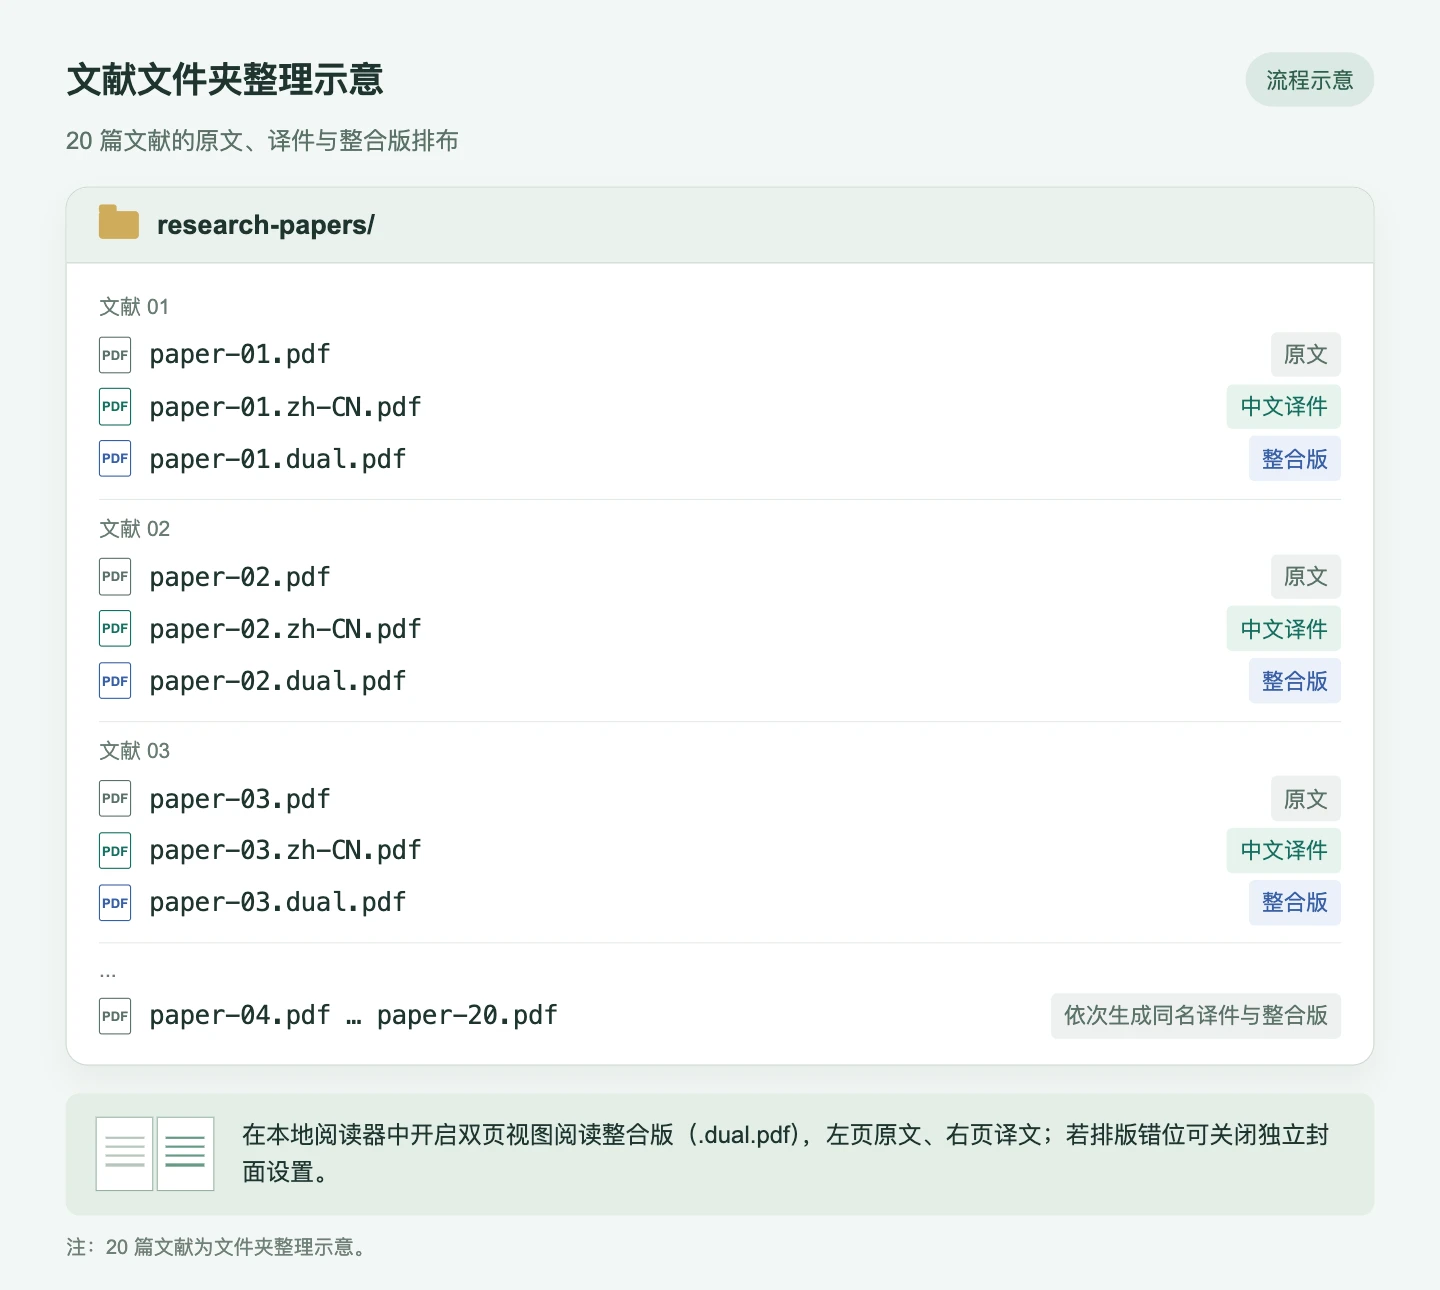
双页并排阅读设置技巧
拿到带有原译配对的整合版后,在 macOS 预览、PDF Expert 或 Acrobat 中开启**「双页视图」,并注意取消勾选「封面单独显示」**。这样屏幕左侧永远是第 $N$ 页英文原稿,右侧永远是第 $N$ 页中文译文:
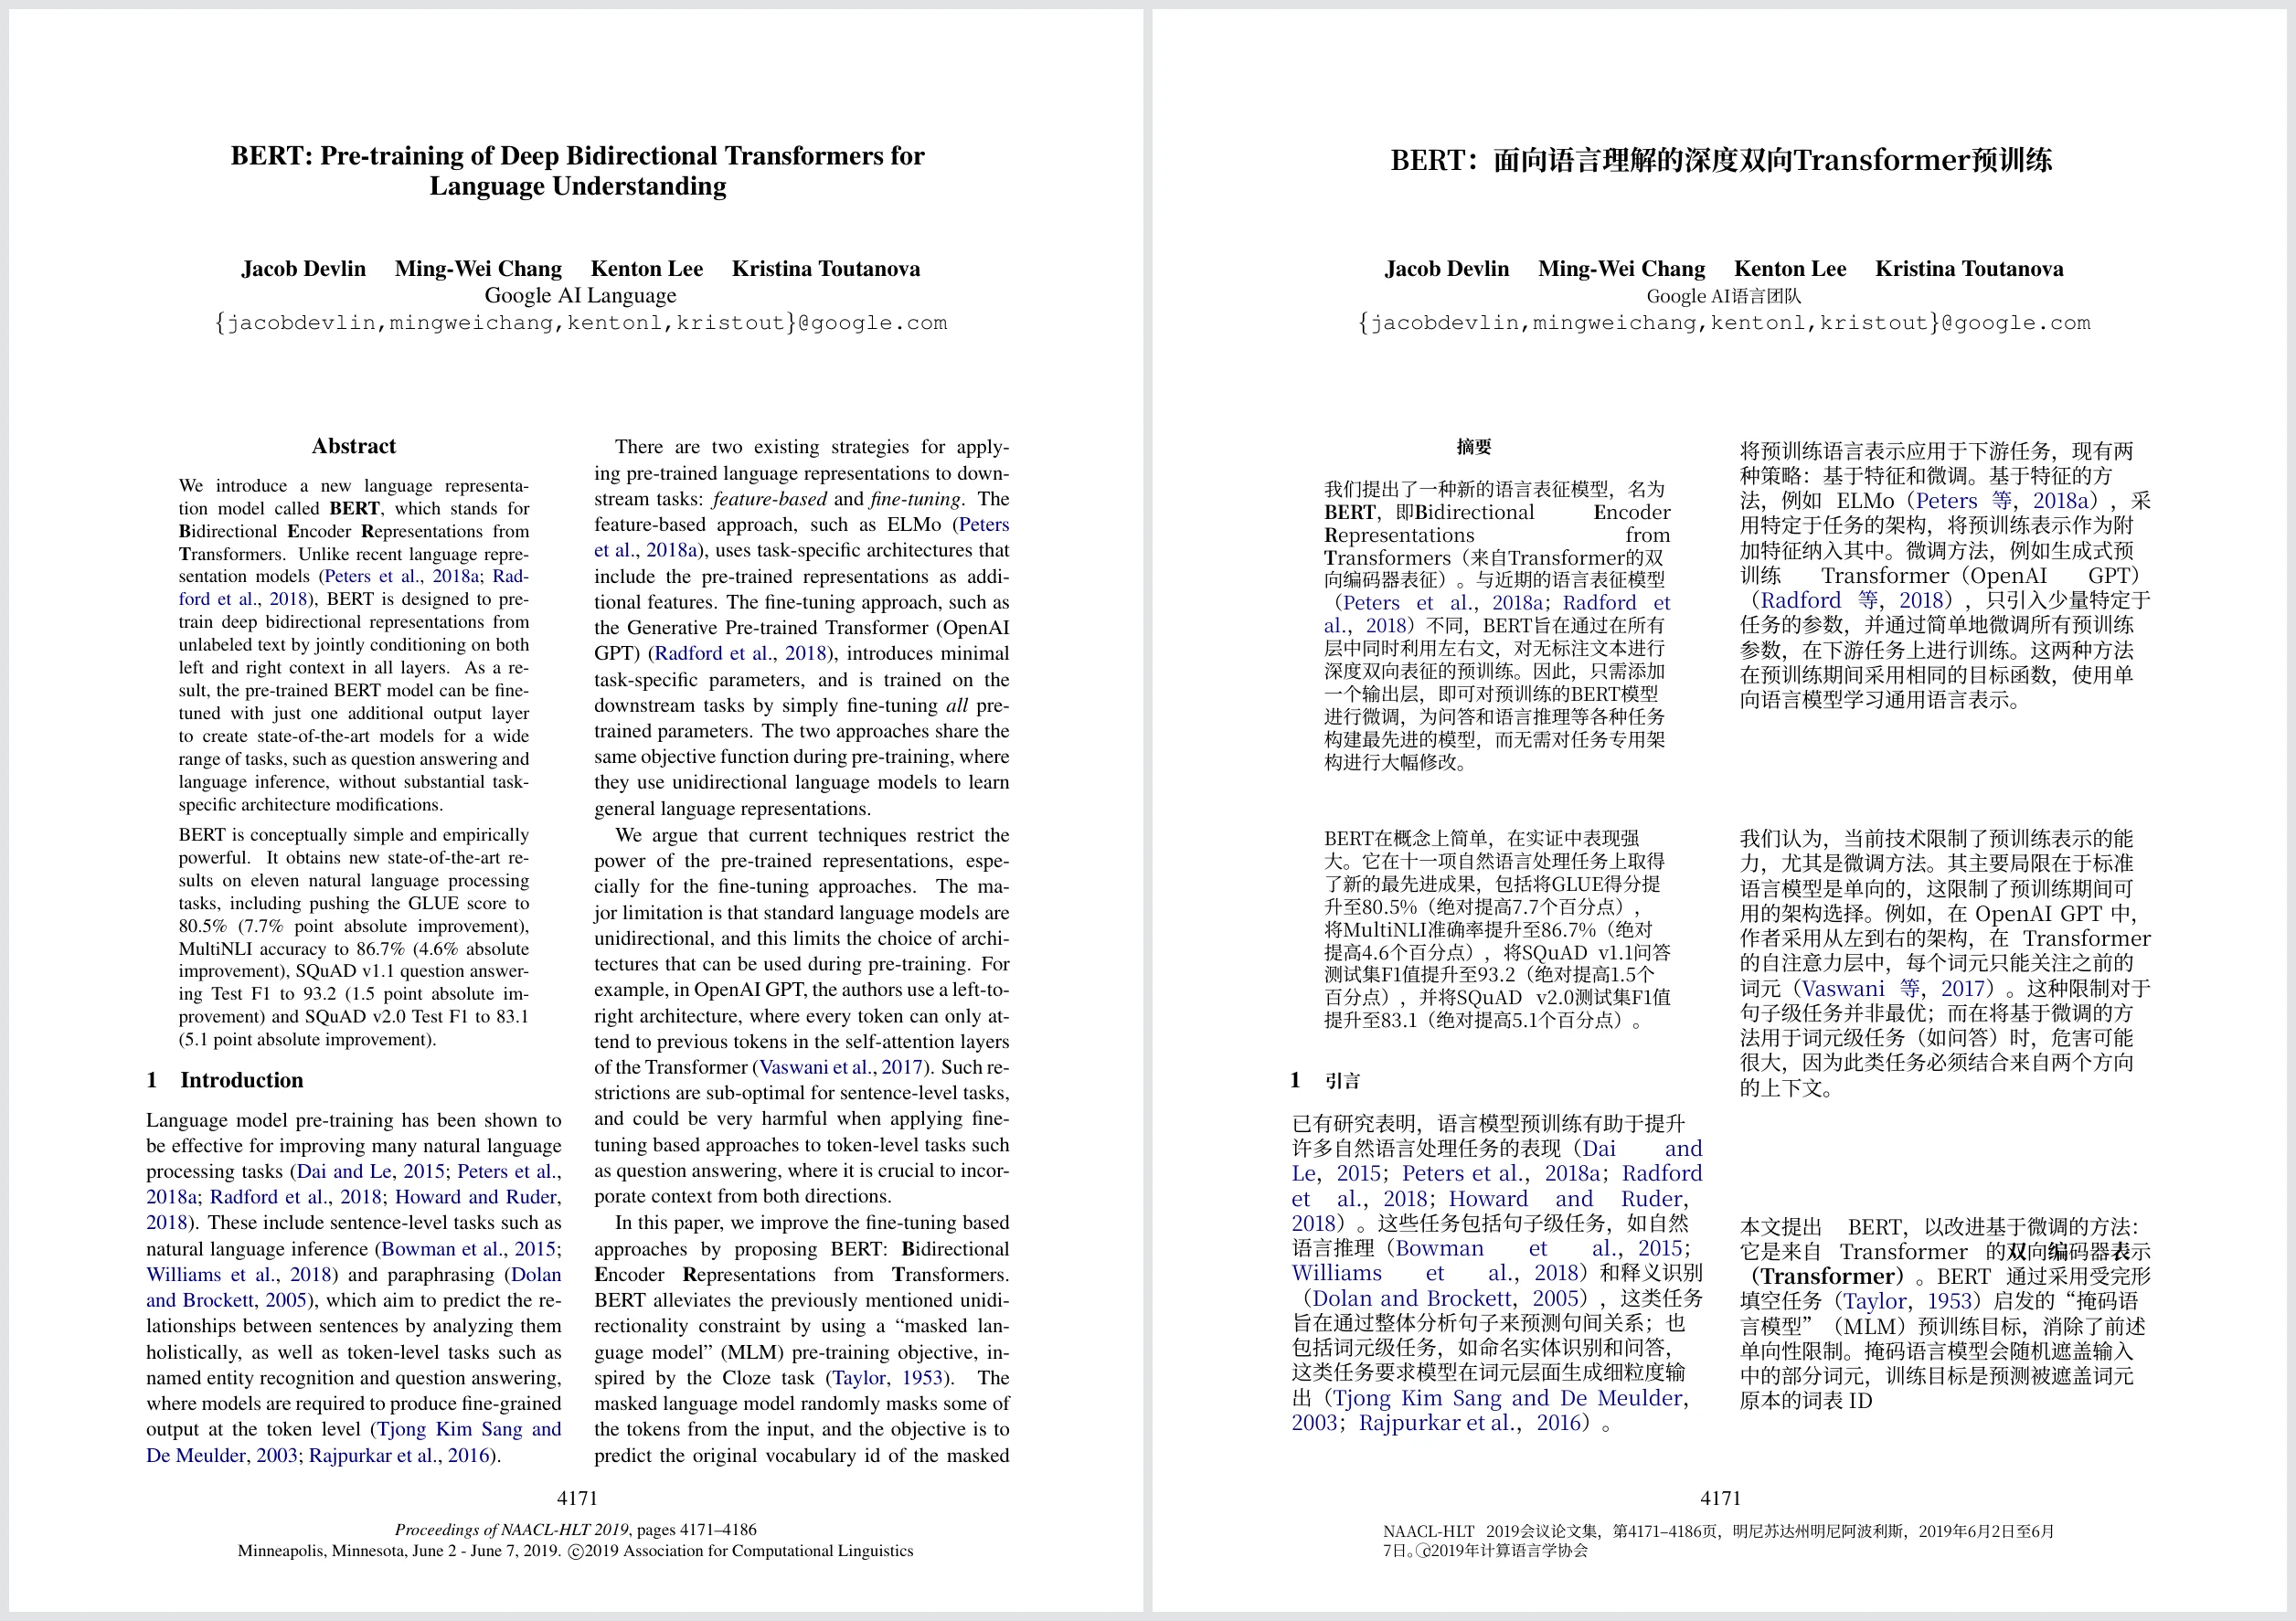
双栏排版、章节层级与表格位置保持对应;被页面底部截断的跨页英文长句也会在段落层级做连贯处理,避免上下语意割裂。
四、第二步:攻克核心公式与架构图(Pass 2 & Pass 3 实战)
到了第二遍与第三遍深度推导,决定能否看懂一篇论文的往往是损失函数、张量变换与网络框图。普通 PDF 翻译容易导致根号 $\sqrt{d_k}$、分式线与上下标漂移,或把行内变量误当普通单词。
针对公式密集的学术 PDF,可以在翻译时开启专门的**「公式优化」**选项。开启后,系统对独立公式与复杂行内符号进行重点保护与结构重建:
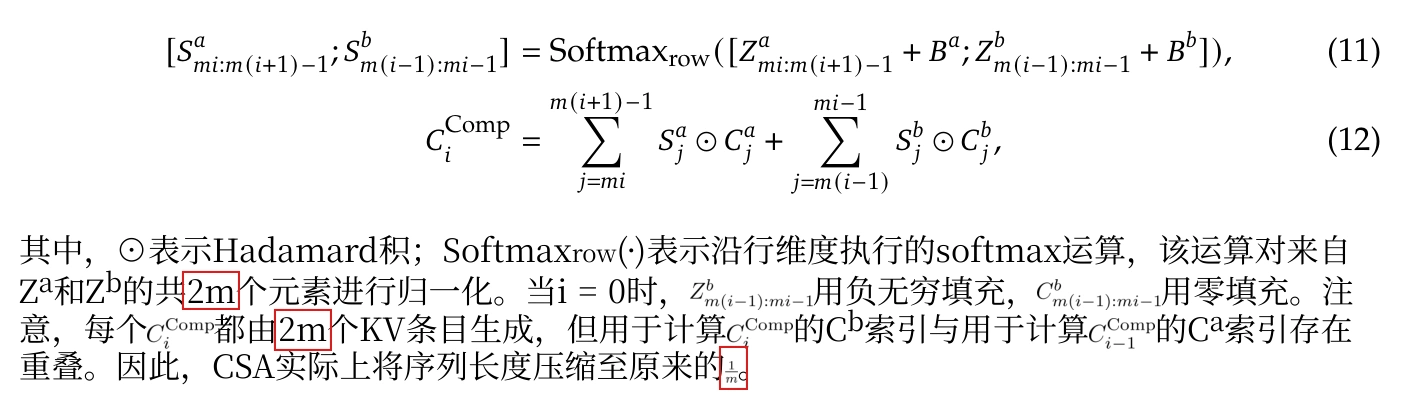
在核对 Transformer 论文(arXiv:1706.03762)与复杂技术报告时,有几个细节值得关注:
- 公式结构与编号对齐:缩放点积注意力分子 $QK^\top$、分母 $\sqrt{d_k}$ 及右侧公式索引编号
(1)均保持原位,正文引用清晰对应。 - 架构图模块对照:框图连接关系与虚线边界保留,「嵌入」「预测头」等标签对应呈现,关键英文缩写(如 CSA / HCA)维持原文不乱译。
- 客观复核建议:字体与字号会随译文长度微调。机器排版不能代替严谨的数学求证,写论文引用或编写代码前,务必以左侧英文原稿的符号定义为准交叉验证。
五、第三步:用这份 Obsidian 模板沉淀文献卡片
读完论文留下标记不等于掌握,沉淀进知识库的**结构化文献卡片(Literature Note)**才是后续撰写论文的基石。
可以直接将以下模板保存为 Obsidian 的 Templates/Literature-Note.md:
---
title: "{{title}}"
authors: []
year: 2026
venue: "arXiv / NeurIPS / ICML / ACL"
arxiv_id: ""
status: "unread" # unread | pass1 | pass2 | pass3-archived
rating: 4 # 1-5 星
tags:
  - paper/domain
  - method/architecture
pdf_en: "[[papers/xxx-original.pdf]]"
pdf_bi: "[[papers/xxx-bilingual.pdf]]"
created: "{{date}}"
---

# {{title}}

## 1. 一句话核心卡片(One-Liner)
- **解决什么痛点?**:在 [特定场景] 下,现有方法 [Baseline] 会因 [根因] 导致 [瓶颈]。
- **核心招数是什么?**:提出 [模块/算法],通过 [核心机制],在不增加 [某开销] 下实现 [核心效果]。

## 2. 核心方法与关键公式(Methodology & Equations)
> 摘录自双语对照 PDF 第 X 页,核对原稿符号定义:

- **张量定义**:输入 $X \in \mathbb{R}^{B \times L \times D}$,输出为……
- **核心目标函数**:
  $$\mathcal{L}_{\text{total}} = \mathcal{L}_{\text{task}} + \lambda \cdot \Omega(\theta)$$
- **直觉解释(为什么有效)**:……

## 3. 实验对比与消融结论(Experiments)
| 对比维度 | 本文方法 | 核心 Baseline 1 | 核心 Baseline 2 | 观察与疑问 |
| :--- | :--- | :--- | :--- | :--- |
| **主指标与数据集** | | | | |
| **算力/显存开销** | | | | |
| **消融实验关键结论** | 去掉模块 A 掉点 X% | — | — | 模块 A 贡献核心增益 |

## 4. 局限性与挑刺(Limitations & Critique)
- **作者承认的局限**:(见 Conclusion / Limitations 节)
- **隐含假设/短板**:如仅在特定序列长度验证、对超参数敏感等。

## 5. 对当前课题的启发(Actionable Links)
- **可复用代码/脚本**:仓库地址与核心算子位置
- **关联卡片**:与 [[前置研究]] 相比,本文改进了……
知识库高效运转的三个习惯
- 原稿与双语本挂进 YAML 属性:在
pdf_en与pdf_bi建立双链。查阅地道学术英文时点原稿,组会前快速唤醒记忆点双语本。 - 只记驱动代码与论述的公式:不必通篇照抄过渡推导,把最关键的目标函数敲进笔记,手敲本身就是一次扎实的 Pass 3 复核。
- 强制双向链接(
[[ ]]):每张卡片至少关联 1–2 张既有笔记。积累数十张后,Obsidian 关系图谱自然会浮现出一份立体的 Related Work 框架。
通过「三遍阅读法初筛 → 双页对照攻克图表公式 → 结构化卡片沉淀入库」这条主线,原本堆积在文件夹里的预印本 PDF 就能持续转化为随时可调用的研究资产。
参考资料 / Sources
- S. Keshav, How to Read a Paper, ACM SIGCOMM Computer Communication Review, Vol. 37, No. 3, 2007: https://ccr.sigcomm.org/online/files/p83-kashavA.pdf
- Equalang(意扣)文档翻译(支持学术 PDF 双栏排版与公式优化):https://equalang.com/zh-CN/documents
- Equalang Agent Skill 开源仓库:https://github.com/equalang/equalang-skill
- Obsidian 官方文档:https://obsidian.md