Ломаются формулы в статьях arXiv? Удобные инструменты перевода
 Equalang
Вкратце
Машинный перевод ломает формулы LaTeX и разрывает длинные фразы в двухколонных PDF? Разбираем барьеры и показываем решение с сохранением исходной верстки и параллельным сопоставлением оригинала и перевода бок о бок.
Ключевые слова: перевод статей arXiv; инструменты перевода научной литературы; сохранение двухколоночной верстки PDF; перевод математических формул LaTeX; параллельное чтение статей на двух страницах
Когда вы отслеживаете свежие препринты на arXiv или разбираете списки принятых статей на ведущие конференции, вы наверняка сталкиваетесь с невидимой преградой. Стоит скопировать фрагмент текста из двухколонного научного PDF в стандартное окно переводчика, как строгие математические формулы LaTeX, подстрочные и надстрочные индексы и знаки суммирования превращаются в бессмысленный набор символов. Дефисы и переносы слов (Hyphenation) между колонками и на стыках страниц разрывают слова, из-за чего машинный перевод выдает несвязные предложения. А когда перевод страницы наконец готов, нумерация графиков, таблиц и логика математических выводов оказываются нарушены, и бесконечное переключение между окнами для сверки отнимает все силы.
Главное препятствие при чтении передовых публикаций — зачастую вовсе не нехватка словарного запаса, а то, что формулы превращаются в абракадабру, двухколоночная верстка рассыпается, а сопоставить перевод с оригиналом невозможно, разрушая непрерывный ход исследовательской мысли.
В этой статье мы разберем базовые критерии выбора инструментов для перевода научной литературы, сравним возможности и ограничения решений с открытым исходным кодом и популярных сервисов, а также продемонстрируем эффективный процесс глубокого чтения статей, позволяющий сохранить формулы и оригинальную двухколоночную верстку.
1. Почему научные статьи — «крепкий орешек» для машинного перевода?
Обычные инструменты перевода (например, универсальные расширения для перевода выделенного текста или стандартные поля ввода) хорошо справляются со связным повседневным текстом, но перед научными PDF-документами часто пасуют. Это связано с тремя ключевыми техническими вызовами, характерными для академических публикаций:
- Переплетение математических формул LaTeX и специальных символов: в тексте статей встречается множество строчных переменных (например, $\theta_i, \mathbf{W}_Q$), индексов, сложных дробей и отдельных тензорных уравнений. Стандартные модели машинного перевода не распознают синтаксическое дерево верстки и часто воспринимают переменные как обычные английские слова, пытаясь перевести их как текст, а корень в знаменателе $\sqrt{d_k}$ дробят на несвязные знаки, из-за чего логика математического вывода полностью теряется.
- Двухколоночная верстка и физические разрывы страниц: формат PDF по своей сути представляет собой набор статических инструкций для печати и не содержит естественной структуры логического перетекания абзацев. При двухколоночной верстке обычные утилиты нередко считывают строки сквозь колонки по горизонтали. А длинные предложения, переходящие с нижней части одной страницы на следующую, разрезаются пополам, что приводит к грубым смысловым ошибкам перевода.
- Утрата нумерации рисунков, таблиц и перекрестных ссылок: схемы архитектур алгоритмов (Figure), таблицы результатов абляционных экспериментов (Table) и текстовые ссылки на конкретные уравнения (например, Equation 3) в процессе стандартного извлечения текста легко смещаются или теряются, нарушая доказательную базу публикации.
Поэтому качественный инструмент для перевода научной литературы должен обладать ключевым набором возможностей: структурный анализ верстки PDF + защита формул LaTeX на исходных местах + параллельное сопоставление оригинала и перевода.
2. Сравнение основных подходов к переводу научной литературы
В исследовательской практике распространены три основных подхода к переводу статей, и у каждого из них есть четкие границы применения:
Для задач, где одинаково важны точность формул, аккуратная верстка и возможность начать работу сразу без лишних настроек, мы покажем рабочий процесс на примере разработанного нашей командой сервиса Equalang.
3. Организация параллельного чтения двухколоночных статей за три шага
Чтобы чтение литературы было максимально плавным, можно сопоставлять оригинал и полученный перевод бок о бок для глубокого и сосредоточенного изучения.
Шаг 1. Полный анализ документа и включение оптимизации формул
Загрузите оригинальный PDF-файл, скачанный с arXiv, на странице перевода документов в веб-версии Equalang. Для научных публикаций по физике, математике или компьютерным наукам с большим количеством математических выражений система на этапе анализа обеспечивает приоритетную защиту внутристрочных символов и выносных уравнений.
Если длинное предложение обрывается внизу страницы, система предварительно объединяет его части на уровне логической структуры абзаца и лишь затем выполняет связный контекстный перевод, исключая смысловые разрывы между страницами.
Шаг 2. Проверка формул и структуры специальных символов
После завершения перевода итоговый документ полностью сохраняет ширину двух колонок оригинальной статьи, иерархию заголовков разделов, исходные графики, таблицы и подписи к ним.
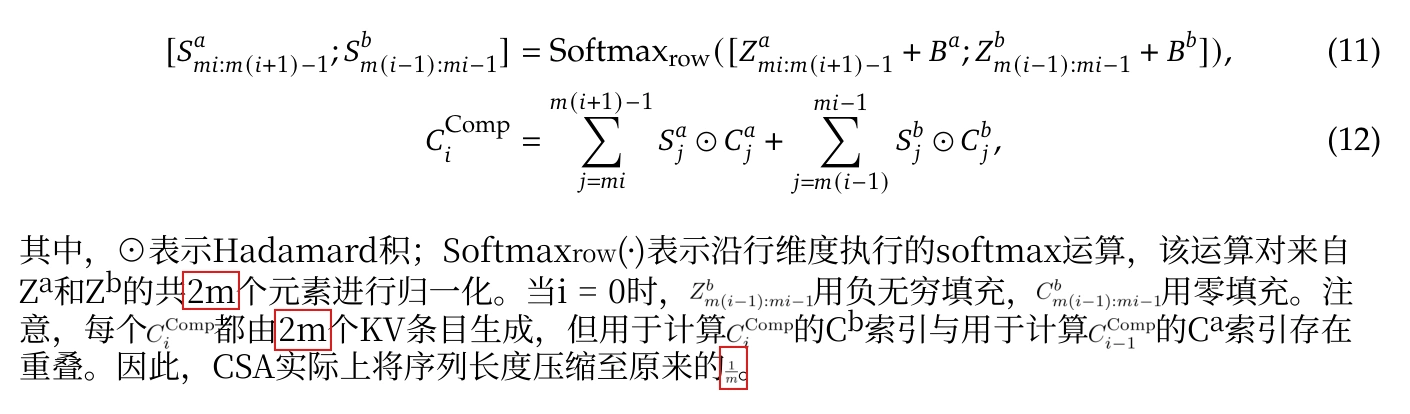
При работе со строгими математическими выкладками (например, в статье DeepSeek-V4) приведенная выше иллюстрация демонстрирует качество верстки формул и перевода:
- Внутристрочные символы не переводятся как текст: внутристрочные обозначения (например, 2m, Z^a) не переведены как текст, однако размер шрифта некоторых формул в строке стал заметно меньше.
- Выносные уравнения выровнены с сохранением нумерации: формулы CSA (11) и (12) отцентрированы, индексы уравнений справа сохранены, а логика изложения и математических выводов остается непрерывной.
Шаг 3. Сопоставление оригинала и перевода в двух окнах бок о бок
Откройте английский оригинал и скачанный перевод на китайский в отдельных окнах в приложении «Просмотр» (Preview) на macOS, Acrobat, PDF Expert или браузере Edge и расположите оба окна рядом бок о бок:
- В окне в левой части экрана откройте оригинал на английском языке.
- В окне в правой части экрана откройте соответствующий перевод на китайский язык и перейдите на ту же страницу.
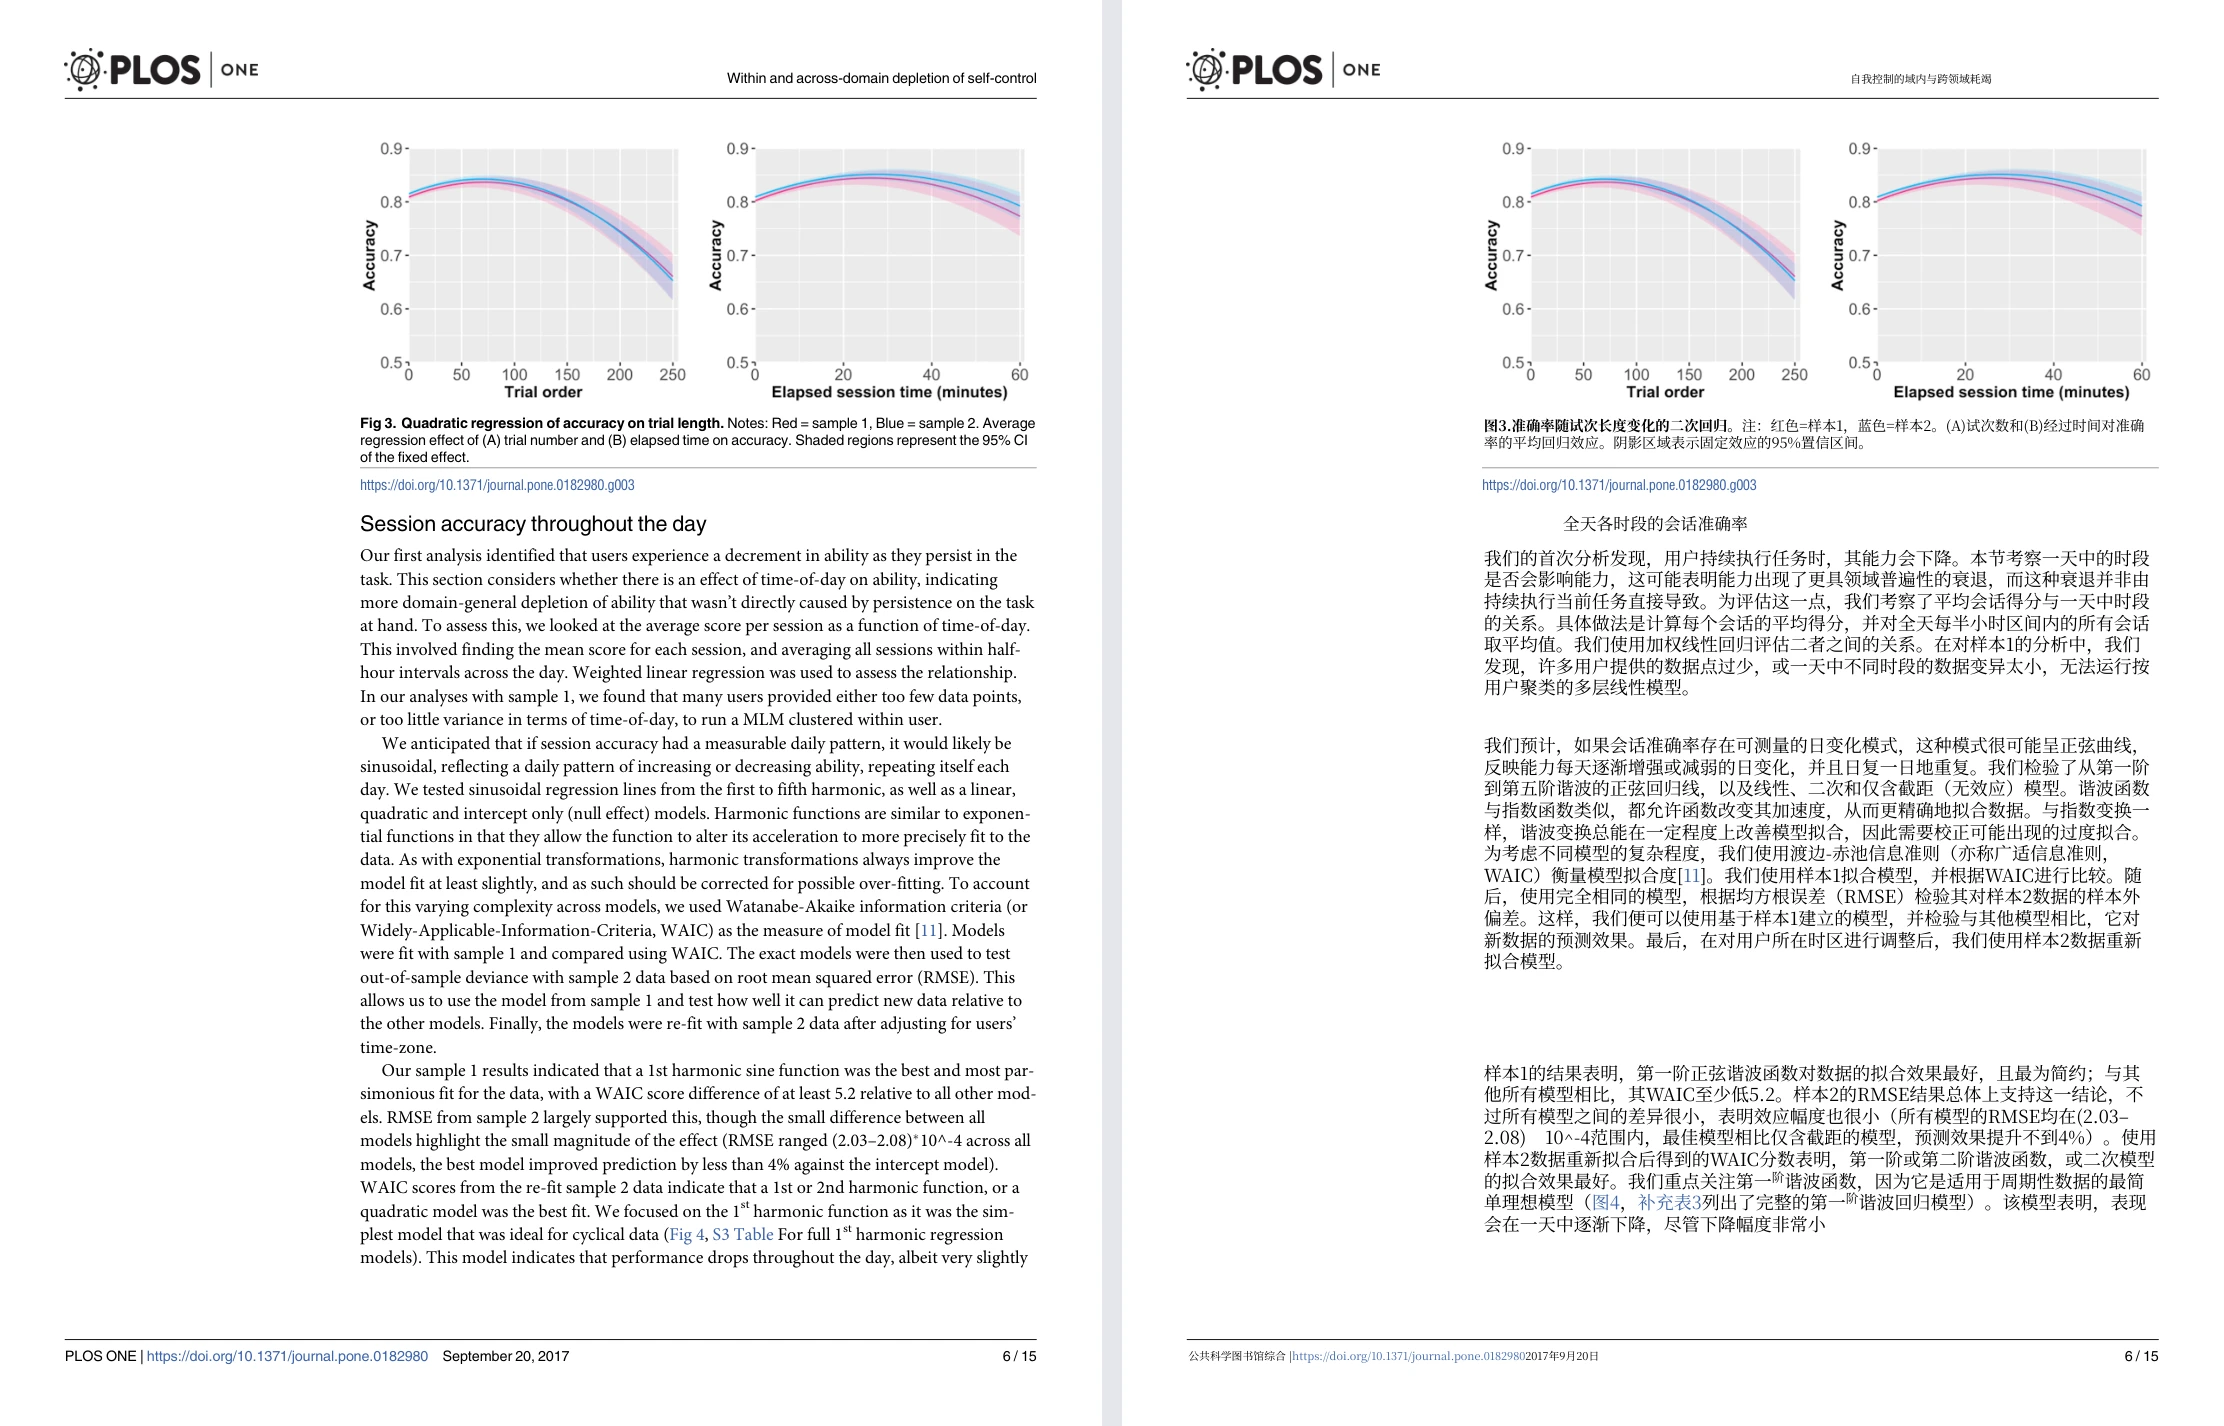
После настройки на экране слева отображается страница $N$ оригинального текста на английском языке, а справа — соответствующая страница $N$ перевода (в данном примере — на китайский язык):
- Читая описательную часть перевода справа, вы быстро понимаете научную мотивацию авторов, ключевые тезисы и схему экспериментов;
- Встретив важную формулу, специальное сокращение или сложный код, можно сразу перевести взгляд на английский оригинал слева, чтобы проверить исходное математическое определение.
4. Чек-лист: чего избегать при двуязычном чтении научной литературы
При регулярном чтении научных публикаций с помощью вспомогательных инструментов рекомендуем придерживаться нескольких полезных исследовательских привычек:
- Сверяйте важные выводы с исходными определениями: машинный перевод значительно снижает порог входа для исследователей, для которых английский язык не является родным. Однако на этапах цитирования (Citation), строгого доказательства теорем или воспроизведения кода обязательно опирайтесь на строгие формулировки англоязычного оригинала.
- Учитывайте разницу между сканами и векторными PDF: в старых отсканированных статьях без качественного OCR-распознавания точность восстановления верстки может снижаться. По возможности используйте оригинальные векторные PDF с arXiv или сайтов IEEE/ACM.
- Сохраняйте названия в псевдокоде на английском языке: имена функций, переменных и модулей библиотек (например, примитивов PyTorch или TensorFlow) в алгоритмах должны оставаться в оригинальном виде, чтобы перевод не исказил практическое понимание кода.
Источники / Sources
- Официальный сервис перевода документов Equalang
- Открытая база научных препринтов arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Репозиторий проекта с открытым исходным кодом PDFMathTranslate