Wzory z arXiv psują się w translatorze? Narzędzia do publikacji
 Equalang
W skrócie
Dwułamowy PDF z arXiv psuje wzory LaTeX i dzieli zdania? Poznaj ograniczenia translatorów i sprawdź, jak czytać artykuły naukowe w zestawieniu obok siebie.
Słowa kluczowe: tłumaczenie artykułów z arXiv; narzędzia do tłumaczenia prac naukowych; zachowanie układu dwułamowego PDF; tłumaczenie wzorów matematycznych LaTeX; czytanie literatury naukowej strona po stronie
Śledząc co tydzień najnowsze preprinty na arXiv lub przeglądając listy artykułów przyjętych na najważniejsze konferencje naukowe, wielu doktorantów i badaczy natrafia na niewidzialną barierę. Kopiowanie tekstu fragment po fragmencie z dwukolumnowego pliku PDF do standardowego okna tłumacza sprawia, że precyzyjne wzory matematyczne LaTeX, indeksy dolne i górne oraz symbole sumowania natychmiast zamieniają się w bezsensowne ciągi znaków. Przenoszenie wyrazów z łącznikiem (dywizem) na końcach wierszy lub stron powoduje sztuczne dzielenie słów, przez co zdania przetłumaczone maszynowo stają się niespójne. Kiedy wreszcie udaje się przetłumaczyć całą stronę, numeracja rycin, tabel oraz logika wywodów z oryginału ulegają rozproszeniu, a ciągłe przełączanie się między oknami w poszukiwaniu odpowiednich miejsc wyczerpuje energię potrzebną na merytoryczną analizę.
Główną przeszkodą w sprawnym przyswajaniu najnowszej literatury rzadko bywa niewystarczający zasób angielskiego słownictwa. Prawdziwym problemem jest to, że „wzory zamieniają się w ciągi zniekształconych znaków, dwułamowy układ ulega rozbiciu, a tekstu oryginalnego i tłumaczenia nie da się równolegle śledzić”, co bezlitośnie wybija badacza ze skupienia.
W tym artykule omawiamy kluczowe kryteria wyboru narzędzi do tłumaczenia literatury naukowej, porównujemy możliwości rozwiązań open source i popularnych translatorów oraz pokazujemy wydajną metodę wnikliwej lektury publikacji – z nienaruszonymi wzorami i zachowanym układem dwukolumnowym.
1. Dlaczego artykuły naukowe to twardy orzech do zgryzienia dla tłumaczenia maszynowego?
Standardowe narzędzia translatorskie (takie jak uniwersalne wtyczki zaznaczające tekst w przeglądarce czy zwykłe pola tłumaczeniowe) dobrze radzą sobie ze spójnymi akapitami tekstu ogólnego, lecz w starciu z naukowym plikiem PDF ujawniają liczne wady. Wynika to przede wszystkim z trzech wyzwań technicznych specyficznych dla publikacji naukowych:
- Przeplatanie się wzorów matematycznych LaTeX ze znakami specjalnymi: W treści artykułu pojawia się mnóstwo zmiennych w tekście (np. $\theta_i, \mathbf{W}_Q$), indeksów dolnych i górnych, złożonych ułamków oraz samodzielnych równań tensorowych. Ogólne modele tłumaczenia maszynowego nie analizują drzewa składniowego układu typograficznego. W rezultacie traktują zmienne matematyczne jak zwykłe słowa i próbują je tłumaczyć, a pierwiastek w mianowniku $\sqrt{d_k}$ rozbijają na chaotyczne znaki, co całkowicie niszczy sens wyprowadzenia matematycznego.
- Układ dwukolumnowy i fizyczny podział na strony: Format PDF opiera się w gruncie rzeczy na statycznych instrukcjach rysowania przeznaczonych do druku i nie zawiera naturalnego logicznego przepływu akapitów. Układ dwułamowy sprawia, że standardowe narzędzia często odczytują tekst w poprzek kolumn. Z kolei długie zdania na dole strony, przechodzące na kolejną stronę, bywają bezwzględnie przecinane na pół, co prowadzi do rażących błędów tłumaczeniowych.
- Utrata numeracji rycin, tabel i odsyłaczy: Schematy architektury algorytmów (Figure), tabele z wynikami badań ablacyjnych (Table) oraz zawarte w tekście odwołania do konkretnych równań (np. Equation 3) podczas zwykłej ekstrakcji tekstu łatwo ulegają przesunięciu lub zatraceniu, przerywając ciąg argumentacji.
Dlatego profesjonalne narzędzie do tłumaczenia literatury naukowej musi łączyć trzy kluczowe możliwości: strukturalną analizę układu PDF, ochronę wzorów LaTeX w ich pierwotnych miejscach oraz równoległe zestawienie oryginału i przekładu.
2. Porównanie wiodących rozwiązań do tłumaczenia literatury naukowej
W codziennej pracy badawczej powszechnie stosowane metody tłumaczenia literatury dzielą się na trzy główne kategorie, z których każda ma wyraźnie określone granice zastosowań:
Dla scenariuszy, w których liczy się precyzja wzorów, nienaruszony układ strony oraz wygoda pracy od razu po uruchomieniu bez konieczności konfiguracji, poniżej przedstawiamy procedurę na przykładzie opracowanego przez nas narzędzia Equalang.
3. Trzystopniowy proces wnikliwej lektury publikacji dwułamowych w układzie porównawczym
Aby czytanie publikacji przebiegało płynnie, można zestawić oryginał z wygenerowanym tłumaczeniem obok siebie, co pozwala na w pełni komfortową, wnikliwą lekturę.
Krok 1: Analiza całego dokumentu i włączenie optymalizacji wzorów
Prześlij oryginalny plik PDF pobrany z arXiv na stronie Tłumaczenie dokumentów w serwisie Equalang. W przypadku artykułów z dziedziny nauk ścisłych, informatyki czy fizyki, nasyconych symboliką matematyczną, system na etapie parsowania otacza szczególną ochroną zmienne w tekście oraz samodzielne równania.
Długie zdania przerwane na dole strony i przechodzące na kolejną są najpierw łączone na poziomie logicznym akapitu, a dopiero potem tłumaczone z zachowaniem spójności kontekstu, co zapobiega nienaturalnemu rozrywaniu myśli między stronami.
Krok 2: Weryfikacja złożonych wzorów i symboli matematycznych
Po zakończeniu tłumaczenia wygenerowany plik w pełni zachowuje szerokość kolumn oryginalnego artykułu, hierarchię nagłówków sekcji, oryginalne ryciny oraz położenie podpisów pod ilustracjami i tabelami.
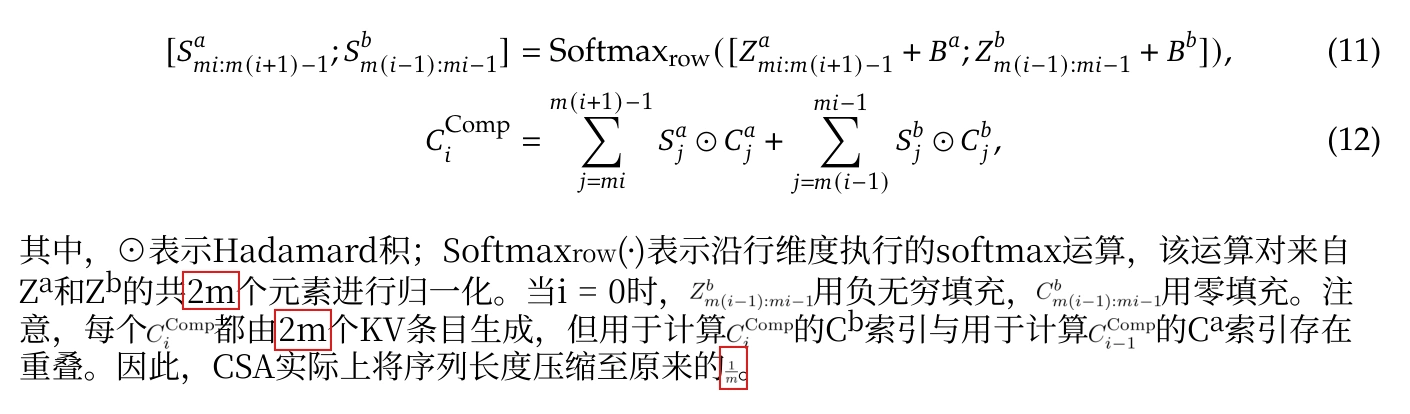
Podczas analizy rygorystycznych wyprowadzeń matematycznych, takich jak w artykule poświęconym DeepSeek-V4, powyższy rysunek ilustruje efekt składu wzorów i przetłumaczonego tekstu:
- Symbole wewnątrz wiersza nie zostały przetłumaczone jako tekst: Symbole takie jak 2m czy Z^a nie zostały przetłumaczone na zwykły tekst, choć rozmiar czcionki części wzorów śródliniowych wyraźnie się zmniejszył.
- Wyrównanie wyodrębnionych równań i ich numeracji: Wzory CSA (11) i (12) pozostają wyśrodkowane, a indeksy numeryczne po prawej stronie zostają wyraźnie zachowane, zapewniając płynną ciągłość narracji i wywodu matematycznego.
Krok 3: Zestawienie oryginału i tłumaczenia w dwóch oknach obok siebie
Otwórz angielski oryginał i pobrane chińskie tłumaczenie w osobnych oknach w aplikacji Podgląd w systemie macOS, Adobe Acrobat, PDF Expert lub przeglądarce Microsoft Edge i ustaw oba okna obok siebie:
- W oknie po lewej stronie ekranu otwórz angielski oryginał.
- W oknie po prawej stronie ekranu otwórz odpowiednie chińskie tłumaczenie i przejdź do tego samego numeru strony.
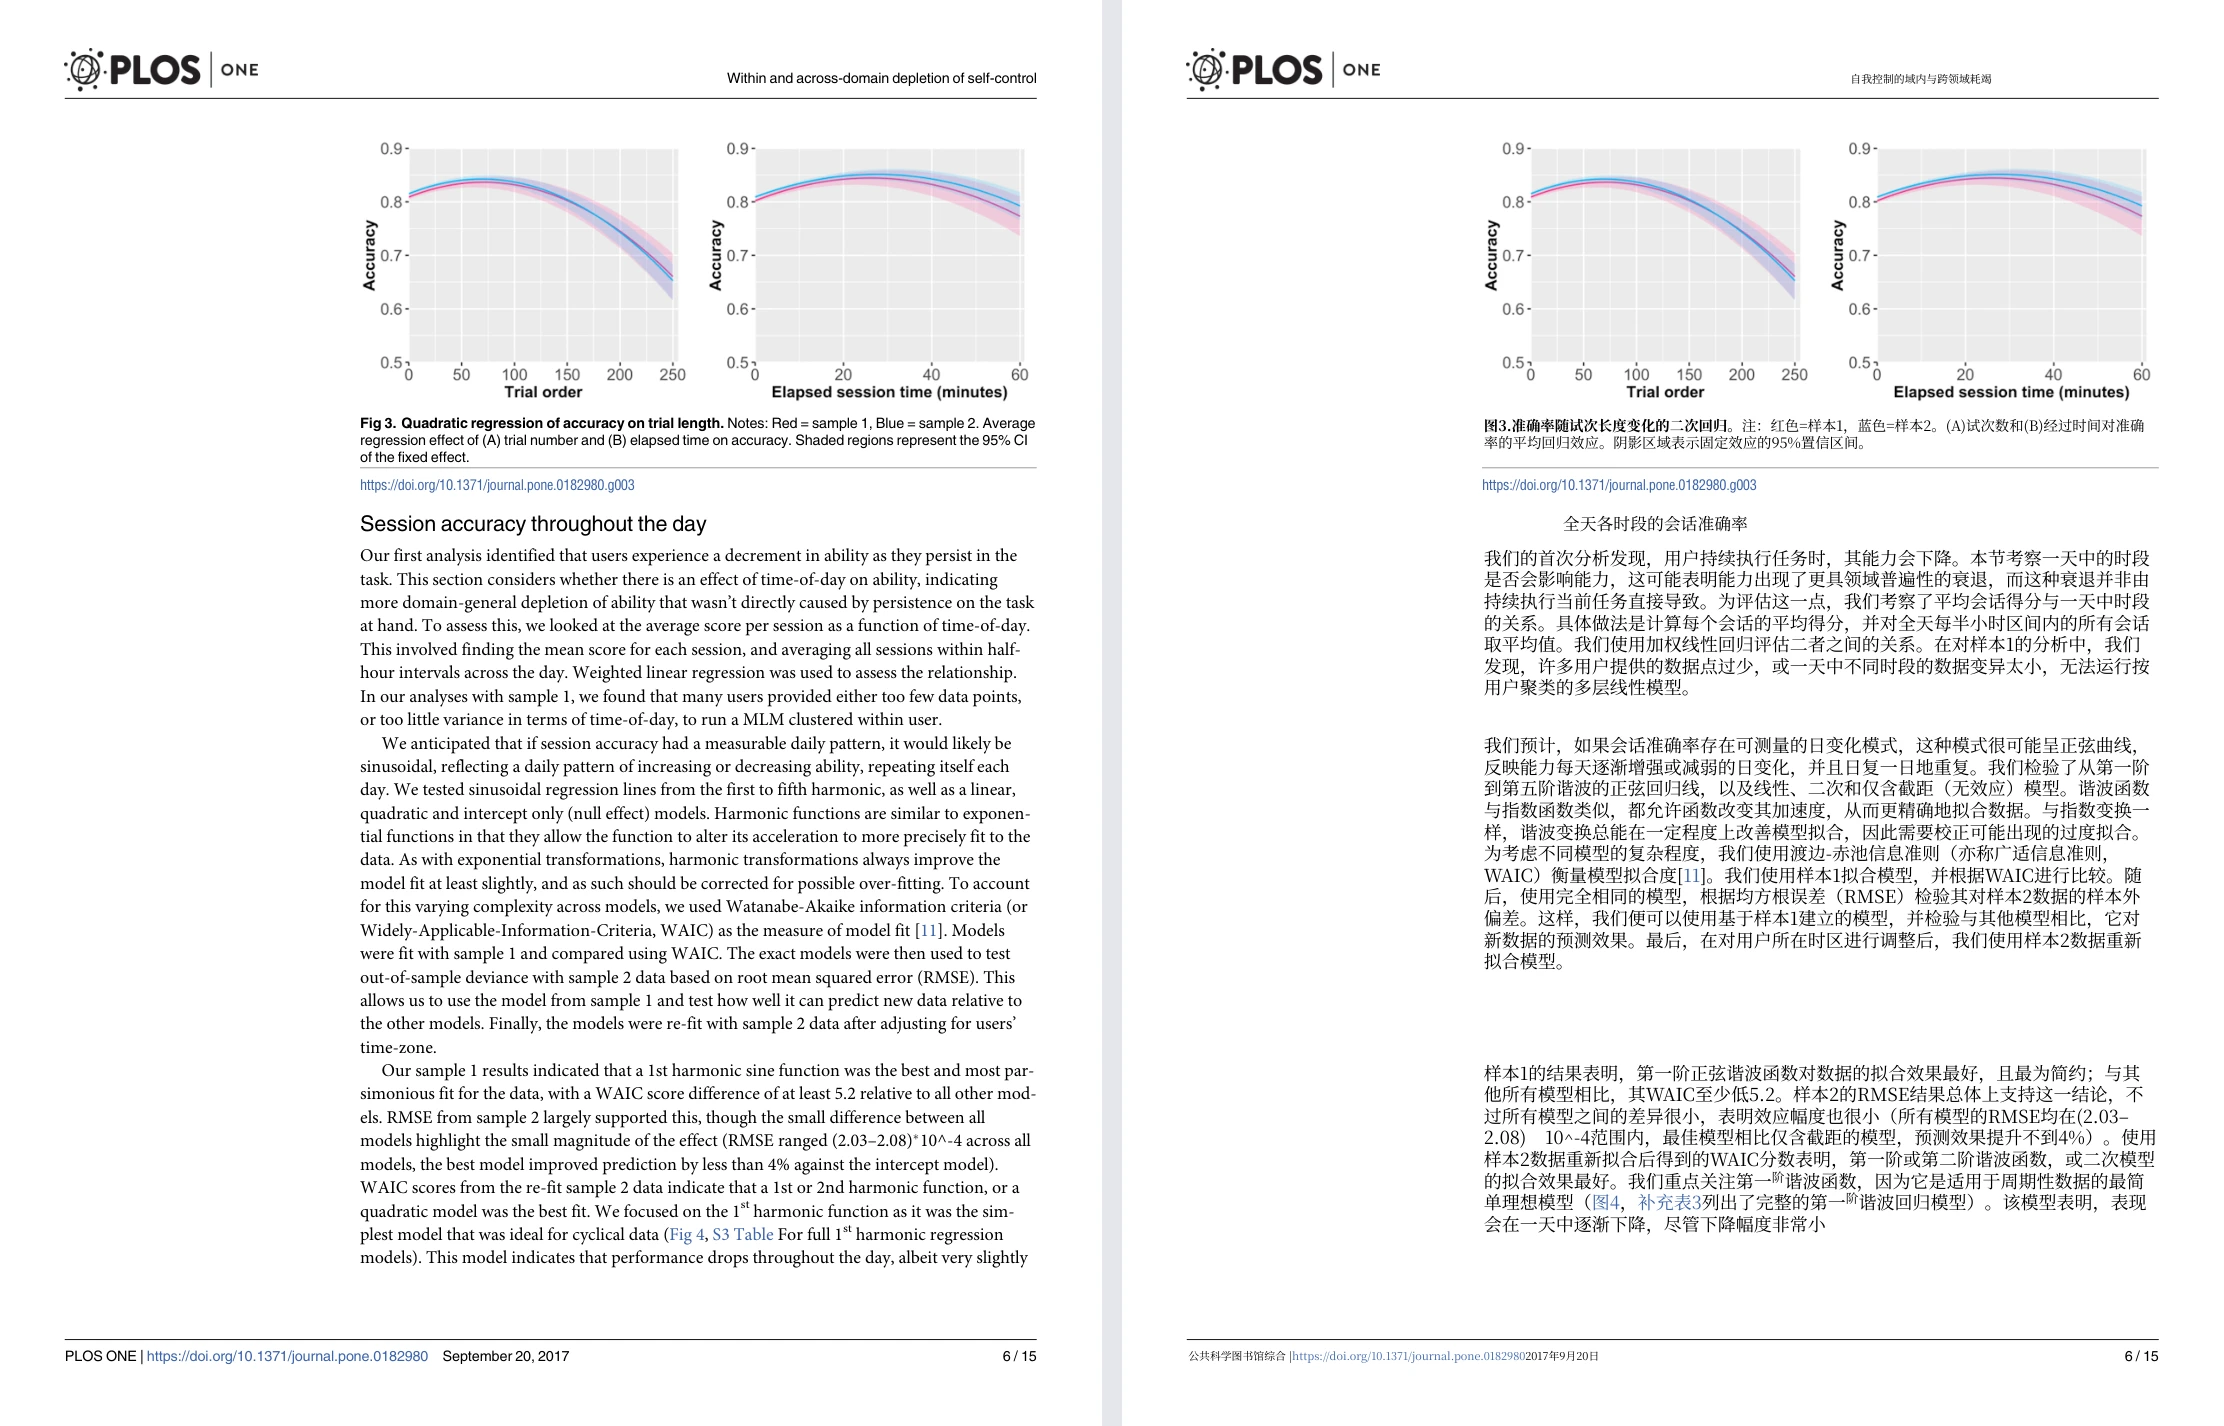
Po dostosowaniu ustawień po lewej stronie ekranu wyświetla się strona $N$ angielskiego oryginału, a po prawej odpowiadająca jej strona $N$ chińskiego tłumaczenia:
- Przeglądając opis, czytasz tłumaczenie po prawej stronie, aby szybko zrozumieć motywację autorów, kluczowe tezy i plan eksperymentów;
- Trafiając na kluczowe wzory, specjalistyczne skróty czy skomplikowane fragmenty kodu, naturalnie przenosisz wzrok na angielski oryginał po lewej stronie, aby zweryfikować pierwotne definicje matematyczne.
4. Dobre praktyki i pułapki przy dwujęzycznej lekturze publikacji naukowych
Podczas codziennego czytania literatury naukowej z pomocą narzędzi translatorskich warto pamiętać o kilku dobrych nawykach badawczych:
- Weryfikuj istotne wnioski z definicjami w oryginale: Tłumaczenie maszynowe znacząco obniża barierę wejścia dla czytelników, dla których angielski nie jest językiem ojczystym. Jednak przy cytowaniu publikacji (Citation), ścisłym dowodzeniu twierdzeń lub odtwarzaniu kodu (reprodukcji wyników) zawsze należy opierać się na precyzyjnych definicjach z angielskiego oryginału.
- Zwracaj uwagę na różnicę między skanami a plikami wektorowymi: W przypadku starszych publikacji w postaci skanów, jeśli tekst nie został poddany wysokiej jakości rozpoznawaniu OCR, dokładność odwzorowania układu może być niższa. W miarę możliwości wybieraj oficjalne, wektorowe pliki PDF udostępniane przez arXiv, IEEE lub ACM.
- Pozostawiaj złożony pseudokod w oryginalnym języku: Nazwy funkcji, zmiennych oraz bibliotek zewnętrznych (np. operatory PyTorch czy TensorFlow) w krokach algorytmu powinny pozostać w oryginale, aby lokalne tłumaczenie nie utrudniało praktycznego wdrożenia.
Źródła / Sources
- Oficjalna strona modułu tłumaczenia dokumentów Equalang
- Otwarta baza preprintów naukowych arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Repozytorium projektu open source PDFMathTranslate do tłumaczenia publikacji naukowych