Pourquoi les PDF traduits perdent leur mise en page
 Equalang
En bref
La plupart des PDF n’indiquent pas quels mots forment un paragraphe ou une table. Deux articles montrent ce qui se casse et ce qu’il faut vérifier ensuite.
Mots-clés: traduire un PDF ; traduction de documents ; mise en page PDF ; conserver la mise en page ; articles de recherche
Un fichier Word enregistre quels mots forment un paragraphe et lesquels appartiennent à une table. La plupart des PDF ne le font pas. Ils ne contiennent que les lettres et les coordonnées où les tracer ; les paragraphes, les tables et les phrases sont reconstitués par l’œil de la personne qui lit. Certains PDF portent des balises d’accessibilité (ajoutées pour les lecteurs d’écran) qui marquent paragraphes et tables, mais beaucoup n’en ont pas (les deux articles que nous utilisons en exemple ci-dessous n’en ont aucune) : un outil de traduction ne peut donc pas compter dessus. Tout ce que tu vois comme structure (une mise en page sur deux colonnes, un en-tête qui s’étend sur plusieurs colonnes, une phrase qui continue à la page suivante) doit être retrouvé avant toute traduction. Ensuite, le texte traduit, désormais plus long ou plus court, doit rentrer dans la mise en page d’origine. La mise en page se perd à l’une de ces deux étapes.
Ce qu’il faut faire dépend de ce que tu as :
- Le .docx ou le .pptx d’origine : traduis ce fichier plutôt que le PDF.
- Un PDF texte simple, avec peu de tables, de moins de 10 Mo : l’envoi gratuit de documents de Google Traduction est l’option la plus rapide à essayer.
- Un article, un manuel ou un rapport avec des tables, des équations ou deux colonnes : utilise un outil de traduction qui reconstruit la mise en page, puis vérifie les quatre points listés dans la section 3.
- Un scan (où tu ne peux pas sélectionner le texte) : il lui faut une reconnaissance de texte (OCR) avant de pouvoir être traduit. DeepL accepte les scans et gère lui-même cette étape. Google Traduction laisse les pages scannées non traduites.
1. Que voit réellement un outil de traduction dans un PDF ?
Nous construisons un outil de traduction de documents ; nous passons donc beaucoup de temps à regarder ce qui sort des PDF. Pour le montrer clairement, nous avons pris deux articles sur les modèles de langage IA publiés sur arXiv, LLaMA et Mistral 7B, et nous avons extrait leur texte avec mutool de MuPDF, un outil PDF open source courant. Ce texte correspond à peu près à ce sur quoi travaille un outil, à moins qu’il ne lise aussi la mise en page. Ci-dessous, chaque passage est d’abord montré tel qu’il apparaît sur la page, puis tel qu’il ressort (une ligne contenant seulement … signifie que nous avons sauté des lignes).
1.1 Les tables deviennent une liste de nombres
La table 3 de l’article LLaMA compare dix modèles sur huit tests :
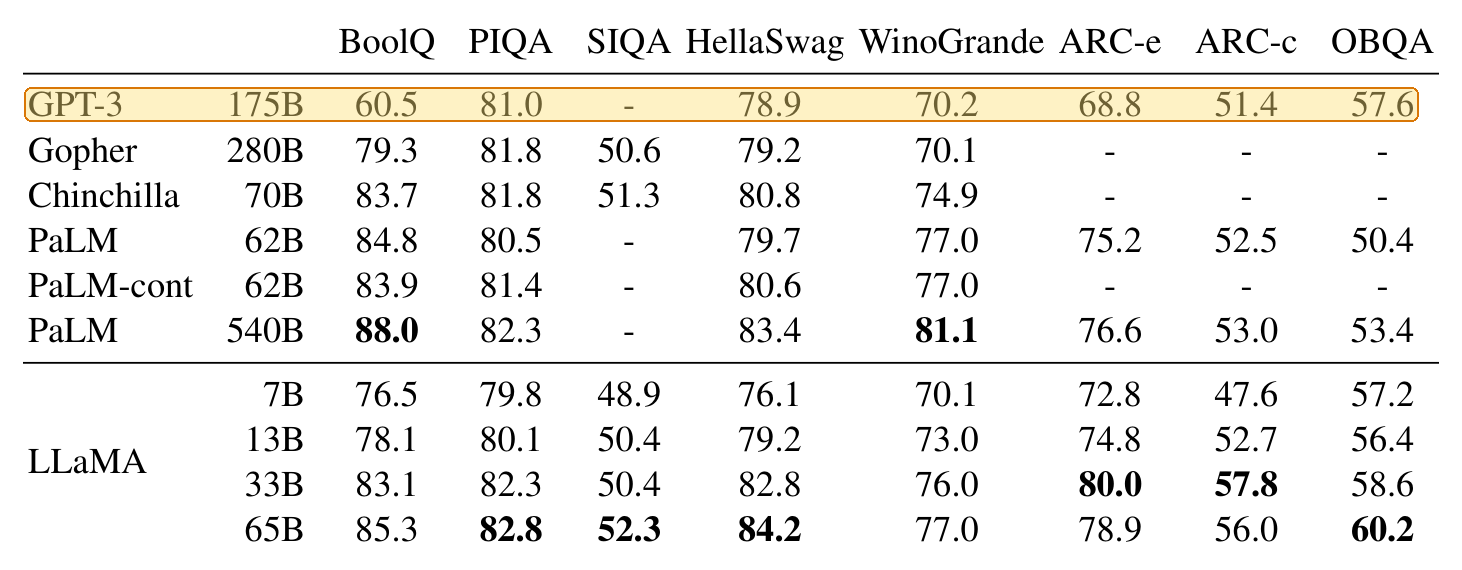
Une fois extraite, elle compte 102 lignes : un en-tête de cinq lignes, puis une valeur par ligne. Voici les 16 premières ; les dix valeurs de GPT-3 à 57.6 forment la ligne mise en évidence.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Rien n’indique à l’outil de traduction quel nombre correspond à quel test. Si tu colles cela dans une zone de traduction, tu obtiens la même liste en retour. Les mots sont traduits, mais la table a disparu.
1.2 Une phrase, avec une table entière à l’intérieur
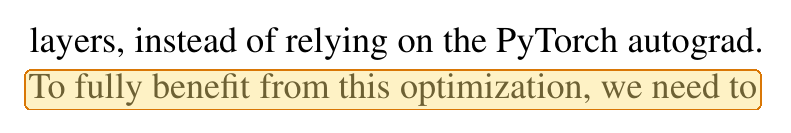
La dernière phrase de la page 3 de l’article LLaMA s’arrête à « we need to » :
Elle reprend dans la colonne de gauche de la page 4, juste sous la table 3 :
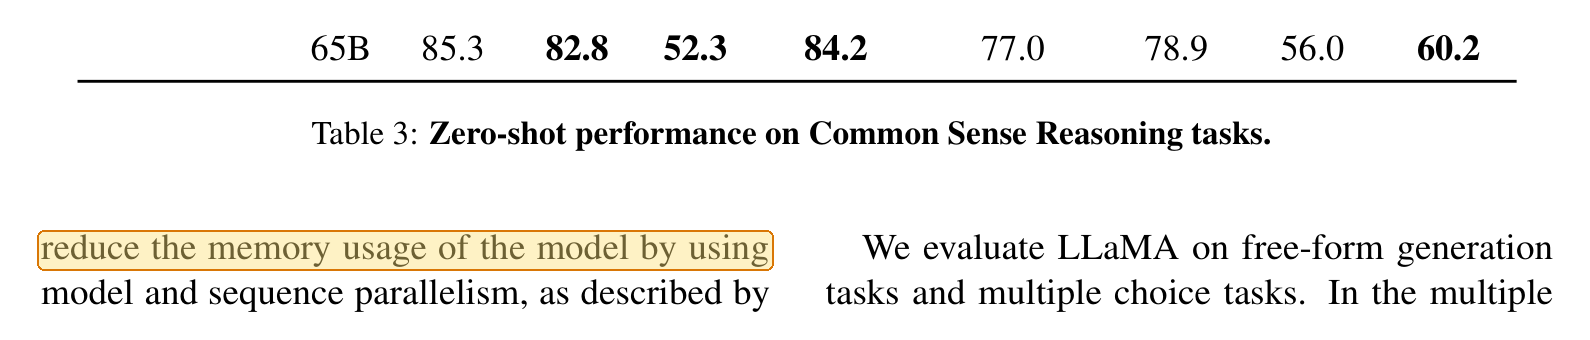
Dans le texte extrait, une note de bas de page, le saut de page, les 102 lignes de la table et sa légende se trouvent à l’intérieur de cette seule phrase :
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Cela se reproduit deux pages plus loin. La page 5 s’achève sur « …the textual description and tests in a », et « docstring. » n’arrive qu’après la table 7 de la page 6, avec entre les deux les 44 lignes de la table et sa légende de sept lignes.
Un outil qui traduit page par page, ou qui suit le texte dans cet ordre exact, obtient deux fragments qu’il n’a aucune raison de relier. Dans le fichier traduit, tu vois une phrase qui s’étiole en bas de page, et son autre moitié réapparaît quelque part sous une table.
1.3 Les indices et les fractions deviennent autre chose
Dans l’article Mistral, une variable est écrite h avec un indice i :
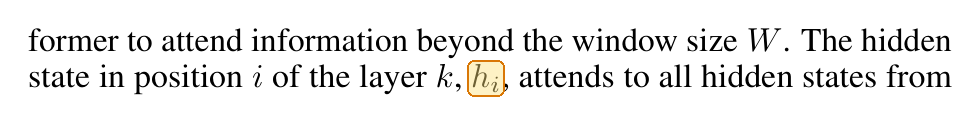
À l’extraction, l’indice disparaît et il ne reste que hi :
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Un outil de traduction n’a aucune raison de traiter cela comme une variable. Pour lui, hi est un simple mot anglais courant.
Les fractions s’en sortent plus mal. LLaMA fixe une valeur aux deux tiers de 4d, écrit ⅔·4d, le ⅔ étant composé d’un petit 2 au-dessus d’un 3 :
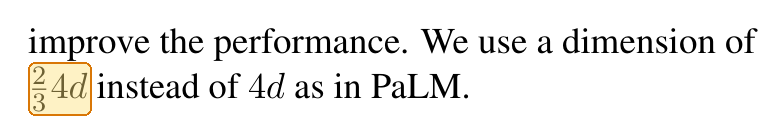
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Les deux tiers de 4d sont devenus 34d. Exposants, fractions et symboles issus de polices mathématiques ne sont que des formes placées à certaines positions. Le texte extrait conserve les formes, mais perd les positions.
1.4 Les mots sont coupés en fin de ligne
Les articles sur deux colonnes coupent beaucoup de mots en fin de ligne. Dans LLaMA, 242 lignes coupent un mot courant en minuscules par un trait d’union. Les recoller paraît facile, jusqu’à ce qu’on tombe sur un trait d’union qui appartient à un nom :
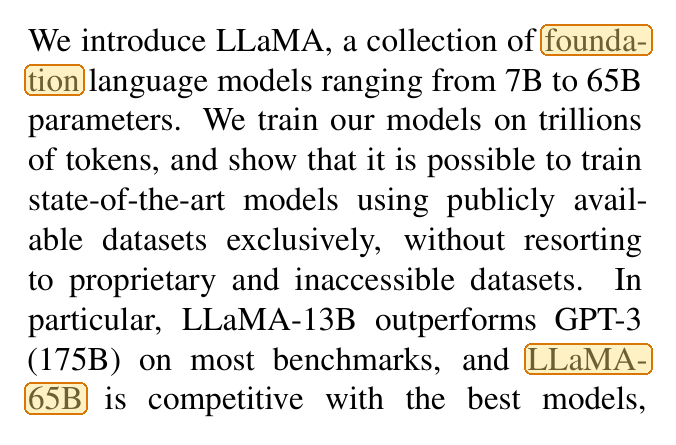
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- et tion forment un seul mot sans le trait d’union. Mais dans LLaMA- et 65B, le trait d’union fait partie du nom du modèle et doit rester.
Nous n’avons utilisé qu’un seul outil d’extraction, sur deux articles composés avec LaTeX, un système de composition courant dans l’édition scientifique. Des PDF exportés depuis Word, des documents scannés ou d’autres outils d’extraction peuvent donner d’autres résultats, mais ces quatre types de dégâts sont ceux à surveiller.
2. Quelles sont tes options ?
Les informations sur Google Traduction et DeepL proviennent de leurs propres pages d’aide, consultées le 7 octobre 2026. Lorsqu’une traduction de PDF déçoit, DeepL conseille d’envoyer plutôt le document d’origine. C’est aussi notre conseil.
La dernière ligne correspond exactement à ce que la traduction de documents d’Equalang est conçue pour faire, et c’est l’approche que nous connaissons le mieux. Avant de traduire, Equalang ressoude les phrases qu’un saut de page a coupées en deux. Les tables à cellules fusionnées et à en-têtes sur plusieurs lignes sont reconstruites dans leur structure d’origine au lieu d’être aplaties en une seule liste. Les équations ne sont pas jetées comme du texte illisible, et une option d’optimisation des formules existe pour celles, difficiles, qui se trouvent au milieu d’une ligne de texte.
Ce qu’elle ne fait pas, c’est reproduire l’original à l’identique. Une traduction plus longue que l’original décale les retours à la ligne et les tailles de police ; les pages à la mise en page serrée méritent donc encore un coup d’œil. La traduction de documents couvre actuellement le chinois, l’anglais, le japonais, le coréen, l’espagnol, le français et d’autres langues.
3. Que vérifier une fois le PDF traduit ?
- Les tables. Les en-têtes sont-ils toujours au-dessus de la bonne colonne ? Les nombres ont-ils changé ?
- Les sauts de page et le texte sous chaque table. Lis la dernière ligne de chaque page et la phrase qui suit immédiatement chaque table. Une phrase qui s’arrête et ne se termine jamais est le signe le plus courant d’un texte traduit en morceaux.
- Les équations et les variables. Vérifies-en quelques-unes qui se trouvent au milieu d’une ligne de texte. Cherche des lettres devenues des mots et des fractions devenues d’autres nombres.
- Le nombre de pages et les liens. Un nombre de pages très différent signifie que du texte a été perdu ou a débordé sur des pages supplémentaires. Clique sur une ou deux entrées de la table des matières pour voir si elles fonctionnent.
Sources
- Touvron et al., « LLaMA: Open and Efficient Foundation Language Models », arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., « Mistral 7B », arXiv:2310.06825v1, CC BY 4.0.
- Aide Google Traduction, Translate documents & websites, consultée le 7 octobre 2026.
- Centre d’aide DeepL, Translate PDF files, consulté le 7 octobre 2026.
- Méthode : texte extrait le 7 octobre 2026 avec MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Les figures sont des recadrages des pages des articles ; les mises en évidence sont de nous.