Formules LaTeX altérées sur arXiv : comment traduire efficacement vos articles scientifiques ?
 Equalang
En bref
Les articles en double colonne, les formules LaTeX et les coupures entre pages déroutent souvent la traduction automatique. Découvrez les solutions techniques pour préserver la mise en page et comparer l'original et la traduction côte à côte.
Mots-clés: traduction d'articles scientifiques; traduction arXiv; préservation mise en page double colonne; traduction formules LaTeX; lecture bilingue en vis-à-vis
Chaque semaine, en suivant les dernières prépublications sur arXiv ou en épluchant les listes d'articles acceptés dans les conférences de premier plan, de nombreux chercheurs et doctorants se heurtent à un obstacle récurrent : en copiant-collant le texte d'un PDF académique en double colonne dans une fenêtre de traduction classique, les formules mathématiques en LaTeX, les indices, exposants et symboles de sommation se transforment instantanément en suites de caractères incompréhensibles. Les césures en fin de ligne ou en bas de page coupent brutalement les mots, générant des phrases décousues. Et lorsqu'on parvient enfin au terme d'une page, les renvois aux figures et la chaîne de déduction logique sont éparpillés, obligeant à d'incessants allers-retours entre les fenêtres pour retrouver le fil.
Le verrou principal pour aborder la littérature scientifique de pointe ne réside que rarement dans le vocabulaire : il tient au fait que les formules sont corrompues, la mise en page en double colonne est disloquée et l'alignement entre le texte source et la traduction est rompu, interrompant le fil de la réflexion.
Cet article détaille les critères essentiels de sélection d'un outil de traduction documentaire, compare les approches open source et les plateformes courantes, puis propose une méthode concrète pour lire vos articles scientifiques sans déformer les formules ni détruire la mise en page d'origine.
1. Pourquoi les articles scientifiques résistent-ils à la traduction automatique classique ?
Les outils de traduction généralistes (tels que les extensions de navigateur ou les formulaires de saisie classiques) traitent convenablement les paragraphes de texte fluide au quotidien. Face à un PDF académique, ils montrent toutefois vite leurs limites en raison de trois verrous techniques majeurs :
- L'enchevêtrement des formules LaTeX et des symboles spécifiques : le corps du texte comporte de nombreuses variables insérées au fil des lignes (comme $\theta_i, \mathbf{W}_Q$), des indices, exposants, fractions élaborées et équations tensorielles isolées. Privés d'une analyse syntaxique de la mise en page, les modèles de traduction généralistes traitent ces variables comme du texte ordinaire qu'ils tentent de traduire littéralement, découpent maladroitement un radical $\sqrt{d_k}$ en caractères épars, ce qui rend la démonstration incohérente.
- La mise en page en double colonne et les sauts de page physiques : le format PDF est constitué d'instructions graphiques statiques conçues pour l'impression, sans flux logique de paragraphes. Les outils classiques ont ainsi tendance à lire les deux colonnes de front sur une même ligne horizontale. De plus, une phrase longue coupée en bas de page se retrouve scindée en deux blocs indépendants, provoquant des contresens notables.
- La perte des références croisées et de la numérotation des figures : les schémas d'architecture (Figure), les tableaux d'ablation (Table) et les appels d'équations dans le texte (comme Equation 3) sont facilement décalés ou ignorés lors d'une extraction brute, rompant la continuité de l'argumentation.
Ainsi, un outil de traduction adapté aux publications scientifiques doit combiner trois aptitudes fondamentales : l'analyse structurelle du PDF, la préservation des formules LaTeX in situ et l'affichage en vis-à-vis du texte original et de la traduction.
2. Comparatif des approches actuelles de traduction d'articles académiques
Dans la pratique de la recherche, les approches courantes de traduction se répartissent en trois grandes catégories, chacune présentant un champ d'application bien défini :
Pour les situations nécessitant à la fois l'intégrité des formules, le respect scrupuleux de la mise en page et une prise en main directe sans configuration, voici les étapes d'un flux de travail complet avec notre plateforme Equalang.
3. Configurer un flux de lecture bilingue en vis-à-vis en trois étapes
Pour garantir une lecture fluide, vous pouvez comparer côte à côte le document original et la traduction générée pour une lecture immersive.
Étape 1 : Analyser le document complet avec protection des formules
Déposez le PDF d'origine téléchargé depuis arXiv sur la page Traduction de documents d'Equalang. Pour les publications en sciences fondamentales, en informatique ou en physique riches en formalisme mathématique, le système isole et préserve les symboles en ligne comme les équations hors-texte lors de la phase d'analyse.
Lorsqu'une phrase s'étend sur deux pages consécutives, elle est d'abord reconstituée au niveau de la structure logique du paragraphe avant d'être traduite dans son contexte global, évitant ainsi les ruptures de syntaxe artificielles.
Étape 2 : Vérifier la fidélité des formules complexes et des symboles
Une fois la traduction générée, le document obtenu conserve la largeur des colonnes, la hiérarchie des titres, ainsi que l'emplacement exact des figures et de leurs légendes.
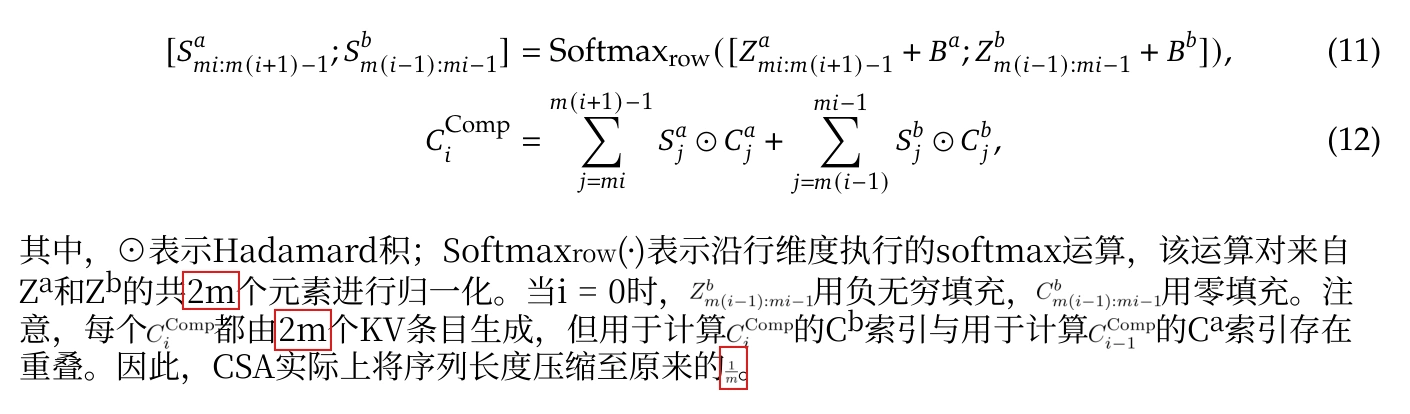
Sur des démonstrations exigeantes, comme celles de l'article DeepSeek-V4, l'image ci-dessus illustre le rendu de la mise en page des formules et de la traduction :
- Symboles en ligne non traduits en texte : les symboles en ligne tels que 2m ou Z^a ne sont pas traduits en texte, mais la taille de police de certaines formules en ligne est nettement réduite.
- Alignement des équations isolées et de leurs numéros : les formules CSA (11) et (12) restent centrées, la numérotation des équations à droite est préservée, et le fil de la démonstration reste limpide.
Étape 3 : Comparer l'original et la traduction côte à côte dans deux fenêtres
Ouvrez séparément le document original en anglais et la traduction en chinois téléchargée dans Aperçu sur macOS, Adobe Acrobat, PDF Expert ou le lecteur intégré de Microsoft Edge, puis disposez les deux fenêtres côte à côte :
- Dans la fenêtre située à gauche de l'écran, ouvrez le document original en anglais.
- Dans la fenêtre située à droite de l'écran, ouvrez la traduction en chinois correspondante et placez-vous sur la même page.
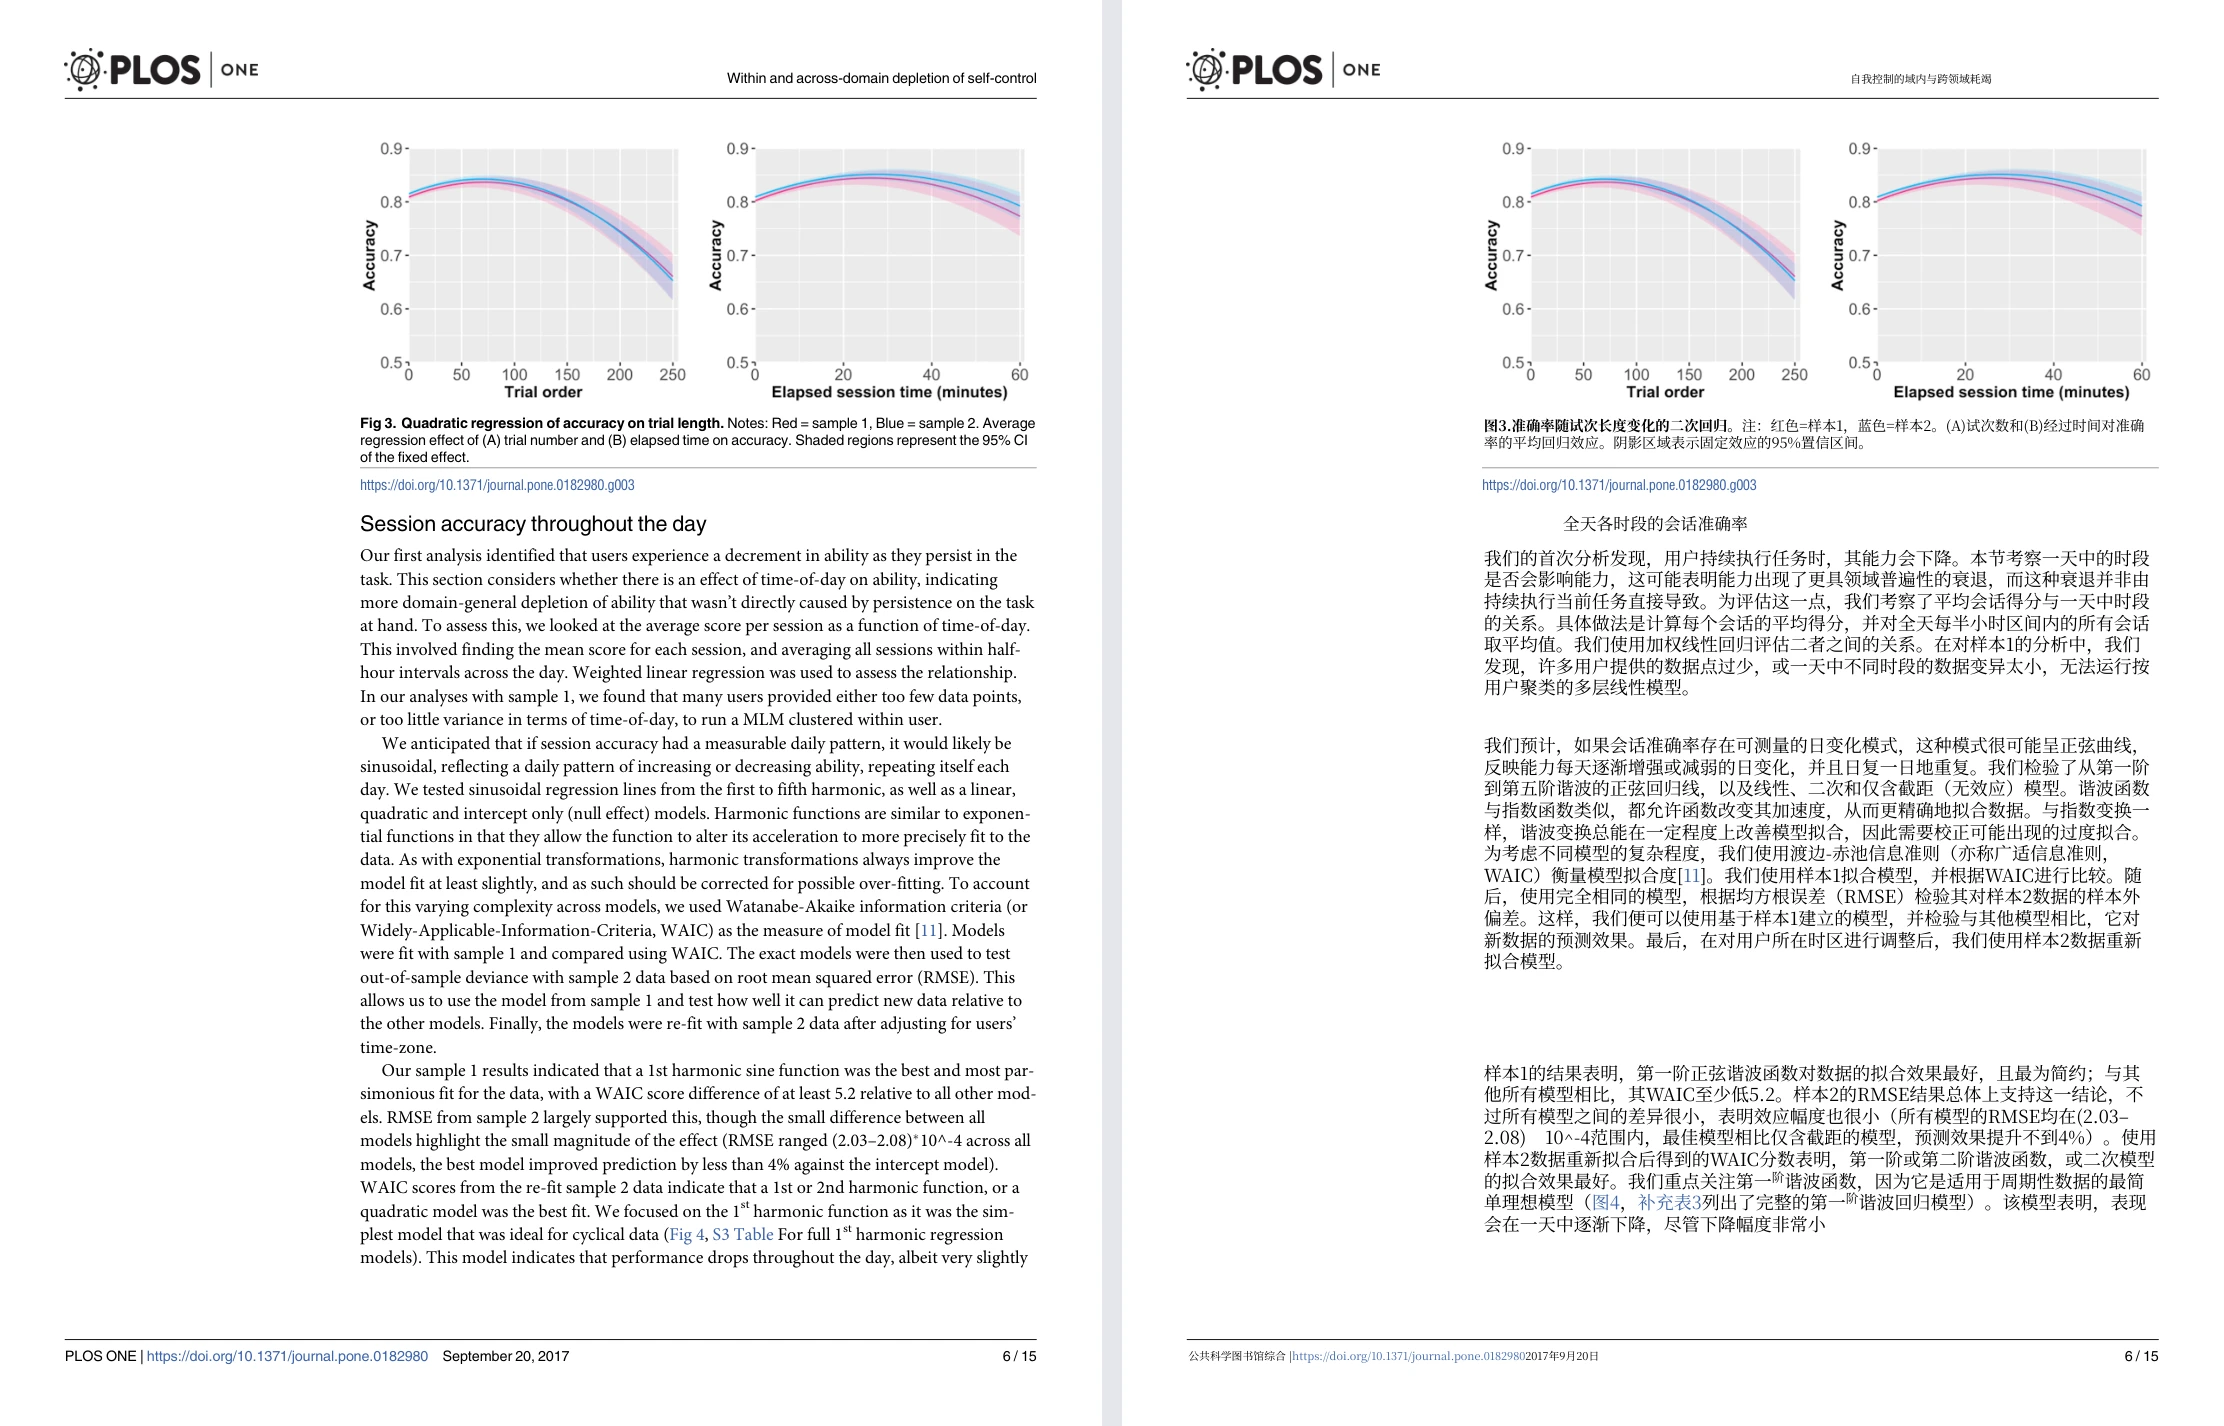
Une fois ce réglage effectué, l'écran affiche sur la gauche la page $N$ du document original en anglais et sur la droite la page $N$ correspondante de la traduction en chinois :
- Lors de la lecture rapide de l'argumentation, regardez le texte en chinois à droite pour comprendre rapidement les motivations de recherche de l'auteur, ses arguments clés et sa conception expérimentale ;
- Face à une formule clé, une abréviation particulière ou du code complexe, portez naturellement votre regard vers la version originale en anglais à gauche pour vérifier la définition mathématique d'origine.
4. Bonnes pratiques pour la lecture critique d'articles scientifiques traduits
Lorsque l'on s'appuie sur la traduction automatique dans son travail de recherche, quelques réflexes méthodologiques restent indispensables :
- Revenir à la source pour les définitions critiques : la traduction automatique facilite considérablement la compréhension globale, mais pour citer un article (citation formelle), vérifier une démonstration mathématique rigoureuse ou réimplémenter un algorithme, référez-vous toujours au texte source d'origine.
- Distinguer les PDF vectoriels des documents scannés : sur des publications anciennes numérisées au format image sans OCR de haute qualité, la restitution de la mise en page peut s'avérer moins fidèle ; privilégiez toujours les PDF vectoriels natifs issus d'arXiv, de l'IEEE ou de l'ACM.
- Préserver les termes techniques dans le pseudo-code : les noms de fonctions, de variables et les primitives de bibliothèques tierces (comme PyTorch ou TensorFlow) doivent rester dans leur langue d'origine pour éviter toute confusion lors de la mise en œuvre pratique.
Sources & Attribution
- Accès au service de traduction de documents Equalang
- Base de prépublications scientifiques arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Dépôt du projet open source de traduction d'articles académiques PDFMathTranslate