Почему PDF теряет формат при переводе и что с этим делать
 Equalang
Вкратце
В отличие от файла Word, большинство PDF не отмечают, какие слова образуют абзац или таблицу. На двух статьях показываем, что ломается и что проверить.
Ключевые слова: перевод PDF; перевод документов; форматирование PDF; сохранение вёрстки; научные статьи
Файл Word хранит сведения о том, какие слова образуют абзац, а какие относятся к таблице. Большинство PDF этого не делают. В них есть только буквы и координаты, по которым их нужно нарисовать; абзацы, таблицы и предложения собирает уже глаз читающего. В части PDF есть теги доступности (их добавляют для программ чтения с экрана), которые помечают абзацы и таблицы, но у многих их нет (у двух статей, которые мы разбираем ниже как примеры, таких тегов нет вообще), поэтому инструмент перевода не может на них рассчитывать. Всё, что вы видите как структуру (двухколоночная вёрстка, заголовок, занимающий несколько колонок, предложение, продолжающееся на следующей странице), нужно сначала восстановить, и только потом переводить. После этого переведённый текст — теперь более длинный или более короткий — должен снова вписаться в исходную вёрстку. Форматирование теряется на одном из этих двух шагов.
Что делать, зависит от того, что у вас есть:
- Исходный .docx или .pptx: переведите его, а не PDF.
- Простой текстовый PDF, с небольшим числом таблиц, меньше 10 MB: бесплатная загрузка документов в Google Переводчике — самый быстрый вариант, который стоит попробовать.
- Статья, руководство или отчёт с таблицами, формулами или двумя колонками: используйте инструмент перевода, который восстанавливает вёрстку, а затем проверьте четыре места из раздела 3.
- Скан (в котором текст нельзя выделить): ему нужно распознавание текста (OCR) перед переводом. DeepL принимает сканы и сам выполняет этот шаг. Google Переводчик оставляет отсканированные страницы без перевода.
1. Что инструмент перевода на самом деле видит в PDF?
Мы делаем инструмент перевода документов, поэтому много времени смотрим на то, что получается на выходе из PDF. Чтобы показать это наглядно, мы взяли две статьи о языковых моделях ИИ с arXiv — LLaMA и Mistral 7B — и извлекли из них текст с помощью mutool из MuPDF, распространённого инструмента для PDF с открытым кодом. Этот текст — примерно то, с чем работает инструмент, если он не читает и вёрстку тоже. Ниже каждый фрагмент показан сначала так, как он выглядит на странице, а затем так, как он выходит при извлечении (строка только с … означает, что мы пропустили несколько строк).
1.1 Таблицы превращаются в список чисел
Таблица 3 в статье про LLaMA сравнивает десять моделей на восьми тестах:
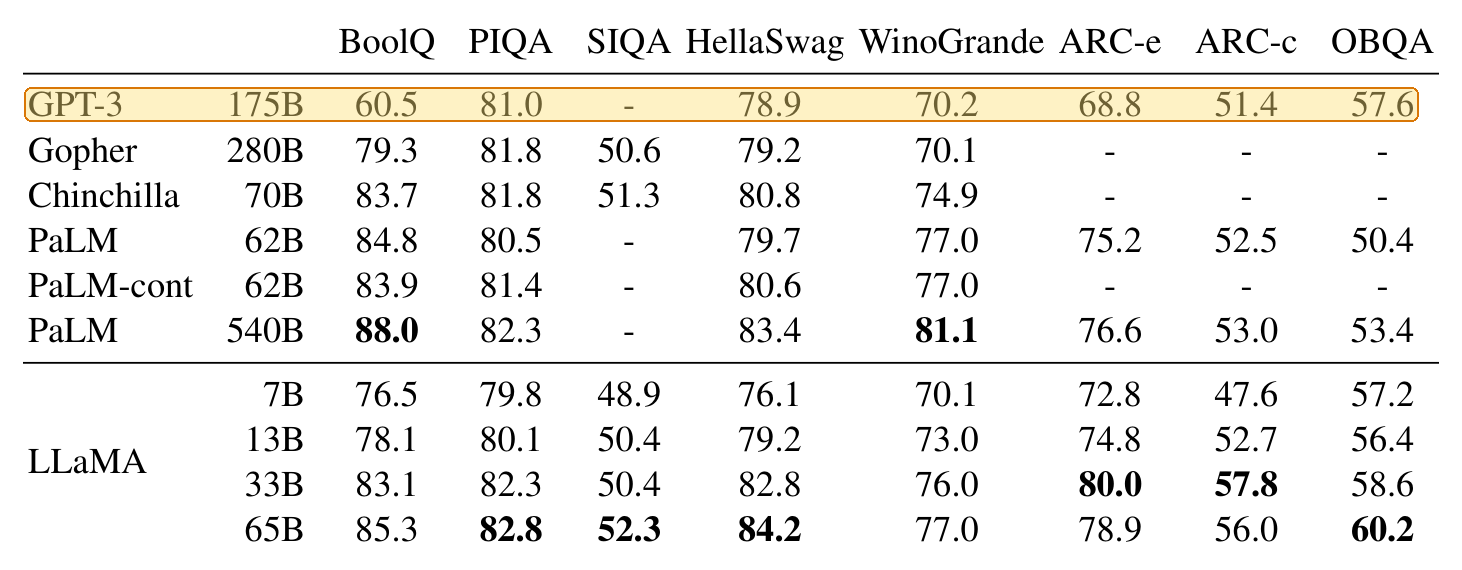
После извлечения это 102 строки: пять строк заголовка, затем по одному значению в строке. Вот первые 16; десять значений от GPT-3 до 57.6 — это выделенная строка.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Инструменту перевода ничто не сообщает, какое число к какому тесту относится. Если вставить это в поле перевода, вы получите тот же список обратно. Слова переведены, а таблица исчезла.
1.2 Одно предложение, а внутри — целая таблица
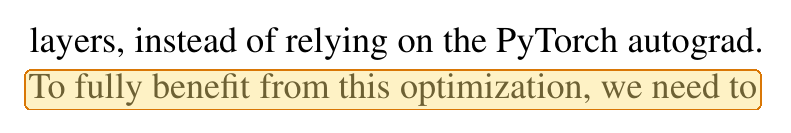
Последнее предложение на странице 3 статьи про LLaMA обрывается на «we need to»:
Оно продолжается в левой колонке страницы 4, сразу под таблицей 3:
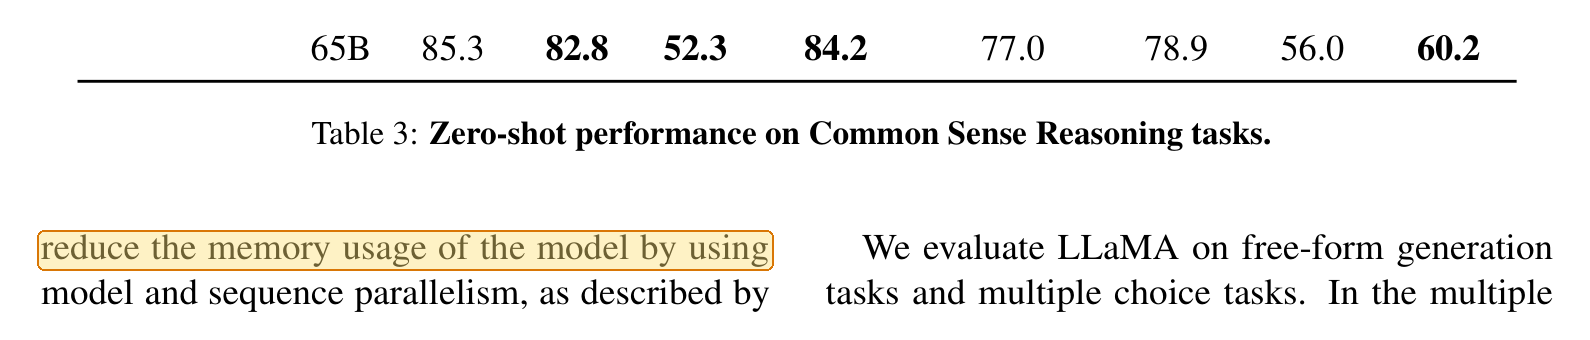
В извлечённом тексте внутри этого одного предложения оказываются сноска, разрыв страницы, все 102 строки таблицы и её подпись:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Две страницы спустя это повторяется. Страница 5 заканчивается на «…the textual description and tests in a», а «docstring.» появляется только после таблицы 7 на странице 6, между ними — 44 строки таблицы и подпись из семи строк.
Инструмент, который переводит постранично или идёт по тексту именно в этом порядке, получает два фрагмента, которые ему не с чего соединять. В переведённом файле вы видите предложение, которое гаснет в конце страницы, а его вторая половина появляется где-то под таблицей.
1.3 Нижние индексы и дроби превращаются в другое
В статье про Mistral переменная записана как h с нижним индексом i:
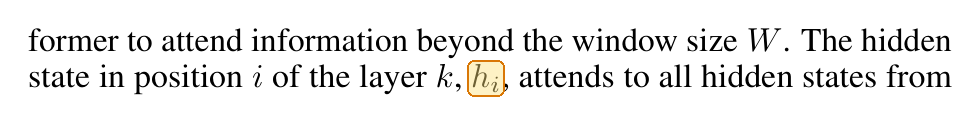
При извлечении индекс исчезает, остаётся hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
У инструмента перевода нет причин считать это переменной. Для него hi — просто обычное английское слово.
С дробями всё хуже. В LLaMA одно значение задано как две трети от 4d, записано как ⅔·4d, при этом ⅔ набрано маленькой двойкой над тройкой:
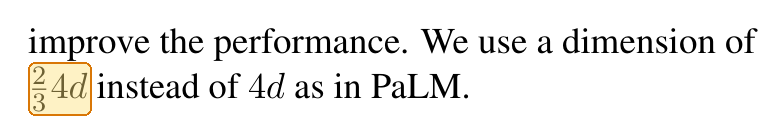
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Две трети от 4d превратились в 34d. Верхние индексы, дроби и символы из математических шрифтов — это просто формы, расставленные в определённых позициях. Извлечённый текст сохраняет формы, но теряет позиции.
1.4 Слова разрываются на конце строки
Статьи в две колонки часто разрывают слова переносом. В LLaMA 242 строки разрывают обычное слово в нижнем регистре дефисом. Склеить их обратно кажется простым делом, пока не дойдёшь до дефиса, который входит в название:
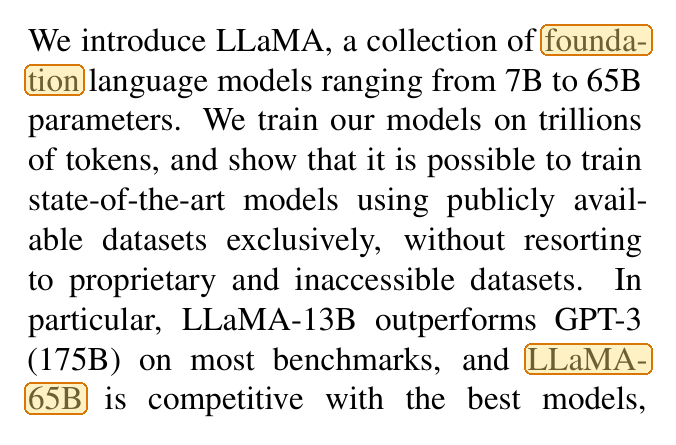
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- и tion образуют одно слово без дефиса. А вот в LLaMA- и 65B дефис — часть названия модели, его нужно оставить.
Мы использовали только один инструмент извлечения и только две статьи, свёрстанные в LaTeX — системе вёрстки, распространённой в научных публикациях. PDF, экспортированные из Word, отсканированные документы и другие инструменты извлечения могут дать другой результат, но искать стоит именно эти четыре типа повреждений.
2. Какие есть варианты?
Сведения о Google Переводчике и DeepL взяты из их собственных страниц помощи, проверены 7 октября 2026 года. Когда перевод PDF разочаровывает, DeepL советует загрузить исходный документ. Это совпадает с нашим советом.
Последняя строка — это то, для чего создан перевод документов Equalang, и подход, который мы знаем лучше всего. Перед переводом Equalang склеивает предложения, разрезанные разрывом страницы. Таблицы с объединёнными ячейками и многострочными заголовками восстанавливаются в исходной структуре, а не сплющиваются в один список. Формулы не выбрасываются как нечитаемый текст, а для сложных формул внутри строки есть возможность оптимизации формул.
Чего он не делает — так это не воспроизводит оригинал точно. Перевод, который длиннее оригинала, сдвигает переносы строк и размеры шрифта, поэтому страницы с плотной вёрсткой всё ещё стоит проверить. Перевод документов сейчас охватывает китайский, английский, японский, корейский, испанский, французский и другие языки.
3. Что проверить после перевода PDF?
- Таблицы. Заголовки по-прежнему над нужным столбцом? Числа не изменились?
- Разрывы страниц и текст под каждой таблицей. Прочитайте последнюю строку каждой страницы и предложение сразу после каждой таблицы. Предложение, которое обрывается и так и не заканчивается, — самый частый признак того, что текст переводили по частям.
- Формулы и переменные. Проверьте несколько формул внутри строки. Ищите буквы, ставшие словами, и дроби, ставшие другими числами.
- Число страниц и ссылки. Сильно отличающееся число страниц означает, что текст потерялся или выплеснулся на дополнительные страницы. Кликните одну-две записи в оглавлении, чтобы проверить, работают ли они.
Источники
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Справка Google Переводчика, Translate documents & websites, проверено 7 октября 2026 года.
- Справочный центр DeepL, Translate PDF files, проверено 7 октября 2026 года.
- Метод: текст извлечён 7 октября 2026 года с помощью MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Рисунки — фрагменты страниц статей; выделения сделаны нами.