Fórmulas quebradas no arXiv? Ferramentas úteis de tradução
 Equalang
Em resumo
Artigos em duas colunas com fórmulas LaTeX e frases longas quebradas na tradução? Veja como manter a formatação original e comparar o original e a tradução lado a lado.
Palavras-chave: tradução de artigos do arXiv; ferramentas de tradução acadêmica; manter layout de PDF em duas colunas; tradução de fórmulas matemáticas LaTeX; leitura com páginas lado a lado
Ao acompanhar os pré-prints mais recentes no arXiv todas as semanas ou conferir a lista de artigos aceitos nas principais conferências, muitos estudantes de pós-graduação e pesquisadores se deparam com uma barreira invisível: ao copiar o texto de um PDF acadêmico em duas colunas, parágrafo por parágrafo, para uma janela de tradução comum, as fórmulas matemáticas rigorosas em LaTeX, sobrescritos, subscritos e símbolos de somatório se transformam instantaneamente em caracteres soltos e sem sentido; a hifenização (hyphenation) na quebra de colunas ou páginas corta palavras ao meio, gerando traduções automáticas desconexas; e, quando você finalmente termina de traduzir uma página, as legendas de gráficos, tabelas e a lógica da dedução original foram desorganizadas, exigindo uma troca exaustiva de abas e telas apenas para encontrar referências no texto.
O maior obstáculo para compreender artigos de ponta geralmente não é a falta de vocabulário em inglês, mas sim a interrupção no fluxo de raciocínio causada por "fórmulas corrompidas em códigos desconexos, diagramação em duas colunas fragmentada e impossibilidade de comparar o original e a tradução em sincronia".
Neste artigo, estruturamos os critérios essenciais para escolher ferramentas de tradução de literatura acadêmica, comparamos os limites práticos entre soluções de código aberto e as principais ferramentas do mercado e demonstramos um fluxo de leitura eficiente que preserva fórmulas intactas e mantém a diagramação original em duas colunas.
1. Por que artigos acadêmicos são um "osso duro de roer" para a tradução automática?
As ferramentas de tradução convencionais (como extensões de navegador por seleção de texto ou caixas de texto comuns) lidam bem com parágrafos lineares do dia a dia, mas costumam falhar diante de um PDF acadêmico. Isso decorre principalmente de três desafios técnicos específicos da literatura acadêmica:
- Fórmulas matemáticas em LaTeX e símbolos especiais entrelaçados no texto: O corpo de um artigo contém inúmeras variáveis inline (como $\theta_i, \mathbf{W}_Q$), sobrescritos, subscritos, frações complexas e equações tensoriais isoladas. Modelos genéricos de tradução automática não compreendem a árvore sintática de diagramação e tendem a interpretar variáveis matemáticas como palavras comuns do inglês, quebrando raízes quadradas no denominador como $\sqrt{d_k}$ em fragmentos desconexos e arruinando todo o raciocínio dedutivo.
- Diagramação em duas colunas e quebras físicas de página: O PDF é, por natureza, um conjunto estático de instruções de desenho voltadas para impressão, sem um fluxo lógico nativo de parágrafos. O layout em duas colunas frequentemente induz ferramentas comuns a ler através das colunas na horizontal; além disso, frases longas que continuam na página seguinte costumam ser cortadas pela metade no rodapé, resultando em erros graves de tradução.
- Perda de numeração de figuras, tabelas e referências cruzadas: Diagramas de arquitetura de algoritmos (Figure), tabelas de estudos de ablação (Table) e referências a equações específicas no texto (como Equation 3) são facilmente deslocados ou perdidos durante a extração convencional, quebrando a linha de argumentação.
Portanto, uma ferramenta adequada para a tradução de literatura acadêmica precisa reunir três capacidades essenciais: análise estrutural do layout do PDF, proteção in loco de fórmulas em LaTeX e comparação lado a lado entre o original e a tradução.
2. Comparativo entre as principais soluções de tradução acadêmica do mercado
Na rotina de pesquisa científica, as soluções de tradução de literatura mais utilizadas dividem-se em três categorias, cada uma com limites de aplicação bem definidos:
Para cenários que exigem precisão em fórmulas, diagramação impecável e praticidade pronta para uso sem configurações prévias, demonstramos a seguir o fluxo de trabalho detalhado utilizando o Equalang, desenvolvido por nossa equipe.
3. Três passos para estruturar um fluxo de leitura em duas colunas com original à esquerda e tradução à direita
Para tornar a leitura de artigos fluida, você pode comparar o original e a tradução gerada lado a lado para uma leitura aprofundada e imersiva.
Passo 1: Analisar o documento completo e ativar a otimização de fórmulas
Na página de tradução de documentos da plataforma web do Equalang, envie o arquivo PDF original baixado do arXiv. Para artigos das áreas de ciências exatas, computação ou física com alta densidade de fórmulas matemáticas, o sistema prioriza a proteção de símbolos inline e equações isoladas durante a etapa de análise.
No caso de frases longas divididas pela quebra de página no rodapé, o sistema primeiro reconstitui a lógica do parágrafo antes de realizar a tradução contextual contínua, evitando cortes e incoerências entre páginas consecutivas.
Passo 2: Verificar a precisão de fórmulas complexas e estruturas de símbolos
Após a conclusão da tradução, o documento gerado preserva integralmente a largura das duas colunas do artigo original, a hierarquia dos títulos das seções, as imagens de gráficos e diagramas e o posicionamento das legendas.
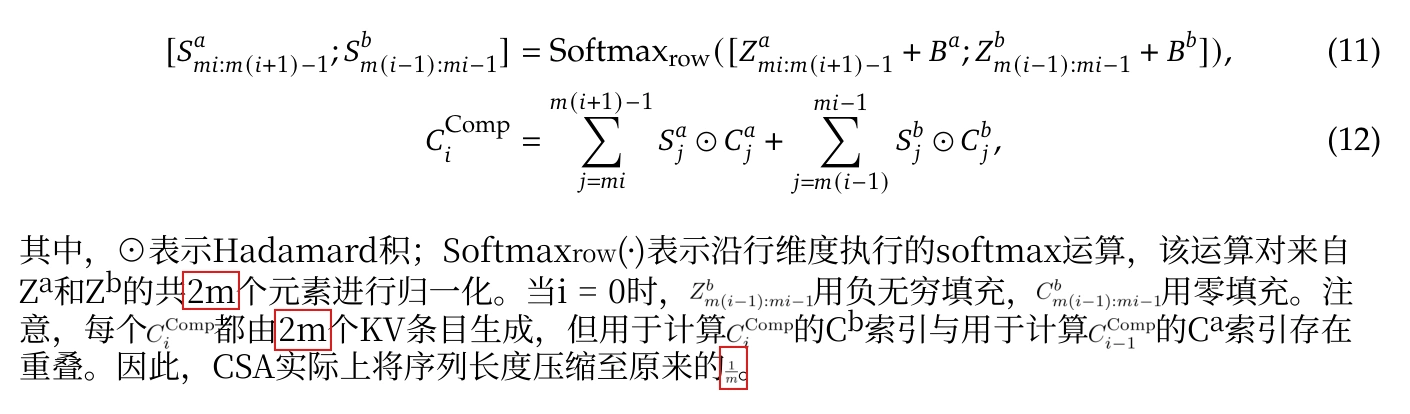
Ao lidar com deduções rigorosas, como no artigo do DeepSeek-V4, a imagem acima ilustra o efeito da diagramação das fórmulas e da tradução:
- Símbolos inline não traduzidos como texto: Símbolos inline como 2m e Z^a não foram traduzidos como texto, mas o tamanho da fonte de algumas fórmulas inline ficou visivelmente menor.
- Equações isoladas e numeração alinhadas: As fórmulas CSA (11)(12) ficam centralizadas, com a numeração de referência à direita perfeitamente preservada, conectando o fluxo de texto e a dedução sem interrupções.
Passo 3: Comparar o original e a tradução lado a lado em duas janelas
Abra o original em inglês e a tradução em chinês baixada separadamente no Pré-Visualização (macOS), Adobe Acrobat, PDF Expert ou Microsoft Edge e posicione as duas janelas lado a lado:
- Na janela do lado esquerdo da tela, abra o original em inglês.
- Na janela do lado direito da tela, abra a tradução correspondente em chinês e navegue até a mesma página.
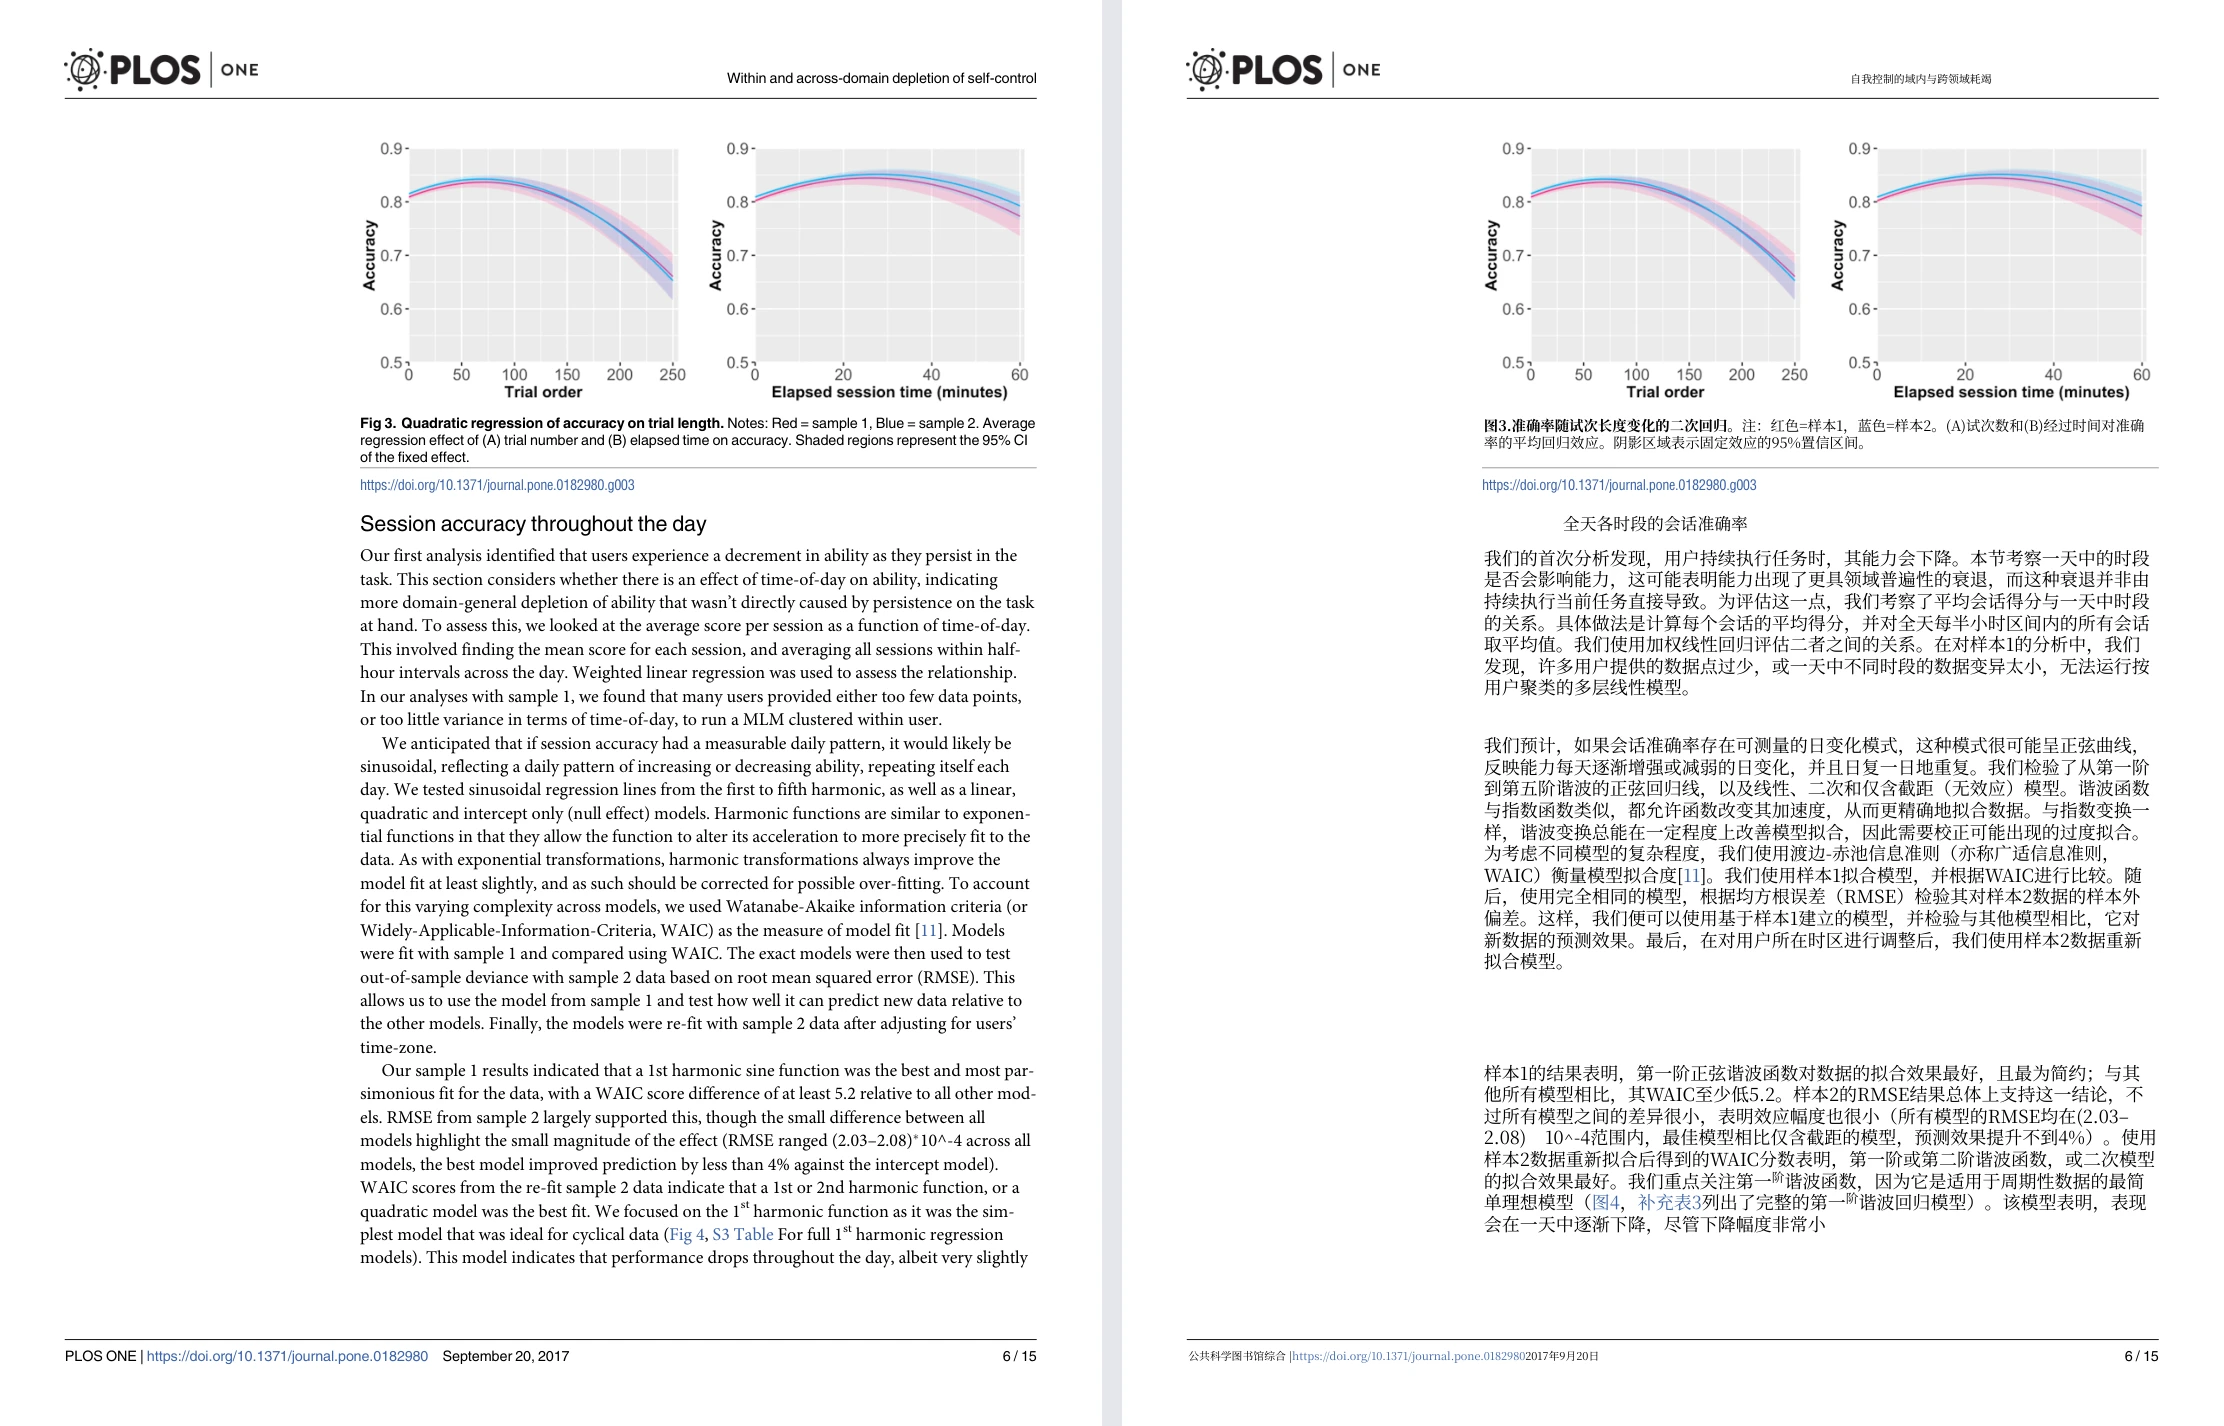
Após essa configuração, o lado esquerdo da tela apresentará a página $N$ do original em inglês e o lado direito, a página $N$ correspondente da tradução (no exemplo testado, em chinês):
- Ao fazer a leitura dinâmica da argumentação, consulte a tradução à direita para compreender rapidamente as motivações dos autores, os argumentos centrais e o desenho experimental;
- Ao se deparar com fórmulas fundamentais, siglas específicas ou trechos complexos de código, volte o olhar com naturalidade para o original em inglês à esquerda a fim de conferir a definição matemática original.
4. O que evitar na leitura bilíngue aprofundada de literatura acadêmica
Ao utilizar ferramentas para ler artigos científicos no dia a dia, recomendamos manter alguns bons hábitos de pesquisa:
- Conferir conclusões importantes na definição original: A tradução automática reduz consideravelmente a barreira de compreensão para leitores não nativos de inglês; no entanto, em etapas como citação de artigos (Citation), provas rigorosas de teoremas ou reprodução de código, certifique-se de validar as definições exatas no original em inglês.
- Atentar-se à diferença entre versões digitalizadas (scans) e vetoriais: Em artigos antigos escaneados, caso o texto não tenha passado por um OCR de alta qualidade, a fidelidade da diagramação pode ser afetada. Sempre que possível, utilize PDFs vetoriais originais fornecidos pelo arXiv ou pelas plataformas oficiais do IEEE/ACM.
- Preservar nomes originais em pseudocódigos complexos: Nomes de funções, variáveis e chamadas de bibliotecas externas (como primitivas de PyTorch / TensorFlow) nos passos do algoritmo devem ser mantidos no original em inglês, evitando que traduções parciais prejudiquem a compreensão prática na implementação.
Referências / Fontes
- Acesso ao portal de Tradução de Documentos do Equalang
- Repositório aberto de pré-prints acadêmicos arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- Repositório do projeto de ferramenta de tradução de artigos acadêmicos de código aberto PDFMathTranslate