Tłumaczenie PDF: dlaczego znika format i jak go zachować
 Equalang
W skrócie
Plik Word zaznacza, które słowa tworzą akapit lub tabelę; większość PDF-ów nie. Na dwóch artykułach pokazujemy, co się psuje i co sprawdzić.
Słowa kluczowe: tłumaczenie PDF; tłumaczenie dokumentów; formatowanie PDF; zachowanie układu; artykuły naukowe
Plik Word zapisuje, które słowa tworzą akapit, a które należą do tabeli. Większość PDF-ów tego nie robi. Przechowują tylko litery i współrzędne, na których trzeba je narysować; akapity, tabele i zdania składa sobie oko czytelnika. Niektóre PDF-y mają tagi dostępności (dodane dla czytników ekranu), które oznaczają akapity i tabele, ale wiele ich nie ma (oba artykuły, których używamy niżej jako przykładów, nie mają ich wcale), więc narzędzie do tłumaczenia nie może na nich polegać. Wszystko, co widzisz jako strukturę — układ dwukolumnowy, nagłówek rozciągnięty na kilka kolumn, zdanie przechodzące na następną stronę — trzeba odtworzyć, zanim zacznie się tłumaczenie. Potem przetłumaczony tekst, teraz dłuższy lub krótszy, musi zmieścić się z powrotem w oryginalnym układzie. Formatowanie ginie w jednym z tych dwóch kroków.
Co zrobić, zależy od tego, co masz:
- Oryginalny plik .docx lub .pptx: przetłumacz jego zamiast PDF-a.
- Zwykły tekstowy PDF z niewieloma tabelami, poniżej 10 MB: darmowe przesłanie dokumentu w Tłumaczu Google to najszybsza opcja do wypróbowania.
- Artykuł, instrukcja lub raport z tabelami, wzorami albo dwiema kolumnami: użyj narzędzia, które odtwarza układ, a potem sprawdź cztery miejsca z sekcji 3.
- Skan (nie da się w nim zaznaczyć tekstu): przed tłumaczeniem potrzebne jest rozpoznawanie tekstu (OCR). DeepL przyjmuje skany i wykonuje ten krok samodzielnie. Tłumacz Google zostawia zeskanowane strony bez tłumaczenia.
1. Co właściwie widzi narzędzie do tłumaczenia w PDF-ie?
Tworzymy narzędzie do tłumaczenia dokumentów, więc spędzamy dużo czasu na patrzeniu, co wychodzi z PDF-ów. Żeby pokazać to jasno, wzięliśmy dwa artykuły o modelach językowych AI z arXiv, LLaMA i Mistral 7B, i wyodrębniliśmy ich tekst za pomocą mutool z MuPDF, popularnego otwartoźródłowego narzędzia do PDF-ów. Ten tekst to w przybliżeniu to, na czym pracuje narzędzie, jeśli nie czyta też układu. Niżej każdy fragment pokazujemy najpierw tak, jak wygląda na stronie, a potem tak, jak wychodzi (wiersz z samym … oznacza, że pominęliśmy kilka wierszy).
1.1 Tabele zamieniają się w listę liczb
Tabela 3 w artykule o LLaMA porównuje dziesięć modeli w ośmiu testach:
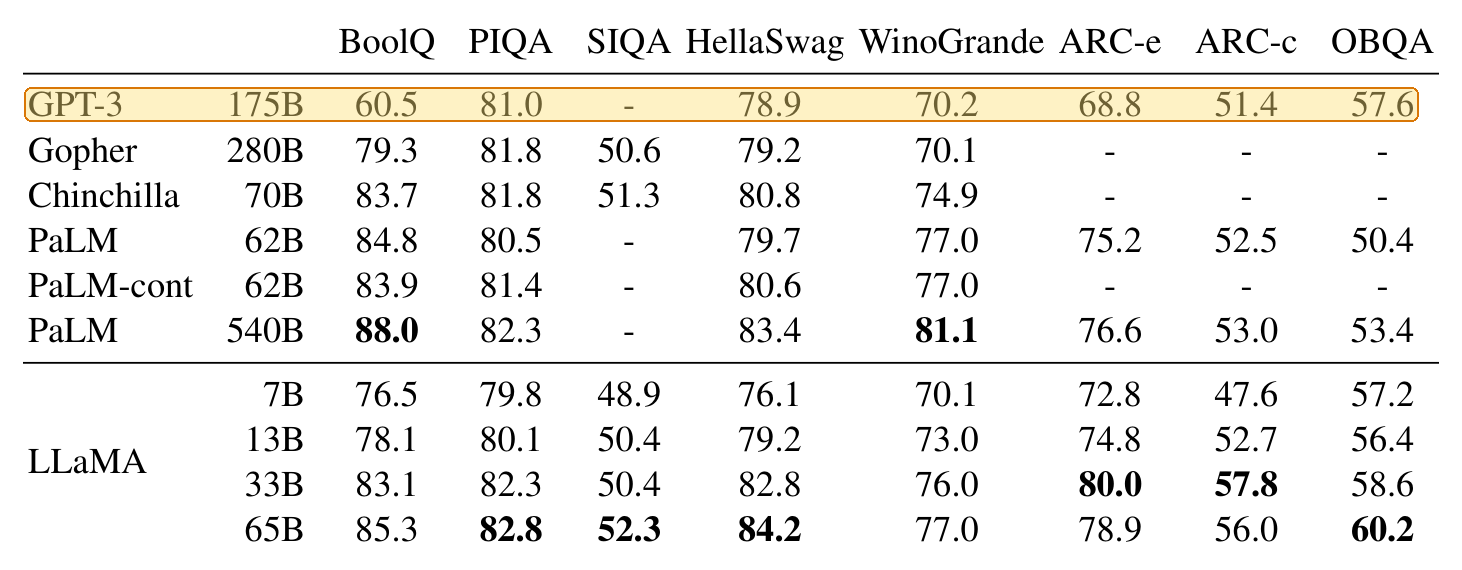
Po ekstrakcji to 102 wiersze: pięciowierszowy nagłówek, potem jedna wartość na wiersz. Oto pierwszych 16; dziesięć od GPT-3 do 57.6 to wyróżniony wiersz tabeli.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Nic nie mówi narzędziu, która liczba należy do którego testu. Jeśli wkleisz to do okienka tłumaczenia, dostaniesz z powrotem tę samą listę. Słowa są przetłumaczone, ale tabela znika.
1.2 Jedno zdanie, a w nim cała tabela
Ostatnie zdanie na stronie 3 artykułu o LLaMA urywa się na „we need to”:
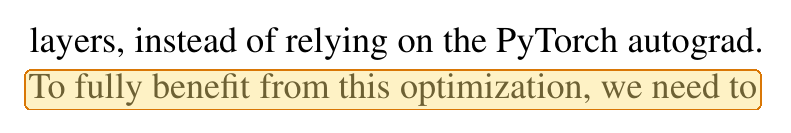
Ciągnie się dalej w lewej kolumnie strony 4, tuż pod Tabelą 3:
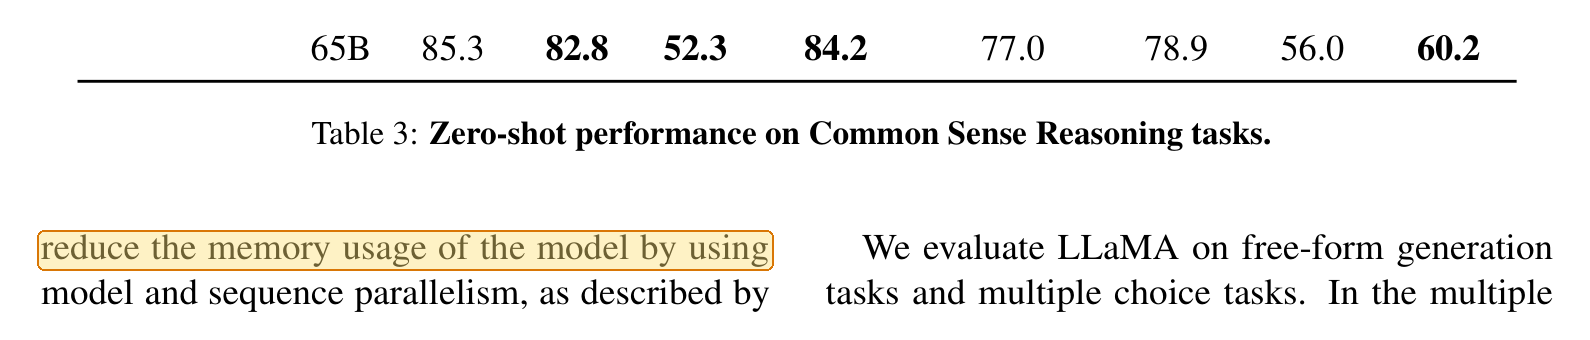
W wyodrębnionym tekście przypis, podział strony, wszystkie 102 wiersze tabeli i jej podpis mieszczą się wewnątrz tego jednego zdania:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
To samo dzieje się dwie strony dalej. Strona 5 kończy się na „…the textual description and tests in a”, a „docstring.” pojawia się dopiero po Tabeli 7 na stronie 6 — pomiędzy jest 44 wiersze tabeli i siedmiowierszowy podpis.
Narzędzie, które tłumaczy strona po stronie albo idzie po tekście dokładnie w tej kolejności, dostaje dwa fragmenty, których nie ma powodu połączyć. W przetłumaczonym pliku widzisz zdanie, które urywa się na dole strony, a jego druga połowa pojawia się gdzieś pod tabelą.
1.3 Indeksy dolne i ułamki zmieniają się w coś innego
W artykule o Mistralu zmienna jest zapisana jako h z indeksem dolnym i:
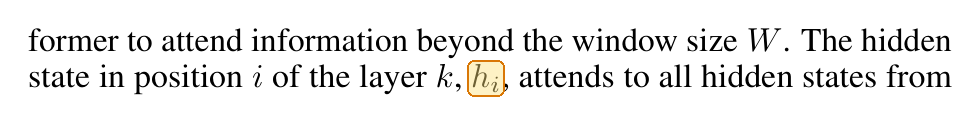
Po ekstrakcji indeks znika i zostaje samo hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Narzędzie nie ma powodu traktować tego jak zmienną. Dla niego hi to po prostu zwyczajne angielskie słowo.
Z ułamkami jest gorzej. LLaMA ustawia jedną wartość na dwie trzecie z 4d, zapisane jako ⅔·4d, gdzie ⅔ złożono z małej 2 nad 3:
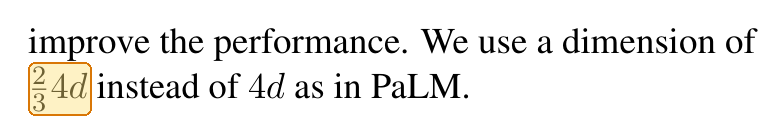
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Dwie trzecie z 4d stały się 34d. Indeksy górne, ułamki i symbole z fontów matematycznych to tylko kształty postawione w określonych miejscach. Wyodrębniony tekst zachowuje kształty, ale traci pozycje.
1.4 Słowa łamane na końcu wiersza
Artykuły dwukolumnowe łamią na końcu wiersza wiele słów. W LLaMA 242 wiersze łamią zwykłe słowo pisane małą literą łącznikiem. Sklejenie ich z powrotem wydaje się proste, dopóki nie trafisz na łącznik, który należy do nazwy:
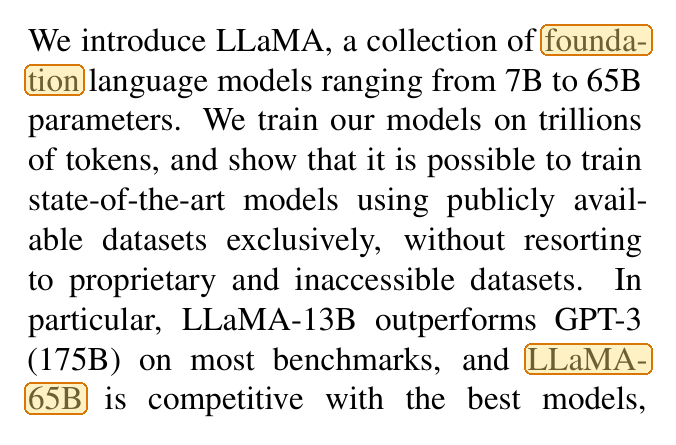
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- i tion tworzą jedno słowo bez łącznika. Ale w LLaMA- i 65B łącznik jest częścią nazwy modelu i musi zostać.
Użyliśmy tylko jednego narzędzia do ekstrakcji, na dwóch artykułach zrobionych w LaTeX-u, systemie składu popularnym w publikacjach akademickich. PDF-y wyeksportowane z Worda, zeskanowane dokumenty i inne narzędzia do ekstrakcji mogą dać inne wyniki, ale tych czterech rodzajów uszkodzeń warto szukać.
2. Jakie masz opcje?
Szczegóły o Tłumaczu Google i DeepL pochodzą z ich własnych stron pomocy, sprawdzone 7 października 2026. Gdy tłumaczenie PDF-a rozczarowuje, rada DeepL brzmi: prześlij zamiast tego dokument źródłowy. To samo radzimy my.
Ostatni wiersz to właśnie to, do czego stworzono tłumaczenie dokumentów Equalang, więc to podejście znamy najlepiej. Przed tłumaczeniem Equalang skleja zdania, które podział strony przeciął na dwoje. Tabele ze scalonymi komórkami i wielowierszowymi nagłówkami są odtwarzane w oryginalnej strukturze, a nie spłaszczane do jednej listy. Wzory nie są wyrzucane jako bezładny tekst, a dla trudnych wzorów wplecionych w wiersz tekstu jest opcja optymalizacji wzorów.
Czego narzędzie nie robi: nie odtwarza oryginału co do znaku. Tłumaczenie dłuższe od oryginału przesuwa łamania wierszy i rozmiary czcionek, więc strony o ciasnym układzie nadal warto przejrzeć. Tłumaczenie dokumentów obejmuje obecnie chiński, angielski, japoński, koreański, hiszpański, francuski i inne języki.
3. Co sprawdzić po przetłumaczeniu PDF-a?
- Tabele. Czy nagłówki są nadal nad właściwymi kolumnami? Czy liczby się nie zmieniły?
- Podziały stron i tekst pod każdą tabelą. Przeczytaj ostatni wiersz każdej strony i zdanie tuż po każdej tabeli. Zdanie, które urywa się i już nigdy nie kończy, to najczęstszy znak, że tekst przetłumaczono kawałkami.
- Wzory i zmienne. Sprawdź kilka wplecionych w wiersz tekstu. Szukaj liter, które zamieniły się w słowa, i ułamków, które zamieniły się w inne liczby.
- Liczba stron i linki. Bardzo różna liczba stron oznacza, że tekst zginął albo wylał się na dodatkowe strony. Kliknij jeden lub dwa wpisy spisu treści, żeby sprawdzić, czy działają.
Źródła
- Touvron i in., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang i in., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Pomoc Tłumacza Google, Translate documents & websites, sprawdzone 7 października 2026.
- Centrum pomocy DeepL, Translate PDF files, sprawdzone 7 października 2026.
- Metoda: tekst wyodrębniono 7 października 2026 za pomocą MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Ilustracje to wycinki ze stron obu artykułów; wyróżnienia są nasze.