แปลเปเปอร์ arXiv แล้วสูตรพัง? เครื่องมือแปลเปเปอร์วิจัย PDF
 Equalang
โดยสังเขป
เจอปัญหาระบบแปลทำสูตร LaTeX พังและตัดประโยคข้ามหน้าในเปเปอร์ 2 คอลัมน์? บทความนี้เจาะลึกข้อจำกัดทางเทคนิค พร้อมวิธีแปล PDF คงรูปเล่มและอ่านเทียบเคียงข้างกันได้อย่างมีประสิทธิภาพ
คำสำคัญ: แปลเปเปอร์ arXiv; เครื่องมือแปลงานวิจัย; แปล PDF สองคอลัมน์คงรูปเล่ม; แปลสูตรคณิตศาสตร์ LaTeX; อ่านเปเปอร์เทียบสองหน้า
ในการติดตามรายงานวิจัยฉบับร่างล่าสุดบน arXiv ประจำสัปดาห์ หรือเร่งอ่านเปเปอร์ที่ได้รับการตอบรับเข้าการประชุมวิชาการระดับแนวหน้า นักศึกษาปริญญาโท-เอกและนักวิจัยจำนวนมากมักต้องเจอกับกำแพงที่มองไม่เห็น: เมื่อคัดลอกข้อความจากไฟล์ PDF สองคอลัมน์ทีละย่อหน้าไปยังหน้าต่างแปลภาษาทั่วไป สูตรคณิตศาสตร์ LaTeX ตัวห้อย ตัวยก และสัญลักษณ์ผลรวมที่รัดกุมกลับแตกกระจายเป็นตัวอักษรที่อ่านไม่รู้เรื่องในทันที การแบ่งพยางค์ด้วยยัติภังค์ (Hyphenation) ข้ามคอลัมน์หรือข้ามหน้ายังทำให้คำถูกตัดครึ่ง ส่งผลให้ประโยคที่แปลด้วยเครื่องอ่านไม่รู้เรื่องและสับสน และเมื่อแปลจบไปหนึ่งหน้า เลขกำกับภาพ ตาราง และตรรกะการอนุมานในต้นฉบับก็กระจัดกระจายไปหมด การต้องสลับหน้าจอไปมาเพื่อหาตำแหน่งอ้างอิงทำให้เสียสมาธิและพลังงานในการอ่านเปเปอร์ไปจนสิ้น
อุปสรรคสำคัญในการทำความเข้าใจเอกสารวิชาการชั้นแนวหน้ามักไม่ใช่เรื่องของคลังคำศัพท์ภาษาอังกฤษที่ไม่เพียงพอ แต่เป็นปัญหา "สูตรคณิตศาสตร์กลายเป็นตัวอักษรขยะ การจัดหน้าแบบสองคอลัมน์แตกกระจัดกระจาย และไม่สามารถเทียบตำแหน่งต้นฉบับกับคำแปลได้พร้อมกัน" ซึ่งขัดจังหวะกระบวนการคิดและสมาธิในการทำความเข้าใจของนักวิจัย
บทความนี้จึงรวบรวมเกณฑ์การเลือกเครื่องมือแปลเอกสารวิชาการ เปรียบเทียบขอบเขตและความสามารถจริงของเครื่องมือโอเพนซอร์สกับเครื่องมือกระแสหลัก พร้อมสาธิตขั้นตอนการอ่านเปเปอร์อย่างละเอียดที่มีประสิทธิภาพสูง โดยไม่ทำให้สูตรพังและยังคงเค้าโครงแบบสองคอลัมน์ไว้ครบถ้วน
1. ทำไมเปเปอร์วิชาการจึงเป็น "โจทย์หิน" สำหรับการแปลด้วยเครื่อง?
เครื่องมือแปลภาษาทั่วไป (เช่น ส่วนขยายแปลคำบนเบราว์เซอร์หรือกล่องแปลข้อความธรรมดา) เชี่ยวชาญในการจัดการกับย่อหน้าทั่วไปที่มีความต่อเนื่อง แต่เมื่อต้องเผชิญกับไฟล์ PDF ทางวิชาการ มักจะพบข้อผิดพลาดมากมาย ซึ่งมีสาเหตุหลักมาจากความท้าทายทางเทคนิค 3 ประการที่พบในเอกสารวิชาการ:
- สูตรคณิตศาสตร์ LaTeX และสัญลักษณ์พิเศษที่ซับซ้อน: เนื้อหาในเปเปอร์มักมีตัวแปรแทรกในบรรทัด (เช่น $\theta_i, \mathbf{W}_Q$) ตัวห้อยตัวยก เศษส่วนซับซ้อน และสมการเทนเซอร์แบบแยกบรรทัด โมเดลแปลภาษาทั่วไปขาดความเข้าใจในโครงสร้างไวยากรณ์การจัดหน้า (syntax tree) จึงมักแปลตัวแปรทางคณิตศาสตร์เป็นคำทั่วไป หรือแยกสัญลักษณ์อย่างเครื่องหมายสแควร์รูทในตัวส่วน $\sqrt{d_k}$ ออกเป็นตัวอักษรที่ขาดวิ่น ทำให้ขั้นตอนการอนุมานเสียหายทั้งหมด
- การจัดหน้าแบบสองคอลัมน์และการตัดแบ่งหน้าตามจริง: โดยเนื้อแท้แล้ว PDF คือชุดคำสั่งวาดภาพแบบคงที่สำหรับการพิมพ์ จึงไม่มีการไหลเวียนของข้อความเชิงตรรกะตามธรรมชาติ การจัดหน้าแบบสองคอลัมน์มักทำให้เครื่องมือทั่วไปอ่านข้ามคอลัมน์ผิดลำดับ ส่วนประโยคยาวที่อยู่ท้ายหน้าและยังไม่จบมักถูกตัดแบ่งออกเป็นสองท่อน นำไปสู่การแปลที่ผิดพลาดอย่างร้ายแรง
- เลขกำกับรูปภาพ ตาราง และการอ้างอิงโยงสูญหาย: แผนภาพสถาปัตยกรรมอัลกอริทึม (Figure) ตารางผลการทดลองการตัดฟีเจอร์ (Ablation Study Table) ตลอดจนการอ้างอิงสมการเฉพาะในเนื้อหา (เช่น Equation 3) มักคลาดเคลื่อนหรือสูญหายไปในระหว่างการดึงข้อความทั่วไป ซึ่งทำลายความต่อเนื่องของกระบวนการพิสูจน์ข้อเท็จจริง
ดังนั้น เครื่องมือแปลเอกสารวิชาการที่มีประสิทธิภาพจึงจำเป็นต้องมีขีดความสามารถหลักในด้าน "การวิเคราะห์โครงสร้างเค้าโครง PDF + การคงสูตร LaTeX ไว้ที่ตำแหน่งเดิม + การอ่านเปรียบเทียบต้นฉบับและคำแปลควบคู่กัน"
2. เปรียบเทียบแนวทางและเครื่องมือแปลเอกสารวิชาการกระแสหลักในท้องตลาด
ในการทำวิจัยทั่วไป วิธีการแปลเอกสารที่พบได้บ่อยแบ่งออกเป็น 3 กลุ่มหลัก ซึ่งแต่ละกลุ่มมีขอบเขตและข้อจำกัดการใช้งานที่ชัดเจน:
สำหรับผู้ที่ต้องการทั้งความถูกต้องของสูตร การจัดหน้าที่เป็นระเบียบ และความสะดวกพร้อมใช้งานทันทีโดยไม่ต้องตั้งค่าระบบ เราขอแนะนำขั้นตอนการทำงานจริงโดยใช้ Equalang ที่เราพัฒนาขึ้น
3. 3 ขั้นตอนสร้างเวิร์กโฟลว์อ่านเปเปอร์สองคอลัมน์แบบหน้าคู่ "ซ้ายอังกฤษ ขวาฉบับแปล"
เพื่อให้การอ่านเอกสารทางวิชาการเป็นไปอย่างราบรื่น คุณสามารถนำต้นฉบับและเอกสารแปลที่สร้างขึ้นมาเปิดเทียบเคียงข้างกันซ้ายขวา เพื่อการอ่านอย่างละเอียดและต่อเนื่อง
ขั้นตอนที่ 1: แยกวิเคราะห์ทั้งเอกสารและเปิดใช้งานการปรับโครงสร้างสูตรให้เหมาะสม
อัปโหลดไฟล์ PDF ต้นฉบับที่ดาวน์โหลดจาก arXiv บนหน้า การแปลเอกสาร บนเว็บไซต์ Equalang สำหรับเปเปอร์ด้านวิทยาศาสตร์ วิศวกรรมศาสตร์ คอมพิวเตอร์ หรือฟิสิกส์ที่มีสูตรคณิตศาสตร์หนาแน่น ระบบจะทำการป้องกันสัญลักษณ์ในบรรทัดและสมการแยกบรรทัดเป็นพิเศษในระหว่างขั้นตอนการแยกวิเคราะห์
สำหรับประโยคยาวที่ถูกตัดขาดที่ส่วนท้ายของหน้า ระบบจะนำมาเรียบเรียงและเชื่อมต่อกันในระดับตรรกะของย่อหน้าก่อน จากนั้นจึงทำการแปลตามบริบทอย่างต่อเนื่อง เพื่อป้องกันไม่ให้ประโยคขาดตอนระหว่างหน้า
ขั้นตอนที่ 2: ตรวจสอบความถูกต้องของโครงสร้างสูตรและสัญลักษณ์ที่ซับซ้อน
เมื่อการแปลเสร็จสิ้น เอกสารฉบับแปลที่ได้จะยังคงความกว้างของคอลัมน์ทั้งสอง ลำดับชั้นของหัวข้อ รูปภาพ ตาราง และตำแหน่งของคำบรรยายภาพตามต้นฉบับเดิมไว้อย่างครบถ้วน
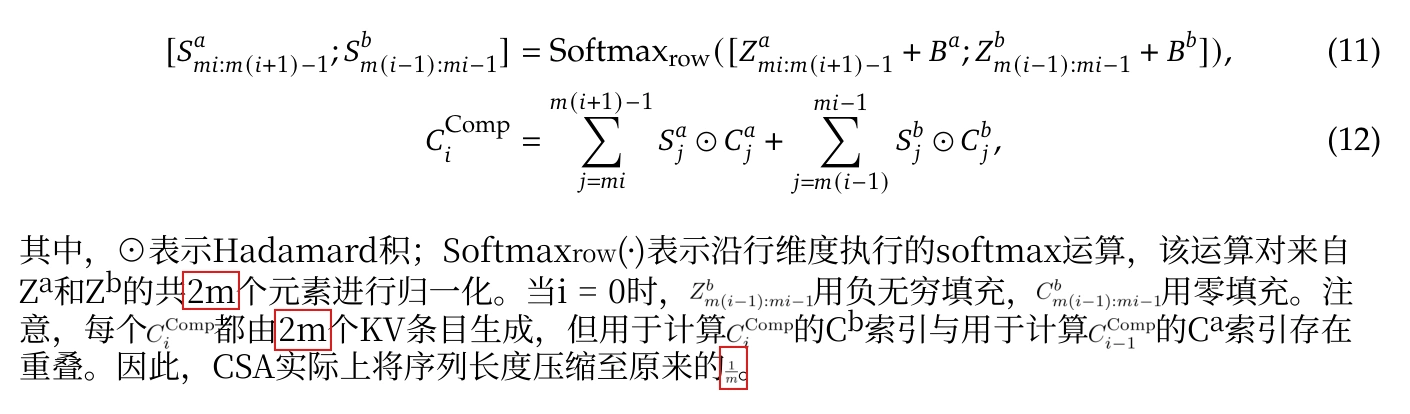
เมื่อต้องจัดการกับเนื้อหาที่มีการอนุมานอย่างรัดกุม เช่น ในเปเปอร์ DeepSeek-V4 ภาพด้านบนจะแสดงให้เห็นถึงผลลัพธ์ของการจัดหน้าสูตรและคำแปล:
- สัญลักษณ์ในบรรทัดไม่ถูกแปลเป็นข้อความ: สัญลักษณ์ในบรรทัด เช่น 2m และ Z^a ไม่ถูกแปลผิดเป็นข้อความธรรมดา แต่ขนาดตัวอักษรของสูตรในบรรทัดบางส่วนเล็กลงอย่างเห็นได้ชัด
- สมการแยกบรรทัดและเลขกำกับจัดตำแหน่งตรงกัน: สูตร CSA (11)(12) จัดวางอยู่กึ่งกลาง พร้อมทั้งรักษาเลขดัชนีกำกับสมการทางด้านขวาไว้อย่างชัดเจน ทำให้ลำดับตรรกะและการอนุมานของเนื้อหาเชื่อมโยงกันอย่างราบรื่น
ขั้นตอนที่ 3: เปิดหน้าต่างเทียบต้นฉบับกับฉบับแปลเคียงข้างกัน
เปิดไฟล์ต้นฉบับภาษาอังกฤษและไฟล์แปลภาษาจีนที่ดาวน์โหลดมาแยกกันใน macOS "Preview", Acrobat, PDF Expert หรือเบราว์เซอร์ Edge แล้วจัดวางสองหน้าต่างเคียงข้างกันทางซ้ายและขวา:
- หน้าต่างฝั่งซ้ายของหน้าจอให้เปิดไฟล์ต้นฉบับภาษาอังกฤษ
- หน้าต่างฝั่งขวาของหน้าจอให้เปิดไฟล์แปลภาษาจีนที่เกี่ยวข้อง แล้วเปิดไปยังหน้าที่ตรงกัน
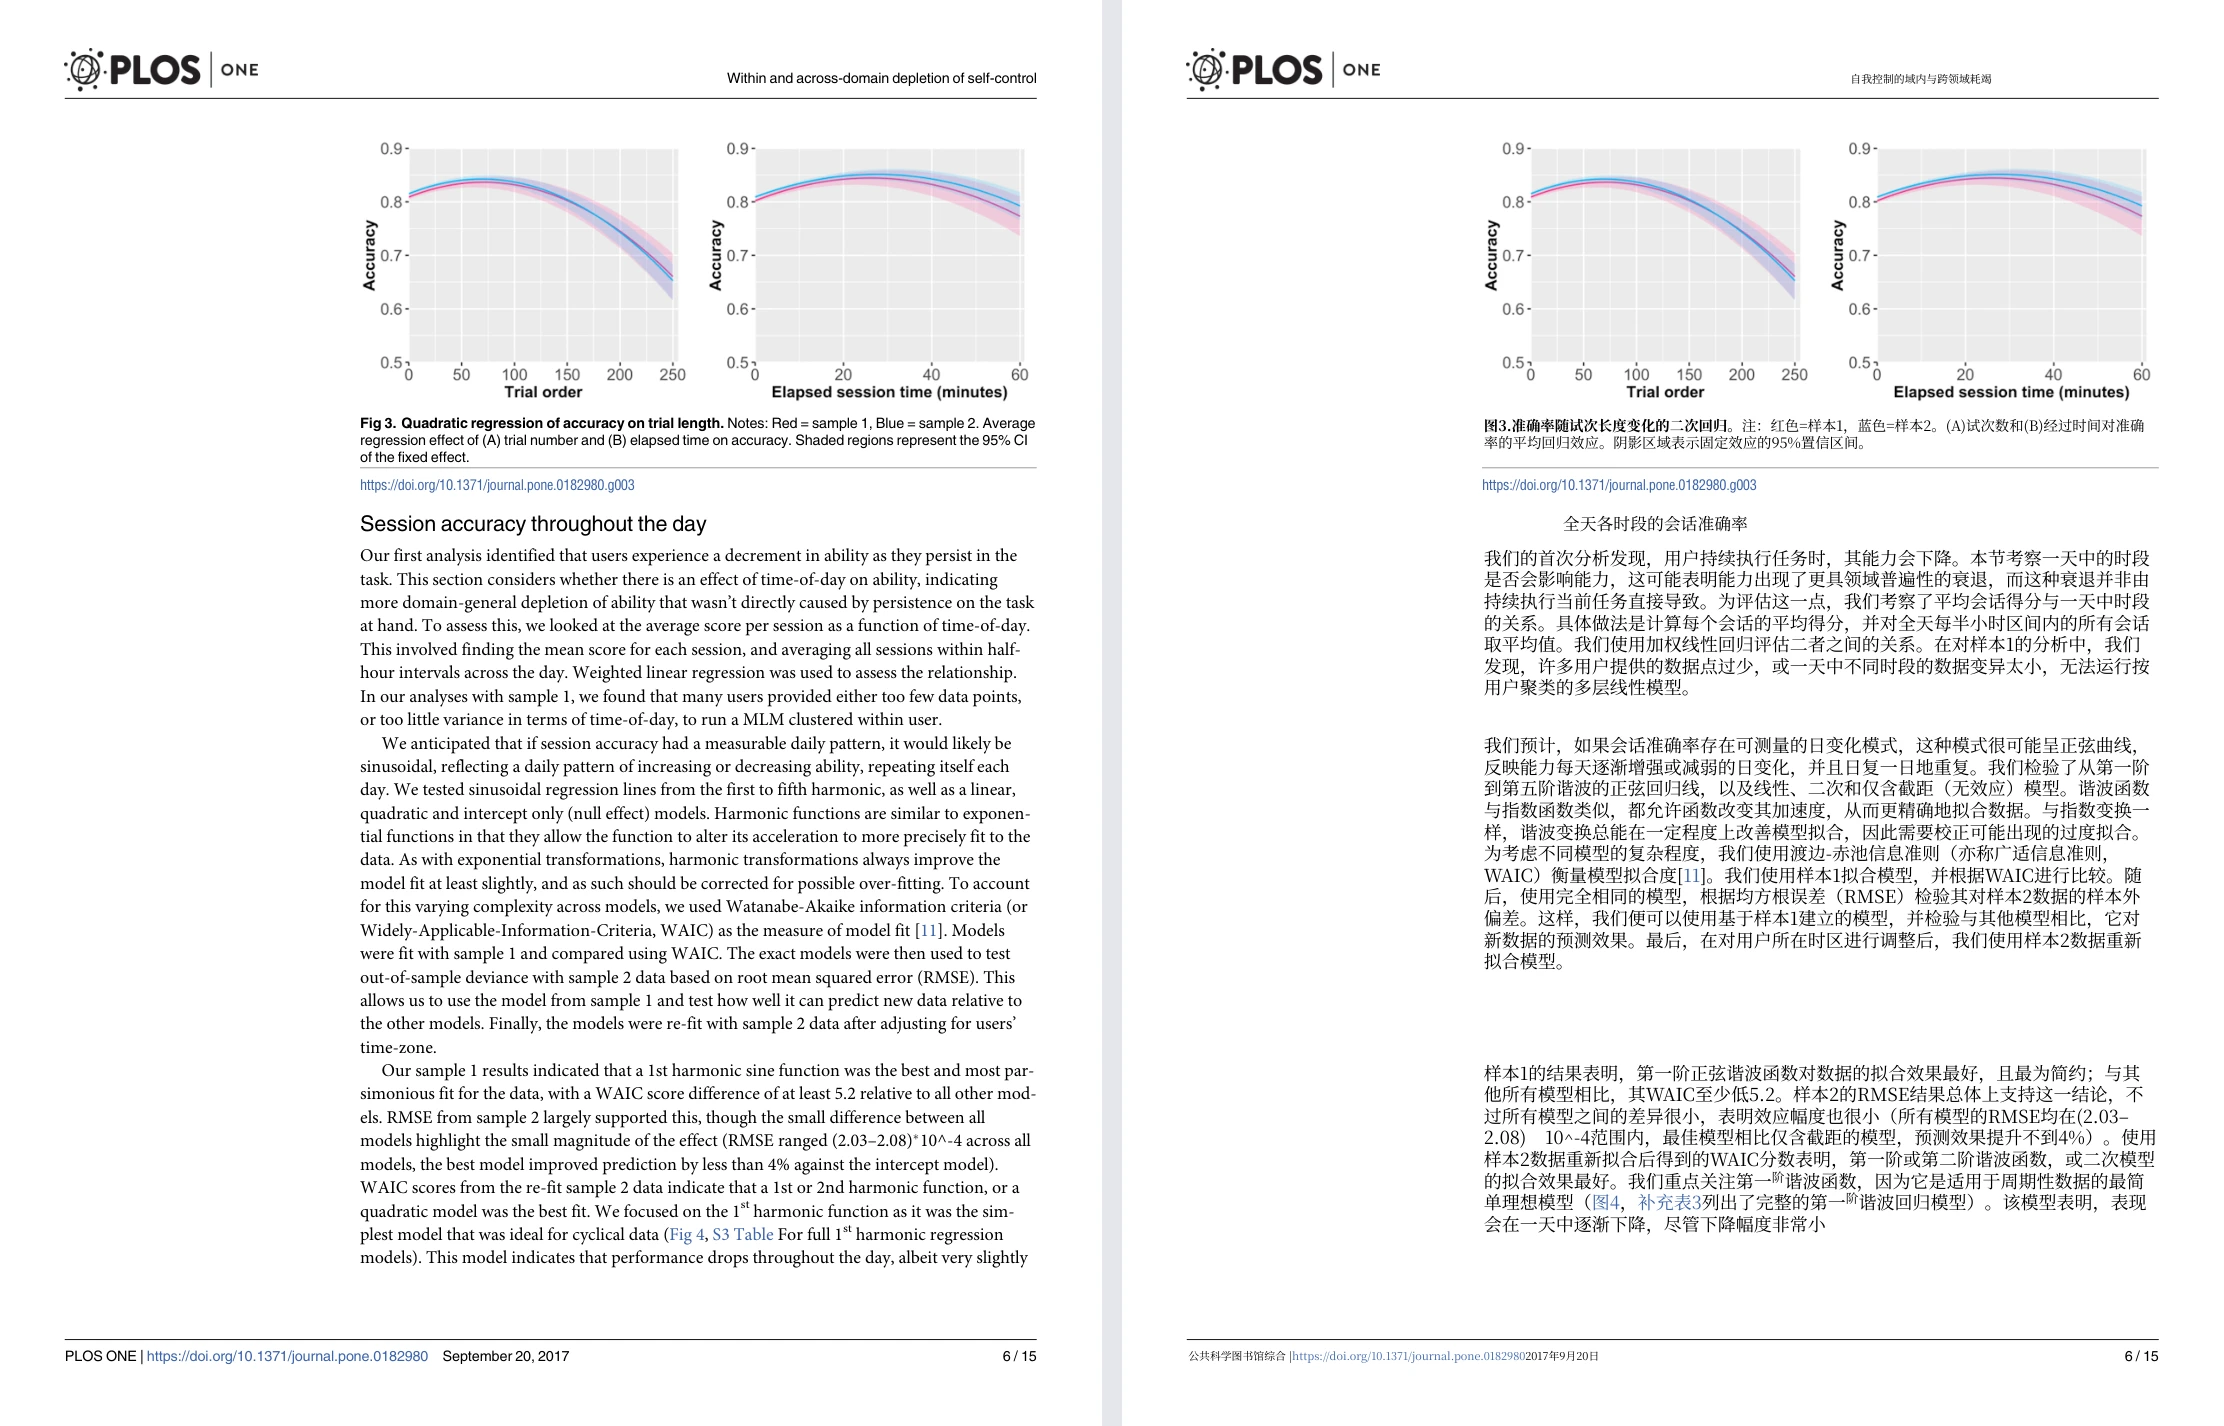
เมื่อปรับแต่งเรียบร้อยแล้ว ด้านซ้ายของหน้าจอจะเป็นเอกสารต้นฉบับภาษาอังกฤษหน้าที่ $N$ และด้านขวาจะเป็นฉบับแปลภาษาจีนหน้าที่ $N$ ที่ตรงกัน:
- เมื่อต้องการกวาดสายตาอ่านคำอธิบาย ให้ดูที่ฉบับแปลภาษาจีนทางด้านขวา เพื่อทำความเข้าใจแรงจูงใจในการวิจัย ข้อโต้แย้งหลัก และการออกแบบการทดลองของผู้เขียนได้อย่างรวดเร็ว
- เมื่อพบสูตรสำคัญ ตัวย่อเฉพาะทาง หรือโค้ดที่ซับซ้อน สามารถเหลือบมองฉบับภาษาอังกฤษต้นฉบับทางด้านซ้าย เพื่อตรวจสอบนิยามทางคณิตศาสตร์ดั้งเดิมได้อย่างเป็นธรรมชาติ
4. ข้อควรระวังในการอ่านเอกสารวิชาการแบบสองภาษาอย่างละเอียด
ในการใช้เครื่องมือช่วยอ่านเอกสารวิชาการ ขอแนะนำให้รักษานิสัยการทำวิจัยที่ดีดังต่อไปนี้:
- ตรวจสอบข้อสรุปสำคัญกับนิยามในต้นฉบับเสมอ: แม้การแปลด้วยเครื่องจะช่วยลดอุปสรรคด้านภาษาลงได้อย่างมาก แต่ในขั้นตอนการอ้างอิงเอกสาร (Citation) การพิสูจน์ทฤษฎีบทอย่างเคร่งครัด หรือการนำโค้ดไปทำซ้ำ ควรอิงตามนิยามที่แน่นอนของเอกสารต้นฉบับภาษาอังกฤษเป็นหลักเสมอ
- ระวังความแตกต่างระหว่างเอกสารสแกนและเอกสารเวกเตอร์: หากเป็นเอกสารเก่าที่เป็นภาพสแกนและไม่ได้ผ่านกระบวนการ OCR คุณภาพสูง ความสมบูรณ์ของการจัดหน้าอาจได้รับผลกระทบ ดังนั้นควรเลือกใช้ไฟล์ PDF เวกเตอร์ต้นฉบับจาก arXiv หรือสำนักพิมพ์ทางการอย่าง IEEE/ACM ให้มากที่สุด
- คงชื่อภาษาอังกฤษดั้งเดิมสำหรับรหัสเทียม (Pseudocode) ที่ซับซ้อน: ชื่อฟังก์ชัน ชื่อตัวแปร และชื่อไลบรารีภายนอก (เช่น คำสั่งเฉพาะของ PyTorch / TensorFlow) ในขั้นตอนของอัลกอริทึมควรคงภาษาอังกฤษต้นฉบับไว้ เพื่อป้องกันไม่ให้การแปลส่งผลกระทบต่อความเข้าใจในการลงมือปฏิบัติจริง
ข้อมูลอ้างอิง / Sources
- บริการแปลเอกสาร Equalang
- ฐานข้อมูลรายงานวิจัยฉบับร่างแบบเปิด arXiv.org
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- โครงการเครื่องมือแปลเปเปอร์วิชาการโอเพนซอร์ส PDFMathTranslate