PDFs traduzidos: por que perdem a formatação e como evitar
 Equalang
Em resumo
A maioria dos PDFs não marca quais palavras formam um parágrafo ou uma tabela. Com dois artigos mostramos o que quebra e o que conferir.
Palavras-chave: traduzir PDF; tradução de documentos; formatação do PDF; manter o layout; artigos científicos
Um arquivo do Word registra quais palavras formam um parágrafo e quais pertencem a uma tabela. A maioria dos PDFs não faz isso. Eles guardam apenas as letras e as coordenadas onde desenhá-las; os parágrafos, as tabelas e as frases são montados pelo olho de quem lê. Alguns PDFs trazem tags de acessibilidade (incluídas para leitores de tela) que marcam parágrafos e tabelas, mas muitos não trazem (os dois artigos que usamos como exemplo abaixo não têm nenhuma), então uma ferramenta de tradução não pode contar com elas. Tudo o que você vê como estrutura (um layout de duas colunas, um cabeçalho que se estende por várias colunas ou uma frase que continua na página seguinte) precisa ser reconstruído antes de qualquer tradução. Depois, o texto traduzido, agora maior ou menor, tem que voltar a caber no layout original. A formatação se perde em uma dessas duas etapas.
O que fazer depende do que você tem:
- O .docx ou .pptx original: traduza esse arquivo em vez do PDF.
- Um PDF de texto simples, com poucas tabelas, com menos de 10 MB: o envio gratuito de documentos do Google Tradutor é a opção mais rápida de testar.
- Um artigo, manual ou relatório com tabelas, equações ou duas colunas: use uma ferramenta de tradução que reconstrua o layout e depois confira os quatro pontos da seção 3.
- Um material digitalizado (em que não dá para selecionar o texto): ele precisa de reconhecimento de texto (OCR) antes de poder ser traduzido. O DeepL aceita digitalizações e cuida dessa etapa. O Google Tradutor deixa as páginas digitalizadas sem tradução.
1. O que uma ferramenta de tradução realmente vê em um PDF?
Nós construímos uma ferramenta de tradução de documentos, então passamos muito tempo olhando o que sai dos PDFs. Para mostrar isso com clareza, pegamos dois artigos sobre modelos de linguagem de IA no arXiv, LLaMA e Mistral 7B, e extraímos o texto deles com o mutool, do MuPDF, uma ferramenta de PDF de código aberto muito usada. Esse texto é mais ou menos aquilo com o qual uma ferramenta trabalha quando não lê também o layout. Abaixo, cada trecho aparece primeiro como está na página e depois como sai na extração (uma linha só com … significa que pulamos algumas linhas).
1.1 As tabelas viram uma lista de números
A tabela 3 do artigo do LLaMA compara dez modelos em oito testes:
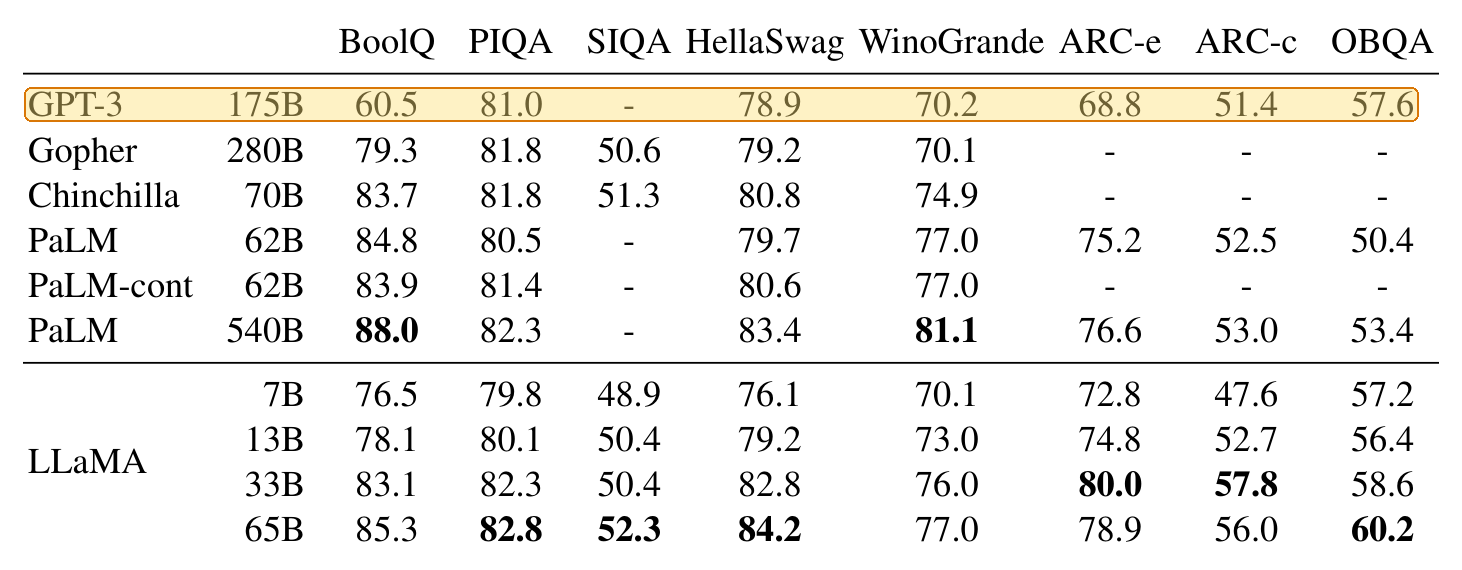
Depois de extraída, são 102 linhas: cinco linhas de cabeçalho e, em seguida, um valor por linha. Estas são as primeiras 16; as dez que vão de GPT-3 a 57.6 são a linha destacada.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Nada informa à ferramenta de tradução qual número pertence a qual teste. Se você colar isso em um campo de tradução, recebe a mesma lista de volta. As palavras foram traduzidas, mas a tabela desapareceu.
1.2 Uma frase, com uma tabela inteira dentro
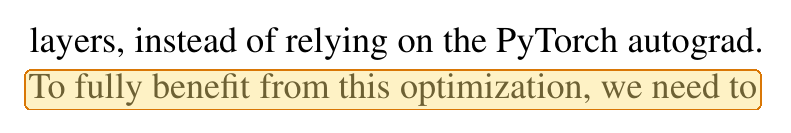
A última frase da página 3 do artigo do LLaMA para em "we need to":
Ela continua na coluna da esquerda da página 4, logo abaixo da tabela 3:
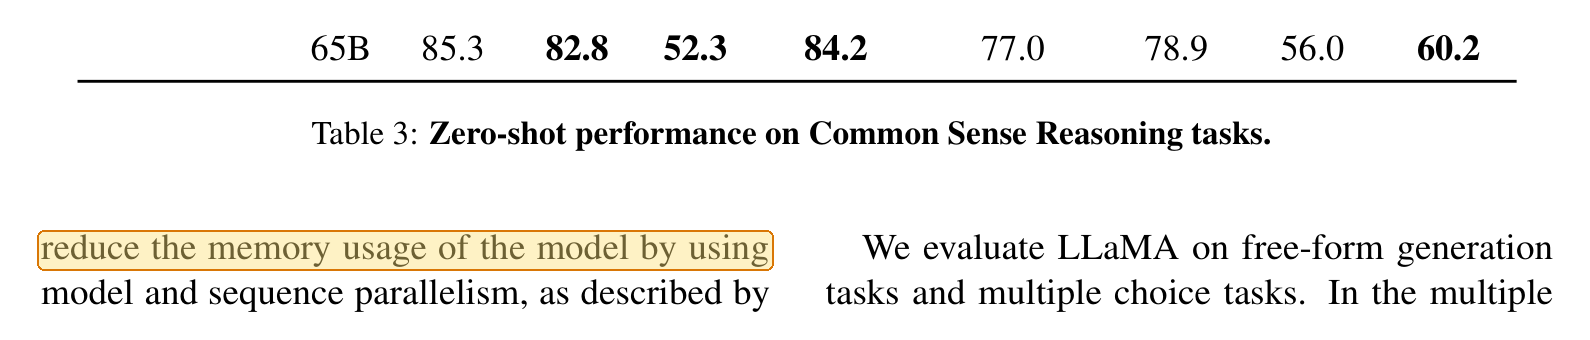
No texto extraído, uma nota de rodapé, a quebra de página, as 102 linhas da tabela e a legenda dela ficam dentro dessa única frase:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Isso acontece de novo duas páginas depois. A página 5 termina em "…the textual description and tests in a", e "docstring." só aparece depois da tabela 7 da página 6, com as 44 linhas da tabela e a legenda de sete linhas no meio do caminho.
Uma ferramenta que traduz página por página, ou que segue o texto nessa ordem exata, recebe dois fragmentos sem motivo para conectá-los. No arquivo traduzido, você vê uma frase que se apaga no fim de uma página, e a outra metade reaparece em algum lugar abaixo de uma tabela.
1.3 Subscritos e frações viram outra coisa
No artigo do Mistral, uma variável é escrita como h com o subscrito i:
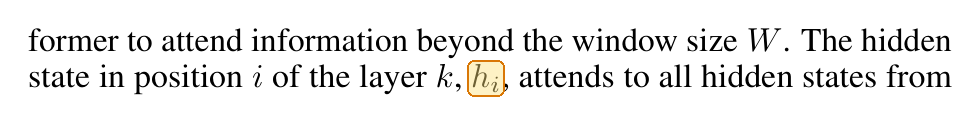
Na extração, o subscrito desaparece e sobra hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Uma ferramenta de tradução não tem motivo para tratar isso como uma variável. Para ela, hi é apenas uma palavra comum do inglês.
As frações se saem pior. O LLaMA define um valor como dois terços de 4d, escrito ⅔·4d, com o ⅔ composto por um 2 pequeno sobre um 3:
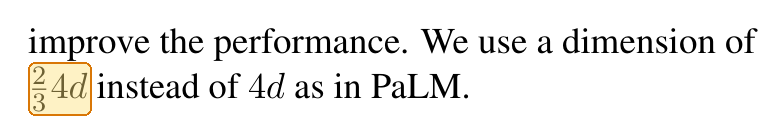
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Dois terços de 4d viraram 34d. Sobrescritos, frações e símbolos de fontes matemáticas são apenas formas colocadas em posições específicas. O texto extraído mantém as formas, mas perde as posições.
1.4 As palavras são cortadas no fim da linha
Artigos de duas colunas separam muitas palavras no fim da linha. No LLaMA, 242 linhas cortam uma palavra comum em letras minúsculas com um hífen. Juntá-las de novo parece fácil, até você chegar a um hífen que faz parte de um nome:
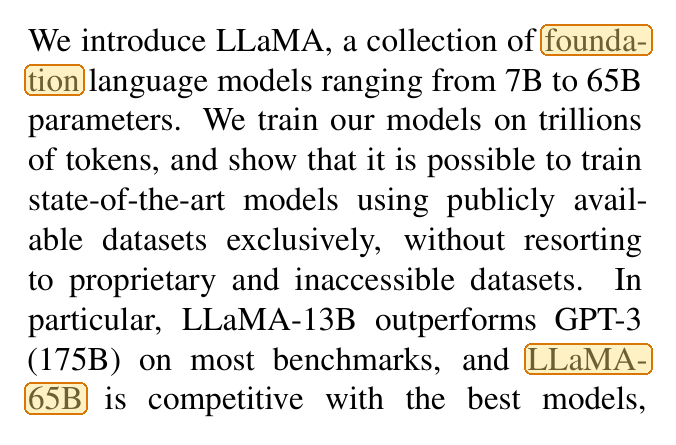
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- e tion formam uma só palavra sem o hífen. Mas em LLaMA- e 65B, o hífen faz parte do nome do modelo e tem que ficar.
Usamos apenas uma ferramenta de extração, em dois artigos feitos em LaTeX, um sistema de diagramação comum na publicação acadêmica. PDFs exportados do Word, documentos digitalizados e outras ferramentas de extração podem dar resultados diferentes, mas estes são os quatro tipos de dano que você deve procurar.
2. Quais são as suas opções?
As informações sobre Google Tradutor e DeepL vêm das próprias páginas de ajuda deles, consultadas em 7 de outubro de 2026. Quando a tradução de um PDF decepciona, o DeepL recomenda enviar o documento original em vez disso. É também a nossa recomendação.
A última linha é exatamente o que a tradução de documentos da Equalang foi feita para fazer, então é a abordagem que conhecemos melhor. Antes de traduzir, a Equalang recompõe as frases que uma quebra de página partiu em duas. As tabelas com células mescladas e cabeçalhos de várias linhas são reconstruídas na estrutura original, em vez de achatadas em uma única lista. As equações não são descartadas como texto ilegível, e existe uma opção de otimização de fórmulas para as difíceis que ficam no meio de uma linha de texto.
O que ela não faz é reproduzir o original exatamente como ele é. Uma tradução mais longa que o original desloca as quebras de linha e os tamanhos de fonte, por isso as páginas com layout apertado ainda merecem uma olhada. A tradução de documentos cobre hoje chinês, inglês, japonês, coreano, espanhol, francês e outros idiomas.
3. O que conferir depois que o PDF foi traduzido?
- Tabelas. Os cabeçalhos continuam sobre a coluna certa? Os números seguem iguais?
- As quebras de página e o texto abaixo de cada tabela. Leia a última linha de cada página e a frase logo depois de cada tabela. Uma frase que para e nunca termina é o sinal mais comum de que o texto foi traduzido em pedaços.
- Equações e variáveis. Confira algumas das que estão no meio de uma linha de texto. Procure letras que viraram palavras e frações que viraram outros números.
- Número de páginas e links. Um número de páginas muito diferente significa que texto foi perdido ou vazou para páginas extras. Clique em uma ou duas entradas do sumário para ver se funcionam.
Fontes
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Ajuda do Google Tradutor, Translate documents & websites, consultada em 7 de outubro de 2026.
- Central de Ajuda do DeepL, Translate PDF files, consultada em 7 de outubro de 2026.
- Método: texto extraído em 7 de outubro de 2026 com o MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. As imagens são recortes das páginas dos artigos; os destaques são nossos.