PDF를 번역하면 레이아웃이 깨지는 이유와 확인할 네 곳
 Equalang
핵심 요약
대부분의 PDF는 Word와 달리 문단과 표의 경계를 저장하지 않습니다. 두 편의 논문으로 무엇이 깨지는지 살펴보고, 번역 후 확인할 네 곳을 정리했습니다.
키워드: PDF 번역; 문서 번역; PDF 서식; 레이아웃 유지; 논문 번역
Word 파일에는 어떤 단어가 한 문단을 이루고 어떤 단어가 표에 속하는지 기록되어 있습니다. 대부분의 PDF에는 그런 기록이 없습니다. PDF에는 그저 글자와 그 글자를 그릴 좌표만 담겨 있을 뿐입니다. 문단, 표, 문장은 읽는 사람의 눈이 이어 붙이는 것입니다. 일부 PDF에는 문단과 표를 표시하는 접근성 태그(스크린 리더용으로 추가된 것)가 있지만, 없는 경우도 많습니다(아래에서 예로 드는 두 편의 논문에는 없습니다). 그래서 번역 도구는 이 태그를 기대할 수 없습니다. 2단 구성, 여러 단을 가로지르는 표제, 다음 페이지로 이어지는 문장처럼 구조로 보이는 모든 것은 번역 전에 다시 알아내야 합니다. 그다음에는 길이가 달라진 번역문을 원래 레이아웃에 다시 담아야 합니다. 서식이 깨지는 것은 이 두 단계 중 어딘가입니다.
무엇을 해야 할지는 가진 파일에 따라 다릅니다:
- 원본 .docx 또는 .pptx: PDF 대신 그 파일을 번역하세요.
- 표가 거의 없는 10 MB 이하의 텍스트 PDF: Google 번역의 무료 문서 업로드가 가장 먼저 시도해 볼 만한 방법입니다.
- 표·수식·2단 구성이 있는 논문, 매뉴얼, 보고서: 레이아웃을 다시 만드는 번역 도구를 사용하고, 3장에서 나열한 네 곳을 확인하세요.
- 스캔본(글자를 선택할 수 없는 파일): 번역 전에 문자 인식(OCR)이 필요합니다. DeepL은 스캔본을 받아 이 단계를 자체적으로 처리합니다. Google 번역은 스캔한 페이지를 번역하지 않고 그대로 둡니다.
1. 번역 도구는 PDF에서 무엇을 보는가
우리는 문서 번역 도구를 만들기 때문에 PDF에서 나오는 글자를 늘 들여다봅니다. 이를 분명히 보여주기 위해 arXiv에서 AI 언어 모델에 관한 논문 두 편(LLaMA와 Mistral 7B)을 가져와, 흔히 쓰이는 오픈소스 PDF 도구인 MuPDF의 mutool로 텍스트를 추출했습니다. 레이아웃까지 읽지 않는 도구라면 대략 이런 텍스트를 가지고 작업하게 됩니다. 아래에서는 각 부분을 페이지에 보이는 그대로 먼저 보여주고, 이어서 추출된 결과를 보여줍니다(…만 있는 줄은 일부 줄을 건너뛴 곳입니다).
1.1 표가 세로로 늘어선 숫자 목록으로 바뀐다
LLaMA 논문의 표 3은 모델 10개를 테스트 8개에서 비교합니다.
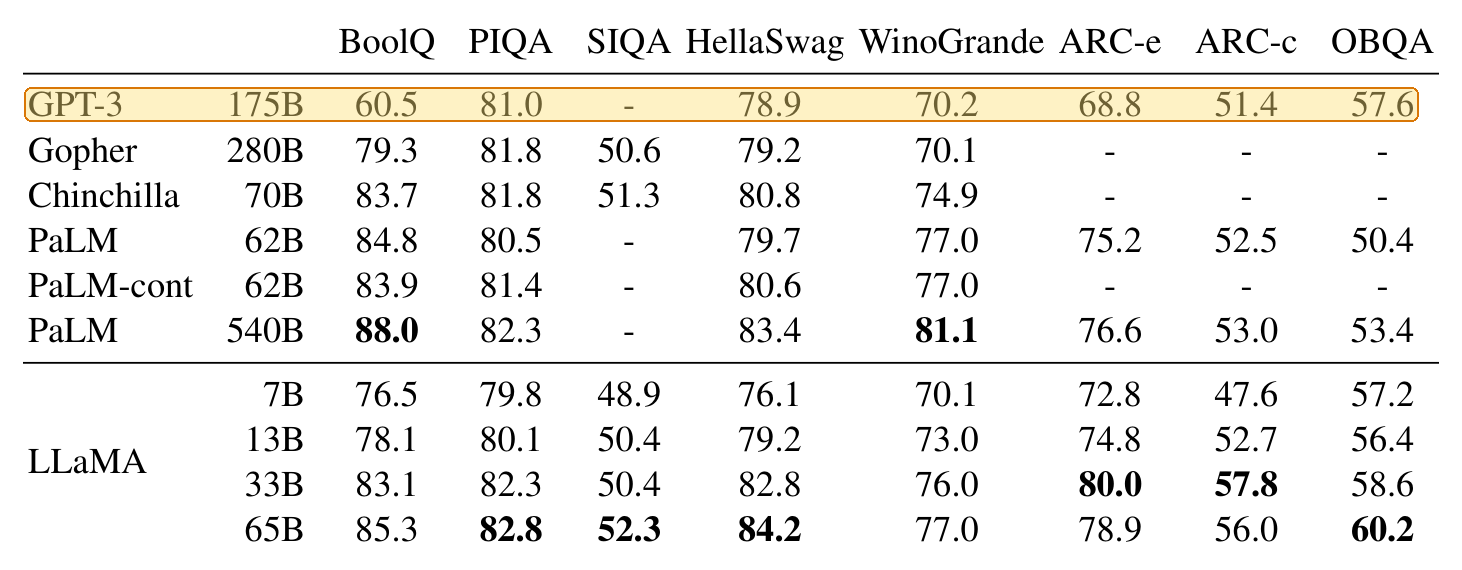
추출하면 102줄입니다. 다섯 줄의 머리글 다음에 한 줄에 값 하나씩입니다. 아래는 처음 16줄이며, GPT-3에서 57.6까지의 10줄이 강조 표시한 행입니다.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
어떤 숫자가 어떤 테스트에 속하는지 알려주는 정보는 아무것도 없습니다. 이걸 번역 상자에 붙여넣으면 세로로 늘어선 똑같은 숫자 목록이 그대로 돌아옵니다. 단어는 번역되지만 표는 사라집니다.
1.2 문장 하나에 표 전체가 들어 있다
LLaMA 논문 3쪽의 마지막 문장은 "we need to"에서 끊깁니다.
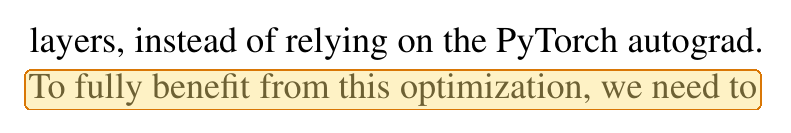
뒤는 4쪽 왼쪽 단, 표 3 바로 아래에서 이어집니다.
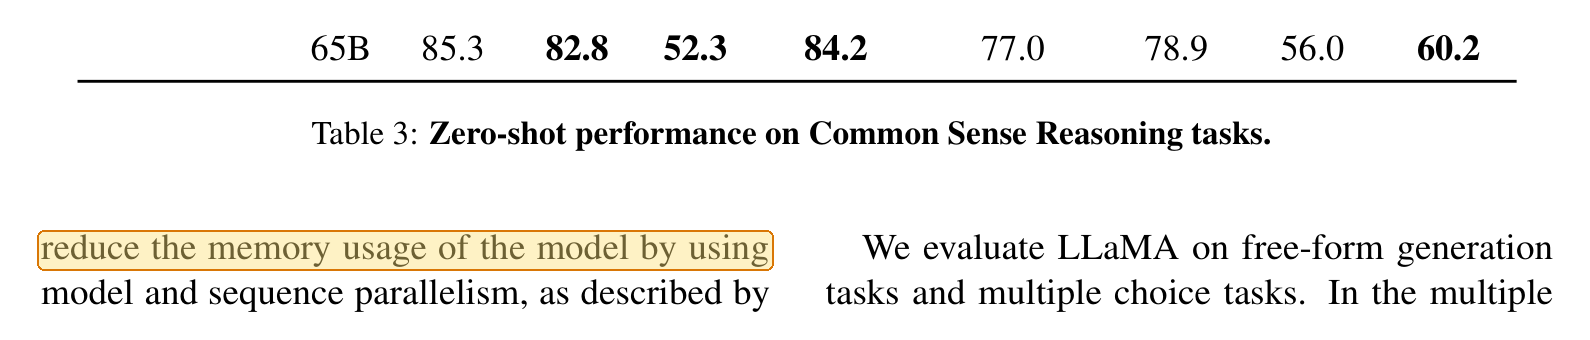
추출된 텍스트에서는 각주, 페이지 나눔, 표 3의 102줄 전체, 그리고 그 표제가 이 문장 하나 안에 들어 있습니다.
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
같은 일이 두 쪽 뒤에 또 일어납니다. 5쪽은 "…the textual description and tests in a"로 끝나고, "docstring."은 6쪽 표 7 뒤에야 나오며 그 사이에 표 7의 44줄과 7줄짜리 표제가 끼어 있습니다.
페이지별로 번역하거나 추출된 순서대로 번역하는 도구는 이 두 조각을 연결해야 할 이유를 찾지 못합니다. 번역된 파일에서는 페이지 맨 아래에서 문장이 흐지부지 끝나고, 나머지 반쪽은 표 아래 어딘가에 나타납니다.
1.3 아래 첨자와 분수는 다른 것으로 바뀐다
Mistral 논문에서는 변수 h를 아래 첨자 i와 함께 씁니다.
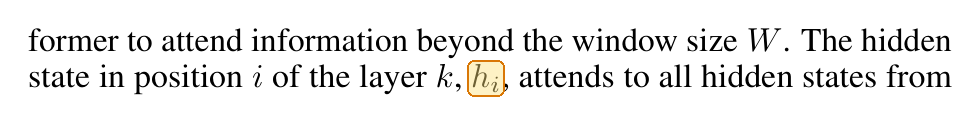
추출하면 아래 첨자가 사라지고 hi만 남습니다.
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
번역 도구가 이것을 변수로 취급할 이유는 없습니다. 도구에게 hi는 흔한 영어 단어일 뿐입니다.
분수는 형편이 더 나쁩니다. LLaMA는 어떤 값을 4d의 3분의 2로 정하는데, ⅔·4d로 쓰며 ⅔는 작은 2를 3 위에 올려놓은 모양입니다.
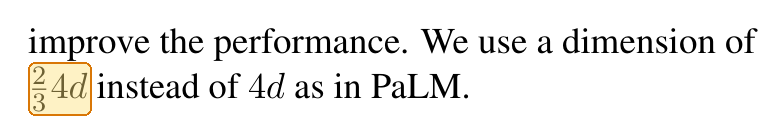
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
4d의 3분의 2가 34d가 되었습니다. 위 첨자, 분수, 수학 폰트의 기호는 특정 위치에 놓인 그림일 뿐입니다. 추출된 텍스트에는 모양이 남지만 위치는 사라집니다.
1.4 단어가 줄 끝에서 잘린다
2단 구성 논문은 양쪽 정렬을 위해 줄 끝에서 단어를 자주 나눕니다. LLaMA에서는 하이픈으로 나뉜 보통 소문자 단어가 242줄에 이릅니다. 다시 붙이는 일은 쉬워 보이지만, 이름에 원래 들어 있는 하이픈을 만나면 이야기가 달라집니다.
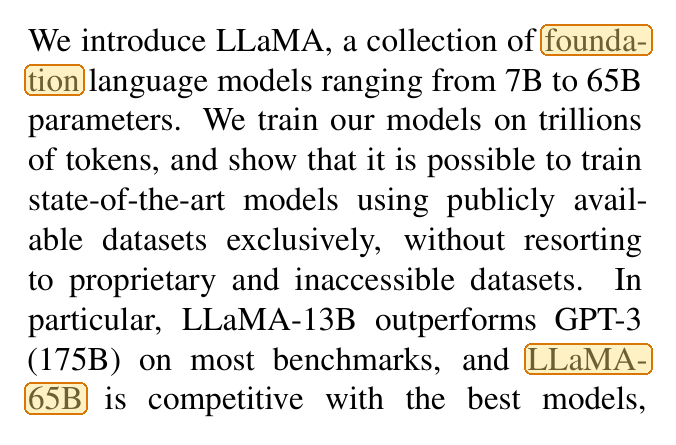
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda-와 tion은 하이픈을 빼야 한 단어가 됩니다. 하지만 LLaMA-와 65B 사이의 하이픈은 모델 이름의 일부라서 그대로 두어야 합니다.
우리는 LaTeX(학술 출판에서 흔한 조판 도구)로 만든 논문 두 편에 추출 도구 하나만 사용했습니다. Word에서 내보낸 PDF, 스캔 문서, 다른 추출 도구에서는 결과가 다를 수 있지만, 찾아야 할 손상은 이 네 가지입니다.
2. 어떤 방법들이 있는가
Google 번역과 DeepL에 관한 내용은 각각의 도움말 페이지에서 가져왔습니다(2026년 10월 7일 확인). PDF 번역 결과가 실망스러울 때 DeepL은 원본 문서를 업로드하라고 권합니다. 이는 우리의 조언과 같습니다.
마지막 줄이 바로 Equalang의 문서 번역이 하려는 일이고, 우리가 가장 잘 아는 방식이기도 합니다. Equalang은 번역 전에 페이지 나눔으로 끊긴 문장을 다시 이어 붙입니다. 병합된 셀과 여러 줄 머리글이 있는 표는 하나의 세로 열로 납작하게 만들지 않고, 원래 구조대로 다시 만듭니다. 수식이 깨진 글자로 버려지지 않고, 문장 안에 있어 다루기 힘든 수식에는 수식 최적화 옵션이 있습니다.
다만 원본을 그대로 재현하지는 못합니다. 번역문이 원문보다 길어지면 줄바꿈과 글꼴 크기가 달라지므로, 원래 촘촘한 페이지는 여전히 확인할 가치가 있습니다. 문서 번역은 현재 한국어, 영어, 중국어, 일본어, 스페인어, 프랑스어 등 여러 언어를 지원합니다.
3. PDF를 번역한 뒤 무엇을 확인해야 하나
- 표. 머리글이 여전히 맞는 열 위에 있는가. 숫자는 바뀌지 않았는가.
- 페이지 나눔과 표 아래 텍스트. 각 페이지의 마지막 줄과 각 표 바로 뒤의 문장을 읽어 보세요. 문장이 끝나지 않고 끊기는 것은 텍스트가 조각난 채 번역되었을 때 가장 흔히 나타나는 신호입니다.
- 수식과 변수. 문장 안에 있는 수식 몇 개를 확인하세요. 단어로 바뀐 글자나 다른 숫자가 된 분수가 있는지 살펴봅니다.
- 쪽수와 링크. 쪽수가 크게 다르다면 텍스트가 빠졌거나 다른 쪽으로 넘쳤다는 뜻입니다. 목차 항목을 한두 개 눌러 제대로 작동하는지 확인하세요.
출처
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Google 번역 도움말, Translate documents & websites, 2026년 10월 7일 확인.
- DeepL 고객센터, Translate PDF files, 2026년 10월 7일 확인.
- 방법: 2026년 10월 7일 MuPDF 1.25.6으로 텍스트 추출, 명령어
mutool draw -q -F txt -o out.txt in.pdf. 그림은 논문 페이지를 잘라낸 것이며, 강조 표시는 필자가 넣었습니다.