arXiv 논문 수식이 자꾸 깨진다면? 학술 논문 번역 도구 비교와 2단 대조 정독 가이드
 Equalang
핵심 요약
2단 학술 논문의 LaTeX 수식과 페이지가 넘어가는 긴 문장이 번역기 때문에 흐트러지셨나요? 학술 논문 번역의 기술적 난제를 짚어보고, 2단 레이아웃 유지와 원문·번역문 나란히 대조를 활용한 효율적인 논문 독해법을 소개합니다.
키워드: arXiv 논문 번역; 학술 논문 번역 도구; PDF 2단 레이아웃 유지; LaTeX 수식 번역; 원문 대조 논문 읽기
매주 arXiv의 최신 프리프린트를 확인하거나 주요 학회 채택 논문 목록을 살펴볼 때, 많은 대학원생과 연구자들은 보이지 않는 벽에 부딪히곤 합니다. 2단(Double-column) 학술 PDF의 텍스트를 복사해 일반 번역기 창에 붙여넣는 순간, 본래 엄밀했던 LaTeX 수학 수식, 위첨자·아래첨자, 합(시그마) 기호들이 순식간에 알아볼 수 없는 깨진 문자 조각으로 흩어져 버립니다. 단이나 페이지가 넘어가는 경계의 하이픈(Hyphenation)으로 인해 단어가 잘려 기계 번역된 문장이 어색해지기도 합니다. 어렵게 한 페이지를 번역하고 나도 원문의 도표 번호와 수식 유도 흐름이 뒤엉켜, 화면을 이리저리 넘나들며 대조하느라 논문을 읽는 데 필요한 집중력을 소진해 버리기 일쑤입니다.
최신 해외 문헌을 제대로 읽어내는 데 있어 진짜 병목은 영어 어휘력 부족이 아닙니다. 바로 **‘수식 깨짐, 2단 레이아웃 붕괴, 원문과 번역문의 비동기화’**로 인해 연구자의 집중 흐름(Flow)이 끊기는 데 있습니다.
이번 글에서는 학술 문헌 번역 도구를 고를 때 살펴봐야 할 핵심 기준을 정리하고, 오픈소스 도구와 주요 번역 방식의 실제 한계를 비교한 뒤, 수식을 보존하면서 2단 레이아웃 원형을 유지하는 효율적인 논문 정독 워크플로우를 살펴봅니다.
1. 학술 논문이 기계 번역에서 유독 까다로운 이유
일반적인 번역 도구(브라우저 드래그 팝업 플러그인이나 텍스트 번역 상자)는 자연스럽게 이어지는 일상 문장을 번역하는 데 유용하지만, 학술 PDF 앞에서는 쉽게 한계를 드러냅니다. 이는 학술 논문 특유의 세 가지 기술적 난제 때문입니다:
- 복잡하게 뒤섞인 LaTeX 수식과 특수 기호: 논문 본문에는 인라인 변수($\theta_i, \mathbf{W}_Q$ 등), 위첨자·아래첨자, 복잡한 분수식, 독립 텐서 방정식이 수없이 교차합니다. 일반적인 기계 번역 모델은 조판 구문 트리(Syntax Tree)를 인식하지 못하기 때문에, 수학 변수를 일반 영어 단어로 오인해 번역하거나 분모의 루트 기호($\sqrt{d_k}$) 등을 엉뚱한 문자로 쪼개버려 수식 유도 흐름을 완전히 무너뜨립니다.
- 2단 레이아웃과 물리적 페이지 분할로 인한 단절: PDF는 기본적으로 인쇄를 목적으로 설계된 정적 그래픽 명령어 집합으로, 텍스트의 자연스러운 문단 논리 흐름을 직접 저장하지 않습니다. 이 때문에 2단 구성 문서를 일반 도구로 추출하면 좌우 양쪽 단을 가로지르며 줄이 뒤섞이기 쉽습니다. 또한 페이지 하단에서 다음 페이지로 이어지는 긴 문장이 중간에 잘려 심각한 오역이 발생하곤 합니다.
- 도표 번호 및 상호 참조(Cross-reference) 유실: 알고리즘 아키텍처 다이어그램(Figure), 절제 연구(Ablation Study) 표(Table), 본문 내 특정 수식 참조 번호(예: Equation 3) 등은 일반적인 텍스트 추출 과정에서 쉽게 누락되거나 위치가 어긋나 논증의 연결 고리를 끊어놓습니다.
따라서 학술 문헌에 적합한 번역 도구라면 반드시 **‘PDF 레이아웃 구조화 분석 + LaTeX 수식 원형 보존 + 원문·번역문 나란히(Side-by-side) 대조’**라는 핵심 역량을 갖추어야 합니다.
2. 주요 학술 논문 번역 방식 비교 분석
연구 현장에서 흔히 쓰이는 논문 번역 방식은 크게 세 가지로 나뉘며, 각각의 장단점과 적용 범위가 뚜렷합니다:
수식의 정확도와 정돈된 레이아웃을 유지하면서도 별도의 설정 없이 바로 사용하고 싶은 환경을 위해, Equalang 팀이 개발한 Equalang을 활용한 구체적인 처리 과정을 소개해 드립니다.
3. 원문과 번역문을 나란히 대조하는 2단 문헌 정독 워크플로우 3단계
논문을 매끄럽게 읽으려면 원본과 생성된 번역본을 좌우로 나란히 대조하여 몰입감 있게 정독할 수 있습니다.
1단계: 전체 문서 분석 및 수식 최적화 실행
Equalang 웹 플랫폼의 문서 번역 페이지에서 arXiv에서 다운로드한 원본 PDF 파일을 업로드합니다. 수학 수식이 밀집된 컴퓨터 과학, 수학, 물리학 등의 논문은 파싱 단계에서 인라인 기호와 독립 방정식을 집중적으로 보호하도록 처리됩니다.
페이지 하단에서 끊겨 다음 페이지로 이어지는 장문은 문단 논리 단계에서 먼저 자연스럽게 결합된 후 전체 문맥에 맞추어 번역되므로, 페이지 전환으로 인한 문맥 단절을 방지합니다.
2단계: 복잡한 수식과 기호 구조의 보존 상태 확인
번역이 완료되면 원본 논문의 2단 너비, 섹션 제목 계층, 도표 원본 및 캡션 위치가 그대로 보존된 번역 문서가 생성됩니다.
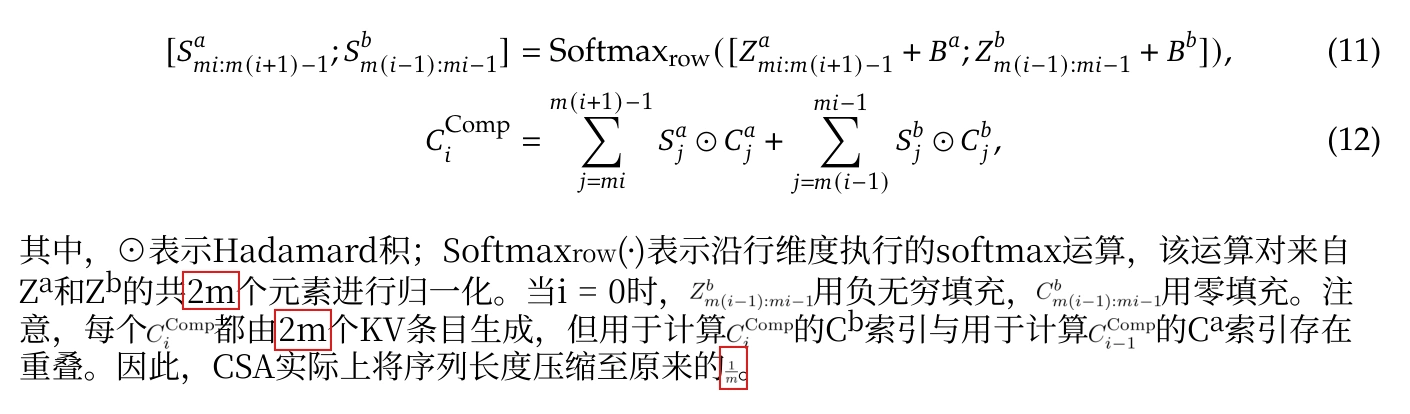
DeepSeek-V4 논문처럼 엄밀한 수식 유도를 다룰 때, 위 그림은 수식과 번역문 조판 효과를 보여줍니다:
- 인라인 기호 텍스트 미변환: 2m, Z^a 등의 인라인 기호가 텍스트로 번역되지 않았으나, 일부 인라인 수식의 글자 크기가 눈에 띄게 작아졌습니다.
- 독립 방정식 및 번호 정렬: CSA 수식 (11)(12)가 가운데 정렬되고 우측 수식 참조 번호도 명확하게 유지되어 논문의 논리적 흐름과 수식 유도가 끊김 없이 이어집니다.
3단계: 원본과 번역본 두 창을 나란히 대조
영문 원본과 다운로드한 중문 번역본을 macOS ‘미리보기(Preview)’, Acrobat, PDF Expert 또는 Edge 브라우저에서 각각 열고, 두 창을 좌우로 나란히 배치합니다:
- 화면 좌측 창에 영문 원본을 엽니다.
- 화면 우측 창에 해당하는 중문 번역본을 열고 동일한 페이지로 이동합니다.
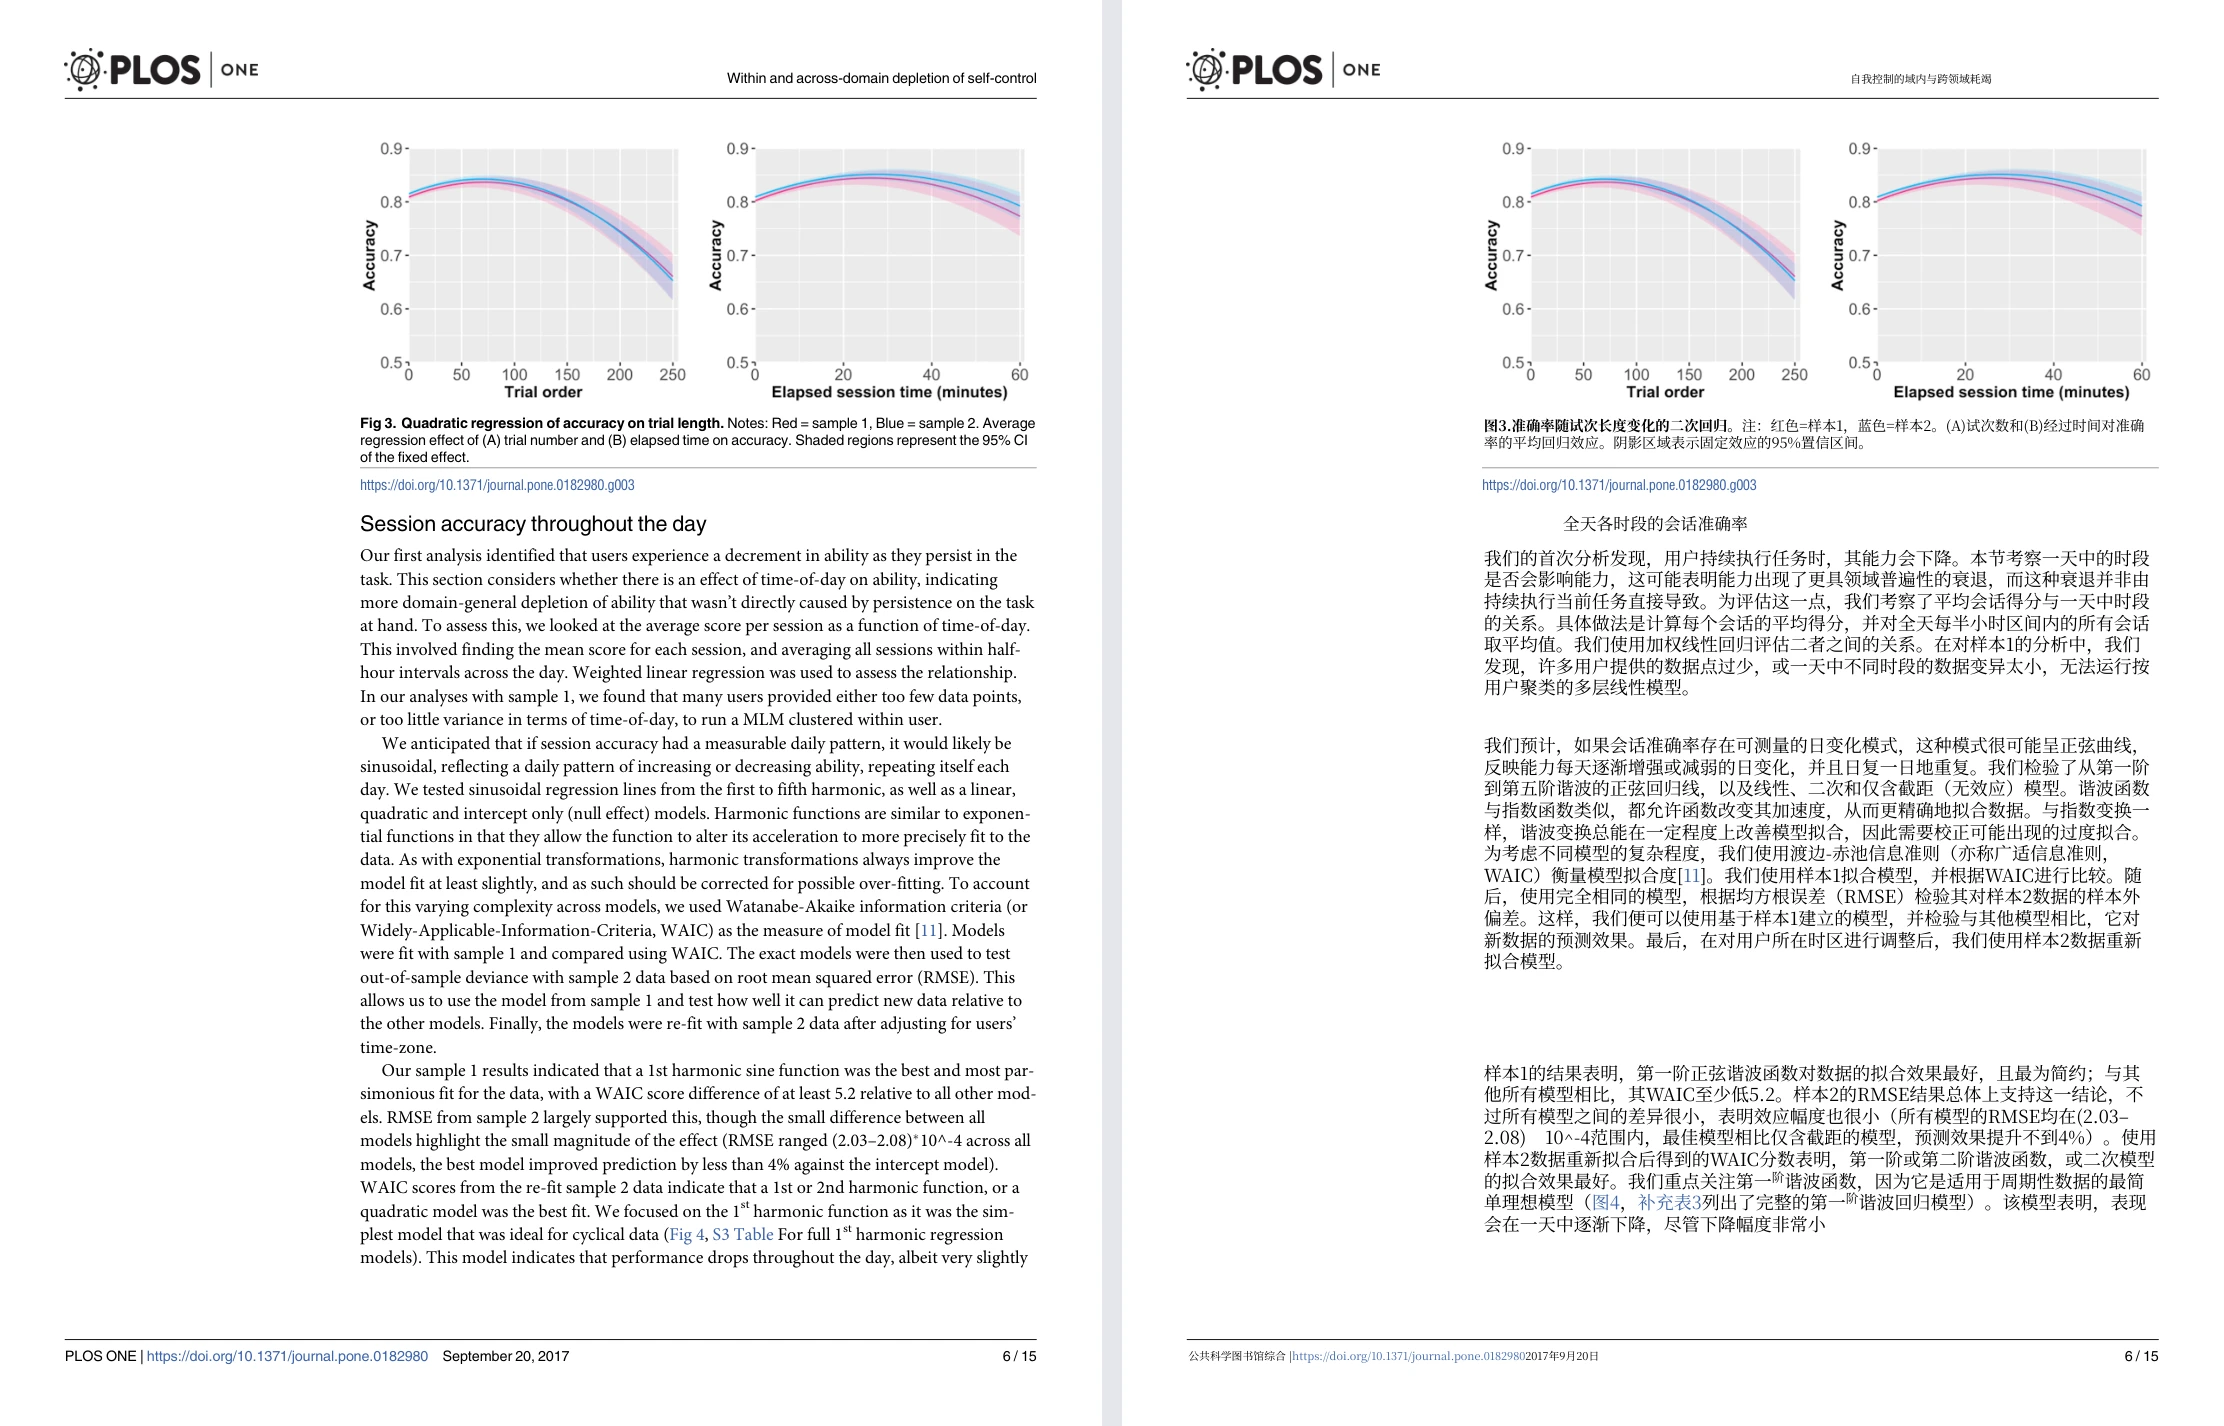
뷰어 설정을 마치면 화면 좌측에는 제 $N$ 페이지 영문 원본이, 우측에는 이에 1:1로 대응하는 제 $N$ 페이지 중문 번역문이 나란히 펼쳐집니다.
이렇게 구성하면 논문 정독 시 다음과 같은 효과를 얻을 수 있습니다:
- 서술된 전개와 실험 배경을 파악할 때는 우측 중문을 확인하며 저자의 연구 동기, 핵심 논점, 방법론을 빠르게 이해합니다.
- 핵심 정의, 특정 학술 약어, 수식이나 인용 출처를 검증할 때는 자연스럽게 시선을 좌측 원본으로 옮겨 가장 원초적인 표현과 대조합니다.
4. 학술 문헌 이중 언어 정독 시 유의할 점
도구를 활용해 학술 논문을 읽을 때 다음 몇 가지 원칙을 지키면 속도와 정확성을 모두 챙길 수 있습니다:
- 중요한 결론과 정리는 원문 정의 재확인: 기계 번역은 비영어권 연구자의 초기 이해 장벽을 크게 낮춰주지만, 논문 인용(Citation), 엄밀한 정리 증명, 코드 구현 단계에서는 반드시 원문의 엄격한 정의를 기준으로 삼아야 합니다.
- 스캔본과 벡터 PDF의 차이 인지: 오래된 스캔 문서의 경우 고품질 OCR 처리가 되어 있지 않다면 레이아웃 복원율이 다소 떨어질 수 있습니다. 가급적 arXiv나 IEEE, ACM 등에서 제공하는 공식 벡터 원본 PDF를 활용하는 것을 권장합니다.
- 복잡한 의사코드(Pseudocode)는 원문 명칭 유지: 알고리즘 단계의 함수명, 변수명, 프레임워크 라이브러리 명칭(예: PyTorch, TensorFlow 함수 등)은 원문 그대로 유지해야 실제 구현 단계에서 혼선을 줄일 수 있습니다.
Sources & Attribution
- Equalang 문서 번역 바로가기
- arXiv.org 공개 학술 프리프린트 저장소
- Keshav, S. (2007). How to Read a Paper. ACM SIGCOMM Computer Communication Review, 37(3), 83-84.
- Vaswani, A., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems (NeurIPS 2017), arXiv:1706.03762.
- PDFMathTranslate 오픈소스 학술 논문 번역 프로젝트 저장소