번역은 기호 바꾸기가 아니라 이해입니다: 한눈에 보는 기계 번역 70년 진화사
 Equalang
핵심 요약
사전 찾기와 단어 빈도 세기부터 단어 벡터, Transformer, 대규모 언어 모델까지, 기계 번역 70년의 네 단계를 짚어 보며 AI가 인간의 언어를 한 겹씩 이해해 온 과정을 알아봅니다.
키워드: 기계 번역; Transformer; 대규모 언어 모델; 인공 신경망; 어텐션 메커니즘; 동시통역
1초 만에 어순을 뒤집는 마법, 인류는 70년 넘게 매달렸습니다
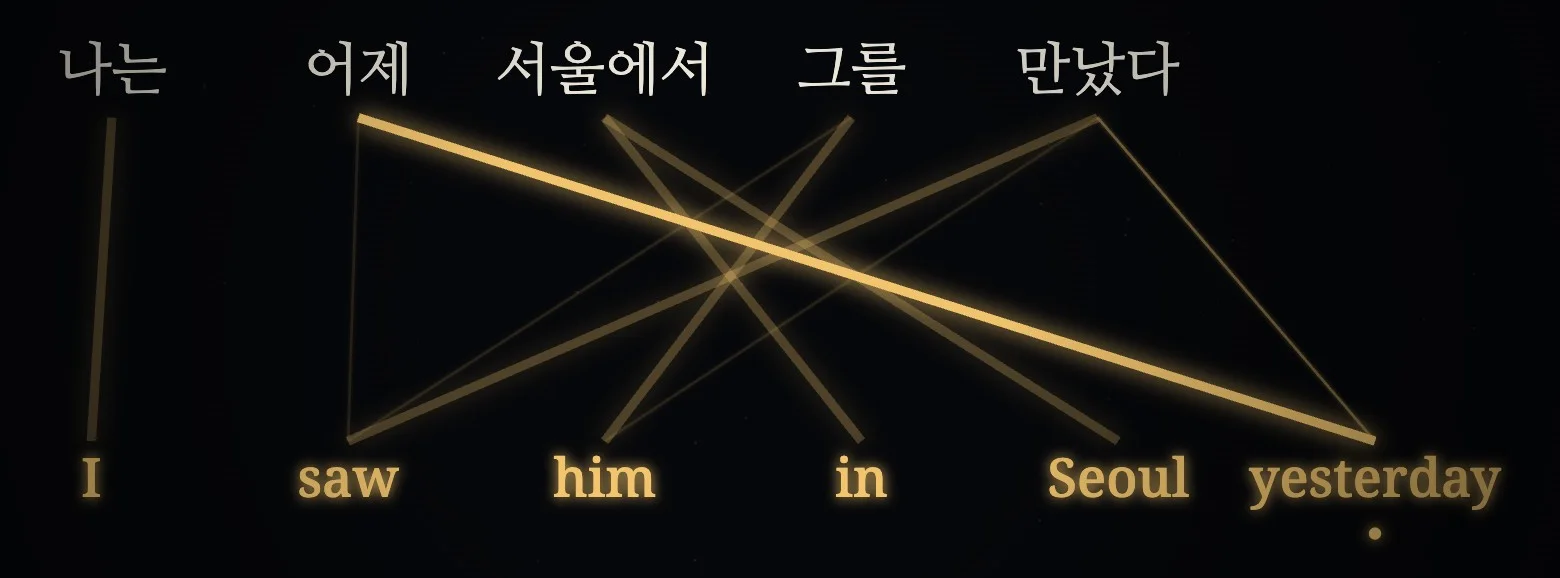
번역기 입력창에 한국어 한 문장을 쳐 넣습니다. "나는 어제 서울에서 그를 만났다."
1초도 안 돼서 화면에 영어 번역문이 뜹니다. "I saw him in Seoul yesterday."
두 문장을 나란히 놓고 자세히 비교해 보면, 너무 당연해서 평소엔 의식하지 못했던 놀라운 사실을 발견하게 됩니다. 기계는 한국어 단어를 그 자리 그대로 영어 단어로 하나씩 바꿔 놓은 게 아닙니다. 원문 앞쪽에 있던 '어제'(yesterday)와 '서울에서'(in Seoul)는 영어 문장 맨 뒤로 밀려났고, 원문 맨 끝에 있던 서술어와 목적어 '그를 만났다'(saw him)는 오히려 앞쪽으로 당겨졌습니다. 두 문장에서 뜻이 통하는 단어끼리 선으로 이어 보면, 선들이 허공에서 복잡하게 교차하며 그물망을 이룹니다.
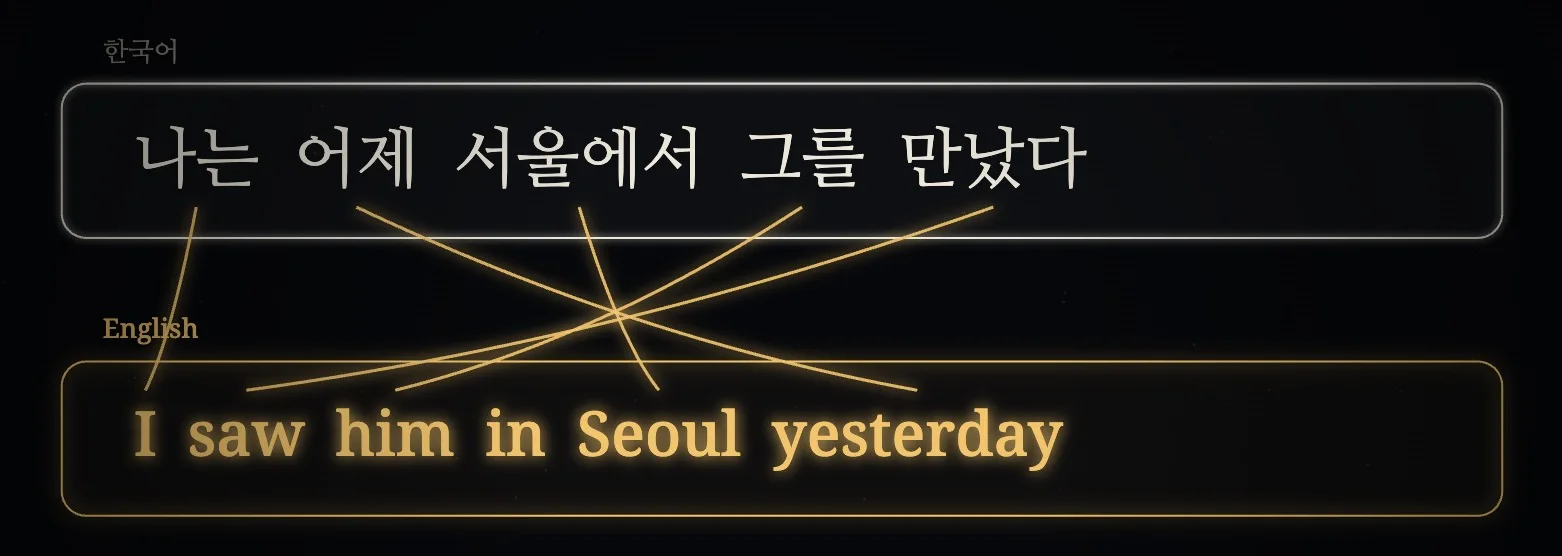
엔터 키를 누른 뒤 흐르는 이 짧은 1초 뒤에는, 인류가 70년 넘게 씨름해 온 난제가 숨어 있습니다. 숫자밖에 모르는 기계에 어떻게 한 언어를 다른 언어로 바꾸는 법을 가르칠 수 있을까요?
지난 70여 년간 이어진 도전을 돌아보면, 기계 번역의 역사는 단순히 사전 두께를 늘려 온 과정이 아니었습니다. 처음에는 뻣뻣하게 기호만 맞바꾸던 수준에서 출발해, 단어의 **뜻(단어 의미)**을 파악하고, 문장 전체를 읽어 낸 뒤, 마침내 글 전체의 앞뒤 맥락까지 읽어 내며 언어를 한 겹씩 더 깊이 이해해 온 계단이었습니다.
이 글은 9분짜리 애니메이션 영상으로도 볼 수 있습니다: https://www.youtube.com/watch?v=8RtBfmcaC8w
첫걸음: 외국어를 암호 해독하듯 풀려던 시도는 왜 벽에 부딪혔을까요?
이야기는 1947년으로 거슬러 올라갑니다. 그해 3월 4일, 미국의 수학자 워런 위버(Warren Weaver)는 친구 노버트 위너에게 편지 한 통을 보냈습니다. 편지에서 그는 흥미로운 직관을 털어놓았습니다. 러시아어로 된 글을 볼 때마다 이런 생각이 든다는 것이었죠. "이건 사실 영어인데, 누군가 이상한 기호로 암호화해 놓았을 뿐이다."
위버에게 번역이란 본질적으로 일종의 암호 해독 문제였습니다. 두 언어 사이에 기호가 어떻게 대응하는지 규칙만 찾아내 암호를 풀면, 그 아래 숨어 있는 영어가 자연스럽게 드러날 거라고 본 것입니다. 1949년 7월, 그는 이 아이디어를 정리해 동료 학자들에게 메모로 돌렸는데, 제목은 딱 한 단어였습니다. 《Translation》(번역).
이 발상은 곧바로 실제 컴퓨터 위에서 실험대에 올랐습니다. 1954년 1월 7일, IBM과 조지타운 대학교가 손을 잡고 인류 역사상 최초의 공개 기계 번역 시연을 펼쳤습니다. 러시아어를 전혀 모르는 직원이 기계 앞에 앉아 러시아어 60여 문장을 천공카드로 입력하자, 컴퓨터가 요란한 소리를 내며 그 문장들을 모두 영어로 자동 번역해 냈습니다.
당시 이 컴퓨터는 어떻게 번역을 해냈을까요? 원리는 설명서가 딸린 사전을 찾는 것과 비슷했습니다.
- 번호 찾기: 먼저 입력된 러시아어 단어를 하나씩 천공카드 사전에서 찾아 고유한 숫자 번호와 후보 영어 단어들로 바꿉니다.
- 규칙 적용하기: 그다음 주변에 어떤 단어가 있는지를 살피고, 사람이 미리 적어 둔 문법 규칙에 따라 세 가지 작업을 수행합니다. 여러 후보 중 알맞은 영어 단어를 고르는 단어 선택, 뒤집힌 순서를 바로잡는 어순 조정, 그리고 영어에서는 필요 없는 단어를 빼 버리는 단어 삭제입니다.
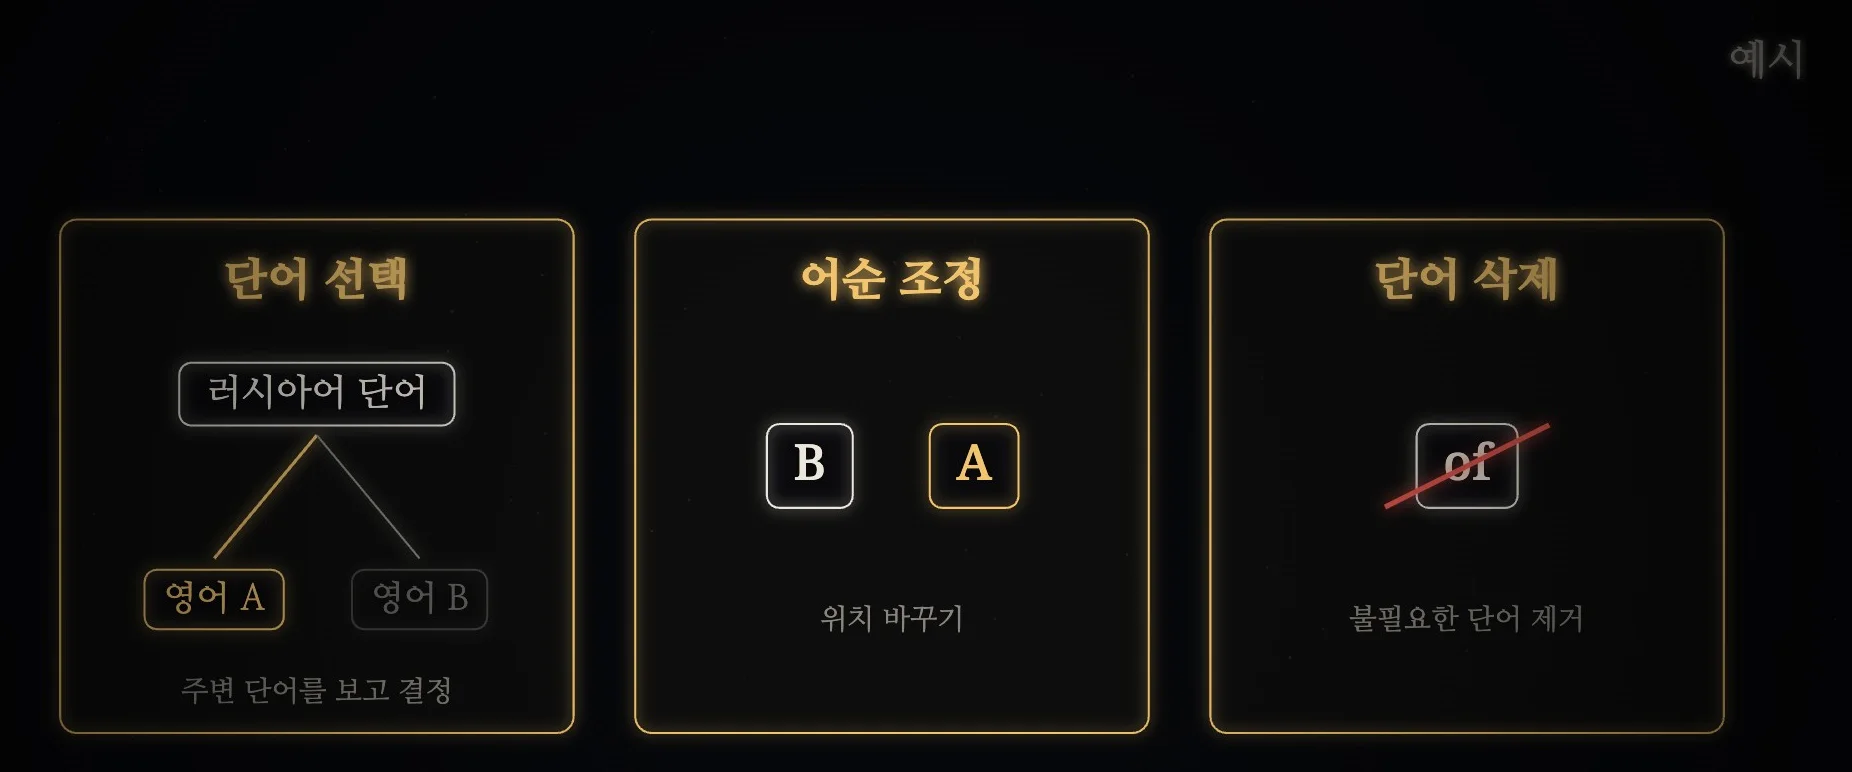
이 시연은 세상을 떠들썩하게 만들었습니다. 당시 연구자들은 무척 낙관적이었고, 이 길로 계속 나아가기만 하면 3년에서 5년 안에 기계 번역 문제가 완전히 해결될 거라고 믿었습니다.
하지만 현장의 관객들이 모르는 사실이 있었습니다. 그 컴퓨터에 들어 있던 사전은 어근과 어미를 다 합쳐도 고작 250개 항목밖에 안 될 정도로 턱없이 작았고, 문법 규칙도 단 6개뿐이었다는 점입니다. 심지어 무대 위에서 시연한 러시아어 60여 문장조차 그 규칙에 맞게 미리 신중하게 골라 둔 것이었습니다.
연구실을 벗어나 현실 세계의 다채로운 글을 마주하자, 3년이 지나고, 5년이 지나고, 10년이 흘러도 기대했던 돌파구는 나타나지 않았습니다. 1966년, 미국 정부가 꾸린 자동언어처리자문위원회(ALPAC)는 냉정한 결론이 담긴 조사 보고서를 내놓았습니다. 지난 10년간의 연구가 당초 기대에 미치지 못했다는 평가였습니다. 직후 연구 예산은 대폭 삭감되었고, 기계 번역은 길고 추운 겨울을 맞이하게 됩니다.
예산이 크게 줄어든 가운데서도 연구를 포기하지 않은 학자들은 1954년의 방식을 한층 더 정교하게 다듬어 나갔습니다. 사전에 단어를 하나하나 보태고 문법 규칙을 한 줄씩 적어 가며 사람이 직접 기계에 언어를 가르치는 방식, 바로 규칙 기반 기계 번역입니다.
이 방식은 특정한 영역에서 실제로 제 몫을 해내기도 했습니다. 예를 들어 캐나다의 METEO 시스템은 1981년부터 일기예보를 영어와 프랑스어로 번역하는 데 쓰였습니다. 이것이 가능했던 이유는 일기예보가 제한된 언어이기 때문입니다. 날마다 쓰이는 표현이 거기서 거기라 어휘와 문장 구조가 정해진 틀을 벗어나지 않았던 덕분이죠.
그러나 일상 대화로 나오면 규칙은 금세 힘을 잃었습니다. 일상 언어는 그렇게 반듯하지 않으며, 무엇보다 골치 아픈 다의어(한 단어가 여러 뜻을 가지는 현상)가 도사리고 있기 때문입니다.
예를 들어 일상에서 흔히 쓰는 동사 '타다'를 생각해 봅시다. 만약 사전에서 단어마다 뜻을 하나씩만 딱 정해 두고, 예컨대 '타다'를 무조건 탈것을 탄다는 뜻의 ride로만 묶어 둔다면, 「나는 커피를 탄다」를 단어별로 직역했을 때 "I coffee ride."처럼 웃음거리가 되는 엉터리 문장이 나오고 맙니다(예시). 실제 언어에서는 똑같은 단어라도 앞에 어떤 말이 짝을 이루느냐에 따라 영어 표현이 완전히 달라져야 합니다.
- 택시를 타다: take a taxi
- 커피를 타다: make coffee
- 스키를 타다: ski
- 햇볕에 타다: get sunburned 등
단어 하나만 놓고 봐도 이렇게 쓰임새가 다양하니, 이를 제대로 번역하려면 짝을 이루는 표현마다 일일이 판별 규칙을 적어 주어야 합니다. 새로운 표현이 나올 때마다 규칙을 추가해야 하니 규칙도 끝이 없고, 언어 속의 예외는 더더욱 끝이 없었습니다. 사람이 기계에 문법 규칙을 하나씩 적어 가르치는 건 카드로 높은 탑을 쌓는 일과 같아서, 예외라는 카드가 쌓이고 쌓이다 보면 결국 탑 전체가 무너져 내릴 수밖에 없었습니다.
문법 대신 요리책을 보고 숫자를 세다: 통계 번역은 어떻게 똑똑해졌을까요?
규칙을 끝까지 다 적는 게 불가능하다면, 발상을 바꿔 볼 수는 없을까요?
1984년, 일본의 학자 나가오 마코토(長尾真)는 예제 기반 기계 번역을 제안했습니다. 기계에 딱딱한 문법 규칙을 억지로 외우게 하는 대신, 이미 번역된 기존 예문을 보고 따라 하게 하자는 아이디어였습니다.
이는 요리책을 보고 응용하는 것과 비슷합니다. 손에 이미 기존 레시피가 하나 있다고 해 봅시다. 예컨대 "나는 어제 서울에서 그를 만났다"를 "I saw him in Seoul yesterday"로 번역한다는 걸 알고 있는 상태에서, "나는 어제 부산에서 그녀를 만났다"라는 새 문장이 들어왔습니다. 그러면 기계는 저장된 예문 창고에서 가장 비슷한 기존 문장을 찾아낸 뒤, 달라진 부분이 '서울→부산', '그→그녀' 두 곳뿐이라는 걸 비교해 내고, 기존 번역문을 그대로 베끼되 바뀐 재료에 해당하는 두 단어만 살짝 갈아 끼워 새로운 번역문을 만들어 냅니다(예시).
1990년 무렵이 되자 IBM 왓슨 연구소의 연구자들은 한 걸음 더 과감하게 나아갔습니다. 문법이고 규칙이고 아예 가르치지 않고, 사람이 번역해 둔 방대한 양의 두 언어 문장 쌍만 기계에 던져 준 뒤, 어떤 두 단어가 늘 짝지어 나오는지를 기계 스스로 세어 보게 한 것입니다.
한국어와 영어로 짝지어진 수많은 문장 카드가 기계 속으로 쏟아져 들어간다고 상상해 보세요. 기계는 한글도 모르고 영어 단어도 모르지만, 셈은 할 줄 압니다. 한국어 문장에 '사과'가 나올 때마다 짝이 되는 영어 문장에도 apple이 등장한다면, 기계는 이 두 단어 사이에 놓인 카운터 숫자를 하나씩 올립니다.
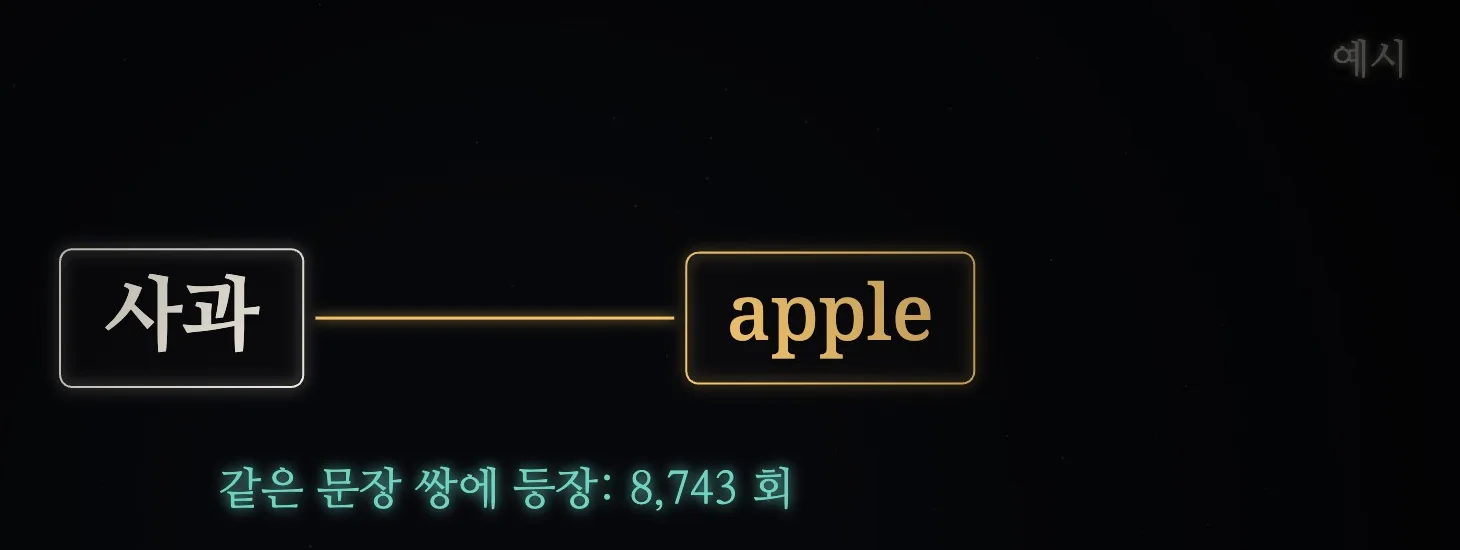
한 쌍, 열 쌍, 수천수만 쌍의 문장을 세어 나가다 보면 '사과'와 apple이 나란히 등장하는 횟수가 점점 쌓이고, 기계가 계산한 확률도 덩달아 높아집니다. 함께 나오는 횟수가 많을수록 기계는 이 두 기호가 같은 뜻을 가리킨다고 확신하게 되죠. 마치 apple이라는 외국어 단어를 전혀 모르는 사람이라도 과일 가게에 갈 때마다 빨간 과일 옆에 늘 그 이름표가 붙어 있는 걸 보면 결국 뜻을 알게 되는 것과 같습니다.
이것이 바로 통계 기반 기계 번역(통계적 기계 번역)입니다. 이 순간부터 번역은 '규칙 찾기'에서 '확률 계산'으로 탈바꿈했습니다.
하지만 한영 단어 쌍만 세어서는 온전한 문장을 만들어 내기 어렵습니다. 예를 들어 한국어의 '그'는 영어로 옮길 때 주격인 he가 될 수도 있고 목적격인 him이 될 수도 있습니다. 둘 중 무엇을 골라야 할까요? '그'라는 단어 하나의 단어 쌍 확률만 봐서는 기계가 답을 내릴 수 없습니다.
그래서 연구자들은 기계에 또 하나의 무기를 쥐여 주었습니다. 영어 문장들 속에서 어떤 단어 뒤에 어떤 단어가 자주 이어서 나오는지를 세어 보게 한 것입니다. 예를 들어 앞부분이 이미 "I saw _"까지 번역되었다면, 기계는 그동안 세어 둔 영어 장부를 뒤져 보고 saw 뒤에는 he보다 him이 이어진 횟수가 훨씬 많고 점수도 높다는 걸 확인합니다(예시). 이렇게 앞 단어들을 보고 다음에 올 단어를 맞히는 모델을 언어 모델이라고 부릅니다.
이 두 가지를 합치면 통계 기반 기계 번역의 작업 공정이 완성됩니다.
- 번역 모델(단어 쌍 찾기): 원문을 작은 구절 단위로 쪼개 확률 표에서 찾으며 가능한 영어 후보들을 추려 냅니다(예컨대 '그'에 대해 he와 him 두 후보를 꺼내 놓습니다).
- 언어 모델(자연스러운 이어짐 고르기): 앞 단어들과 어울리는 습관을 보고 후보 중에서 가장 자연스럽게 이어지는 단어를 고른 뒤(앞이 saw이므로 him을 남기고 he는 지움), 하나로 이어 붙여 완성된 문장을 만듭니다(예시).
2006년 출시된 구글 번역이 바로 이 통계 기반 기계 번역 방식을 사용했습니다.
하지만 통계 기반 기계 번역 역시 초기의 규칙 기반 번역과 마찬가지로 여전히 **'기호'**라는 1단계에 갇혀 있었습니다. 기계의 눈에 각 단어는 그저 고립된 번호에 불과했기 때문입니다. 예를 들어 '고양이'는 #4127번, '개'는 #9853번일 뿐(번호는 예시), 두 번호 사이에는 아무런 연결 고리가 없었습니다. 기계는 '고양이'와 '개'의 뜻이 얼마나 가까운지 전혀 알 수 없었고, '고양이'라는 단어에서 배운 번역 노하우를 비슷한 단어인 '개'에 조금도 응용할 수 없었습니다. 훈련 데이터에 별로 나온 적 없는 낯선 단어 조합을 만나면 통계 횟수가 부족해 속수무책으로 막히곤 했죠.
한 걸음 더 나아가려면, 기계는 단어를 차가운 번호로만 세는 데서 벗어나 단어의 **뜻(의미)**을 이해해야만 했습니다.
단어 벡터부터 어텐션 메커니즘까지: 기계는 어떻게 문장 전체를 읽게 되었을까요?
전환점은 2013년에 찾아왔습니다. 이 해에 등장한 word2vec은 일찍이 제안되었던 단어 벡터 기술을 본격적으로 유행시켰습니다(단어 벡터라는 발상 자체는 이미 2000년에 벤지오(Bengio) 등의 연구자들이 제시한 바 있습니다).
단어 벡터는 아주 기발한 일을 해냈습니다. 단어마다 고립된 번호표를 하나씩 나눠 주는 대신, 각 단어를 수백 개의 숫자가 늘어선 긴 숫자 배열로 나타낸 것입니다.
이 수백 개의 숫자는 단어마다 꼼꼼하게 매긴 '특징 점수표'라고 생각하면 이해하기 쉽습니다. 첫째 칸은 '동물인가?', 둘째 칸은 '먹을 수 있나?', 셋째 칸은 '도시인가?'처럼 항목마다 점수를 매기는 셈이죠(참고: 실제 각 차원에는 사람이 바로 읽을 수 있는 독립된 의미가 적혀 있는 것이 아니라, AI가 스스로 요약해 낸 추상적인 특징이 담깁니다).
그렇다면 이 숫자들은 어떻게 얻을까요? 사람이 직접 적어 넣는 게 아니라, 기계에 수많은 빈칸 채우기 문제를 풀게 해서 얻습니다. 예를 들어 "나는 귀엽고 작은 _를 키운다" 같은 문장에서 단어 하나를 가려 놓고 빈칸에 무슨 단어가 들어갈지 맞히게 하는 식입니다(예시). 수천수만 문장 속에서 '고양이'와 '개'는 늘 비슷한 빈칸에 자주 들어가기 때문에, 기계가 단어를 맞히려고 숫자를 반복해서 조정하다 보면 '고양이'와 '개'를 나타내는 수백 개의 숫자 배열도 점점 비슷하게 맞춰집니다.
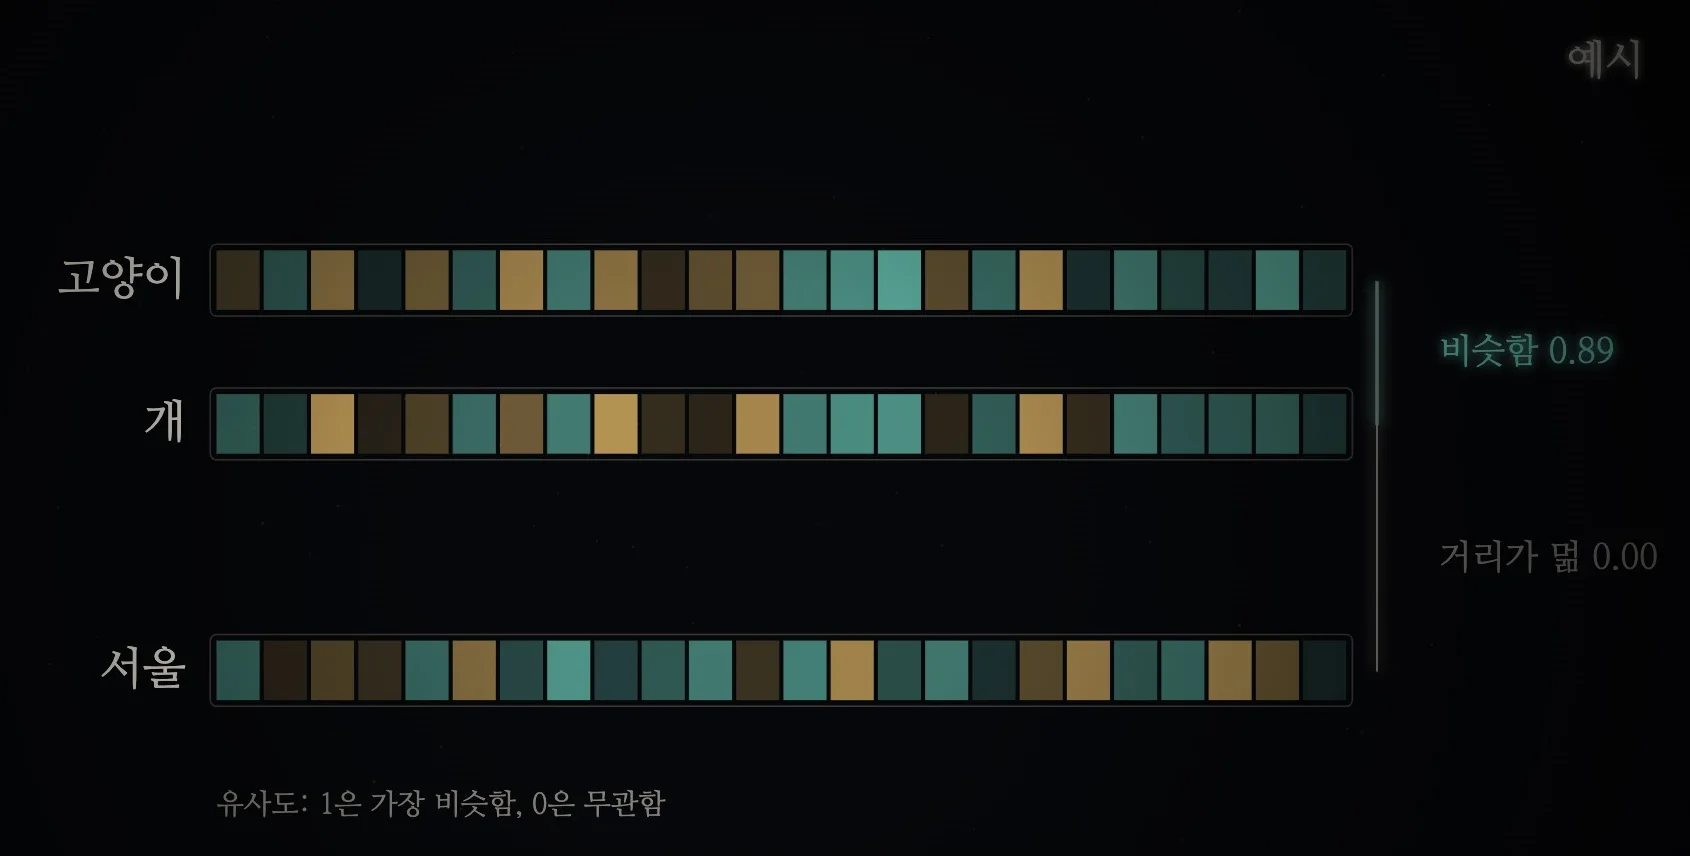
그 결과는 무척 놀라웠습니다. 뜻이 가까운 단어일수록 숫자 배열도 비슷해지고, '고양이'와 '서울'처럼 전혀 상관없는 단어는 숫자도 크게 달라졌습니다. 비슷한 단어는 숫자도 비슷하니 기계는 마침내 '고양이'에서 배운 규칙을 '개'에도 자연스럽게 응용할 수 있게 되었습니다. 무엇보다 단어가 연속적인 숫자로 바뀌면서, 기계는 마침내 이 숫자들을 가지고 문장 전체의 뜻을 계산할 수 있게 되었습니다.
이 흐름을 타고 2014년, 인공 신경망 기반 기계 번역(줄여서 신경망 기계 번역)이 등장했습니다. 신경망 기계 번역은 문장을 조각내어 표에서 찾는 대신, 실제 통역사처럼 일합니다.
- 먼저 끝까지 읽기(인코더): 한국어 원문 전체를 처음부터 끝까지 읽고, 문장 전체의 뜻을 숫자 형태의 '기억' 하나로 압축합니다.
- 한 단어씩 말하기(디코더): 이 기억을 넘겨받아 영어 번역문을 한 단어씩 차례로 말합니다. 단어를 하나 내뱉을 때마다 방금 말한 단어를 다시 기억에 합쳐 다음 칸으로 넘기며 다음에 무슨 단어를 말할지 이어서 생각하죠.
당시 이 기억을 쌓고 번역문을 말하는 역할을 맡은 구조가 바로 순환 신경망(예: 장단기 메모리 네트워크 LSTM)이었습니다. 순환 신경망은 보안 검색대를 한 줄로 통과하듯 단어를 차례로 하나씩 읽으며, 새 단어를 읽을 때마다 이전 단계까지 쌓인 기억에 녹여 넣어 새로운 기억으로 업데이트한 뒤 다음 단계로 넘깁니다.
하지만 이 방식은 곧 한계에 부딪혔습니다. 기억 상자의 크기가 정해져 있다는 점이 문제였습니다. 다섯 단어짜리 짧은 문장이든 수십 단어짜리 긴 문장이든 똑같은 크기의 기억 상자 하나에 억지로 구겨 넣어야 했던 것입니다. 문장이 길어지면 마치 긴 전화번호를 한 번에 외울 때처럼, 뒷부분을 외우느라 맨 앞에 나왔던 말은 점점 흐려지다가 결국 잊어버리고 맙니다.
긴 문장에서 앞부분을 잊어버리는 문제를 어떻게 해결했을까요? 같은 해 연구자들은 어텐션 메커니즘(Attention)을 내놓았습니다.
어텐션 메커니즘의 원리는 수험생이 독해 문제를 푸는 모습과 비슷합니다. 기계가 영어 번역문의 단어를 하나씩 쓸 때마다 고정된 크기의 기억 상자만 붙들고 있는 것이 아니라, 원문의 해당 부분을 다시 돌아볼 수 있게 해 준 것입니다. 지금 쓰는 단어와 가장 관련이 깊은 원문 위치에 시선을 집중하는 방식이죠. 예를 들어 "I saw him in Seoul yesterday"를 써 내려갈 때, saw를 쓸 때는 한국어 원문의 '만났다'를 중점적으로 쳐다보고, 맨 끝에 yesterday를 쓸 때는 원문 앞머리에 있던 '어제'로 시선을 되돌려 확인합니다. 신경망 기계 번역이 가장 잘하는 특기 중 하나가 바로 이렇게 멀리 떨어진 단어들의 어순을 자연스럽게 뒤바꾸는 일(특히 동사의 위치 이동)입니다.
2015년 바이두가 '순환 신경망 + 어텐션 메커니즘'을 결합한 대규모 신경망 기계 번역 시스템을 가장 먼저 출시했고, 이듬해인 2016년에는 구글 번역도 이 구조로 전면 교체했습니다. 구글의 2016년 실측 보고서에 따르면, 앞서 10년간 사용했던 구절 기반 통계 번역 시스템과 비교해 신경망 기계 번역은 번역 오류를 평균 약 60%나 줄였습니다.
그럼에도 순환 신경망에는 태생적인 단점이 하나 남아 있었습니다. 단어를 한 줄로 세워 차례로 읽어야 한다는 점이었습니다. 매 단계의 기억은 앞 단계의 계산이 끝나야만 넘겨받을 수 있기 때문에, 앞 단어를 다 처리하기 전까지는 뒷단어들이 마냥 줄 서서 기다려야 했습니다. 심지어 학습할 때 원문과 번역문 전체를 기계 앞에 한꺼번에 펼쳐 놓아도 한눈에 동시에 계산하지 못하고 귓속말을 옆 사람에게 차례로 전하듯 느리게 훈련해야만 했습니다.
줄 서기를 버리고 확성기를 들다: Transformer와 대규모 언어 모델은 어떻게 맥락을 꿰뚫었을까요?
2017년, 구글의 연구자 8명이 기계 번역 실험을 다룬 논문 한 편을 발표했습니다. 제목은 《Attention Is All You Need》였습니다. 논문 제목이 전하는 메시지는 아주 명쾌했습니다. 순환 신경망을 버리고, 어텐션만 쓰면 충분하다는 것입니다.
번역 연구에서 출발한 이 논문이 제안한 새로운 구조가 바로 그 유명한 Transformer입니다. Transformer는 기계 번역의 판도를 바꾸었을 뿐 아니라, 이후 등장한 BERT(2018년), GPT 시리즈(2018년~), 그리고 ChatGPT(2022년 말) 등 오늘날 대부분의 현대 대규모 언어 모델을 떠받치는 공통의 밑바탕이 되었습니다. 과학 학술지 《네이처》(Nature)의 2025년 집계에 따르면, 이 논문은 21세기에 가장 많이 인용된 과학 논문 상위 10편 가운데 하나로 이름을 올렸습니다.
Transformer와 순환 신경망은 대체 무엇이 다를까요? 말을 전달하는 모습에 비유하면 쉽게 이해할 수 있습니다.
- 순환 신경망은 귓속말 전하기 같습니다: 사람들이 한 줄로 서서 첫 번째 단어가 두 번째 단어에게, 두 번째 단어가 다시 세 번째 단어에게 귓속말을 옆으로만 전달합니다. 멀리 갈수록 내용이 흐려지기 쉬울 뿐 아니라, 뒤쪽에 서 있는 단어들은 자기 차례가 올 때까지 그 자리에서 마냥 기다려야 합니다.
- Transformer는 모두 확성기를 들고 외치는 것 같습니다: 줄에 서 있는 모든 단어가 동시에 확성기를 들고 외치기 때문에, 문장 속 모든 단어가 다른 모든 단어의 목소리를 직접 들을 수 있습니다. 거리가 멀든 가깝든 똑같이 또렷하게 들리죠.
모두가 동시에 외치면 아수라장이 되지 않을까요? 그렇지 않습니다. 단어마다 골라서 귀를 기울이기 때문입니다. 문장 안에서 자기와 가장 관련이 깊은 단어가 누구인지 살펴 그 단어의 말에 더 귀를 기울이고, 이를 통해 이 문장 안에서 자신의 정확한 뜻을 정합니다. 이렇게 문장 내부의 단어들이 서로를 살피며 관련도에 따라 정보를 모으는 메커니즘을 셀프 어텐션(Self-Attention)이라고 합니다.
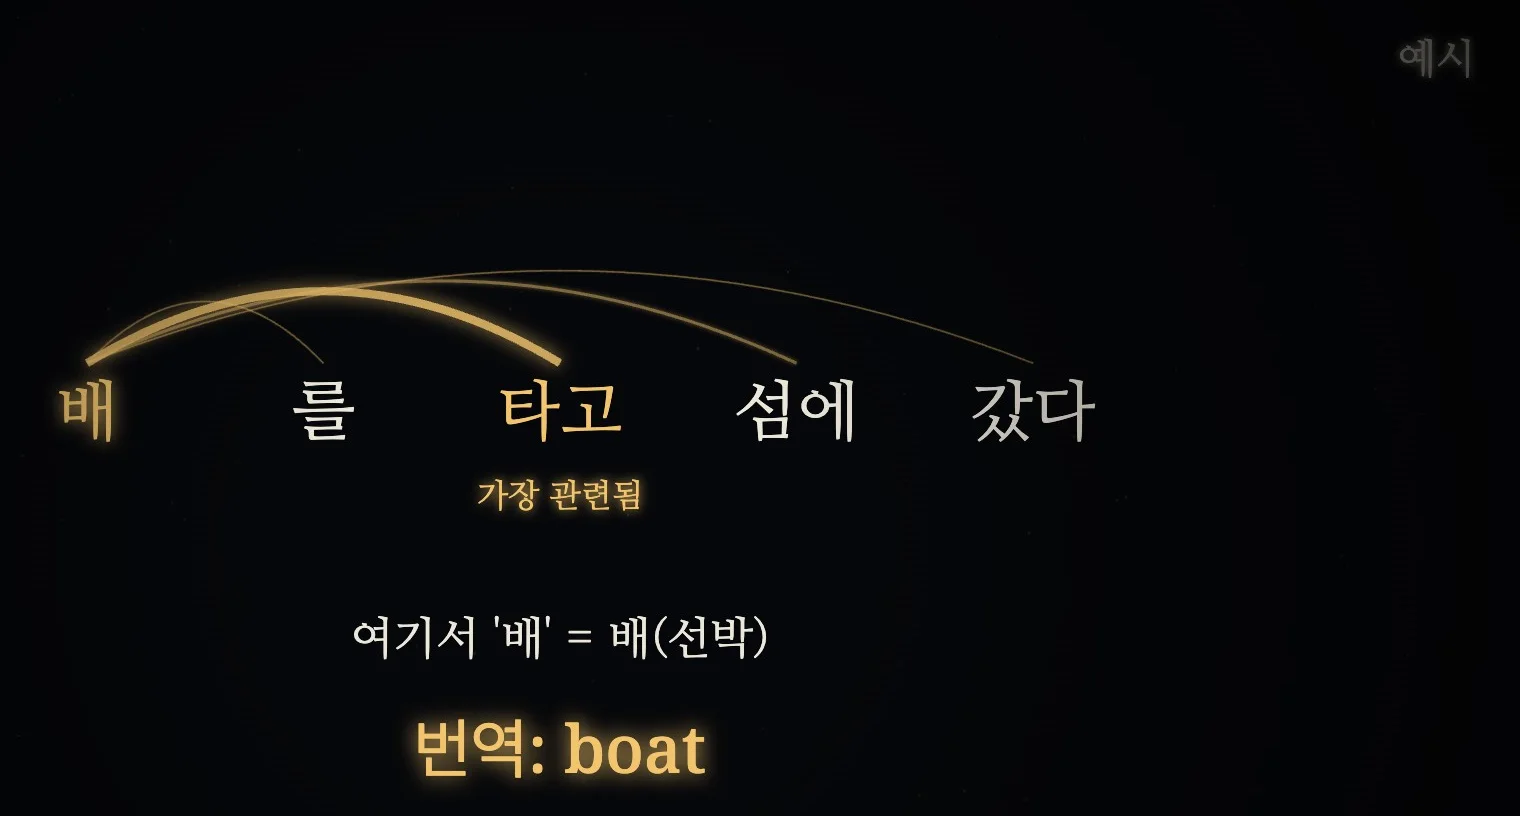
셀프 어텐션이 어떻게 다의어 문제를 해결하는지 살펴봅시다. 똑같은 '배'라는 단어가 서로 다른 두 문장에 들어 있습니다.
- "배를 타고 섬에 갔다"라는 문장에서 '배'는 확성기를 들고 문장 전체를 둘러본 뒤, 바로 뒤에 있는 동사 '타고'가 자기와 가장 관련이 깊다는 걸 발견합니다. '타고'의 정보에 귀를 기울인 '배'는 이 문장에서 자신이 물 위를 달리는 선박을 뜻한다는 걸 곧바로 알아채고, 영어로 번역할 때 boat로 옮깁니다(예시).
- 반면 "배를 깎아 먹었다"라는 문장에서는 '배'가 가장 관련 깊은 동사인 '깎아(깎는다)'에 귀를 기울이고, 여기서 자신은 먹는 과일 배라는 사실을 알아차려 pear로 번역합니다(예시).
문장 전체의 관계를 한눈에 파악하는 능력 외에도, Transformer에는 엄청난 공학적 장점이 하나 더 있습니다. 바로 줄 설 필요가 없다는 점입니다. 모델을 학습시킬 때 한 페이지 분량의 글에 담긴 모든 단어를 동시에 병렬로 계산할 수 있어 학습 속도가 비약적으로 빨라졌습니다. 계산 속도가 확 빨라지자, 사람들은 예전에는 엄두도 못 냈던 방대한 양의 글을 기계에 넣어 훈련시킬 수 있게 되었습니다.
이후 연구자들은 Transformer를 쌓아 올려 대규모 언어 모델(LLM)을 만들었습니다. 대규모 언어 모델은 처음부터 번역 전용으로 만든 기계가 아니라 범용 과제를 해결하기 위해 탄생했으며, 번역은 모델이 해낼 수 있는 수많은 과제 중 하나일 뿐입니다. 그리고 사전 학습 단계에서 이 모델이 밤낮으로 훈련한 기본기는 오직 한 가지, 다음 단어 맞히기였습니다.
어디서 많이 들어본 이야기 같지 않나요? 앞서 통계 기반 기계 번역에 쓰였던 n-gram 언어 모델도 '앞 단어들을 보고 다음 단어를 맞히는' 일을 했습니다. 예를 들어 앞부분이 「어제 서울에서 만난 사람은 _」이라면 빈칸에는 '그'가 올 확률이 가장 높지만, 동사를 먹는다는 말로 바꿔서 「어제 서울에서 먹은 것은 _」처럼 빈칸을 두면 뒤에는 음식 이름이 올 가능성이 커집니다(예시). 수학에서는 이를 조건부 확률이라고 부릅니다. 대화를 이어받듯 앞에 무슨 말을 했는지가 다음에 올 단어를 결정하는 것이죠.
똑같이 다음 단어를 맞히는데, 대규모 언어 모델과 옛 통계 언어 모델 사이에는 어떤 본질적인 차이가 있을까요? 핵심 차이는 두 가지입니다.
- 얼마나 멀리까지 보는가: 옛 통계 언어 모델은 시야가 아주 좁아서 빈칸 바로 앞의 몇 단어밖에 보지 못했습니다. 반면 대규모 언어 모델은 앞 문단 전체를 한눈에 봅니다(예를 들어 GPT-3의 컨텍스트 창은 2,048개의 토큰을 담을 수 있습니다). 예를 들어 「지난주 부산으로 출장을 갔다. 어젯밤 먹은 것은 _」이라는 글이 있다고 해 봅시다. 옛 언어 모델은 고작 「어젯밤 먹은 것은」이라는 몇 단어만 테두리 안에 가두어 볼 뿐, 말하는 사람이 부산에 있다는 사실은 전혀 모릅니다. 하지만 대규모 언어 모델은 문단 전체를 시야에 담아 앞부분에 나온 장소(부산)를 확인하고, 빈칸에 '돼지국밥'이 올 가능성이 높다고 맞힐 수 있습니다(예시).
- 배운 것을 응용할 수 있는가: 옛 언어 모델은 단어 조합이 등장한 횟수만 고지식하게 세었기 때문에, 훈련 데이터에서 '돼지국밥을 먹었다'는 본 적이 있어도 '소머리국밥을 먹었다'를 본 적이 없다면 데이터가 부족해 확률을 제대로 계산하지 못했습니다. 반면 대규모 언어 모델은 단어를 연속적인 숫자로 바꾸는 신경망의 능력을 물려받았기 때문에, 숫자 공간에서 '돼지국밥'과 '소머리국밥'의 숫자 배열이 무척 비슷하다는 걸 알고 '소머리국밥을 먹었다'라는 표현이 드물더라도 배운 것을 응용해 정확하게 계산해 냅니다(예시).
그런데 여기서 한 가지 흥미로운 의문이 생깁니다. 날마다 '앞 문맥에 이어질 다음 단어 맞히기'만 연습하고 번역을 따로 배운 적도 없는 모델이, 어떻게 갑자기 번역을 할 수 있게 된 걸까요?
2023년의 한 연구가 중요한 단서를 찾아냈습니다. 연구자들이 한 대규모 언어 모델(PaLM)의 훈련 데이터를 샅샅이 조사해 보았더니, 인터넷에서 수집한 웹페이지와 문서 속에 이미 최소 44개 언어에 걸친 3,000만 쌍 이상의 대역 번역문이 섞여 있었던 것입니다. 다시 말해 인류는 이미 일상적인 웹페이지 곳곳에 방대한 번역 교재를 끼워 넣어 모델에 먹이고 있었던 셈입니다. 그래서 입력창에 번역 요청과 원문을 적어 주면, 대규모 언어 모델이 그 뒤에 이어질 말로 가장 자연스럽게 맞혀 내놓는 단어들이 바로 영어 번역문이 됩니다(예시).
2020년 출시된 GPT-3가 바로 이렇게 훈련되었습니다. 수천억 단어 분량의 글을 읽은 덕분에 코딩이든 요약이든 번역이든 프롬프트에 맞춰 어떤 글이든 이어 쓸 수 있었죠. GPT-3 뒤에는 과감한 승부수가 있었습니다. 모델이 클수록, 더 많은 글을 읽을수록 성능이 더 좋아질 거라는 믿음이었습니다.
여기서 '크다'는 것은 모델 내부에서 조절할 수 있는 숫자인 파라미터(매개변수)의 개수가 많다는 뜻입니다. 2018년부터 2020년 사이 모델의 파라미터 규모는 폭발적으로 늘어났습니다.
- GPT-1(2018년): 1억 1,700만 개
- GPT-2(2019년): 15억 개 (약 13배 증가)
- GPT-3(2020년): 1,750억 개 (다시 약 117배 증가)
- 2022년 11월에 나온 ChatGPT(초기에는 미세 조정된 GPT-3.5 기반)와 2023년의 GPT-4에 이르러서는 공식 파라미터 수를 공개하지 않았습니다(언론 보도에 따르면 GPT-4는 약 1조 개 규모로 알려졌으나, 확인되지 않음).
이렇게 규모가 급격히 커지는 과정에서 연구자들은 스케일링 법칙(Scaling Law)을 찾아냈습니다. 파라미터 수와 학습 데이터양, 연산량을 비율에 맞춰 늘릴수록 모델의 성능이 멱법칙(power law)을 따라 일정하게 올라간다는 법칙입니다. 로그 눈금 그래프에 그려 보면 자원을 10배씩 더 투입할 때마다 성능이 직선을 따라 일정한 폭만큼 올라가서, 도달할 성능을 미리 계산해 볼 수 있을 정도였습니다.
2022년 11월 30일 ChatGPT가 출시되면서, 번역은 누구나 언제든 요구 사항을 덧붙여 조율할 수 있는 대화가 되었습니다. 예전에는 번역기가 내놓는 번역문을 그대로 받아들일 수밖에 없었지만, 이제는 초안이 마음에 들지 않으면 한마디 덧붙여 말투를 바꿔 다시 번역시킬 수 있습니다. 예를 들어 「내일 회의는 오후 3시로 변경되었습니다」를 영어로 번역해 달라고 하면 처음에는 평범하게 "Tomorrow's meeting is moved to 3 pm."이라고 답하지만, "고객사에게 보낼 거니까 더 격식 있게 바꿔 줘"라고 한마디 덧붙이면 그 자리에서 정중한 비즈니스 어조로 바꿔 "Please note that tomorrow's meeting has been rescheduled to 3:00 p.m."이라고 다시 번역해 줍니다(예시).
더 중요한 변화는 모델이 긴 앞뒤 맥락을 살필 수 있게 되면서 번역이 마침내 글자 그대로의 직역을 넘어섰다는 점입니다. 예를 들어 「그는 떠났다」라는 짧은 문장은 그 자체만 놓고 보면 '자리를 떠났다'(left)는 뜻일 수도 있고, '세상을 떠났다'(passed away)를 완곡하게 돌려 말한 표현일 수도 있습니다. 만약 앞선 대화에서 줄곧 병원과 병세 이야기를 하고 있었다면, 대규모 언어 모델은 앞뒤 상황을 바탕으로 이 문장이 완곡한 표현임을 알아채고 기계적인 직역 대신 문맥에 맞게 의역해 냅니다(예시).
대규모 언어 모델이 나오기 전에는 신경망 기계 번역이 문장의 뜻은 맞히더라도 원문 구조에 얽매여 이른바 '번역기 말투'가 묻어나는 딱딱한 문장이 많았습니다. 예를 들어 직장에서 흔히 쓰는 표현인 「요청하신 자료는 오늘 중으로 보내드리겠습니다」를 예전 번역기는 글자 그대로 뻣뻣하게 "The requested materials within today I will send."로 직역하곤 했습니다(예시). 반면 대규모 언어 모델은 자연스러운 영어 표현인 "I'll send you the requested materials today."를 내놓습니다(예시). 2023년 국제 기계 번역 평가(WMT23)에 이르러서는 최상위 기계 번역의 품질이 사람의 번역과 우열을 가리기 힘들 정도가 되었습니다.
글자 너머의 시험대: 엔드투엔드 동시통역은 언제 입을 열지 어떻게 결정할까요?
글자 번역을 넘어선 기계는 이제 한층 더 어려운 과제에 도전하고 있습니다. 누군가 연단에서 말을 이어 갈 때 실시간으로 듣고 외국어로 통역해 말해 주는 동시통역입니다.
초기의 음성 번역은 세 단계를 거치는 캐스케이드 방식(직렬 연결 방식)을 따랐습니다.
- 음성 인식(ASR): 먼저 들리는 말소리를 원문 글자로 바꿉니다.
- 기계 번역(MT): 바뀐 원문 글자를 외국어 글자로 번역합니다.
- 음성 합성(TTS): 마지막으로 번역된 외국어 글자를 합성 음성으로 읽어 줍니다.
세 단계를 이어 달리는 이 방식에는 두 가지 뚜렷한 한계가 있었습니다. 첫째는 느리고 오류가 눈덩이처럼 불어난다는 점입니다. 뒷단계가 앞 단계의 계산이 끝날 때까지 마냥 기다려야 하니 세 구간의 지연 시간이 고스란히 쌓여 반응이 느려졌고, 첫 단계인 음성 인식에서 단어를 하나라도 잘못 들으면 뒤이은 번역과 음성 합성까지 연달아 틀려 버렸습니다. 둘째는 감정이 사라진다는 점입니다. 사람이 말할 때의 어조와 강세, 감정은 모두 소리 파형 속에 담겨 있는데, 중간 단계에서 말을 차가운 글자로 바꾸는 순간 이러한 비언어적 정보가 전부 날아가 버려 결국 마지막에는 억양 없는 기계음만 남게 됩니다.
중간의 글자 단계를 건너뛰기 위해 연구자들은 엔드투엔드(End-to-End) 모델로 눈을 돌렸습니다. 세 단계로 쪼개지 않고 단일 모델 하나로 한 언어의 소리에서 다른 언어의 소리로 곧바로 통역하는 방식입니다. 앞 단계의 오류가 뒤로 전해지지 않고 한 번만 계산하면 되니 기다림도 줄어 더 빠릅니다. 2019년 구글이 발표한 Translatotron이 바로 이렇게 소리에서 소리로 바로 가는 모델로, 외국어 통역문을 말할 때 원래 화자의 목소리까지 그대로 살려 냈습니다. 다만 당시에는 화자가 한 문장을 끝까지 다 말해야만 비로소 입을 열어 번역할 수 있었기 때문에 진정한 의미의 동시통역이라고 보기는 어려웠습니다.
진정한 동시통역을 해내려면 가장 큰 난제를 풀어야 합니다. 바로 언제 입을 여느냐입니다.
이 문제는 글 맨 처음에 살펴보았던 어순 차이로 다시 이어집니다. 한국어와 영어는 어순이 달라서, 화자가 문장 앞부분을 막 말했을 때는 핵심 동사가 아직 뒷부분에 남아 입 밖으로 나오지 않은 경우가 많습니다. 기계가 오래 기다릴수록 더 온전한 정보를 들을 수 있어 번역은 정확해지지만, 이어폰을 끼고 통역을 기다리는 사람은 그만큼 답답해집니다. 반대로 시간을 아끼겠다고 단어가 들리자마자 성급하게 입을 열면 뒷부분을 듣지 못해 오역하기 십상입니다. 뛰어난 동시통역 시스템은 '기다리기'와 '말하기' 사이에서 아슬아슬한 줄타기를 해야 합니다. 예를 들어 앞부분을 듣고 뜻이 통할 만큼 모이면 먼저 통역을 시작한 뒤, 뒷부분 말이 나오면 앞선 말에 자연스럽게 이어 붙이는 식입니다(예시).
2025년에 이르러 최신 동시통역 모델은 전이중(Full-Duplex) 구조로 발전했습니다. 하나의 모델이 듣기와 말하기를 동시에 수행하는 것입니다. 그 바탕은 여전히 다음을 맞히는 언어 모델이지만, 이제는 다음에 올 단어만 맞히는 게 아니라 매 순간 실시간으로 지금 더 들을지, 아니면 입을 열어 말할지도 함께 맞힙니다(예시).
2025년 한 연구팀의 보고에 따르면, 이러한 엔드투엔드 전이중 동시통역 모델은 사람의 말을 들으면서 동시에 화자 본인의 목소리로 외국어 통역을 들려줄 수 있으며, 목소리를 복제해 동시통역할 때 걸리는 평균 지연 시간을 기존 방식의 약 10초 수준에서 약 3초로 대폭 줄여 지연 시간을 약 70% 단축했습니다.
70년간 올라온 네 계단: 제대로 번역하려면 먼저 제대로 이해해야 합니다
시간을 다시 1947년으로 되돌려 지난 70여 년의 여정을 하나의 그래프로 그려 보면, 기계 번역이 일궈 낸 세 번의 큰 도약이 한눈에 들어옵니다. 1990년 무렵의 통계 기반 기계 번역, 2014년 부상한 신경망 기계 번역(2016년 구글 실측 기준 오류 약 60% 감소), 그리고 2020년대의 대규모 언어 모델(2023년 국제 평가에서 최상위 시스템이 사람의 번역과 우열을 가리기 힘들어진 단계)입니다.
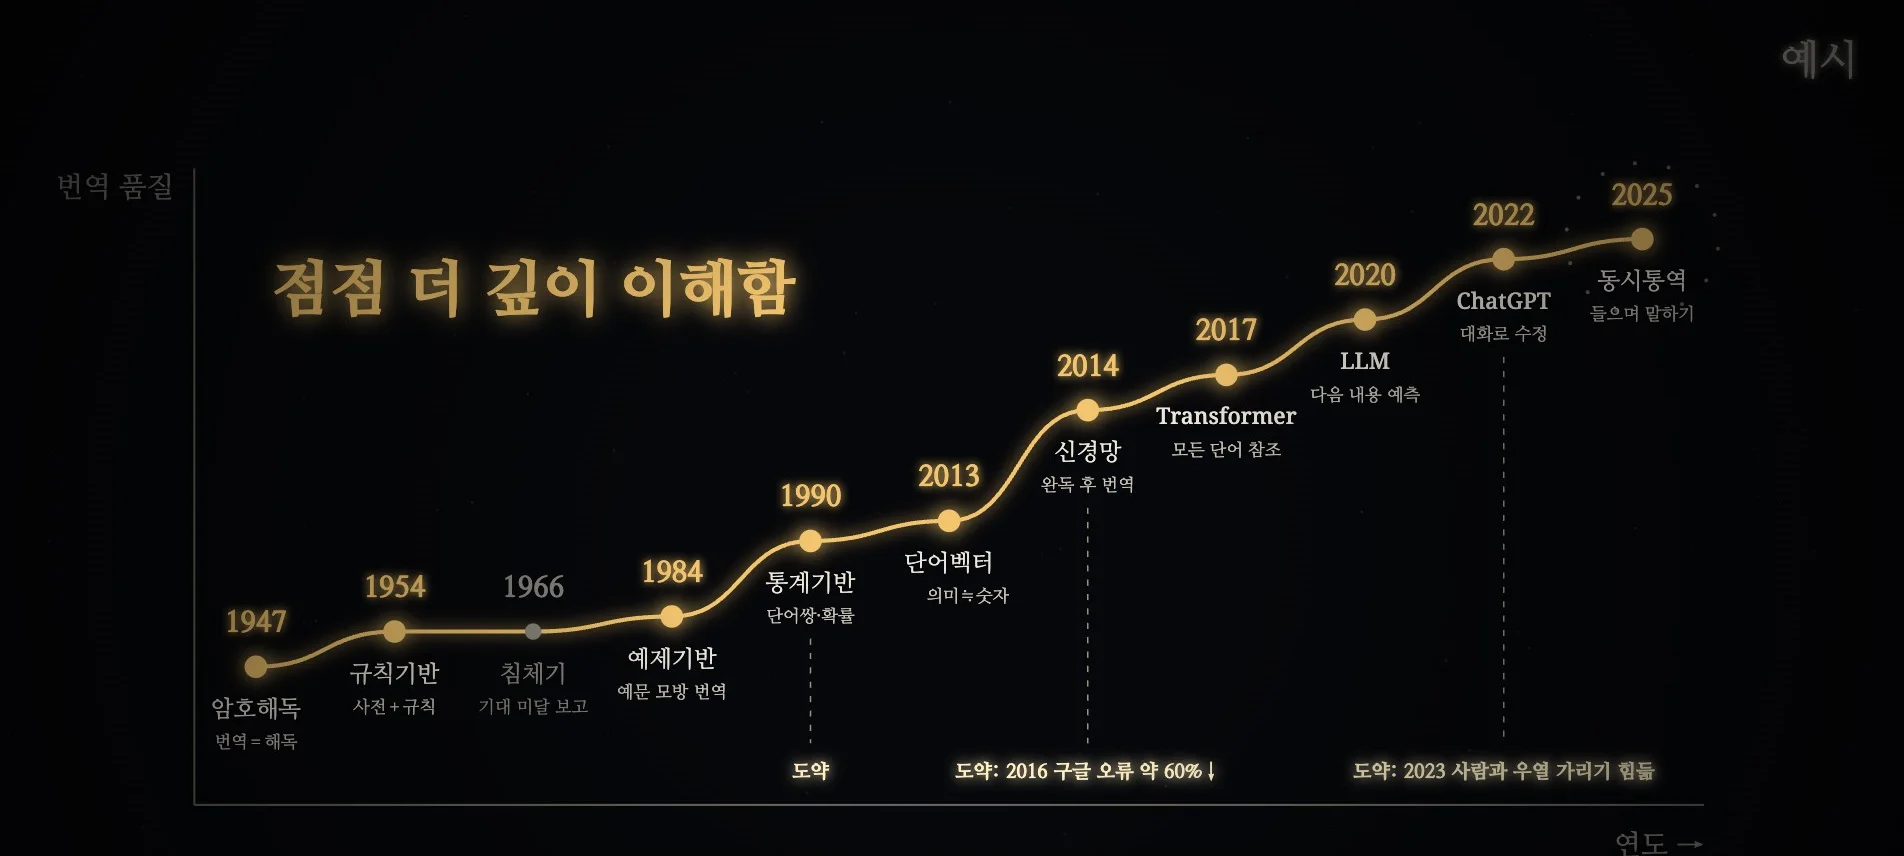
맨 처음 사람들은 번역을 두 언어 사이에서 대응하는 기호만 찾으면 풀리는 암호 해독 문제라고 생각했습니다. 하지만 거듭 벽에 부딪히면서, 딱딱한 문법 규칙만으로는 언어 속의 무수한 예외를 다 적을 수 없고 단어 쌍의 등장 횟수만 세는 통계 번역으로도 참뜻은 붙잡지 못한다는 사실을 깨닫게 되었습니다.
기계 번역이 한 걸음 나아갈 때마다, 기계는 인간의 언어를 한 겹씩 더 깊이 이해하게 되었습니다.
- 첫 번째 계단: 기호(1954~2013). 사람이 사전과 문법을 적어 넣은 규칙 기반 번역이든, 방대한 문장 쌍에서 단어 빈도를 세는 통계 기반 번역이든, 기계의 눈에 단어는 고립된 기호일 뿐이었고 번역은 기호와 기호를 짝짓는 작업에 머물렀습니다.
- 두 번째 계단: 단어 의미(2013). 단어 벡터가 각 단어를 수백 개의 연속된 숫자로 바꾸어 놓으면서, 기계는 처음으로 단어와 단어 사이의 뜻이 얼마나 가까운지 계산해 내고 배운 것을 비슷한 단어에 응용할 수 있게 되었습니다.
- 세 번째 계단: 문장(2014~2017). 순환 신경망과 어텐션 메커니즘에서 Transformer에 이르기까지, 기계는 문장 전체를 하나의 기억으로 읽고 문장 안에서 셀프 어텐션으로 단어들 사이의 관계를 살피며 문장 전체의 어울림에 따라 각 단어의 뜻과 어순을 정하는 법을 배웠습니다.
- 네 번째 계단: 맥락(2020~현재). 대규모 언어 모델은 시야를 한 문장에서 문단 전체, 나아가 대화 전체로 넓혔으며, 앞선 상황과 말투 요청, 심지어 화자의 목소리까지 살려 상황에 꼭 맞는 번역을 내놓게 되었습니다.
맨 처음 보았던 "나는 어제 서울에서 그를 만났다"라는 아주 평범한 문장조차, 단어 몇 개를 알맞은 자리로 옮겨 제대로 번역하려면 먼저 그 문장을 제대로 이해해야 합니다. 번역이란 결코 단순한 기호 바꾸기가 아니라, 곧 이해이기 때문입니다.
참고문헌
- 1947년 3월 4일 Weaver가 Wiener에게 보낸 편지; 1949년 메모 "Translation"
- 1954년 Georgetown–IBM 실험
- ALPAC 보고서 (1966): Language and Machines: Computers in Translation and Linguistics https://nap.nationalacademies.org/catalog/9547
- 캐나다 METEO 일기예보 번역 시스템 (1981년~)
- Makoto Nagao (1984): A Framework of a Mechanical Translation between Japanese and English by Analogy Principle
- 통계적 기계 번역, Brown et al. (1990): A Statistical Approach to Machine Translation https://aclanthology.org/J90-2002/
- 2006년 구글 번역 출시 (통계적 기계 번역)
- word2vec, Mikolov et al. (2013): Efficient Estimation of Word Representations in Vector Space https://arxiv.org/abs/1301.3781
- Sequence to sequence, Sutskever et al. (2014): Sequence to Sequence Learning with Neural Networks https://arxiv.org/abs/1409.3215
- Cho et al. (2014): Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation https://arxiv.org/abs/1406.1078
- 어텐션 메커니즘, Bahdanau et al. (2014): Neural Machine Translation by Jointly Learning to Align and Translate https://arxiv.org/abs/1409.0473
- 2015년 바이두 신경망 기계 번역 출시; Google, Wu et al. (2016, 오류 평균 약 60% 감소): Google's Neural Machine Translation System: Bridging the Gap between Human and Machine Translation https://arxiv.org/abs/1609.08144
- Transformer, Vaswani et al. (2017): Attention Is All You Need https://arxiv.org/abs/1706.03762 ; 인용 데이터 출처 Nature (2025): Exclusive: the most-cited papers of the twenty-first century https://www.nature.com/articles/d41586-025-01125-9
- GPT-1 (2018): Improving Language Understanding by Generative Pre-Training https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf ; GPT-2 (2019): Language Models are Unsupervised Multitask Learners https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- GPT-3, Brown et al. (2020): Language Models are Few-Shot Learners https://arxiv.org/abs/2005.14165
- 스케일링 법칙, Kaplan et al. (2020): Scaling Laws for Neural Language Models https://arxiv.org/abs/2001.08361
- GPT-4 Technical Report (2023, 파라미터 수 미공개; Semafor 보도에 따르면 약 1조 개, 미확인) https://arxiv.org/abs/2303.08774
- Briakou et al. (2023): Searching for Needles in a Haystack: On the Role of Incidental Bilingualism in PaLM's Translation Capability https://arxiv.org/abs/2305.10266
- ChatGPT: 2022년 11월 30일 OpenAI 릴리스 노트, Introducing ChatGPT https://openai.com/index/chatgpt/
- WMT23 (2023): Findings of the 2023 Conference on Machine Translation (WMT23): LLMs Are Here But Not Quite There Yet https://aclanthology.org/2023.wmt-1.1/
- Translatotron, Jia et al. (2019): Direct speech-to-speech translation with a sequence-to-sequence model https://arxiv.org/abs/1904.06037
- STACL, Ma et al. (2018): STACL: Simultaneous Translation with Implicit Anticipation and Controllable Latency using Prefix-to-Prefix Framework https://arxiv.org/abs/1810.08398
- Moshi (2024, 실시간 음성 대화 모델): Moshi: a speech-text foundation model for real-time dialogue https://arxiv.org/abs/2410.00037
- Hibiki (2025): High-Fidelity Simultaneous Speech-To-Speech Translation https://arxiv.org/abs/2502.03382
- Seed LiveInterpret 2.0 (2025): Seed LiveInterpret 2.0: End-to-end Simultaneous Speech-to-speech Translation with Your Voice https://arxiv.org/abs/2507.17527