PDFs übersetzen: Warum die Formatierung dabei verloren geht
 Equalang
Kurz gesagt
Die meisten PDFs speichern nicht, welche Wörter einen Absatz oder eine Tabelle bilden. An zwei Papers: was schiefgeht und was Sie danach prüfen sollten.
Schlagwörter: PDF übersetzen; Dokumentenübersetzung; PDF-Formatierung; Layout erhalten; wissenschaftliche Paper
Eine Word-Datei hält fest, welche Wörter einen Absatz bilden und welche zu einer Tabelle gehören. Die meisten PDFs tun das nicht. Sie enthalten nur die Buchstaben und die Koordinaten, an denen sie gezeichnet werden; Absätze, Tabellen und Sätze entstehen erst im Auge der lesenden Person. Manche PDFs tragen Barrierefreiheits-Tags (zusätzlich für Screenreader eingefügt), die Absätze und Tabellen markieren, viele jedoch nicht (die beiden Papers, die wir unten als Beispiele verwenden, haben keine), deshalb kann sich ein Übersetzungswerkzeug nicht darauf verlassen. Alles, was Sie als Struktur sehen (ein zweispaltiges Layout, eine Kopfzeile über mehreren Spalten, ein Satz, der auf der nächsten Seite weitergeht), muss vor dem Übersetzen erst wieder rekonstruiert werden. Danach muss der übersetzte Text, nun länger oder kürzer, zurück in das ursprüngliche Layout passen. Die Formatierung geht in einem dieser beiden Schritte verloren.
Was Sie tun sollten, hängt davon ab, was Sie haben:
- Die Originaldatei als .docx oder .pptx: übersetzen Sie diese statt des PDFs.
- Ein reines Text-PDF mit wenigen Tabellen, unter 10 MB: der kostenlose Dokumenten-Upload von Google Übersetzer ist die schnellste Option, um es auszuprobieren.
- Ein Paper, Handbuch oder ein Bericht mit Tabellen, Gleichungen oder zwei Spalten: nutzen Sie ein Übersetzungswerkzeug, das das Layout rekonstruiert, und prüfen Sie danach die vier Stellen in Abschnitt 3.
- Ein Scan (bei dem sich kein Text auswählen lässt): er braucht eine Texterkennung (OCR), bevor er übersetzt werden kann. DeepL nimmt Scans an und erledigt diesen Schritt selbst. Google Übersetzer lässt gescannte Seiten unübersetzt.
1. Was sieht ein Übersetzungswerkzeug eigentlich in einem PDF?
Wir entwickeln ein Werkzeug für Dokumentenübersetzung und sehen uns deshalb viel an, was aus PDFs herauskommt. Um das greifbar zu zeigen, haben wir zwei Papers über KI-Sprachmodelle von arXiv genommen, LLaMA und Mistral 7B, und den Text mit mutool aus MuPDF extrahiert, einem verbreiteten Open-Source-Werkzeug für PDFs. Dieser Text ist in etwa das, womit ein Werkzeug arbeitet, solange es nicht auch das Layout liest. Unten wird jede Stelle erst so gezeigt, wie sie auf der Seite aussieht, dann so, wie sie herauskommt (eine Zeile mit nur … bedeutet, dass wir Zeilen übersprungen haben).
1.1 Aus Tabellen wird eine Liste von Zahlen
Tabelle 3 im LLaMA-Paper vergleicht zehn Modelle in acht Tests:
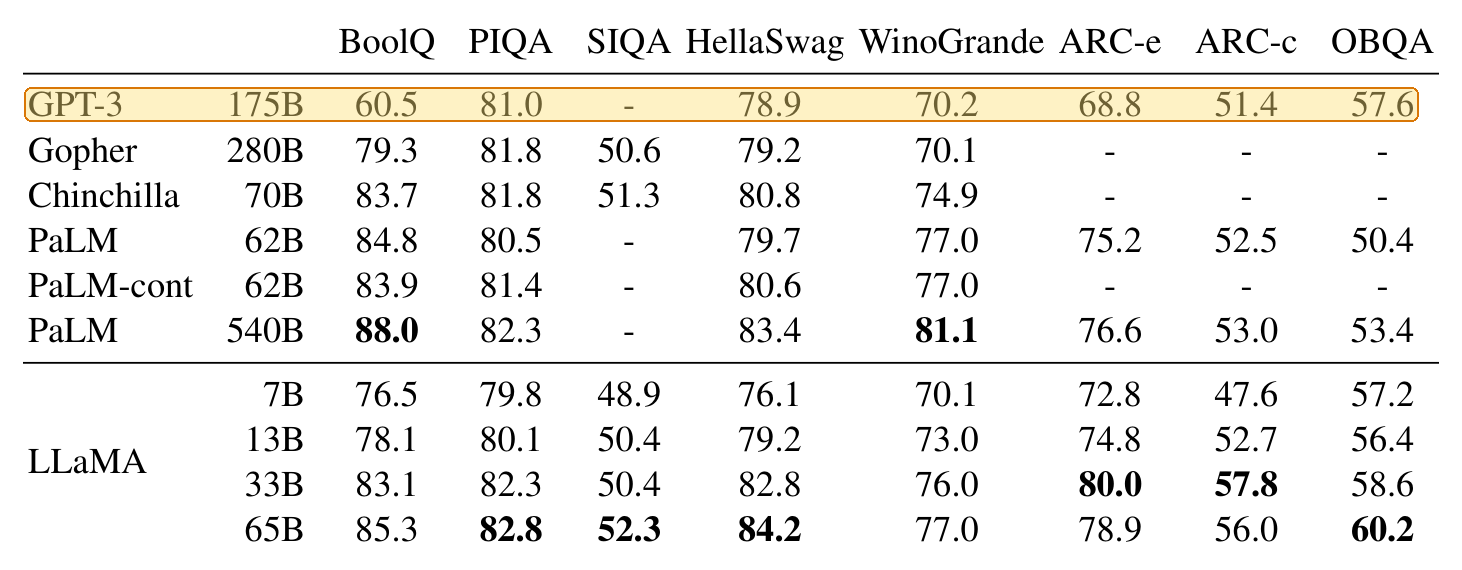
Extrahiert sind es 102 Zeilen: eine fünfzeilige Kopfzeile, danach ein Wert pro Zeile. Das sind die ersten 16; die zehn Werte von GPT-3 bis 57.6 sind die hervorgehobene Zeile.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Nichts sagt dem Übersetzungswerkzeug, welche Zahl zu welchem Test gehört. Wenn Sie das in ein Übersetzungsfeld einfügen, erhalten Sie dieselbe Liste zurück. Die Wörter sind übersetzt, aber die Tabelle ist verschwunden.
1.2 Ein Satz, in dem eine ganze Tabelle steckt
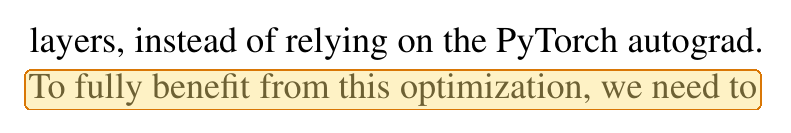
Der letzte Satz auf Seite 3 des LLaMA-Papers bricht bei „we need to" ab:
Er geht in der linken Spalte auf Seite 4 weiter, direkt unter Tabelle 3:
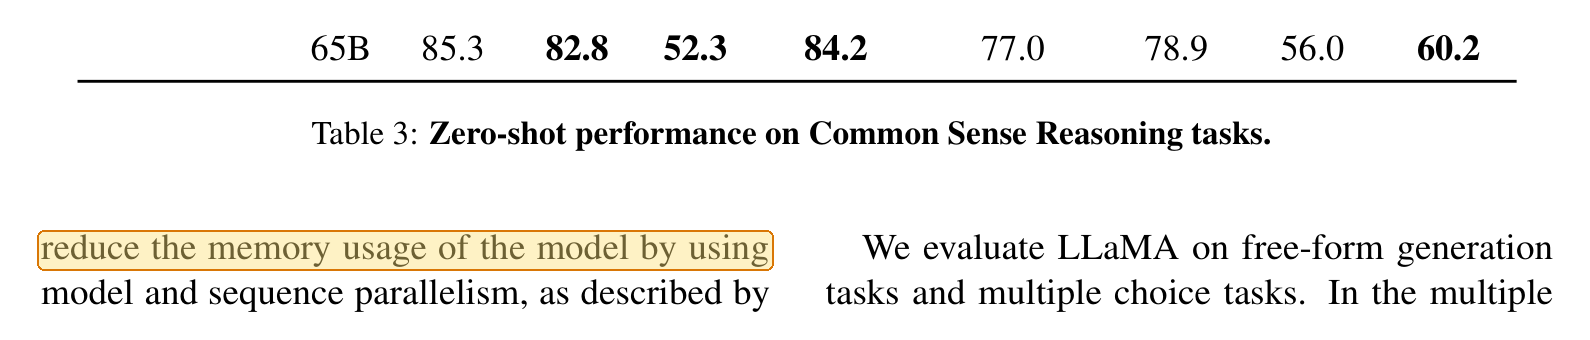
Im extrahierten Text liegen eine Fußnote, der Seitenwechsel, alle 102 Zeilen der Tabelle und ihre Überschrift innerhalb dieses einen Satzes:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Zwei Seiten später passiert es wieder. Seite 5 endet mit „…the textual description and tests in a", und „docstring." folgt erst nach Tabelle 7 auf Seite 6, dazwischen liegen die 44 Zeilen der Tabelle und ihre siebenzeilige Überschrift.
Ein Werkzeug, das Seite für Seite übersetzt oder dem Text in genau dieser Reihenfolge folgt, erhält zwei Bruchstücke, für die es keinen Anlass hat, sie zu verbinden. In der übersetzten Datei sehen Sie einen Satz, der am Seitenende ausläuft, und seine andere Hälfte taucht irgendwo unter einer Tabelle wieder auf.
1.3 Tiefgestellte Zeichen und Brüche werden etwas anderes
Im Mistral-Paper ist eine Variable als h mit tiefgestelltem i geschrieben:
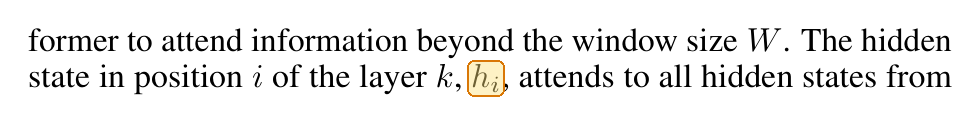
Beim Extrahieren verschwindet das tiefgestellte Zeichen, hi bleibt übrig:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Ein Übersetzungswerkzeug hat keinen Anlass, das als Variable zu behandeln. Für das Werkzeug ist hi einfach ein gewöhnliches englisches Wort.
Brüche sind schlimmer dran. LLaMA setzt einen Wert auf zwei Drittel von 4d, geschrieben als ⅔·4d, wobei ⅔ als kleine 2 über einer 3 gesetzt ist:
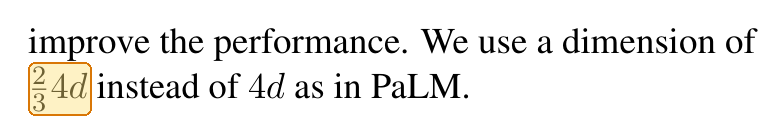
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Aus zwei Dritteln von 4d ist 34d geworden. Hochgestellte Zeichen, Brüche und Symbole aus Mathematikschriften sind nur Formen an bestimmten Positionen. Extrahierter Text behält die Formen, verliert aber die Positionen.
1.4 Wörter werden am Zeilenende getrennt
Zweispaltige Paper trennen viele Wörter am Zeilenende. Im LLaMA-Paper brechen 242 Zeilen ein gewöhnliches kleingeschriebenes Wort mit einem Bindestrich. Sie wieder zusammenzusetzen wirkt einfach, bis man bei einem Bindestrich ankommt, der zu einem Namen gehört:
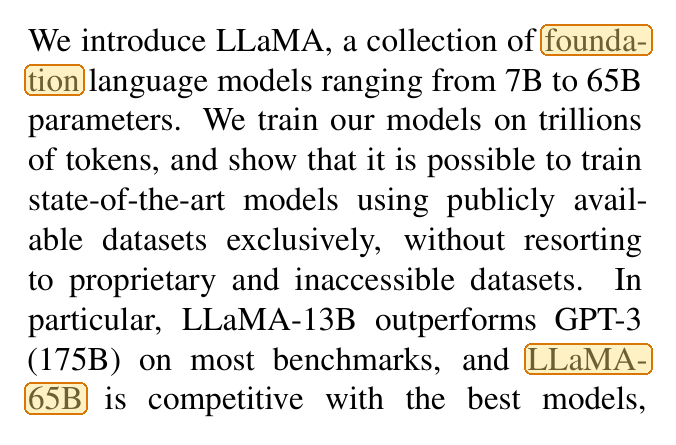
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- und tion ergeben ohne den Bindestrich ein Wort. Aber bei LLaMA- und 65B gehört der Bindestrich zum Modellnamen und muss bleiben.
Wir haben nur ein Extraktionswerkzeug auf zwei Papers angewandt, die mit LaTeX erstellt wurden, einem im akademischen Publizieren verbreiteten Satzprogramm. Aus Word exportierte PDFs, gescannte Dokumente und andere Extraktionswerkzeuge können andere Ergebnisse liefern, aber auf diese vier Arten von Schäden sollten Sie achten.
2. Welche Möglichkeiten gibt es?
Die Angaben zu Google Übersetzer und DeepL stammen aus den jeweiligen Hilfeseiten, geprüft am 7. Oktober 2026. Wenn eine PDF-Übersetzung enttäuscht, rät DeepL, stattdessen das Originaldokument hochzuladen. Das deckt sich mit unserem Rat.
Die letzte Zeile ist das, wofür Equalangs Dokumentenübersetzung gebaut ist, und der Ansatz, den wir am besten kennen. Vor der Übersetzung fügt Equalang Sätze wieder zusammen, die ein Seitenumbruch zerschnitten hat. Tabellen mit verbundenen Zellen und mehrzeiligen Kopfzeilen werden in ihrer ursprünglichen Struktur wieder aufgebaut, statt sie zu einer einzigen Liste einzuebnen. Gleichungen werden nicht als unlesbarer Text weggeworfen, und für schwierige Gleichungen, die mitten in einer Textzeile stehen, gibt es eine Option zur Formeloptimierung.
Was sie nicht tut, ist das Original exakt zu reproduzieren. Eine Übersetzung, die länger wird als das Original, verschiebt Zeilenumbrüche und Schriftgrößen; deshalb lohnt sich bei eng gesetzten Seiten weiterhin ein Blick. Die Dokumentenübersetzung deckt derzeit Chinesisch, Englisch, Japanisch, Koreanisch, Spanisch, Französisch und weitere Sprachen ab.
3. Was sollten Sie nach der Übersetzung prüfen?
- Tabellen. Stehen die Kopfzeilen noch über der richtigen Spalte? Sind die Zahlen unverändert?
- Seitenwechsel und der Text unter jeder Tabelle. Lesen Sie die letzte Zeile jeder Seite und den Satz direkt nach jeder Tabelle. Ein Satz, der abbricht und nie zu Ende geführt wird, ist das häufigste Anzeichen dafür, dass der Text in Stücken übersetzt wurde.
- Gleichungen und Variablen. Prüfen Sie einige, die mitten in einer Textzeile stehen. Achten Sie auf Buchstaben, die zu Wörtern geworden sind, und auf Brüche, die zu anderen Zahlen geworden sind.
- Seitenzahl und Links. Eine stark abweichende Seitenzahl bedeutet, dass Text verloren ging oder auf zusätzliche Seiten überlief. Klicken Sie ein oder zwei Einträge des Inhaltsverzeichnisses an, um zu sehen, ob sie funktionieren.
Quellen
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Google Übersetzer Hilfe, Translate documents & websites, geprüft am 7. Oktober 2026.
- DeepL-Hilfebereich, Translate PDF files, geprüft am 7. Oktober 2026.
- Methode: Text extrahiert am 7. Oktober 2026 mit MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Die Abbildungen sind Ausschnitte aus den Seiten der Papers; die Hervorhebungen stammen von uns.