Dịch PDF: vì sao định dạng bị mất và cách giữ lại
 Equalang
Tóm tắt
Khác với tệp Word, hầu hết PDF không đánh dấu từ nào tạo thành đoạn văn hay bảng. Qua hai bài báo, chúng tôi chỉ ra điều gì hỏng và cần kiểm tra gì.
Từ khóa: dịch PDF; dịch tài liệu; định dạng PDF; giữ bố cục; bài báo khoa học
Một tệp Word lưu lại những từ nào tạo thành một đoạn văn và những từ nào thuộc về một bảng. Hầu hết PDF thì không. Chúng chỉ giữ các chữ cái và tọa độ để vẽ chúng lên; còn đoạn văn, bảng và câu là do mắt người đọc ghép lại. Một số PDF có thẻ hỗ trợ tiếp cận (được thêm cho trình đọc màn hình) đánh dấu đoạn văn và bảng, nhưng nhiều tệp không có (hai bài báo chúng tôi dùng làm ví dụ bên dưới hoàn toàn không có), nên công cụ dịch không thể trông chờ vào chúng. Mọi thứ bạn thấy là cấu trúc (bố cục hai cột, tiêu đề trải dài trên nhiều cột, hay một câu tiếp tục sang trang sau) đều phải được khôi phục trước khi dịch. Sau đó, văn bản đã dịch — giờ dài hơn hoặc ngắn hơn — lại phải vừa với bố cục gốc. Định dạng bị mất ở một trong hai bước đó.
Việc nên làm phụ thuộc vào thứ bạn có:
- Tệp .docx hoặc .pptx gốc: hãy dịch tệp đó thay vì PDF.
- PDF văn bản đơn giản, ít bảng, dưới 10 MB: tải tài liệu lên miễn phí bằng Google Dịch là cách thử nhanh nhất.
- Bài báo, hướng dẫn sử dụng hay báo cáo có bảng, công thức hoặc hai cột: dùng công cụ dịch khôi phục bố cục, rồi kiểm tra bốn vị trí ở mục 3.
- Bản scan (không thể chọn được văn bản): cần nhận dạng văn bản (OCR) trước khi dịch được. DeepL nhận bản scan và tự xử lý bước này. Google Dịch để nguyên các trang scan không dịch.
1. Công cụ dịch thực sự nhìn thấy gì trong một tệp PDF?
Chúng tôi xây dựng một công cụ dịch tài liệu, nên dành nhiều thời gian xem thứ gì đi ra từ PDF. Để cho thấy rõ, chúng tôi lấy hai bài báo về mô hình ngôn ngữ AI trên arXiv, LLaMA và Mistral 7B, và trích xuất văn bản bằng mutool của MuPDF, một công cụ PDF mã nguồn mở phổ biến. Văn bản đó đại khái là thứ mà một công cụ dùng để dịch, nếu nó không đọc cả bố cục. Ở dưới, mỗi đoạn được trình bày trước tiên theo cách nó hiện trên trang, sau đó theo cách nó đi ra (một dòng chỉ có … nghĩa là chúng tôi đã bỏ qua vài dòng).
1.1 Bảng biến thành một danh sách số
Bảng 3 trong bài báo LLaMA so sánh mười mô hình trên tám bài kiểm tra:
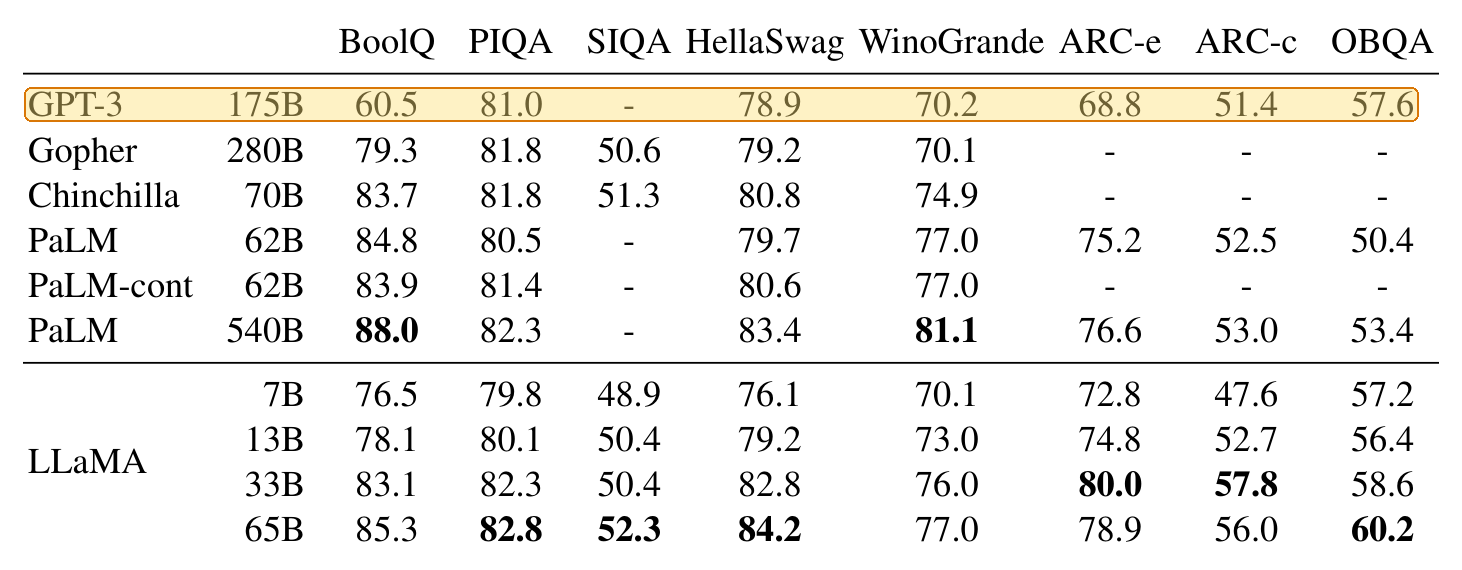
Sau khi trích xuất, nó là 102 dòng: năm dòng tiêu đề, rồi mỗi dòng một giá trị. Đây là 16 dòng đầu; mười dòng từ GPT-3 đến 57.6 chính là hàng được đánh dấu.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Không có gì cho công cụ dịch biết số nào thuộc về bài kiểm tra nào. Nếu bạn dán đoạn đó vào ô dịch, bạn nhận lại chính danh sách đó. Từ ngữ được dịch, còn bảng thì biến mất.
1.2 Một câu, mà bên trong chứa cả một bảng
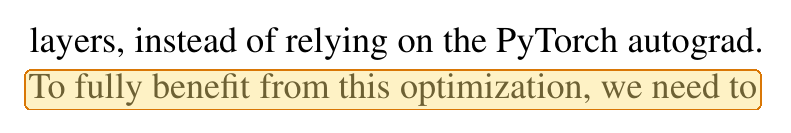
Câu cuối cùng ở trang 3 của bài báo LLaMA dừng lại ở "we need to":
Nó tiếp tục ở cột bên trái trang 4, ngay dưới Bảng 3:
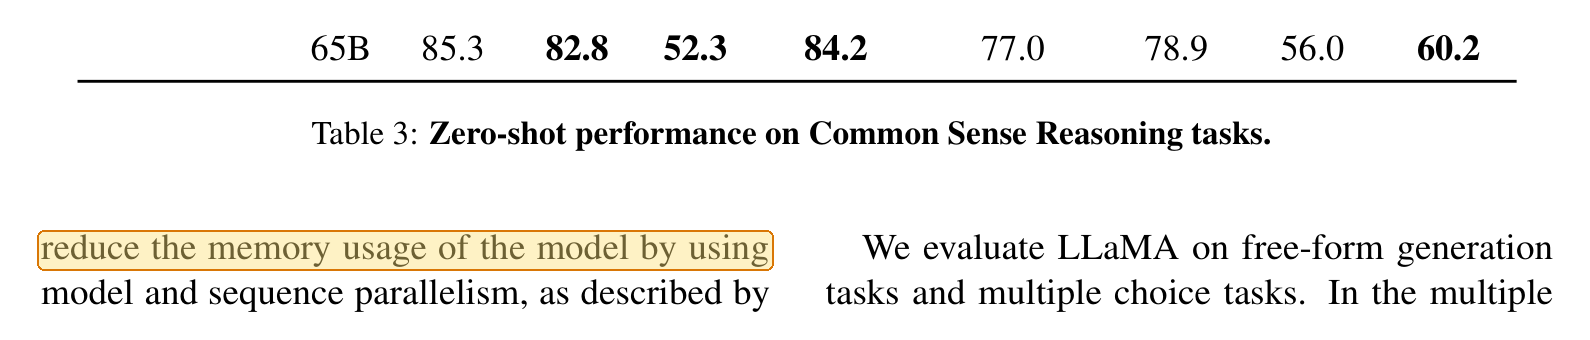
Trong văn bản đã trích xuất, một chú thích cuối trang, chỗ ngắt trang, toàn bộ 102 dòng của bảng và chú thích của nó đều nằm gọn trong chính câu đó:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Chuyện này lặp lại hai trang sau đó. Trang 5 kết thúc ở "…the textual description and tests in a", và "docstring." chỉ xuất hiện sau Bảng 7 ở trang 6, xen giữa là 44 dòng của bảng và chú thích dài bảy dòng.
Một công cụ dịch từng trang, hoặc đi theo văn bản đúng thứ tự này, sẽ nhận được hai mảnh mà nó chẳng có lý do gì để nối lại. Trong tệp đã dịch, bạn sẽ thấy một câu lịm dần ở cuối trang, và nửa còn lại xuất hiện ở đâu đó bên dưới một bảng.
1.3 Chỉ số dưới và phân số biến thành thứ khác
Trong bài báo Mistral, một biến được viết là h với chỉ số dưới i:
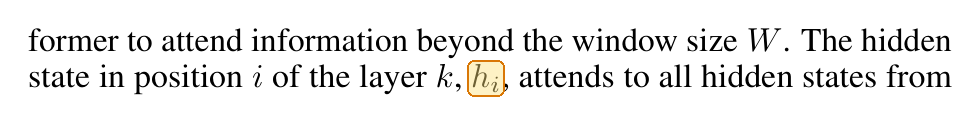
Khi trích xuất, chỉ số dưới biến mất và chỉ còn hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Công cụ dịch không có lý do gì để coi đó là một biến. Với nó, hi chỉ là một từ tiếng Anh thông thường.
Phân số còn tệ hơn. LLaMA đặt một giá trị bằng hai phần ba của 4d, viết là ⅔·4d, trong đó ⅔ được sắp bằng số 2 nhỏ bên trên số 3:
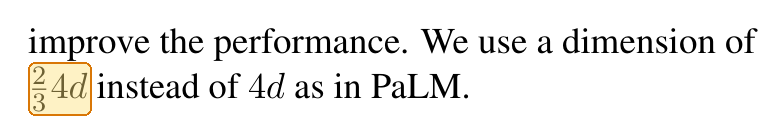
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Hai phần ba của 4d đã trở thành 34d. Chỉ số trên, phân số và các ký hiệu từ font toán học chỉ là những hình dạng được đặt ở những vị trí nhất định. Văn bản trích xuất giữ được hình dạng nhưng mất vị trí.
1.4 Từ bị tách ở cuối dòng
Các bài báo hai cột tách rất nhiều từ ở cuối dòng. Trong LLaMA, có 242 dòng tách một từ thường viết thường bằng dấu gạch nối. Nối chúng lại có vẻ dễ, cho đến khi bạn gặp một dấu gạch nối thuộc về tên riêng:
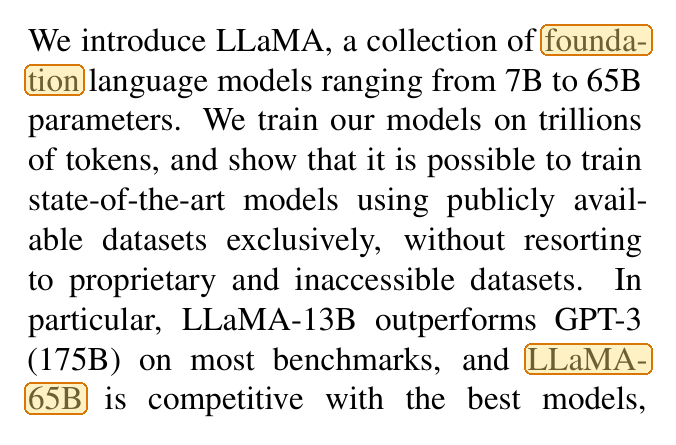
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- và tion tạo thành một từ nếu bỏ dấu gạch nối. Nhưng trong LLaMA- và 65B, dấu gạch nối là một phần của tên mô hình và phải giữ lại.
Chúng tôi chỉ dùng một công cụ trích xuất, trên hai bài báo được làm bằng LaTeX, một hệ thống sắp chữ phổ biến trong xuất bản học thuật. PDF xuất từ Word, tài liệu scan và các công cụ trích xuất khác có thể cho kết quả khác, nhưng bốn dạng hư hại này là thứ cần tìm.
2. Bạn có những lựa chọn nào?
Thông tin về Google Dịch và DeepL lấy từ trang trợ giúp của chính họ, kiểm tra ngày 7 tháng 10 năm 2026. Khi một bản dịch PDF gây thất vọng, lời khuyên của DeepL là hãy tải lên tài liệu gốc. Điều đó trùng với lời khuyên của chúng tôi.
Hàng cuối cùng chính là điều mà dịch tài liệu của Equalang được tạo ra để làm, vì vậy đó là cách chúng tôi hiểu rõ nhất. Trước khi dịch, Equalang nối lại những câu bị ngắt trang cắt làm đôi. Các bảng có ô gộp và tiêu đề nhiều dòng được khôi phục theo cấu trúc gốc thay vì bị gộp phẳng thành một danh sách. Công thức không bị vứt bỏ như văn bản lỗi, và có tùy chọn tối ưu công thức cho những công thức khó nằm trong một dòng văn bản.
Điều nó không làm là tái tạo bản gốc y hệt. Một bản dịch dài hơn bản gốc sẽ làm lệch chỗ xuống dòng và cỡ chữ, nên những trang có bố cục chật vẫn đáng để xem lại. Dịch tài liệu hiện hỗ trợ tiếng Trung, tiếng Anh, tiếng Nhật, tiếng Hàn, tiếng Tây Ban Nha, tiếng Pháp và nhiều ngôn ngữ khác.
3. Sau khi dịch PDF, cần kiểm tra những gì?
- Bảng. Tiêu đề còn nằm trên đúng cột không? Các con số có thay đổi không?
- Chỗ ngắt trang và văn bản dưới mỗi bảng. Hãy đọc dòng cuối của mỗi trang và câu ngay sau mỗi bảng. Một câu dừng lại rồi không bao giờ kết thúc là dấu hiệu thường gặp nhất cho thấy văn bản đã được dịch thành từng mảnh.
- Công thức và biến. Kiểm tra vài công thức nằm trong một dòng văn bản. Tìm những chữ cái đã biến thành từ, và những phân số đã biến thành số khác.
- Số trang và liên kết. Số trang chênh lệch quá nhiều nghĩa là có văn bản bị mất hoặc tràn sang trang khác. Hãy nhấp vào một hai mục trong mục lục để xem chúng có hoạt động không.
Nguồn
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Trợ giúp Google Dịch, Translate documents & websites, kiểm tra ngày 7 tháng 10 năm 2026.
- Trung tâm trợ giúp DeepL, Translate PDF files, kiểm tra ngày 7 tháng 10 năm 2026.
- Phương pháp: văn bản được trích xuất ngày 7 tháng 10 năm 2026 bằng MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Các hình là phần cắt từ trang của hai bài báo; phần đánh dấu là của chúng tôi.