ทำไม PDF ที่แปลแล้วถึงเสียรูปแบบ และจะรักษาไว้อย่างไร
 Equalang
โดยสังเขป
ต่างจากไฟล์ Word ไฟล์ PDF ส่วนใหญ่ไม่ระบุว่าคำใดรวมกันเป็นย่อหน้าหรือตาราง เราใช้สองบทความเพื่อแสดงว่าอะไรพังและควรตรวจอะไร
คำสำคัญ: แปล PDF; แปลเอกสาร; รูปแบบ PDF; รักษาเลย์เอาต์; บทความวิจัย
ไฟล์ Word บันทึกว่าคำใดประกอบกันเป็นย่อหน้าและคำใดอยู่ในตาราง แต่ไฟล์ PDF ส่วนใหญ่ไม่ทำอย่างนั้น สิ่งที่มีอยู่คือตัวอักษรและพิกัดสำหรับวาดมันลงไป ส่วนย่อหน้า ตาราง และประโยคนั้น ตาของผู้อ่านเป็นผู้ประกอบขึ้นเอง ไฟล์ PDF บางไฟล์มีแท็กการเข้าถึง (เพิ่มมาเพื่อโปรแกรมอ่านหน้าจอ) ที่ระบุย่อหน้าและตาราง แต่หลายไฟล์ก็ไม่มี (สองบทความที่เราใช้เป็นตัวอย่างด้านล่างไม่มีเลย) ดังนั้นเครื่องมือแปลจึงพึ่งพาไม่ได้ ทุกอย่างที่คุณเห็นว่าเป็นโครงสร้าง (เลย์เอาต์สองคอลัมน์ หัวข้อที่คร่อมหลายคอลัมน์ หรือประโยคที่ไปต่อในหน้าถัดไป) ต้องถูกประกอบขึ้นใหม่ก่อนแปล หลังจากนั้นข้อความที่แปลแล้ว ซึ่งตอนนี้ยาวขึ้นหรือสั้นลง ต้องกลับไปพอดีกับเลย์เอาต์เดิม รูปแบบจะสูญเสียไปในหนึ่งในสองขั้นตอนนั้น
สิ่งที่ควรทำขึ้นอยู่กับสิ่งที่คุณมี:
- ไฟล์ .docx หรือ .pptx ต้นฉบับ: แปลไฟล์นั้นแทน PDF
- PDF ที่เป็นข้อความธรรมดา มีตารางน้อย และเล็กกว่า 10 MB: การอัปโหลดเอกสารฟรีของ Google แปลภาษาเป็นทางเลือกที่ลองได้เร็วที่สุด
- บทความ คู่มือ หรือรายงานที่มีตาราง สมการ หรือสองคอลัมน์: ใช้เครื่องมือแปลที่สร้างเลย์เอาต์ใหม่ แล้วตรวจสี่จุดในส่วนที่ 3
- เอกสารสแกน (ที่เลือกข้อความไม่ได้): ต้องรู้จำข้อความ (OCR) ก่อนจึงจะแปลได้ DeepL รับเอกสารสแกนและจัดการขั้นตอนนี้เอง ส่วน Google แปลภาษาจะปล่อยหน้าที่สแกนไว้โดยไม่แปล
1. เครื่องมือแปลมองเห็นอะไรในไฟล์ PDF กันแน่?
เราสร้างเครื่องมือแปลเอกสาร จึงใช้เวลาดูสิ่งที่หลุดออกมาจาก PDF มาก เพื่อให้เห็นชัด เรานำสองบทความเรื่องโมเดลภาษา AI จาก arXiv คือ LLaMA และ Mistral 7B แล้วสกัดข้อความด้วย mutool จาก MuPDF ซึ่งเป็นเครื่องมือ PDF โอเพนซอร์สที่ใช้กันทั่วไป ข้อความนั้นคร่าว ๆ คือสิ่งที่เครื่องมือเอาไปทำงาน หากมันไม่อ่านเลย์เอาต์ด้วย ด้านล่าง แต่ละช่วงจะแสดงแบบที่ปรากฏบนหน้าก่อน แล้วตามด้วยแบบที่สกัดออกมา (บรรทัดที่มีแค่ … หมายความว่าเราข้ามบางบรรทัดไป)
1.1 ตารางกลายเป็นรายการตัวเลข
ตารางที่ 3 ในบทความ LLaMA เปรียบเทียบสิบโมเดลในการทดสอบแปดอย่าง:
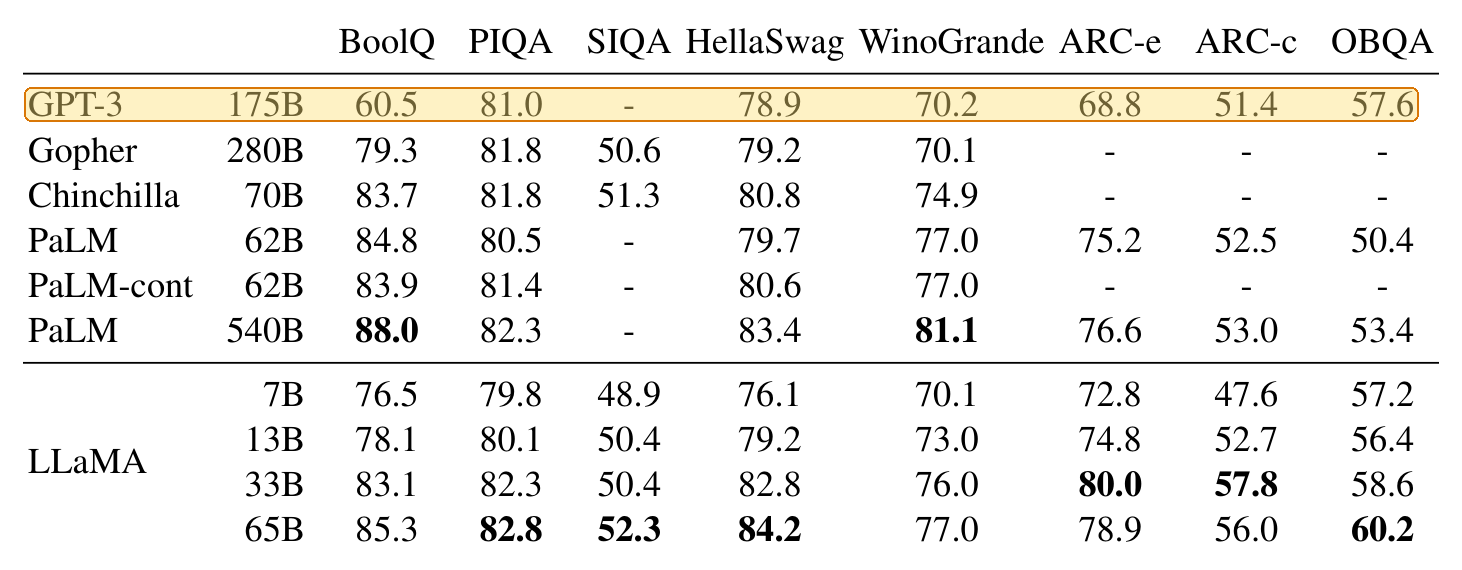
เมื่อสกัดออกมาแล้วมันมี 102 บรรทัด: ห้าบรรทัดแรกเป็นส่วนหัว แล้วบรรทัดละหนึ่งค่า นี่คือ 16 บรรทัดแรก ส่วนสิบบรรทัดจาก GPT-3 ถึง 57.6 คือแถวที่เน้นไว้
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
ไม่มีอะไรบอกเครื่องมือแปลว่าตัวเลขใดเป็นของการทดสอบใด ถ้าคุณนำไปวางในช่องแปล คุณจะได้รายการเดิมกลับมา คำถูกแปลแล้ว แต่ตารางหายไป
1.2 หนึ่งประโยค ที่มีตารางทั้งตารางซ้อนอยู่ข้างใน
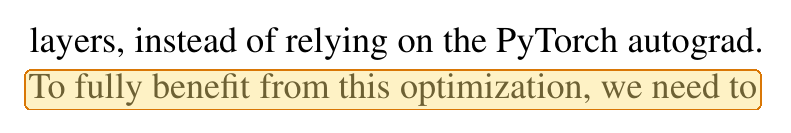
ประโยคสุดท้ายในหน้า 3 ของบทความ LLaMA หยุดอยู่ที่ "we need to":
มันไปต่อที่คอลัมน์ซ้ายของหน้า 4 ทันทีใต้ตารางที่ 3:
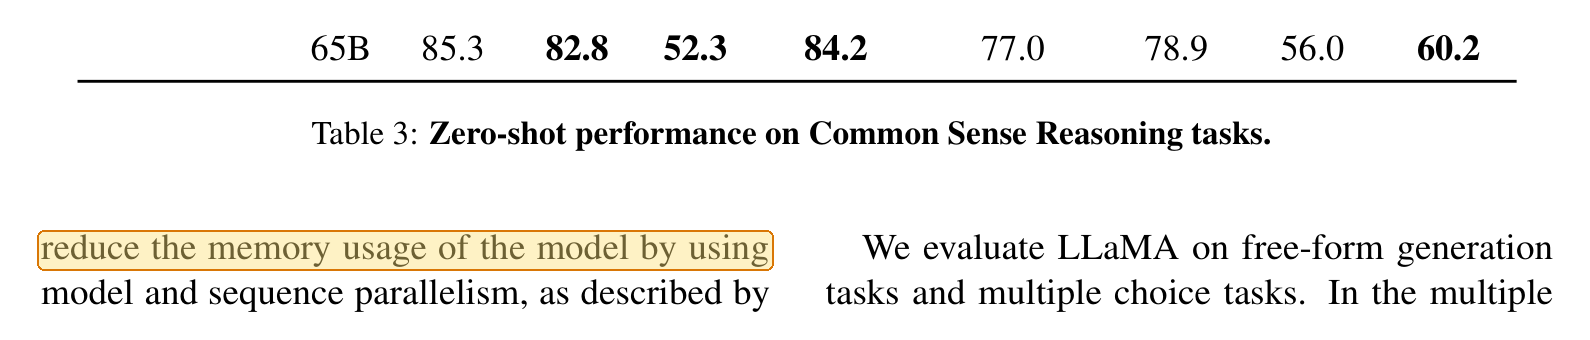
ในข้อความที่สกัดออกมา เชิงอรรถ การขึ้นหน้าใหม่ ทั้ง 102 บรรทัดของตาราง และคำอธิบายตาราง ล้วนอยู่ในประโยคเดียวนั้น:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
เกิดขึ้นอีกครั้งในอีกสองหน้าถัดมา หน้า 5 จบที่ "…the textual description and tests in a" และ "docstring." ปรากฏหลังตารางที่ 7 ในหน้า 6 โดยมี 44 บรรทัดของตารางกับคำอธิบายเจ็ดบรรทัดคั่นอยู่
เครื่องมือที่แปลทีละหน้า หรือเดินตามข้อความตามลำดับเป๊ะ ๆ จะได้สองชิ้นส่วนที่ไม่มีเหตุผลจะเชื่อมกัน ในไฟล์ที่แปลแล้ว คุณจะเห็นประโยคที่ค่อย ๆ จางหายที่ท้ายหน้า และอีกครึ่งไปโผล่ที่ใต้ตาราง
1.3 ตัวห้อยและเศษส่วนกลายเป็นอย่างอื่น
ในบทความ Mistral มีตัวแปรเขียนเป็น h พร้อมตัวห้อย i:
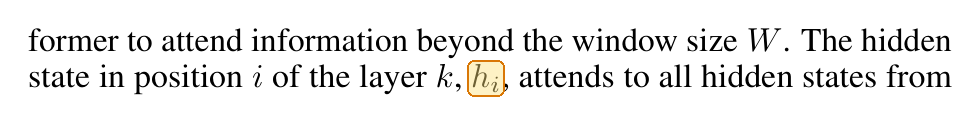
เมื่อสกัดออกมา ตัวห้อยหายไป เหลือเพียง hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
เครื่องมือแปลไม่มีเหตุผลจะมองว่านั่นคือตัวแปร สำหรับมัน hi เป็นเพียงคำภาษาอังกฤษธรรมดา
เศษส่วนยิ่งแย่กว่า LLaMA กำหนดค่านี้เป็นสองในสามของ 4d เขียนเป็น ⅔·4d โดย ⅔ วางเลข 2 เล็ก ๆ ทับเลข 3:
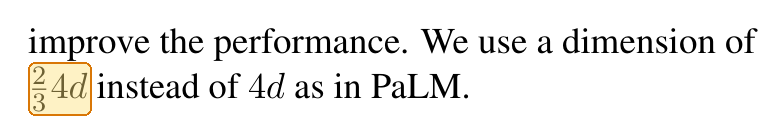
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
สองในสามของ 4d กลายเป็น 34d ตัวยก เศษส่วน และสัญลักษณ์จากฟอนต์คณิตศาสตร์เป็นเพียงรูปทรงที่วางไว้ในตำแหน่งหนึ่ง ข้อความที่สกัดออกมาเก็บรูปทรงไว้ แต่เสียตำแหน่งไป
1.4 คำถูกตัดที่ท้ายบรรทัด
บทความสองคอลัมน์ตัดคำที่ท้ายบรรทัดบ่อยมาก ใน LLaMA มี 242 บรรทัดที่ตัดคำธรรมดาที่เป็นตัวพิมพ์เล็กด้วยยัติภังค์ การนำกลับมาต่อกันดูง่าย จนกว่าจะเจอยัติภังค์ที่เป็นส่วนหนึ่งของชื่อ:
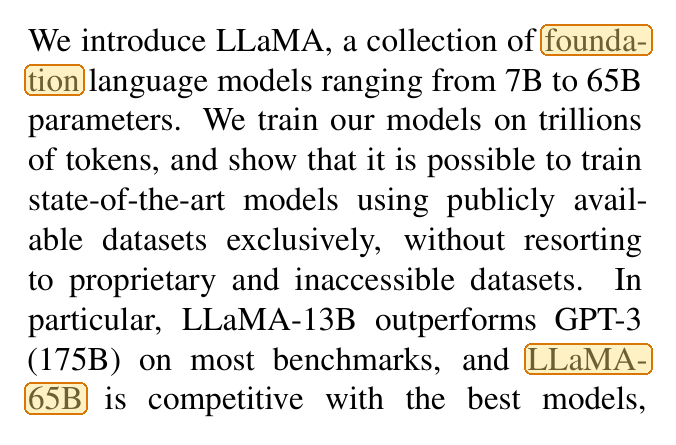
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- กับ tion รวมกันเป็นคำเดียวเมื่อเอาขีดออก แต่ใน LLaMA- กับ 65B ยัติภังค์เป็นส่วนหนึ่งของชื่อโมเดลและต้องเก็บไว้
เราใช้เครื่องมือสกัดเพียงตัวเดียวกับสองบทความที่ทำด้วย LaTeX ซึ่งเป็นระบบเรียงพิมพ์ที่พบบ่อยในงานพิมพ์วิชาการ PDF ที่ส่งออกจาก Word เอกสารสแกน หรือเครื่องมือสกัดอื่น อาจให้ผลต่างออกไป แต่ความเสียหายสี่แบบนี้คือสิ่งที่ควรมองหา
2. คุณมีทางเลือกอะไรบ้าง?
ข้อมูลของ Google แปลภาษาและ DeepL มาจากหน้าช่วยเหลือของแต่ละราย ตรวจสอบเมื่อวันที่ 7 ตุลาคม 2026 เมื่อการแปล PDF น่าผิดหวัง คำแนะนำของ DeepL คือให้อัปโหลดเอกสารต้นฉบับแทน ซึ่งตรงกับคำแนะนำของเรา
แถวสุดท้ายคือสิ่งที่ แปลเอกสาร ของ Equalang ถูกสร้างมาเพื่อทำโดยตรง จึงเป็นแนวทางที่เรารู้จักดีที่สุด ก่อนแปล Equalang จะต่อประโยคที่ถูกขึ้นหน้าใหม่ตัดเป็นสองท่อนให้กลับมาสมบูรณ์ ตารางที่มีเซลล์รวมและหัวตารางหลายบรรทัดจะถูกสร้างใหม่ตามโครงสร้างเดิม แทนที่จะถูกยุบให้แบนเป็นรายการเดียว สมการไม่ถูกทิ้งเป็นข้อความที่อ่านไม่ออก และมีตัวเลือกเพิ่มประสิทธิภาพสมการสำหรับสมการที่ยากและอยู่ในบรรทัดข้อความ
สิ่งที่มันไม่ทำคือการทำซ้ำต้นฉบับได้เหมือนเป๊ะ การแปลที่ยาวกว่าต้นฉบับจะขยับจุดขึ้นบรรทัดใหม่และขนาดตัวอักษร ดังนั้นหน้าที่มีเลย์เอาต์แน่นยังคงควรตรวจดู ปัจจุบันการแปลเอกสารรองรับภาษาจีน อังกฤษ ญี่ปุ่น เกาหลี สเปน ฝรั่งเศส และภาษาอื่น ๆ
3. หลังจากแปล PDF แล้ว ควรตรวจอะไร?
- ตาราง. หัวตารางยังอยู่เหนือคอลัมน์ที่ถูกต้องหรือไม่ ตัวเลขเปลี่ยนไปหรือเปล่า
- การขึ้นหน้าใหม่และข้อความใต้ตารางแต่ละตาราง. อ่านบรรทัดสุดท้ายของทุกหน้าและประโยคถัดจากตารางแต่ละตาราง ประโยคที่หยุดแล้วไม่มีทางจบคือสัญญาณที่พบบ่อยที่สุดว่าข้อความถูกแปลเป็นชิ้น ๆ
- สมการและตัวแปร. ตรวจดูสองสามแห่งที่อยู่ในบรรทัดข้อความ มองหาตัวอักษรที่กลายเป็นคำ และเศษส่วนที่กลายเป็นตัวเลขอื่น
- จำนวนหน้าและลิงก์. จำนวนหน้าต่างกันมากหมายความว่ามีข้อความหายไปหรือล้นไปยังหน้าเพิ่ม ลองคลิกหนึ่งหรือสองรายการในสารบัญเพื่อดูว่าทำงานหรือไม่
แหล่งที่มา
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- วิธีใช้ Google แปลภาษา, Translate documents & websites, ตรวจสอบเมื่อวันที่ 7 ตุลาคม 2026.
- ศูนย์ช่วยเหลือ DeepL, Translate PDF files, ตรวจสอบเมื่อวันที่ 7 ตุลาคม 2026.
- วิธีการ: สกัดข้อความเมื่อวันที่ 7 ตุลาคม 2026 ด้วย MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdfรูปภาพเป็นส่วนที่ตัดจากหน้าของบทความ ส่วนการเน้นเป็นของเรา