Terjemahan PDF: kenapa formatnya hilang dan cara menjaganya
 Equalang
Secara singkat
Kebanyakan PDF tidak menandai mana paragraf dan mana tabel, tidak seperti file Word. Dua makalah menunjukkan apa yang rusak dan apa yang perlu diperiksa.
Kata kunci: terjemahan PDF; terjemahan dokumen; format PDF; menjaga tata letak; makalah penelitian
File Word mencatat kata mana yang membentuk satu paragraf dan kata mana yang termasuk sebuah tabel. Kebanyakan PDF tidak. PDF hanya menyimpan huruf-huruf dan koordinat untuk menggambarnya; paragraf, tabel, dan kalimat adalah sesuatu yang dirangkai oleh mata pembaca. Sebagian PDF membawa tag aksesibilitas (ditambahkan untuk pembaca layar) yang menandai paragraf dan tabel, tetapi banyak yang tidak memilikinya (dua makalah yang kami pakai sebagai contoh di bawah sama sekali tidak punya), jadi alat penerjemah tidak bisa mengandalkannya. Semua yang Anda lihat sebagai struktur (tata letak dua kolom, tajuk yang membentang di beberapa kolom, atau kalimat yang bersambung di halaman berikutnya) harus direkonstruksi dulu sebelum penerjemahan terjadi. Sesudahnya, teks terjemahan yang kini lebih panjang atau lebih pendek harus kembali muat ke dalam tata letak aslinya. Format hilang di salah satu dari dua langkah itu.
Apa yang sebaiknya Anda lakukan bergantung pada apa yang Anda miliki:
- File .docx atau .pptx aslinya: terjemahkan itu saja, bukan PDF-nya.
- PDF teks biasa dengan sedikit tabel, di bawah 10 MB: unggah dokumen gratis dari Google Terjemahan adalah pilihan tercepat untuk dicoba.
- Makalah, manual, atau laporan yang berisi tabel, rumus, atau dua kolom: pakai alat penerjemah yang membangun ulang tata letak, lalu periksa empat posisi yang tercantum di bagian 3.
- Hasil pindaian (yang teksnya tidak bisa Anda pilih): perlu pengenalan teks (OCR) sebelum bisa diterjemahkan. DeepL menerima hasil pindaian dan menangani langkah ini sendiri. Google Terjemahan membiarkan halaman pindaian tetap tidak diterjemahkan.
1. Apa yang sebenarnya dilihat alat penerjemah di dalam PDF?
Kami membangun alat penerjemah dokumen, jadi kami menghabiskan banyak waktu melihat apa yang keluar dari PDF. Untuk memperlihatkannya dengan jelas, kami mengambil dua makalah tentang model bahasa AI dari arXiv, LLaMA dan Mistral 7B, lalu mengekstrak teksnya dengan mutool dari MuPDF, alat PDF sumber terbuka yang lazim dipakai. Teks itu kira-kira sama dengan yang dipakai sebuah alat untuk bekerja, kalau alat itu tidak membaca tata letaknya juga. Di bawah, setiap bagian ditampilkan dulu seperti tampilannya di halaman, kemudian seperti yang keluar (baris yang hanya berisi … berarti kami melewat beberapa baris).
1.1 Tabel berubah menjadi daftar angka
Tabel 3 dalam makalah LLaMA membandingkan sepuluh model dalam delapan pengujian:
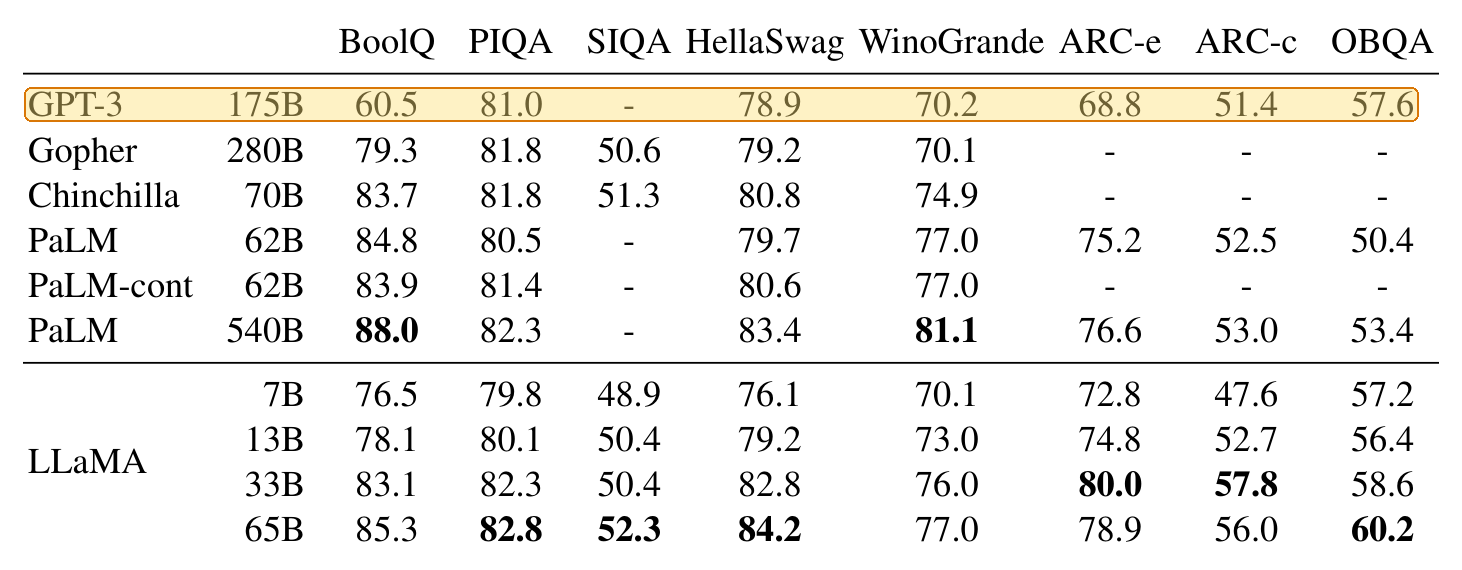
Setelah diekstrak, isinya 102 baris: lima baris tajuk, lalu satu nilai per baris. Ini 16 baris pertama; sepuluh baris dari GPT-3 sampai 57.6 adalah baris tabel yang disorot.
BoolQ
PIQA
SIQA HellaSwag WinoGrande ARC-e
ARC-c
OBQA
GPT-3
175B
60.5
81.0
-
78.9
70.2
68.8
51.4
57.6
Gopher
Tidak ada yang memberi tahu alat penerjemah angka mana yang termasuk pengujian yang mana. Kalau Anda menempelkan itu ke kotak terjemahan, Anda mendapatkan daftar yang sama kembali. Kata-katanya diterjemahkan, tetapi tabelnya hilang.
1.2 Satu kalimat, dengan satu tabel utuh di dalamnya
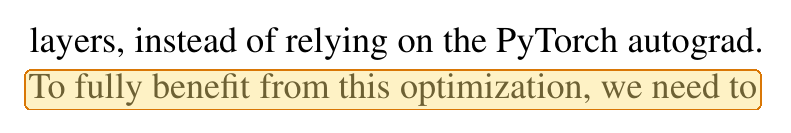
Kalimat terakhir di halaman 3 makalah LLaMA berhenti pada "we need to":
Ia bersambung di kolom kiri halaman 4, tepat di bawah Tabel 3:
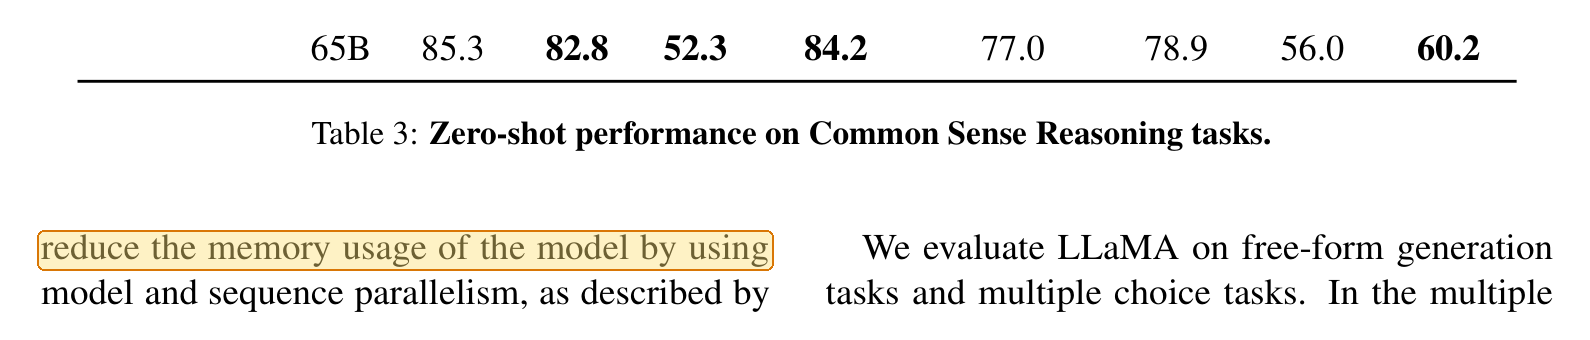
Dalam teks hasil ekstraksi, sebuah catatan kaki, jeda halaman, seluruh 102 baris tabel, dan tajuk tabelnya berada di dalam satu kalimat itu:
To fully benefit from this optimization, we need to
2https://github.com/facebookresearch/xformers
BoolQ
PIQA
…
Table 3: Zero-shot performance on Common Sense Reasoning tasks.
reduce the memory usage of the model by using
Hal yang sama terjadi lagi dua halaman kemudian. Halaman 5 berakhir pada "…the textual description and tests in a", dan "docstring." baru muncul setelah Tabel 7 di halaman 6, dengan 44 baris tabel dan tajuk tujuh baris di antaranya.
Alat yang menerjemahkan halaman demi halaman, atau mengikuti teks persis dalam urutan ini, mendapat dua fragmen yang tidak punya alasan untuk disambung. Di dalam file terjemahan, Anda melihat sebuah kalimat yang menggantung di bagian bawah halaman, dan separuh lainnya muncul di suatu tempat di bawah tabel.
1.3 Subskrip dan pecahan berubah menjadi sesuatu yang lain
Dalam makalah Mistral, sebuah variabel ditulis sebagai h dengan subskrip i:
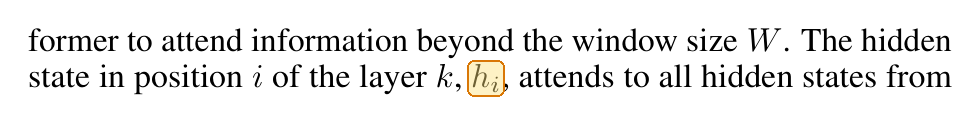
Saat diekstrak, subskripnya hilang dan yang tersisa hanya hi:
former to attend information beyond the window size W. The hidden
state in position i of the layer k, hi, attends to all hidden states from
Alat penerjemah tidak punya alasan untuk menganggapnya sebagai variabel. Baginya, hi hanya sebuah kata bahasa Inggris biasa.
Pecahan nasibnya lebih buruk. LLaMA menetapkan satu nilai sebesar dua pertiga dari 4d, ditulis sebagai ⅔·4d dengan ⅔ yang disusun sebagai angka 2 kecil di atas angka 3:
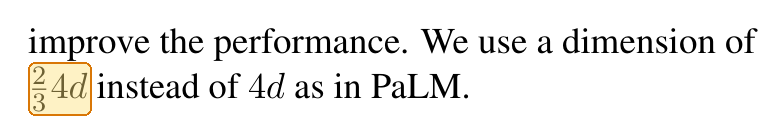
improve the performance. We use a dimension of
2
34d instead of 4d as in PaLM.
Dua pertiga dari 4d sudah menjadi 34d. Superskrip, pecahan, dan simbol dari font matematika hanyalah bentuk yang diletakkan pada posisi tertentu. Teks hasil ekstraksi mempertahankan bentuknya, tetapi kehilangan posisinya.
1.4 Kata terpotong di ujung baris
Makalah dua kolom memotong banyak kata di ujung baris. Di LLaMA, 242 baris memotong sebuah kata biasa berhuruf kecil dengan tanda hubung. Menyambungnya kembali tampak mudah, sampai Anda menjumpai tanda hubung yang merupakan bagian dari sebuah nama:
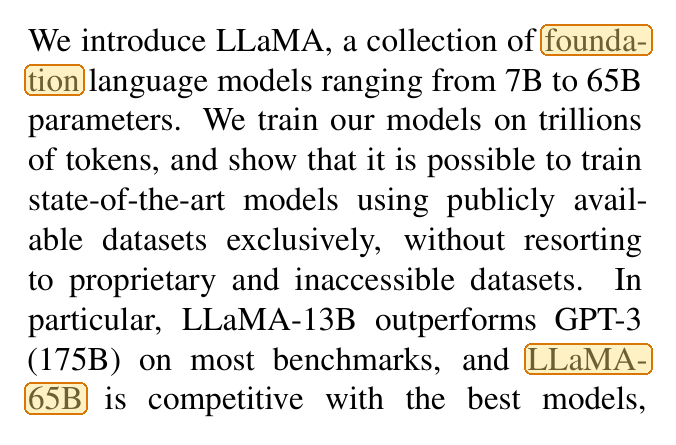
We introduce LLaMA, a collection of founda-
tion language models ranging from 7B to 65B
…
(175B) on most benchmarks, and LLaMA-
65B is competitive with the best models,
founda- dan tion membentuk satu kata tanpa tanda hubung. Tetapi pada LLaMA- dan 65B, tanda hubung itu bagian dari nama model dan harus tetap ada.
Kami hanya menjalankan satu alat ekstraksi pada dua makalah yang dibuat dengan LaTeX, sebuah sistem penataan huruf yang lazim dalam penerbitan akademik. PDF yang diekspor dari Word, dokumen hasil pindaian, dan alat ekstraksi lain bisa memberi hasil yang berbeda, tetapi empat jenis kerusakan inilah yang perlu dicari.
2. Apa pilihan Anda?
Keterangan tentang Google Terjemahan dan DeepL berasal dari halaman bantuan mereka sendiri, diperiksa pada 7 Oktober 2026. Saat terjemahan PDF mengecewakan, saran DeepL adalah mengunggah dokumen aslinya saja. Itu sama dengan saran kami.
Baris terakhir itulah yang dirancang untuk dikerjakan oleh terjemahan dokumen Equalang, jadi itulah pendekatan yang paling kami pahami. Sebelum menerjemahkan, Equalang menyambung kembali kalimat yang dipotong dua oleh jeda halaman. Tabel dengan sel yang digabung dan tajuk multi-baris direkonstruksi dalam struktur aslinya, bukan diratakan menjadi satu daftar. Rumus tidak dibuang begitu saja sebagai teks kacau, dan ada opsi optimasi rumus untuk rumus sulit yang berada di dalam satu baris teks.
Yang tidak dilakukannya adalah mereproduksi aslinya secara persis. Terjemahan yang lebih panjang dari aslinya menggeser jeda baris dan ukuran font, jadi halaman dengan tata letak yang padat tetap layak diperiksa. Saat ini terjemahan dokumen mencakup bahasa Mandarin, Inggris, Jepang, Korea, Spanyol, Prancis, dan bahasa lainnya.
3. Setelah PDF diterjemahkan, apa yang perlu diperiksa?
- Tabel. Apakah tajuknya masih berada di atas kolom yang tepat? Apakah angka-angkanya tidak berubah?
- Jeda halaman dan teks di bawah setiap tabel. Bacalah baris terakhir setiap halaman dan kalimat tepat setelah setiap tabel. Kalimat yang berhenti dan tidak pernah selesai adalah tanda paling umum bahwa teks diterjemahkan secara terpotong-potong.
- Rumus dan variabel. Periksa beberapa yang berada di dalam satu baris teks. Carilah huruf yang berubah menjadi kata, dan pecahan yang berubah menjadi angka lain.
- Jumlah halaman dan tautan. Jumlah halaman yang sangat berbeda berarti ada teks yang hilang atau meluber ke halaman tambahan. Klik satu dua entri daftar isi untuk melihat apakah tautannya berfungsi.
Sumber
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models", arXiv:2302.13971v1, CC BY 4.0.
- Jiang et al., "Mistral 7B", arXiv:2310.06825v1, CC BY 4.0.
- Bantuan Google Terjemahan, Translate documents & websites, diperiksa 7 Oktober 2026.
- Pusat Bantuan DeepL, Translate PDF files, diperiksa 7 Oktober 2026.
- Metode: teks diekstrak pada 7 Oktober 2026 dengan MuPDF 1.25.6,
mutool draw -q -F txt -o out.txt in.pdf. Gambar-gambarnya adalah potongan halaman kedua makalah; sorotannya dari kami.